编写第一个爬虫程序:获取页面、提取需要的数据、如何精准定位!

Python 网络爬虫进阶教学全指南 本次博客将深入探究 Python 网络爬虫的核心知识与实用技巧,引领大家从入门迈向精通 阅读详情

1、获取页面

import requests #引入包requests
link = "https://blog.youkuaiyun.com/qq_45154565/article/details/109261945" #将目标网页的网址定义为link

# 定义请求头的浏览器代理,伪装成火狐浏览器
headers = {'User-Agent' : 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'} 

r = requests.get(link, headers= headers) #请求网页,r是requests的response回复对象,可以从中获取想要的信息
print (r.text)  #r.text是获取的网页内容代码
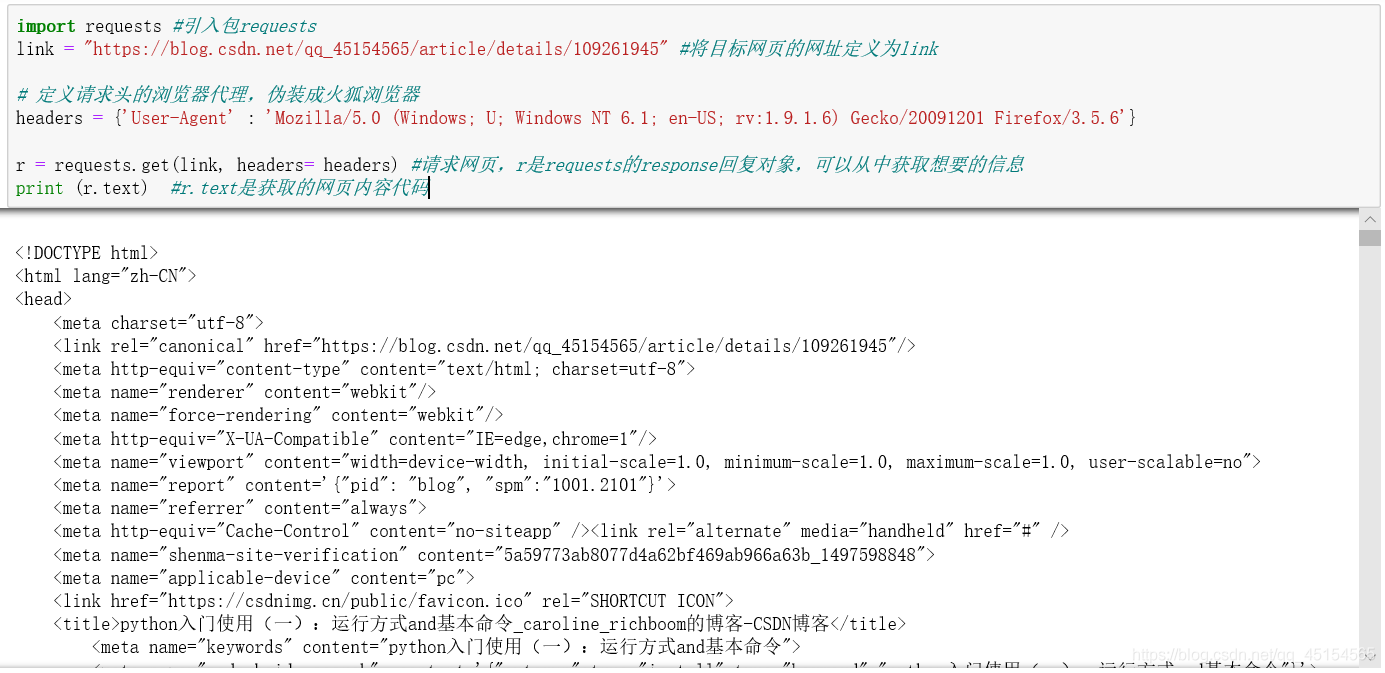
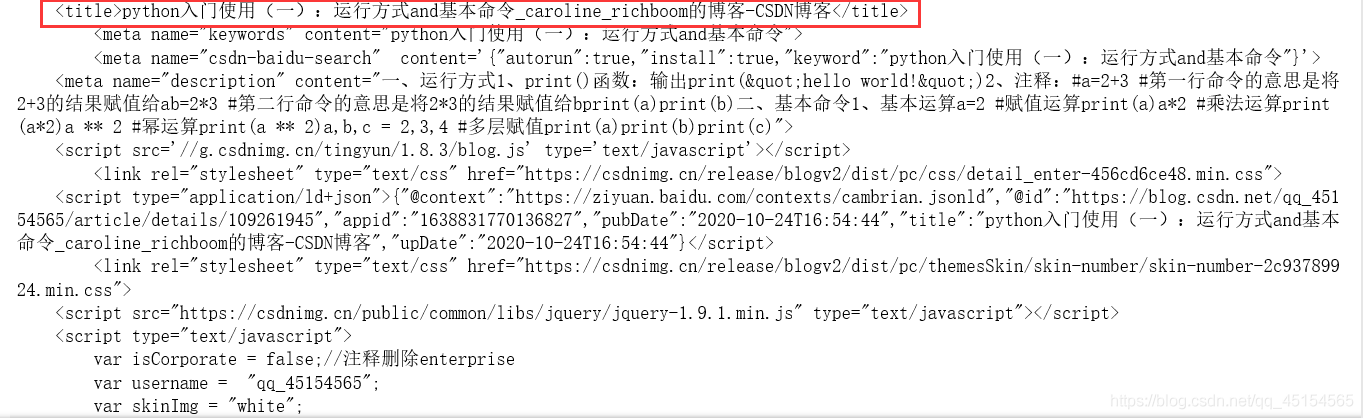
 

从上述输出结果可以看出文章的标题等内容,它其实获取的是博客页面的HTML代码(一种用来描述网页的语言,我后续会更新博客学习),大家可以理解成网页上呈现出来的内容都是HTML代码。

2、提取需要的数据

在获取整个页面的HTML代码后,就可以从整个网格网页中提取出文章的标题了。

import requests
from bs4 import BeautifulSoup     #从bs4这个库中导入BeautifulSoup

link = "https://blog.youkuaiyun.com/qq_45154565/article/details/109261945"
headers = {'User-Agent' : 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'} 
r = requests.get(link, headers= headers)

soup = BeautifulSoup(r.text, "html.parser")  #使用BeautifulSoup解析这段代码,把HTML代码转化为soup对象

#用soup.find函数找到文章标题,定位到class是"post-title"的h1元素,提取a,提取里面的字符串,strip()去除左右空格
title = soup.find("h1", class_="title-article")
print (title)
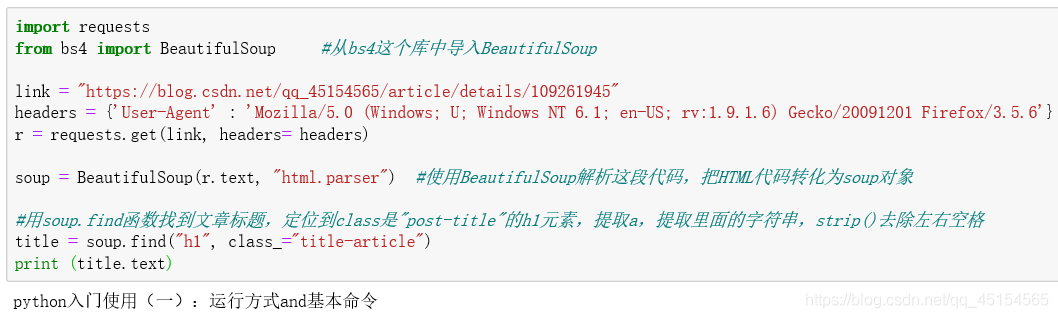

由上图可见,已经提取了指定的标题内容。
3、如何精准定位标题的HTML代码位置

在2中的代码中可以看到这一句代码

#用soup.find函数找到文章标题,定位到class是"post-title"的h1元素,提取a,提取里面的字符串,strip()去除左右空格
title = soup.find("h1", class_="title-article")1

那么soup.find函数中的这些参数是怎么决定的呢?请看下面解释

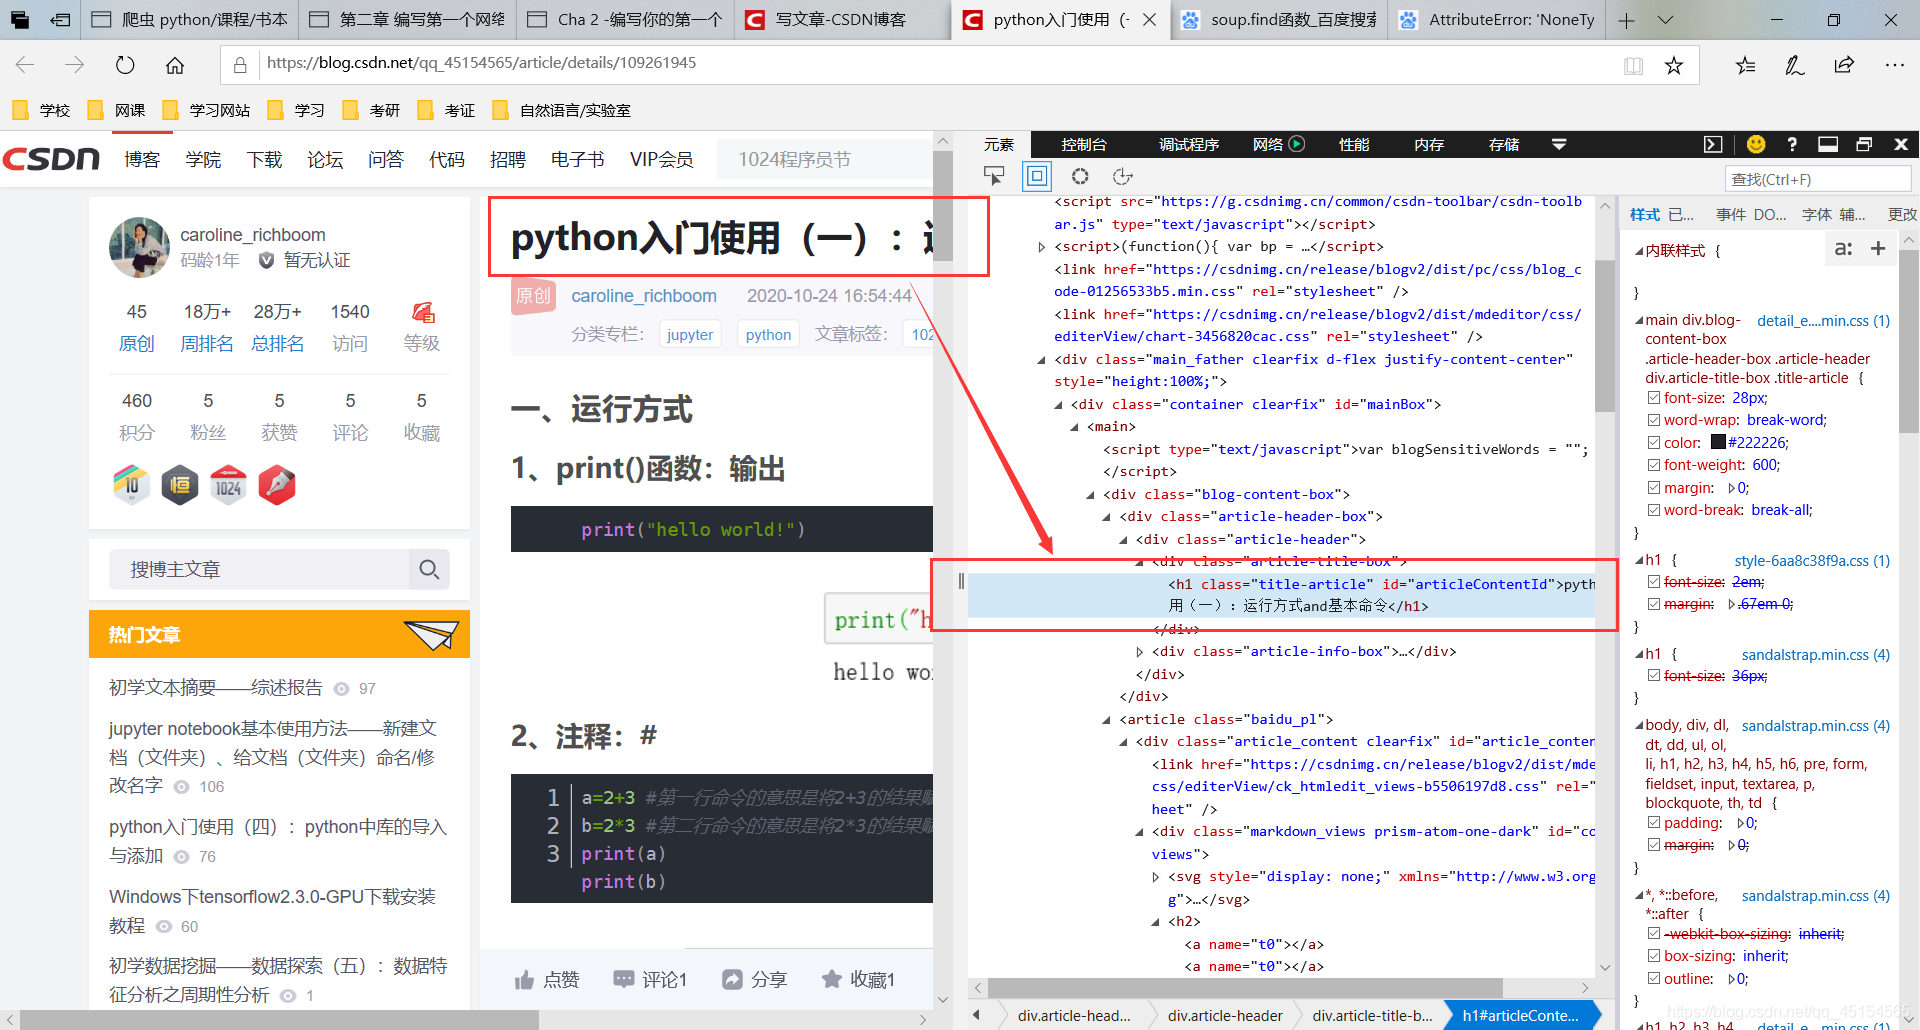
(1)在浏览器右键 > 检查元素(IE)/检查(谷歌)

以下以IE浏览器为例,谷歌同理:
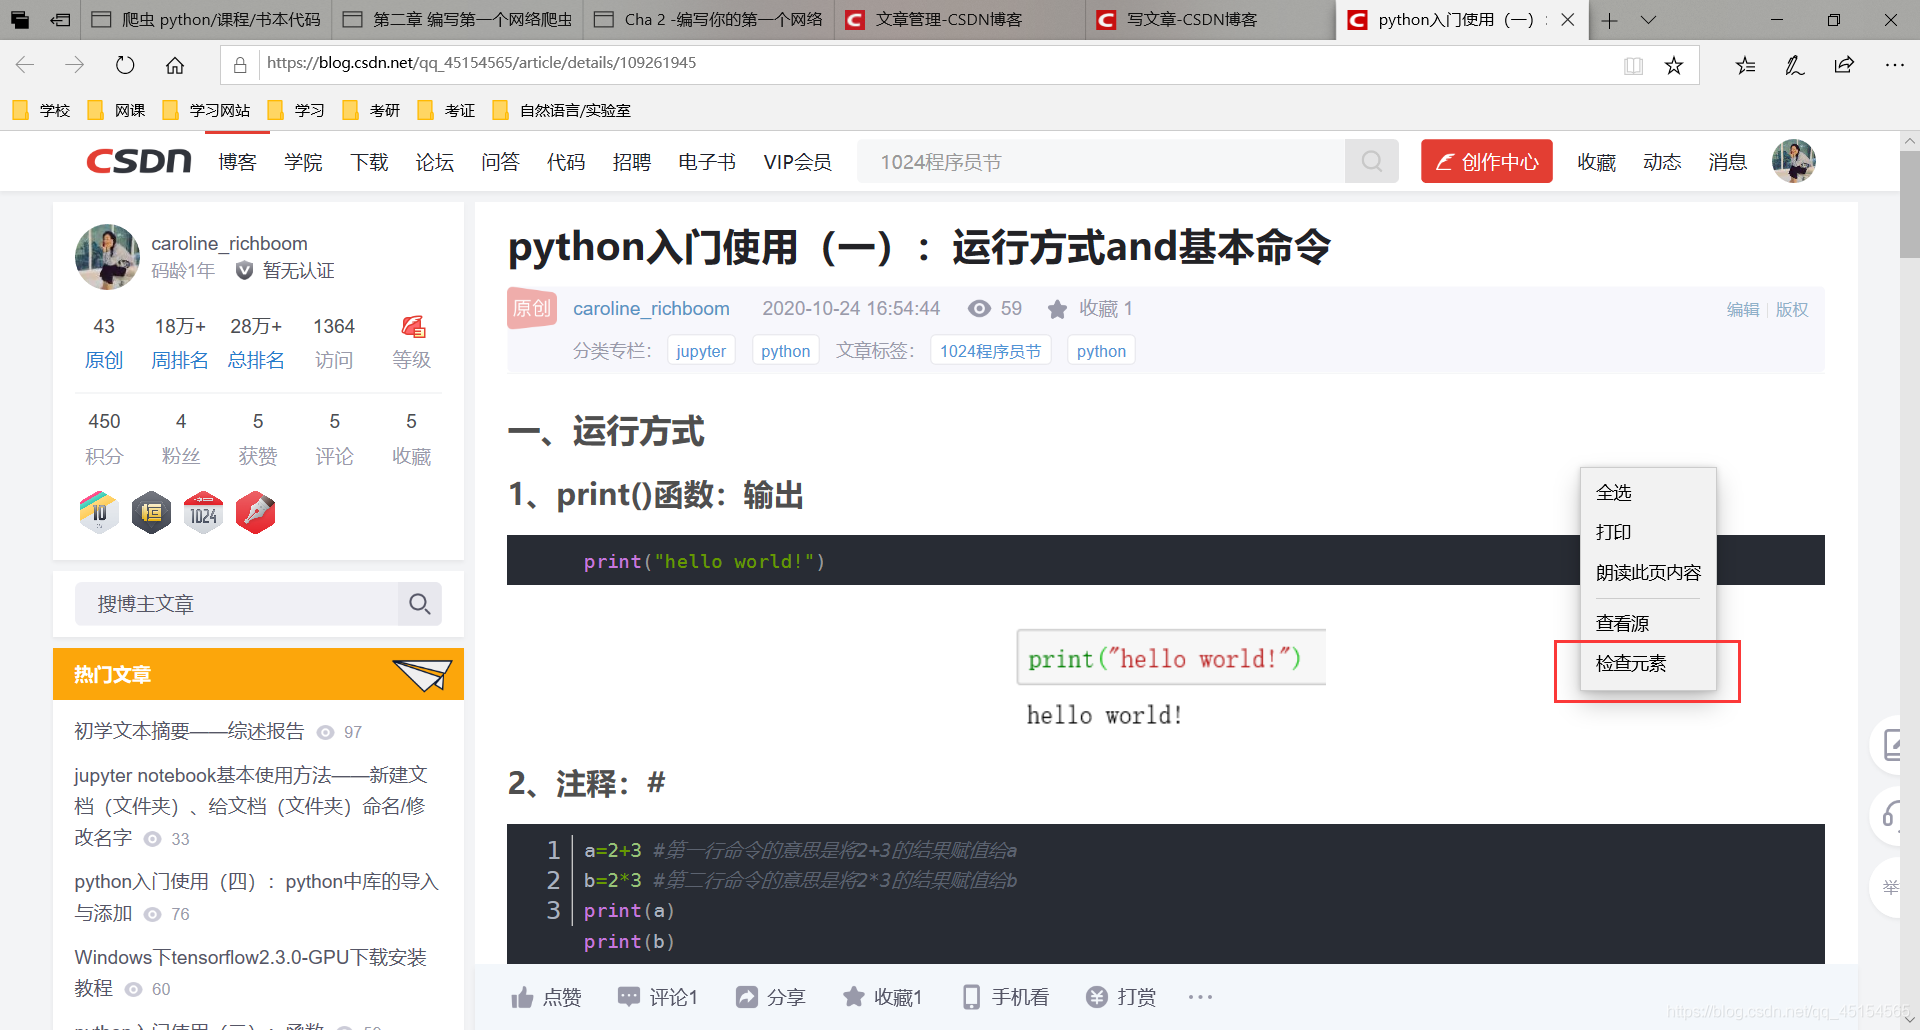

会出现以下界面:
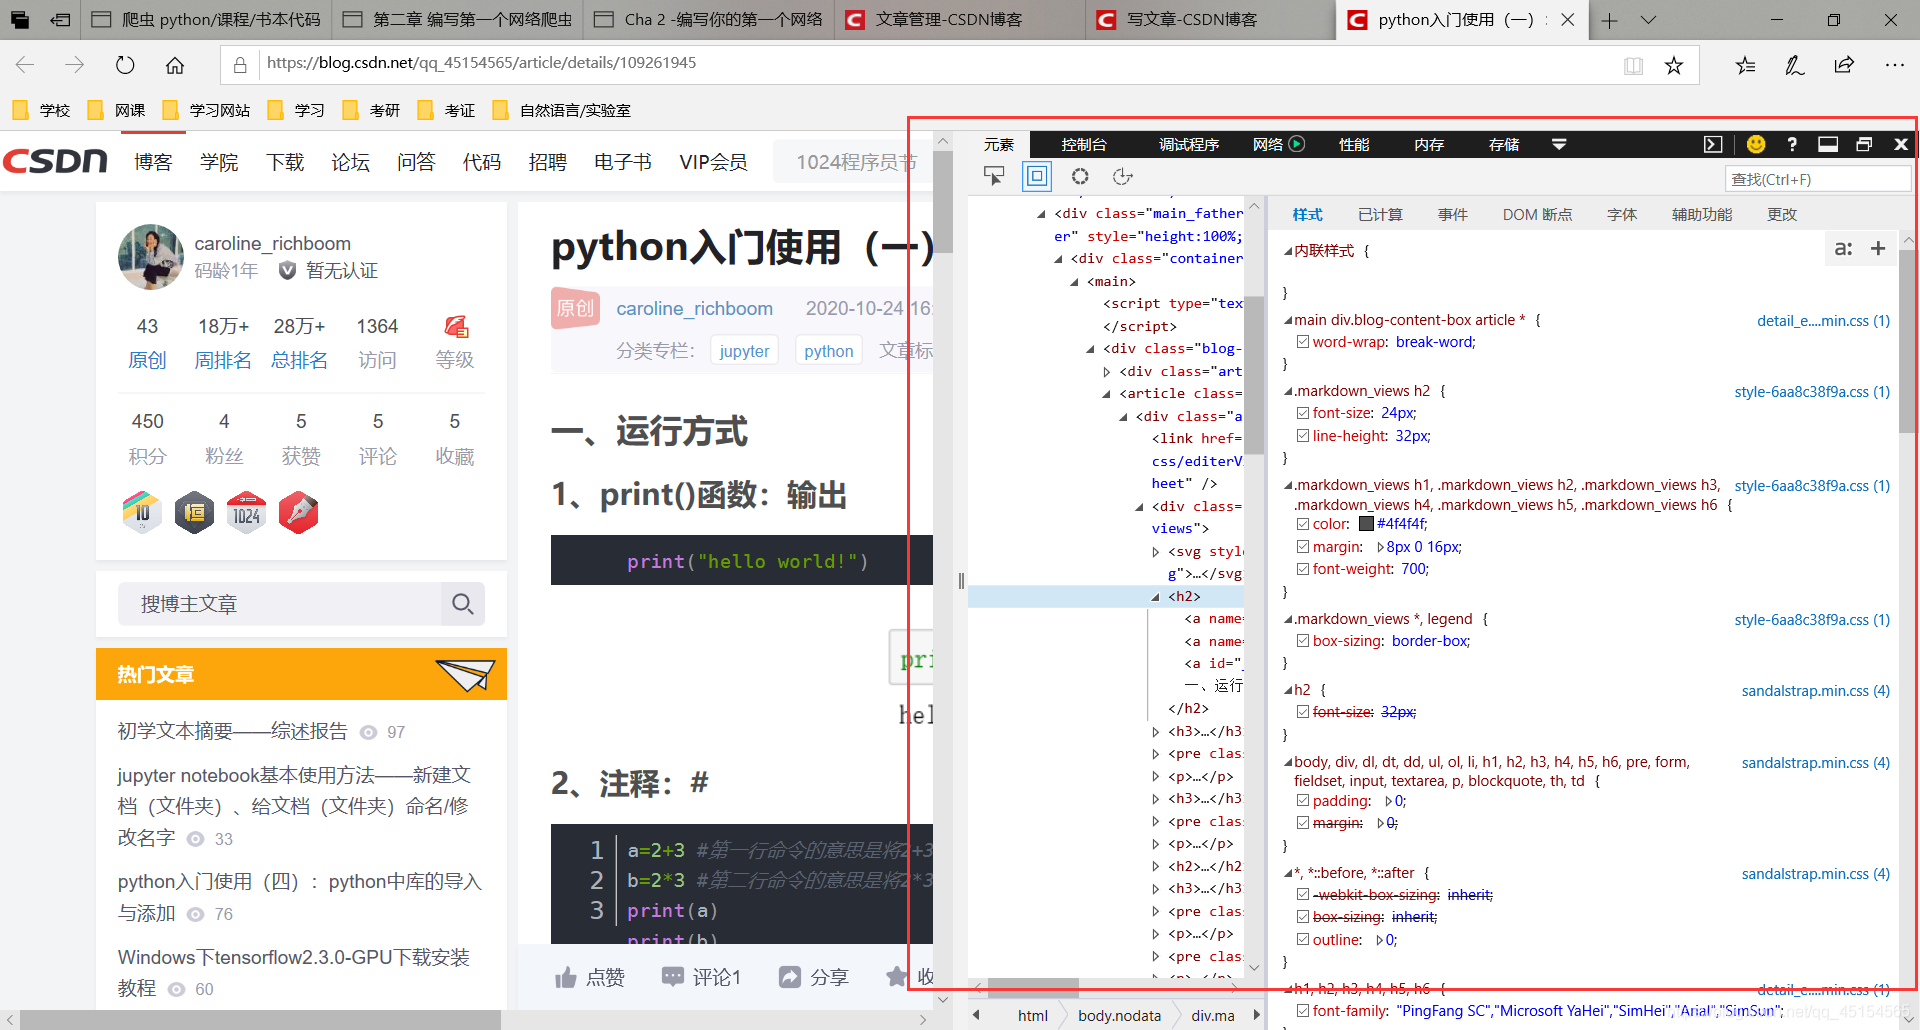

右侧显示的即为HTML代码

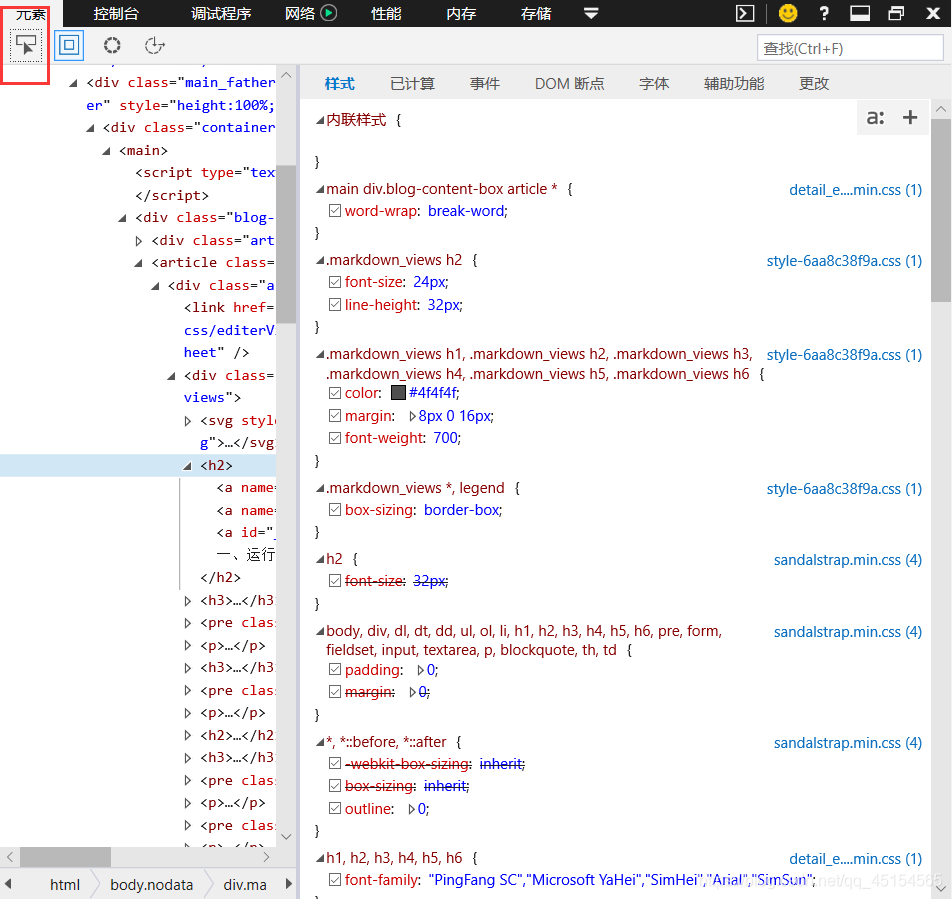
(2)点击HTML代码界面左上角的鼠标:

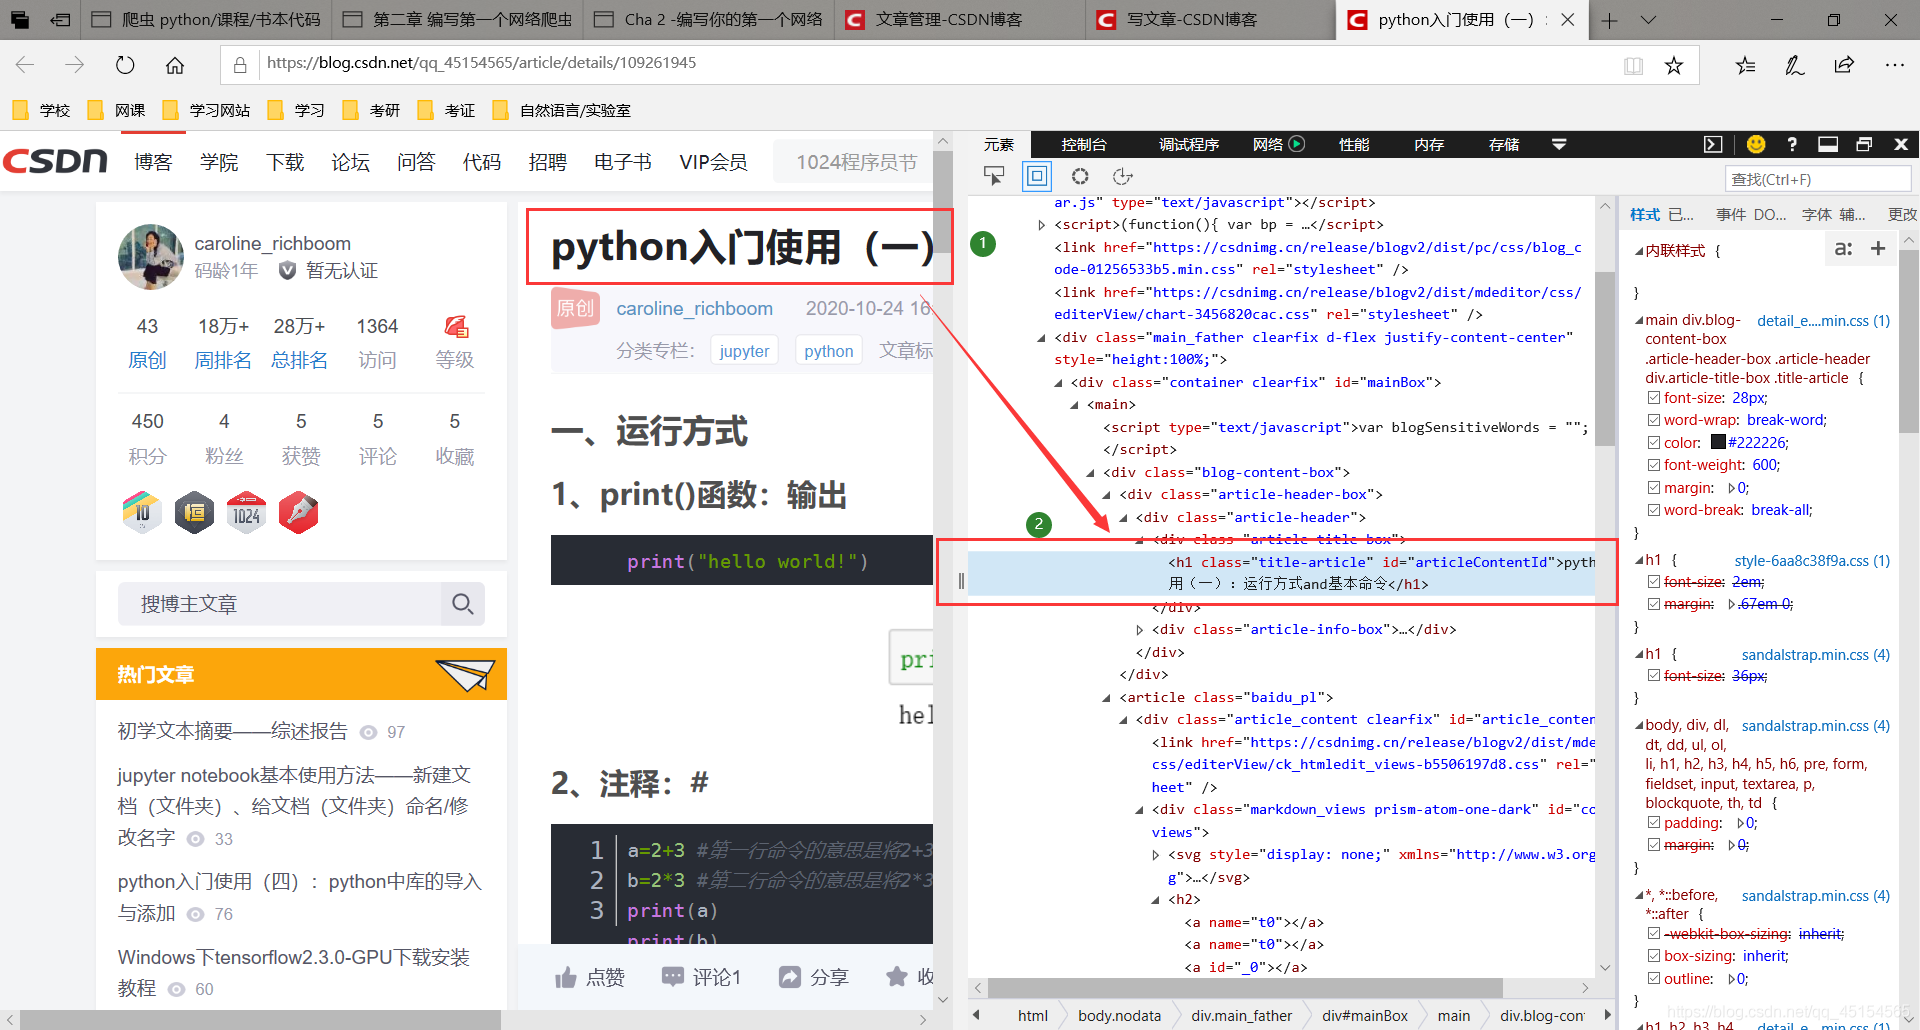
然后用鼠标点击页界面的任意位置,就会出现其对应的HTML代码板块(呈蓝色):
4、存储数据

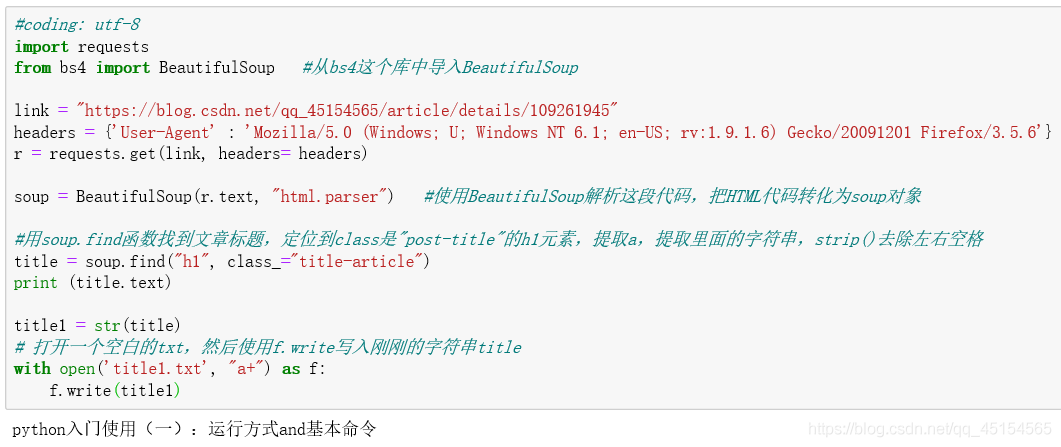
#coding: utf-8
import requests
from bs4 import BeautifulSoup   #从bs4这个库中导入BeautifulSoup

link = "https://blog.youkuaiyun.com/qq_45154565/article/details/109261945"
headers = {'User-Agent' : 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'} 
r = requests.get(link, headers= headers)

soup = BeautifulSoup(r.text, "html.parser")   #使用BeautifulSoup解析这段代码,把HTML代码转化为soup对象

#用soup.find函数找到文章标题,定位到class是"post-title"的h1元素,提取a,提取里面的字符串,strip()去除左右空格
title = soup.find("h1", class_="title-article")
print (title.text)

title1 = str(title)
# 打开一个空白的txt,然后使用f.write写入刚刚的字符串title
with open('title1.txt', "a+") as f:
    f.write(title1)

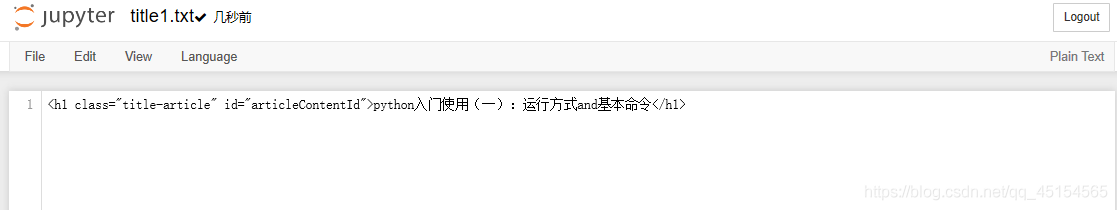
生成的txt文本:
PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取

python免费学习资料以及群交流解答点击即可加入

 

【Python网络爬虫笔记】11- Xpath精准定位元素 Xpath,能够帮助开发者从复杂的网页结构中精准地提取所需信息。本文将深入探讨 Xpath 在 Python 网络爬虫中的作用、常用方法、安装与使用步骤以及典型案例。 阅读详情

相关推荐

【Python进阶】网络爬虫核心技能-数据提取

本课程由​​好学星城(Learning Star City)的Harry老师​​主讲,系统性地讲解了网络爬虫开发中至关重要的一环——提取数据。

专注Python编程与网络安全领域,分享原创技术文章与靶机渗透实战经验。以清晰的逻辑解构复杂技术,用深入浅出的笔触呈现:从Python基础到高级特性,从漏洞原理到攻防实践。在这里,代码与安全交织,思考与成长同行。 1071

【初码干货】关于.NET玩爬虫这些事

这几天在微信群里又聊到.NET可以救中国但是案例太少不深的问题,我说.NET玩爬虫简直就是宇宙第一,于是大神朱永光说,你为何不来写一篇总结一下? 那么今天就全面的来总结一下,在.NET生态下,如何玩爬虫 关于爬虫 从搜索引擎开始,爬虫应该就出现了,爬的对象当然也就是网页URL,在很长一段时间内,爬虫所做的事情就是分析URL、下载WebServer返回的HTML、分析HTML内容、构建H...

582

Python 网络爬虫的基本流程及 robots 协议详解

Python 网络爬虫的基本流程是数据采集的技术框架,而 robots 协议是规范爬虫行为的道德与技术准则。掌握请求发送、内容解析、数据存储和策略控制的核心技巧,同时严格遵守 robots 协议及相关法律法规,才能开发出高效、合规的爬虫程序。在实际应用中,开发者需始终平衡数据需求与网站权益,推动网络爬虫技术的健康发展。

srlsong的博客 1349

第一个爬虫程序

网络爬虫使用程序代码来访问网站,而非人类亲自点击访问,因此爬虫程序也被叫做“爬虫机器人”。绝大网站都具备一定的反爬能力,禁止网络爬虫大量访问网站,以免给网站服务器带来压力 python内置的urllib库获取网页的html信息。urllib库属于python的标准模块。是python爬虫的常用模块。urllib的模块如下: urlopen()有两个参数:url 表示要爬取的数据的url地址,timeout:表示等待超时时间,指定时间内未得到响应就抛出超市异常urllib库有几个模块:向网站发出请求,获得响应

changan 322

深入解析:使用C++构建网络爬虫

网络爬虫是一种自动化的网络机器人,它遵循特定的算法,高效地访问网络,检索并收集网页数据。简而言之,爬虫是网络数据的“收割机”,能够在茫茫信息海洋中精准定位并抓取目标内容。其重要性不仅体现在搜索引擎的索引构建上,还广泛应用于市场研究、新闻聚合、学术研究等多个领域,极大地推动了大数据和机器学习等技术的发展。在搜索引擎领域,爬虫是核心组件之一,负责不断抓取新内容和更新旧内容,保证搜索引擎数据库的实时性和相关性。

weixin_35972981的博客 2964

3D Slicer-最强大的开源医学图像分割工具简要概述

3D Slicer 是一个免费的开源软件平台,用于医学、生物医学和其他 3D 图像的可视化、处理、分割、配准和分析。读/写DICOM图像和多种其他格式;三维图像、多边形网格和体积渲染的交互式可视化;手动编辑和标记图像;使用刚性和非刚性算法融合和共同配准数据;图像自动分割;跟踪图像引导程序的设备。所有的功能模块可在工具栏里找到,提供搜索,下拉选择,左右切换等功能。3D slicer的大概情况就介绍到这里。它的功能非常强大,也没有必要说掌握每个功能的使用。

Tina姐的博客 2万+

一篇文章带你入门爬虫并编写自己的第一个爬虫程序

本文介绍了爬虫的基本概念、基本过程,并详细地讲解了一个爬虫程序的构思思路与代码实现,旨在带领读者入门爬虫并编写自己的第一个爬虫程序。

2301_79959126的博客 3656

激光可燃气体传感器DIY指南:从TDLAS原理到STM32实战(附代码)

本文详细介绍了如何DIY激光可燃气体传感器,从TDLAS原理到STM32实战,包括硬件选型、光路搭建、电子系统设计和嵌入式软件开发。通过TDLAS技术实现高灵敏度甲烷检测,适合工业安全和环境监测应用。附有完整代码和实用调试技巧,帮助开发者快速掌握光学气体检测技术。

fanta的博客 444

Hello,Spider!入门第一个爬虫程序

年轻人的第一个爬虫程序!Hello Spider!

记录学习路上的一些拙见 2476

暗月项目七详解

本文围绕“暗月靶场项目七”展开,记录了一次从外网 Web 入口逐步深入内网并最终获取域控目标的完整实训过程。

Re_K123的博客 419

华为OD新系统机试真题-文章特征提取

华为OD机试新系统真题 【文章特征提取】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD新系统机试真题【文章特征提取】

qq_45776114的博客 736

python爬虫:定位目标数据位置(一)

python爬虫中,定位目标数据位置是很关键的一步,今天就来讲其中的一种方法,也是最基础的一种方法。 首先怎么看一个网页的源代码,例如打开知乎首页(网址:https://www.zhihu.com/explore),在网页任意空白处单击右键,然后点击【查看网页源代码】选项,就可以查看源代码了: 源代码如下: 如果你是用Chrome浏览器,也可以直接在网页前面加前缀view-source:如,view-source:https://www.zhihu.com/explore,也是可以找到网页源代码。 网页源

weixin_48697341的博客 3719

雷达方程从零开始的详细推导及实现

通过以上六步,我们从最基本的物理图像出发,完整地推导出了雷达方程。初学者可以按照这个逻辑,自己在纸上一步步重现整个过程。Python实现。

VectorShift的博客 339

【论文投稿】Python 网络爬虫:探秘网页数据抓取的奇妙世界

在当今数字化信息呈爆炸式增长的时代,网络爬虫宛如一把神奇的钥匙,开启了通往海量数据宝藏的大门。无论是商业领域的市场情报搜集、科研工作中的资料聚合,还是个人兴趣驱动下的信息整合,网络爬虫都展现出了无与伦比的价值。今天,就让我们一同走进 Python 网络爬虫的精彩世界,探索其中的奥秘。Python 网络爬虫为我们打开了一扇通往无限数据世界的大门,在商业、科研、生活等各个领域释放出巨大能量。通过掌握requestsScrapy等核心工具和框架,我们能够披荆斩棘,克服重重挑战,从网页的海洋中挖掘出珍贵的数据宝藏。

来自想要赚大钱的小周同学 9504

第三天:Python基础语法详解

Python代码规范与注释最佳实践 摘要: 本文深度解析Python缩进规则与代码结构的技术规范,包括缩进的底层原理、语法规则和错误处理。详细阐述Python注释系统,涵盖行内注释、文档字符串和类型注释等多种形式,并提供工业级代码组织方案。研究显示,良好的缩进可提升40%的代码识别速度,降低50%的认知负荷。文章还对比了Sphinx、pdoc等主流文档生成工具,给出企业级项目中的注释编写原则和模板建议,帮助开发者构建更可维护的Python代码。

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 1014

笔试题-2023-大疆-数字IC设计【纯净题目版】

笔试题-2023-大疆-数字IC设计【纯净题目版】

w0shishabi的博客 2513

网络爬虫学习心得

通过这段时间的学习,我从对网络爬虫一无所知,到能够独立开发功能完善的爬虫程序,技术能力得到了显著提升。同时,培养了问题解决能力和逻辑思维,也明白了数据合规使用的重要性。​。

AlwaysAimerSS的博客 2391

【嘉立创EDA】PCB金属包边设计快捷方法

本文使用嘉立创EDA,描述如何在PCB设计时,快速增加边框包边设计,特别是金属包边(伪)——这里标记(伪)是因为该这里的包边特指不含边缘壁。请参考本文时特别注意!本文将此过程记录,以供有需要的读者参考。

l64481000的博客 1751

Python网络爬虫:从入门到实践

从基础的HTTP请求和网页解析,到功能强大的Scrapy框架,再到应对反爬虫机制,每一步都需要我们不断学习和实践。- BeautifulSoup:它可以将复杂的HTML文档转化为一个复杂的树形结构,每个节点都是Python对象,方便我们进行数据提取。Scrapy是一个功能强大的Python爬虫框架,它提供了一套完整的解决方案,包括数据抓取、数据处理、持久化存储等。- 设置User - Agent池:准备多个不同的User - Agent,在发送请求时随机选择,模拟真实浏览器请求。四、反爬虫机制与应对策略。

m0_73774547的博客 1910

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Python网络爬虫技术

通过学习和实践书中的内容,我不仅掌握了爬虫的基本原理和方法,还积累了丰富的实践经验,也对网络爬虫有了更深入的理解和思考。通过这门课程的学习,我收获颇丰,不仅掌握了爬虫的基本原理与操作,更深刻领悟到数据获取背后的责任与智慧。通过《Python 网络爬虫技术》这门课程的学习,我不仅掌握了一项实用的编程技能,更学会了如何在技术的海洋中保持清醒的头脑,遵循道德和法律的准则。未来,我将继续深入学习,不断提升自己的技术水平,同时牢记责任与担当,让网络爬虫技术成为助力我前行的有力工具,为解决实际问题贡献自己的一份力量。

shenjue02的博客 1417

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

网络爬虫科普:原理、类型、策略与常用工具

网络爬虫在当今互联网时代扮演着极为重要的角色,它能帮助我们从海量的网络信息中提取出有价值的数据。以下将从网络爬虫的基本概念、工作流程、类型、搜索策略以及常用工具等方面进行详细科普介绍。

Da_Zhuang的博客 2324

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

上一篇: Python实现手写体数字图片识别+GUI界面+画板数字识别
下一篇: 用Python爬取天气并且语言播报!
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值