如何查看scrapy 爬取过程中的报错,有解决方案的哦!

解决Scrapy报错: Unknown Command ‘crawl‘ 解决Scrapy报错: Unknown Command 'crawl'问题描述:报错:原因分析:解决方案: 问题描述: 编写好的项目(douban)在终端cmd运行 scrapy crawl douban可以运行。但通过vs code创建main.py却无法运行,出现报错’unknow command: crawl’ 。 报错: 在vs code中创建main.py运行douban from scrapy import cmdline cmdline.execute(['scrapy','crawl' 阅读详情

常见报错及解决方法


1. 缺请求头的报错,请求403

在setting文件加上请求头即可,修改完记得保存。

这个会在检查完环境之后,开启爬虫准备爬取时显示出错误,看到403,一般就是被反爬了,先检查一下请求头。


2. items没传、少传值或者不对应

报错:KeyError: 'DoubanItem does not support field: title1'

对应的,在items文件中,加上或修改相关的变量即可。


3. 没有项目

报错:KeyError: 'Spider not found: douban'

是否存在?是否保存?


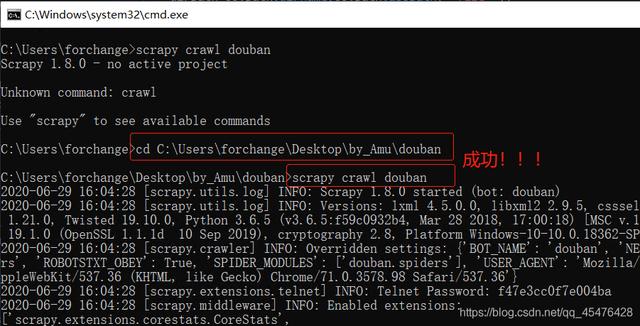
4. 运行不了问题:Unknown command: crawl

在cmd或者终端中运行报错:

切换到项目目录下,再执行

关于Unknown command: crawl更详细的解读,可以参考文章:https://blog.youkuaiyun.com/qq_45476428/article/details/108719410

关于scrapy的运行结果解读,参考:https://blog.youkuaiyun.com/qq_45476428/article/details/108701932


小彩蛋

其实,还可以把scrapy的运行结果设置不要打印到终端,当有报错直接抛出来即可。

方法一:在终端或cmd中运行,改为下面命令执行

scrapy crawl douban -s LOG_FILE=spider.log# douban 改为你的项目名字

方法二:在编辑器中运行,直接在setting.py 文件中添加以下代码:

# setting.py 文件中添加以下代码,即可去掉打印结果 LOG_LEVEL="WARNING"

方法三:在编辑器中运行,在setting.py 文件中添加以下5行代码:

# setting.py 文件中添加以下5行代码,去掉打印结果, LOG_FILE = "spider.log"LOG_STDOUT = True FEED_URI='output.csv'FEED_FORMAT='csv'FEED_EXPORT_ENCODING='ansi'


解决:python爬取豆瓣电影遇到的KeyError: 'subject_collection_items'错误 今天在学习爬虫,爬取豆瓣电影的一些json资料存到本地的时候遇到了一些问题,先解释一下: 在豆瓣手机版的“正在热映”页面里可以找到一些包,里面有当前页的内容(json格式): 所以requests模块可以去爬这些下来: 找到url,然后找到提交规律url里是用的start来表示当前页面显示的是哪些片。 还可以找到数据都放在subject_collection_items下面: ... 阅读详情

相关推荐

scrapy获取数据的一些问题与解决

前言 我们采用scrapy 爬取了一些游戏数据,这里对遇到的一些技术问题 的解决情况 项目情况 爬虫的逻辑是比较简单的,有一个进程从 任务队列中 拿到 相应的任务(一般是url),去请求,拿到html/json/…后 进行解析,解析完后自己选择做什么,比如:1,把解析后的数据存起来,2,解析后发现有想用的url,重新把这些个url当作一个任务扔到 任务队列中. 我们的爬虫任务有挺多的,如 游戏的i...

mingover的专栏 1435

如何查看scrapy 爬取过程中的报错(附解决方法及运行结果解读)

文末有彩蛋~~ 常见报错及解决方法 2.1 缺请求头的报错,请求403 在setting文件加上请求头即可,修改完记得保存。 这个会在检查完环境之后,开启爬虫准备爬取时显示出错误,看到403,一般就是被反爬了,先检查一下请求头。 2.2 items没传、少传值或者不对应 报错:KeyError: 'DoubanItem does not support field: title1' 对应的,在items文件中,加上或修改相关的变量即可。 2.3 没有项目 ...

明而决之 5446

使用scrapy框架爬取数据

一、环境准备 首先我采用anacoda环境,需要首先建造一个项目,并激活 建立一个爬虫项目: conda create -n Spider python == 3.6.2 conda create -n Spider python == 3.6.2 然后激活环境 activate Spider 再此环境下需要下载scrapy模块和pywin32模块 pip install sc...

珂鸣玉的博客 4559

15.0 Scrapy 使用中出现的错误分享

文章是用来记录分享自己使用 Scrapy 的错误与解决方式。

学编程的菜恐龙的博客 986

python爬虫教程: Python利用Scrapy框架爬取豆瓣电影示例

本文实例讲述了Python利用Scrapy框架爬取豆瓣电影。分享给大家供大家参考,具体如下: 1、概念 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。 通过Python包管理工具可以很便捷地对scrapy进行安装,如果在安装中报错提示缺少依赖的包,那就通过pip安装所缺的包 pip install scrapy...

python爬虫教程 6658

利用Scrapy爬取1905电影网

本文将从以下几个方面讲解Scrapy爬虫的基本操作 Scrapy爬虫介绍 Scrapy安装 Scrapy实例——爬取1905电影网 相关资料 Scrapy 爬虫介绍Scrapy是Python开发的一个快速,高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。Scrapy吸引人的地方在于它是一个框架,任何人都可以根据

wds2006sdo的专栏 14万+

scrapy 中爬取时被重定向_如何查看scrapy 爬取过程中的报错,有解决方案的哦!...

常见报错及解决方法1. 缺请求头的报错,请求403在setting文件加上请求头即可,修改完记得保存。这个会在检查完环境之后,开启爬虫准备爬取时显示出错误,看到403,一般就是被反爬了,先检查一下请求头。2. items没传、少传值或者不对应报错:KeyError: 'DoubanItem does not support field: title1'对应的,在items文件中,加上或修改相关的变...

weixin_39922151的博客 242

scrapy爬取豆瓣top250电影数据

scrapy爬取豆瓣top250电影数据 scrapy框架 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。 scrapy的组成结构如下图所示: 图片中各层含义: Spiders(爬虫器):它负责处理所有Responses,从中分析提取数据,获取Item字段需要的数据,并将需要跟进的URL提交给引擎,再次进入Scheduler(调度器) Engine(引擎):框架核心,负责Spider、ItemPipeline、Dow

lucky_0123的博客 4410

利用Scrapy爬取豆瓣电影

1、概念 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。 通过Python包管理工具可以很便捷地对scrapy进行安装,如果在安装中报错提示缺少依赖的包,那就通过pip安装所缺的包 pip install scrapy scrapy的组成结构如下图所示 引擎Scrapy Engine,用于中转调...

theVicTory的博客 1万+

Scrapy爬取当当网畅销图书保存csv格式!最详细的教程!

、 初步了解scrapy框架爬虫的使用。 前言: 需要安装一下第三方库 在win下 pip install scrapy pip install bs4 在mac下把pip改成pip3即可 一、创建scrapy项目 在cmd运行里输入(随便找个盘) scrapy startproject dangdang 如上图创建成功,接下来在编译器中打开文件 这些文件都是自动生成的 来解释说明一下部分文件 二、代码实现——编辑爬虫 ...

爬遍所有网站 1152

微信群消息监控系统实战:从零搭建Python自动化监控平台

本文详细介绍了如何从零搭建Python微信群消息监控系统,实现自动化监控和记录群消息。通过wxauto库模拟人工操作微信,结合MySQL数据库存储和智能去重策略,系统能高效处理大量消息并支持关键词监控。文章还分享了性能优化、安全合规等实战经验,帮助开发者快速构建高效稳定的监控平台。

weixin_29091105的博客 322

使用 Scrapy + Selenium 爬取动态渲染的页面

那么如果我们想要在scrapy也获取动态加载出的数据,则必须使用selenium创建浏览器对象,然后通过该浏览器对象进行请求发送,获取动态加载的数据值. 本文分享scrapy的介绍和如何配合selenium实现动态网页的爬取。它允许用户模拟最终用户执行的常见活动;在撰写爬虫程序时, 遇到动态渲染的页面我们可以使用Scrapy+Selenium对页面规避反爬策略和爬取页面信息. 虽然webdriver影响到了Scrapy 的运行速度, 我们还可以使用scrapy-redis让我们的爬虫变成分布式以提高效率。

NHB222222的博客 1844

【雷达成像实战】RD、CS、RMA算法对比与Matlab实现:从信号处理到高清成像

本文深入对比了雷达成像中三种核心算法:经典的距离多普勒算法(RD)、基于稀疏重建的压缩感知算法(CS)以及高精度的快速多通道获取算法(RMA)。通过详细的Matlab实战代码,从原理拆解到实现步骤,分析了各自在计算效率、成像精度、数据需求和适用场景上的优劣,为工程选型与算法实践提供了清晰指南。

weixin_29095587的博客 452

scrapy实现二级页面爬取(以小说为例)

1.scrapy图解 2.创建项目 scrapy startproject 项目名 创建后的目录 3.编写字段 在items.py中编写需要的字段,这里就写小说的章节和内容 class XiaoshuoItem(scrapy.Item): # define the fields for your item here like: # name = scrapy.Field() ...

GGBond的博客 4505

PCL 八叉树的使用

八叉树(Octree)是一种空间划分的数据结构,广泛应用于三维点云的处理和分析。八叉树通过将空间递归地划分为八个子区域,可以有效地组织和索引三维点数据,提升点云的查询、降采样和配准等操作的效率。

纵马踏花向自由 1659

逆强化学习:从专家示范中学习策略

逆强化学习(Inverse Reinforcement Learning,简称IRL)是强化学习(Reinforcement Learning,简称RL)的一个子领域,它的目标是从专家的行为中学习策略。在传统的强化学习中,智能体通过与环境交互,根据奖励信号来学习一个策略。而在逆强化学习中,我们没有直接的奖励信号,而是通过观察专家的行为来推断出奖励函数,从而学习到一个与专家类似的策略。逆强化学习作为强化学习的一个重要子领域,在许多实际应用场景中都取得了显著的成功。

AI天才研究院 1453

Python.Scrapy爬取当当网畅销图书保存csv格式详细教程

前言: 需要安装一下第三方库 在win下 pip install scrapy pip install bs4 在mac下把pip改成pip3即可 文章目录一、创建scrapy项目-——1.二、代码实现——编辑爬虫-——1.-——2. 修改两个文件三、运行爬虫 一、创建scrapy项目 -——1. 在cmd运行里输入(随便找个盘) scrapy startproject dangdang 如上图创建成功,接下来在编译器中打开文件 这些文件都是自动生成的 来解释说明一下部分文件 .

weixin_51277037的博客 4481

Moviepy自动化剪辑视频中的广告

本教程展示了如何使用 Python 中的 MoviePy 库,通过检测和剪辑广告段落来实现视频内容的清洁播放。通过广告检测算法和 MoviePy 剪辑功能的结合,可以自动化处理视频,极大提升编辑效率。在学习和应用中,理解广告检测的原理及其实现方法尤为重要,以便针对不同类型的视频进行调整。此外,MoviePy 的灵活性使其适用于多种视频编辑场景,适合自动化内容制作与优化。

Mr数据杨 3418

Scrapy redis中爬取卡死 解决(清除缓存)

环境: win10 py3.6 pycharm scrapy1.6 报错信息 2017-05-19 20:08:53 [scrapy.extensions.logstats] INFO: Crawled 0 pages (at 0 pages/min), scraped 0 items (at 0 items/min) 2017-05-19 20:08:53 [scrapy.extensions....

人生苦短,我用python 4405

uboot引导vxworks6.9(T4240) 启动

vxworks内核配置下搜索RAM_LOW_ADRS, 值为0x01000000, 是vxworks下载启动的地址,uboot启动时会用到。vxworks6.9 t4240用的是32地址空间,uboot下用的是64位地址空间,去uboot下修改law物理地址空间为32位。vxworks下flash基地址为 0xff000000, 将vx下的地址修改为0xe0000000,和uboot下地址一致。uboot下flash基地址为0xe000000,vxworks内核配置为build-in 符号表。

珂珂可爱多 3236

通信算法之249: DJI波形物理层

D-J-I的Lightbridge波形、Ocusync1波形、Ocusync2波形、Ocusync3波形,

leegang12的专栏 1444

python:最简单爬虫之使用Scrapy框架爬取小说

python爬虫框架中,最简单的就是Scrapy框架。执行几个命令就能生成爬虫所需的项目文件,我们只需要在对应文件中调整代码,就能实现整套的爬虫功能。 以下在开发工具PyCharm中用简单的Demo项目来演示爬取小说网站的流程。我们打开小说网首页,将要演示的是如何爬取首页小说推荐列表的小说名称、小说简介、小说作者,这三项元素内容并输出到txt文件中。

奋斗鱼 3796

秋招突击——笔试整理——8/25——拼多多笔试整理

继续加油! 转变思维,有简单到复杂,由直观到抽象,这种贪心模拟的题目一直是这样的!

Blackoutdragon的博客 2402

Python使用Scrapy框架爬取数据存入CSV文件

1. Scrapy框架   Scrapy是python下实现爬虫功能的框架,能够将数据解析、数据处理、数据存储合为一体功能的爬虫框架。 2. Scrapy安装 1. 安装依赖包 2. 安装scrapy 注意事项:scrapy和twisted存在兼容性问题,如果安装twisted版本过高,运行scrapy startproject project_name的时候会提示...

python学习者的博客 8616

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

上一篇: Python利用google翻译,翻译字幕文件!我想翻译日语!
下一篇: 用selenium爬取淘宝商品信息!听说这个项目值五百?
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值