因为穷按着学大模型的野路子 成功从前端转行38K大模型

Kimi K2.5与GLM-4.7实战选型:开源大模型部署与协同工作流指南 开源大模型并非参数越大越好,其真实价值体现在本地可部署性、结构化输出能力与多模态理解等工程落地维度。Kimi K2.5采用动态稀疏MoE架构,擅长任务感知的算力调度和复杂文档/图表联合推理;GLM-4.7则通过结构感知剪枝实现轻量化高密度参数设计,在JSON生成、低延迟API响应和中小企业级稳定部署中表现突出。二者差异本质是‘可能性探索’与‘确定性交付’的技术哲学分野,适用于科研假设生成、开发者工作流构建及制造业边缘推理等不同场景。本文基于17轮真实切换经验,聚焦显存优化、量化部署、Agent协同与输入格式 阅读详情

给所有前端零基础转大模型的同学,分享一套真实可落地、普通人能吃透的90天转行上岸路线。无天赋、无科班优势、无算法底子,完全靠阶段性精准学习成功转型,非常适合被裁、想转赛道、零基础小白参考。

一、前端转AI:天然优势 & 必须补齐的短板

✅ 现有优势(可以直接复用) 1. 熟悉HTTP、接口请求、JSON结构、前后端联调,适配模型服务部署、API对接场景; 2. 掌握Git、Linux基础操作,配环境、跑项目比纯零基础新手快很多; 3. 具备工程化思维,更擅长落地项目、排查业务问题,适配企业AI应用岗需求。

❌ 必须补齐的核心短板 Python数据科学库零基础、矩阵/张量概念薄弱、深度学习原理空白、Transformer完全不懂、本地小显存设备跑模型极易报错。

图片

二、90天阶段性精准学习路线(不玄学、不浪费时间)

第1周:极速补齐Python数据基础不用从头啃语法(和JS逻辑互通),直接主攻Numpy、Pandas,建立向量、矩阵、张量核心概念。手动实现简单线性回归,熟悉数据处理逻辑,快速摆脱“只会打印Hello World”的阶段。

第2–3周:深度学习底层核心倍速刷机器学习基础课程,重点吃透梯度下降、反向传播、损失函数调优核心逻辑,不求面面俱到,但必须理解模型权重更新原理。同时完整搭建AI运行环境:CUDA、cuDNN、PyTorch、HuggingFace,解决驱动崩溃、环境冲突等基础问题,保证后续项目可正常运行。

第4–5周:硬啃Transformer(面试核心)放弃复杂数学推导,主打面试能用、项目能跑。吃透QKV计算逻辑、多头注意力机制、位置编码作用、Transformer完整架构。每天实操BERT-base前向推理,熟悉模型输入输出链路,能独立画图、口述原理,应对八股追问。

第6–7周:LoRA单卡微调实战(核心项目能力)主攻企业主流轻量微调方案,使用LLaMA-Factory框架,适配低显存设备。针对性解决OOM显存溢出问题,通过调小batchsize、缩短max_length适配本地6G显存。完成多组数据集微调,掌握数据清洗、噪音过滤、loss调优、模型效果对比的完整流程。

第8–9周:落地2个简历刚需项目(上岸关键)1. 大模型微调客服问答系统:自行采集、清洗对话数据,完成SFT微调,部署为API服务,可稳定响应业务问题; 2. 企业RAG知识库系统:实现文档切片、向量化存储、相似度检索、上下文问答,掌握ChromaDB向量库使用、检索优化、幻觉抑制方案。 所有Bug、报错、优化方案全部复盘,作为面试核心谈资。

最后3周:面试冲刺刷题复盘专攻大模型高频八股:SFT预训练区别、LoRA/Adapter微调差异、RLHF核心流程、显存优化策略、vLLM推理加速、Prompt工程规范。算法不深究难题,只刷Python、SQL简单题,重心放在项目复盘、问题拆解、工程落地。

图片

三、面试核心答题思路(通过率极高)面试官重点追问:数据清洗规则、模型选型理由、超参设置依据、loss不下降解决方案、显存优化方案、RAG检索优化策略。 核心原则:不背标准答案,只讲自己实操踩坑、排查、优化的真实过程,真诚且有细节,远超模板化回答。

图片

四、转行核心总结前端转大模型,不需要天赋、不需要深厚算法功底,最怕盲目啃论文、死磕推导、追求玄学知识点。普通人上岸的核心:重工程、重落地、重项目细节、精准对标岗位需求。3个月系统深耕,完全足够从页面仔转型AI应用开发。

图片

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?

别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书
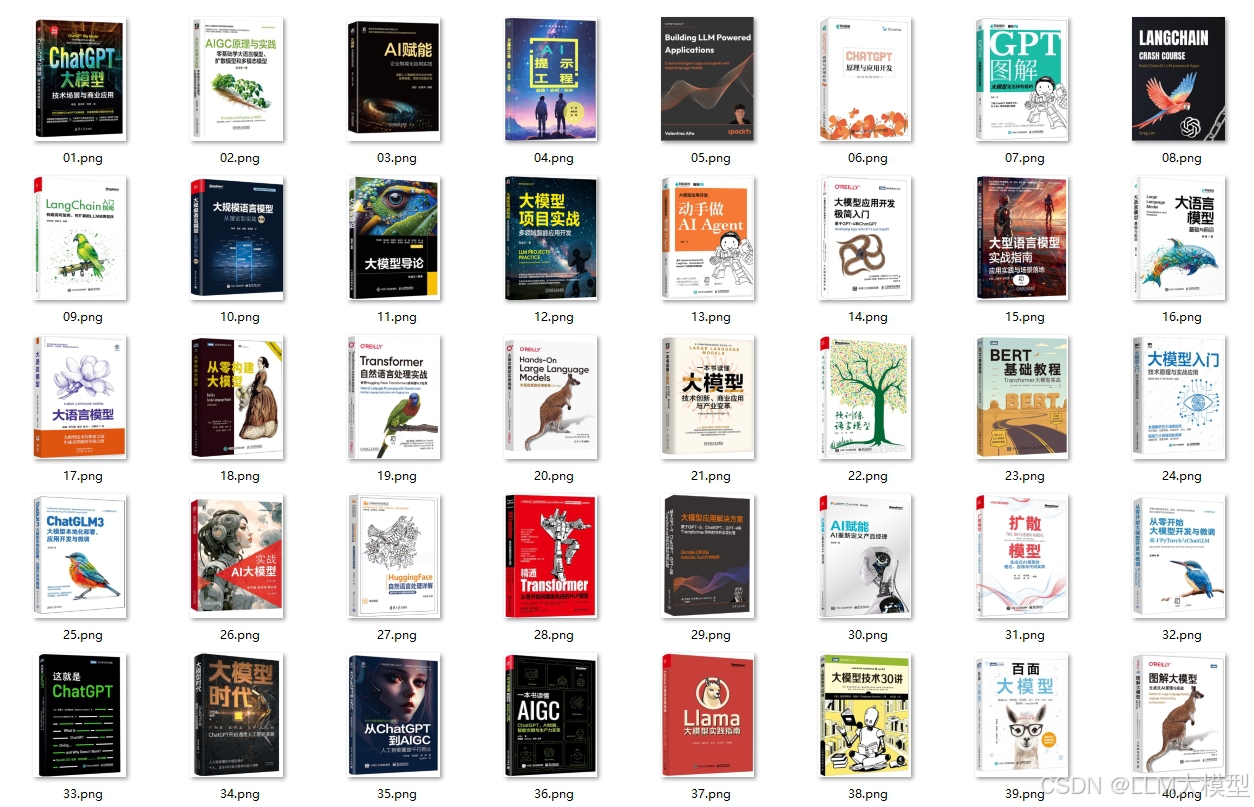
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
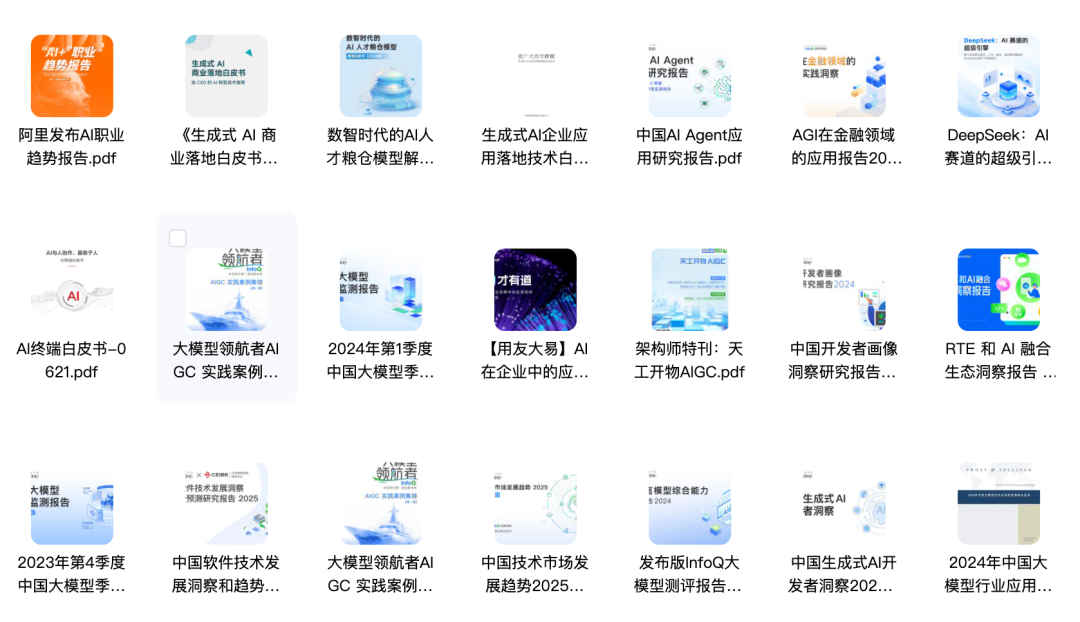
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

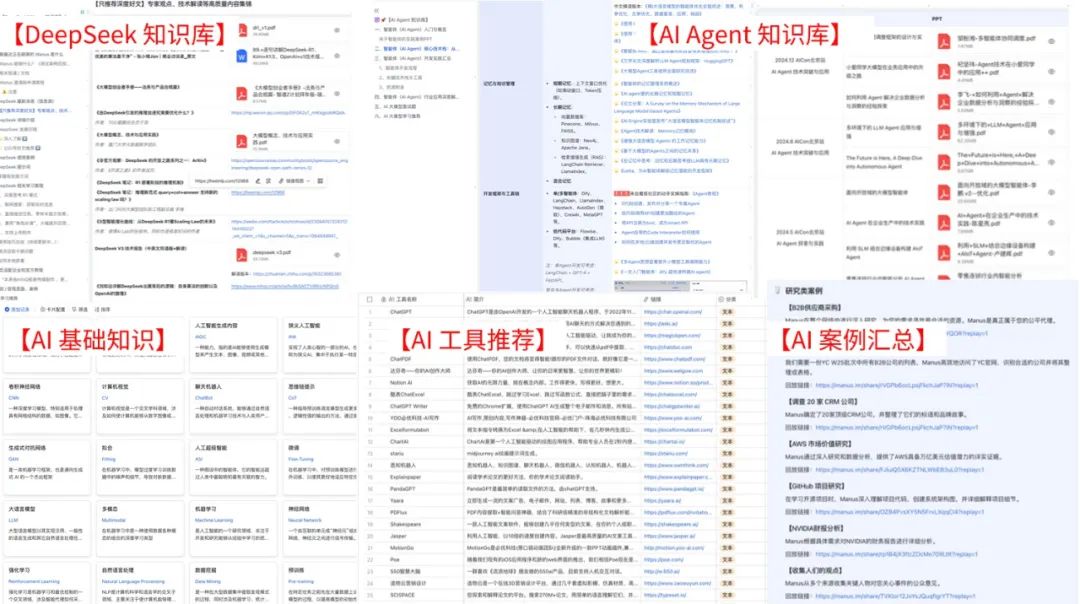
3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
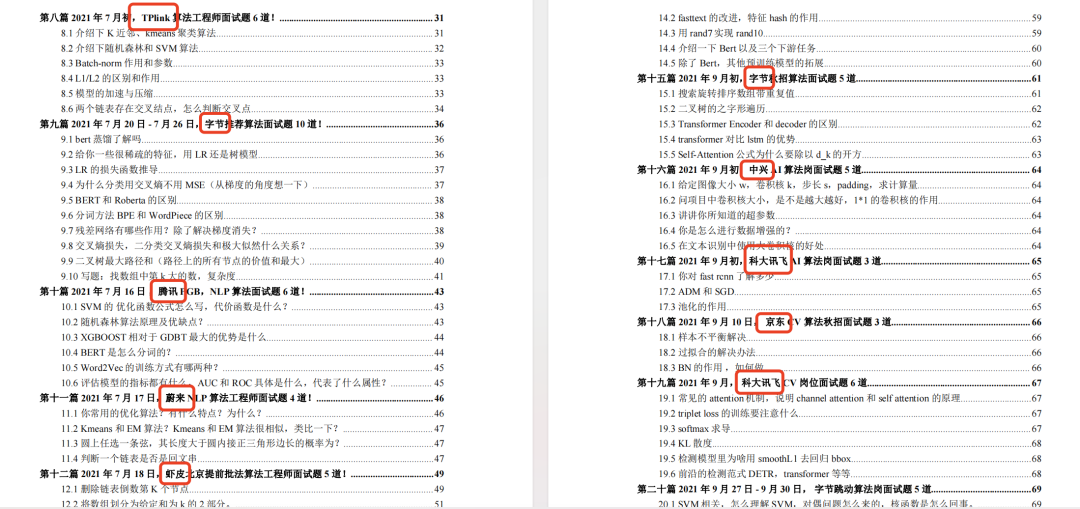
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
2. 102 道 AI 大模型真题:直击大模型核心考点

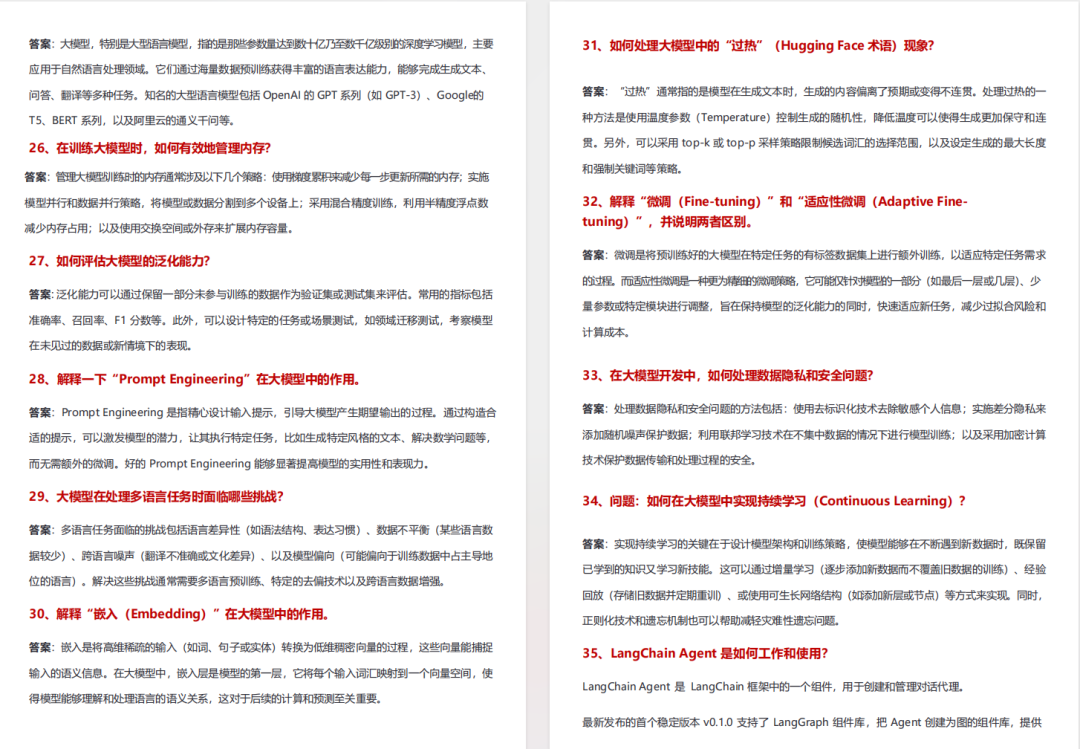
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

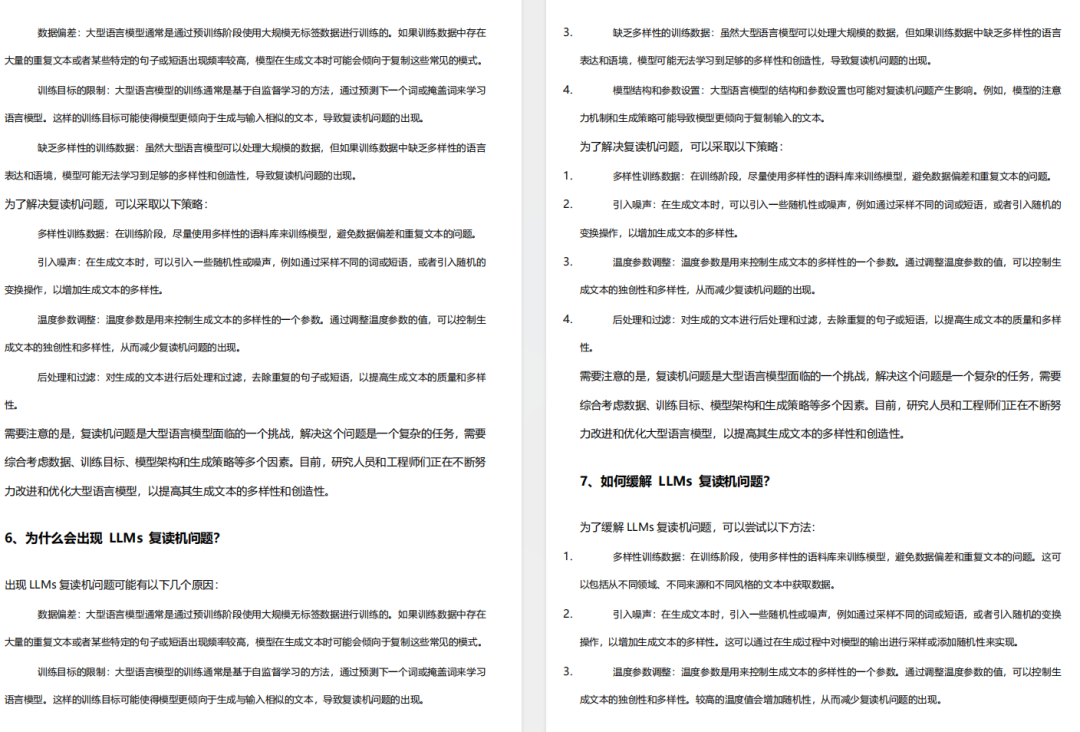
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

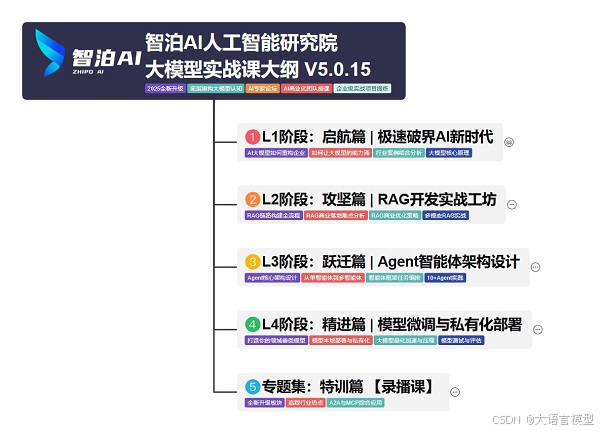
三、路线必明:AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
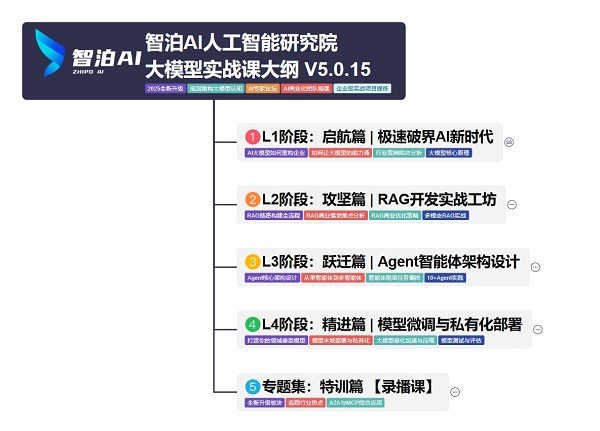
img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
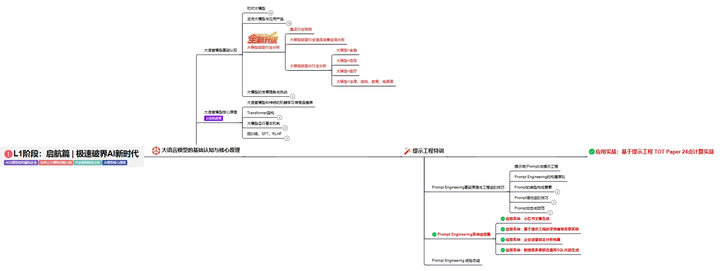
img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
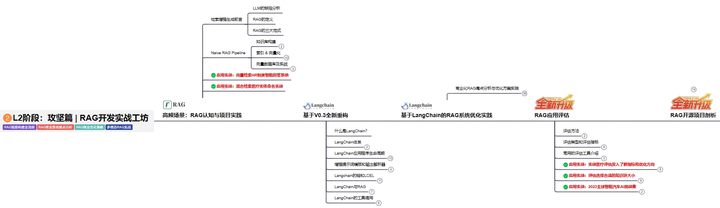
img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
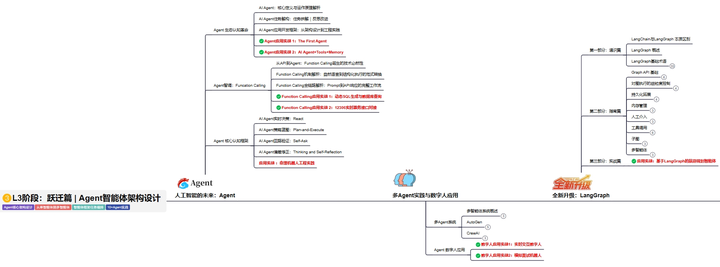
img

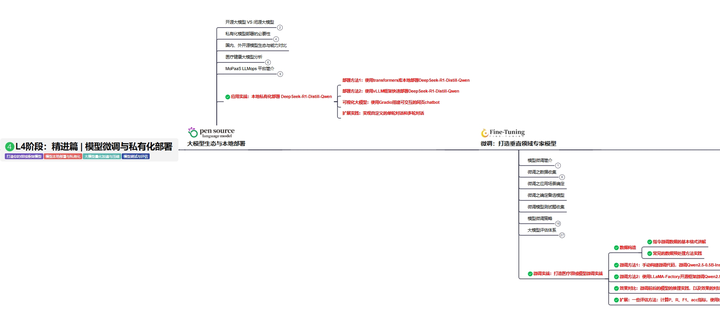
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

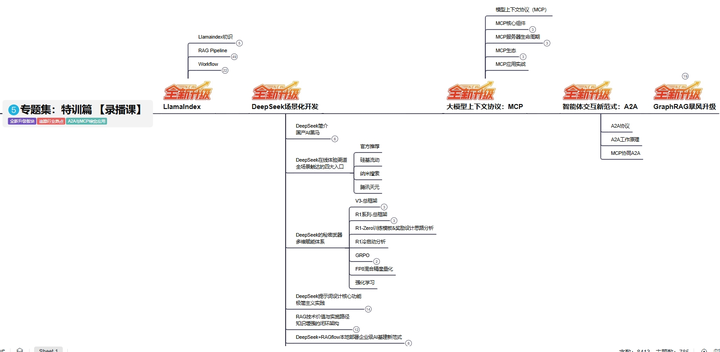
L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

Qwen3.5 CPU本地部署:262K上下文与120 tokens/s实操指南 大语言模型本地推理正从GPU依赖走向CPU普惠化,其核心在于模型量化、内存管理与指令集优化的协同突破。AWQ 4bit量化在精度与体积间取得关键平衡,结合ExLlamaV2的分块KV缓存与内存池预分配,可稳定支撑262K超长上下文;而AVX-512 VNNI等CPU向量指令则显著提升token生成吞吐。这类技术路径不仅降低硬件门槛,更使大模型真正嵌入办公、教育与开发等轻量级生产场景——无需独显、不依赖云服务、全链路本地可控。本文即围绕Qwen3.5在通用x86/ARM设备上的高可用CPU推理实践展开,覆盖量 阅读详情

相关推荐

vLLM部署Llama系列大模型实战指南

大语言模型推理引擎是支撑私有化AI服务的核心基础设施,其性能直接决定低延迟、高吞吐与显存效率。vLLM凭借PagedAttention内存管理与Continuous Batching动态批处理技术,显著提升KV Cache利用率和请求吞吐能力,已成为Llama、Qwen等Decoder-only架构模型的首选推理框架。相比transformers静态批处理易OOM、llama.cpp CPU推理延迟抖动大等局限,vLLM在A10/A100等主流GPU上实现实测128+ QPS与亚秒级P99延迟,同时原生兼容

anwenzhao0749的博客 482

拐点2017

h5版(https://imgss.github.io/demo/2017/) 图片拍于2017-1-22,山西 1-3月 从CCS到CSS CCS,中国船级社的简写;CSS,层叠样式表的简写。 这两个缩写来自两个不同的行业,一个来自传统重工业,一个来自半新不旧的互联网,从前者到后者,看起来跨度还是有点大的。所幸互联网是个包容性很强的行业,半路出家的野路子不在少数。单单...

weixin_30879833的博客 180

中文大模型能力地图:DeepSeek、通义、混元、文心、豆包实战选型指南

大语言模型不是参数堆砌的黑箱,而是基于训练数据密度、推理优化路径和指令理解颗粒度形成的场景化智能体。理解其底层原理,才能摆脱‘谁更强’的误区,转向‘谁更适配’的工程实践。DeepSeek在代码与逻辑推演中展现高结构化+高语义优势,通义凭借政务语料密度成为体制内文书首选,混元依托方言词典与地域感知实现文化适配突破,文心擅长教育认知路径设计,豆包则以社交语料驱动情绪化内容生成。本文聚焦真实API调用表现、响应稳定性与长程记忆衰减等隐形指标,为金融、政务、制造、教育等垂直领域提供可落地的混合调用策略。

weixin_34115824的博客 496

Kimi K2.5 Agent能力深度评测:多步协同、长上下文与跨模态对齐实战分析

AI Agent并非简单调用API,而是具备状态感知、意图理解与动态决策能力的智能体。其核心原理在于将任务建模为有状态流程,依托长上下文维持对话一致性,并通过跨模态对齐实现图文指令精准响应。技术价值体现在复杂业务链路中的稳定性、低失败率与高容错性,广泛应用于智能报销、IT工单处理、合同审核等企业级场景。本文基于真实压力测试,聚焦多步工具调用协同与长上下文状态保持两大热词,解析Kimi K2.5在生产环境中的可用边界与工程落地关键路径。

weixin_33896726的博客 445

大模型原生能力崛起导致中间层蒸发:RAG、微调与提示引擎的归零趋势

在大模型工程实践中,'中间层'指代向量检索、领域微调、提示编排等传统增强模块,其存在基础正被Claude 3.5 Sonnet等新一代模型的原生多文档理解、上下文消解与系统指令执行能力所覆盖。技术原理上,模型前向计算已内聚原本分散的检索-重排-生成链路,实现端到端折叠;由此带来显著的技术价值——降低延迟累加、提升质量延迟比(QLR)、释放SRE运维负担。典型应用场景包括金融合同比对、电商客服知识问答、法律文书分析等需高精度语义理解的任务。当自建FAISS服务或LoRA微调方案的F1值低于模型原生能力70%,

weixin_30924239的博客 462

本地运行Llama 3实战指南:零基础在笔记本部署AI开发环境

大语言模型(LLM)正从云端服务演进为开发者本地基础设施,其核心价值在于离线可用性、数据主权与响应确定性。基于Transformer架构的开源模型如Llama系列,通过量化压缩(GGUF格式)和轻量推理引擎(llama.cpp/Ollama),已可在8GB内存笔记本上实现45+ token/s的稳定推理。这种端侧AI能力不再依赖API调用,而是以CLI工具、VSCode插件和RAG应用等形式深度嵌入日常开发流——尤其适合处理敏感代码审查、私有文档问答、合规报告生成等强隐私场景。本文聚焦Llama 3的本地化

wjxbj的博客 533

DeepSeek-R1本地部署实战:绕过Ollama限制的全链路方案

大语言模型本地化部署是保障数据安全、低延迟响应与深度定制的核心路径。其本质涉及模型加载、推理优化、资源调度与生产运维四大技术层次。DeepSeek-R1作为典型MoE架构模型,对Ollama等轻量级运行时提出严峻挑战——标准pull流程失效、显存爆炸、长上下文崩溃等问题频发。根本原因在于MoE动态专家调度与现有工具链不匹配,叠加国内网络环境下HuggingFace直连失败、镜像源缺失等现实约束。本文聚焦‘能跑’到‘稳跑’的关键跃迁,系统拆解权重离线获取、ollama国内镜像源适配、MoE量化卸载、Paged

weixin_34242509的博客 436

Claude归零层解析:语义保真度校验环的工程重构

大语言模型推理中的‘语义保真度’是保障输出逻辑一致与事实准确的核心概念,其传统实现依赖实时、全量的动态校验机制,导致计算冗余与延迟不可控。Anthropic通过将校验功能解耦为状态锚点生成与轻量级状态机,实现了从‘实时计算’到‘状态感知’的范式迁移,显著降低GPU算力消耗并提升首token确定性。该技术本质是推理链路的结构性精简,带来低延迟、高稳定性与成本阶梯式下降等工程价值,广泛适用于RAG增强检索、合规审查、客服对话引擎等对响应确定性要求严苛的生产场景。

weixin_30482181的博客 500

DeepSeek-V4 Pro长上下文与混合注意力技术解析

大语言模型的长上下文能力并非单纯扩大token窗口,而是关乎信息检索效率、推理稳定性与工程可用性。传统Transformer在百万级上下文中面临计算爆炸与信息衰减双重瓶颈,CSA(压缩稀疏注意力)与HCA(重度压缩注意力)混合机制通过语义分块、层级索引与硬件感知优化,实现KV缓存降低90%、显存占用下降73%的技术突破。这种设计使模型能在真实工程场景中稳定定位跨文件Bug、保持多轮重构一致性,并支撑百万token级源码级分析。结合两段式专家蒸馏训练与档位化推理调度,V4-Pro将编程理解从语法补全升维至架构

weixin_33749131的博客 496

Claude推理优化新范式:token级动态跳过实现计算归零

大语言模型推理优化正从静态压缩转向动态执行——核心在于识别并跳过对语义贡献极低的token所触发的冗余计算。基于Transformer架构的稀疏化执行机制,通过轻量gate head在前向传播中实时决策FFN层跳过,实现毫秒级计算卸载与显存释放。该技术不依赖模型剪枝或量化,保留完整语义能力,显著提升高并发API、边缘部署及按token计费场景下的推理效率与成本效益。本文聚焦Claude模型推理优化与token级动态跳过两大关键技术落地实践。

csobhtdx34120的博客 462

Claude归零层解析:语义校验环的剥离与推理效率革命

大语言模型推理中的‘语义保真度校验’是保障输出一致性的重要机制,但传统实时全量校验带来显著计算冗余与延迟波动。Anthropic通过将校验逻辑解耦为静态知识锚点(SKA)与动态决策快照(DDS),实现从‘每步必检’到‘关键节点治理’的范式升级。该技术大幅降低GPU显存占用、压缩P99延迟标准差,并提升长上下文处理稳定性。其核心价值在于以架构精简替代参数堆叠,在不牺牲语义连贯性与事实准确性的前提下,释放硬件资源密度。适用于法律合同解析、RAG增强检索、多轮客服对话等对确定性与低延迟双敏感的工业级场景。

weixin_30892889的博客 435

ChatGPT识图分析实操指南:从拍照到精准识别的完整链路

多模态大模型的视觉理解能力正从实验室走向日常生产力工具,其核心在于图像输入→语义解析→结构化输出的技术闭环。GPT-4o已突破传统OCR局限,支持布局感知、自适应增强与多步推理,但实际效果高度依赖图像质量、模型版本及提问方式三大前提。理解其视觉编码器的patch size限制、语义盲区与单帧处理特性,是规避幻觉与误判的关键。本文聚焦真实场景下的可复现操作——涵盖手机拍摄黄金三角法则、HEIC转JPEG等格式预处理、EXIF元数据剥离,以及‘角色+任务+约束’式精准提问范式,助力用户在教育、工程、法律、消费等

weixin_34049948的博客 495

PHASER:面向VLA模型的相位感知经验回放框架

在视觉-语言-动作(VLA)智能体训练中,传统经验回放因忽略动作执行的时序相位连续性,导致策略在‘抬手→前伸’‘接触→握持’等关键过渡环节频繁失效。其本质是马尔可夫假设在具身任务中的崩塌——下一状态不仅取决于当前状态与动作,更依赖动作所处的隐式相位进度。PHASER通过将相位信息显式建模为可学习的置信度向量φ∈ℝ^k,重构经验样本的元数据结构,实现从离散快照到连续相位流的范式升级。该技术显著提升机械臂任务成功率(63%→89%),尤其适用于高精度对准、多阶段装配等强时序耦合场景,为机器人仿真、工业质检与手术

z466459262的专栏 407

codes外网访问实战:frp穿透8091端口与HTTPS全链路部署

codes作为典型的企业级本地化研发管理平台,其外网访问本质是内网服务暴露问题,涉及非标端口(如8091)、WebSocket长连接、跨域策略及HTTPS终结等核心网络原理。技术价值在于打通研发流程断点,支撑远程协同、故障应急与外包接入等真实场景。需兼顾协议兼容性(HTTP/HTTPS/WebSocket)、连接稳定性(NAT保活、心跳机制)和安全合规(TLS卸载、CORS精确控制)。本文聚焦生产级落地,覆盖frp穿透配置、codes服务改造、Nginx+Certbot自动化证书管理等关键环节,特别适配80

weixin_30530939的博客 544

OpenClaw直读同花顺内存实现AI盯盘实战指南

Windows桌面级金融软件如同花顺,因其封闭架构与私有协议,长期缺乏标准API支持,导致普通用户难以接入AI分析工具。本文围绕进程内存读取这一底层技术路径,解析如何利用pywin32、psutil与Windows调试权限,在不依赖网络接口、不逆向DLL的前提下,稳定提取实时行情数据。该方案规避了券商API年费、Web抓包失效、UI识别漂移等常见痛点,具备强兼容性与低维护成本,适用于本地化AI盯盘、自动止盈止损、多股动态监控等散户高频场景。核心聚焦OpenClaw技能扩展与同花顺内存映射实践,让大模型真正‘

weixin_30239339的博客 467

OpenClaw:面向开发者的可插拔AI工作流引擎安装与模型管理实战

AI工作流引擎是现代本地大模型应用的核心基础设施,它通过统一CLI抽象层调度异构推理后端、技能插件与上下文管理,解决Ollama、Llama.cpp等工具碎片化协同难题。其技术价值在于降低模型切换、技能集成与环境部署的工程门槛,广泛应用于金融财报解析、医疗报告解读、代码生成等垂直场景。OpenClaw作为典型代表,以零Python依赖的Rust二进制实现跨平台兼容,并内置模型别名绑定、技能兼容性校验、安全卸载(openclaw uninstall --all)与智能裁剪(openclaw model pru

cuizhu0832的博客 374

MacBook外置硬盘装Windows全链路指南:UEFI/GPT/驱动/性能调优

Windows on external SSD for Mac 是解决Apple Silicon无法运行x86软件、Intel Mac Boot Camp限制及虚拟机性能不足的关键路径。其底层依赖UEFI固件对GPT分区与标准EFI系统分区(ESP)的识别能力,技术核心在于绕过Boot Camp图形界面限制,通过终端手动创建符合Mac硬件规范的启动结构。PCIe NVMe移动固态的随机IOPS、TRIM支持与USB协议兼容性直接决定系统响应与稳定性,而USB-C线缆供电质量、固件温度墙、NVRAM启动参数等

weixin_30824599的博客 558

Grok 4 Fast:高精度低token的双模推理引擎实战解析

大语言模型的推理效率正从‘拼参数规模’转向‘提token含金量’——即单位token承载的有效语义密度。其核心原理在于将长链推理与快速响应内化为同一模型的可切换认知模式,通过系统提示词动态调控注意力掩码与FFN激活阈值,实现推理路径的实时编排。这种架构级优化显著提升多跳搜索、结构化提取与实时响应等任务的工程落地性,尤其适用于SaaS客服、电商比价、API驱动型工具等对首响延迟敏感且需高确定性输出的场景。Grok 4 Fast正是这一技术范式的典型代表,它不靠压缩降质,而以‘智能密度’重构成本-性能平衡点。

cuanwei9356的博客 494
上一篇: 前端程序员转AI大模型开发,这一年我踩过的坑和最实用的学习路线
下一篇: 前端工程师最终会变成 AI工程师?
Llama-Turbo
博客等级 码龄4年 9901粉丝 2025原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值