我管了五年客服,上线智能客服后一线同事的反应让我意外

企业NLP落地五大实战场景:电商客服、车载语音、呼叫质检等避坑指南 自然语言处理(NLP)作为AI核心能力,其真正价值不在于模型参数大小,而在于能否在真实业务中稳定解决高确定性、高可量化的问题。从技术原理看,NLP落地依赖数据质量、任务边界清晰度与业务影响可衡量性的三重验证;其技术价值体现在降低人工干预率、提升响应确定性与保障操作安全性;典型应用场景包括电商客服机器人(意图识别+状态机)、车载语音交互(多模态上下文感知)、呼叫中心质检(ASR定制+规则引擎)、智能外呼营销(合规分层响应)及知识图谱构建(实体关系推理)。本文聚焦这五大高频落地场景,结合电商客服机器人和车载语音 阅读详情

我在一家培训机构讲了四年产品经理的课,线下线上都带过。去年开始,来问 AI 大模型怎么用的人越来越多。有回课后一个姑娘拉住我,说老师你啥时候开个 AI 提效的班,我们组天天被催着用,可没人教怎么用。

我心动了。可心动归心动,真要开课,我卡在一个问题上:我自己也就刚摸了半年,很多原理说不清,算哪门子老师。

其实在动这念头之前,我报过一个线上的 AI 课,听完更懵。老师讲了一堆词,我一句用不上。我退了,钱没退成,但想明白了:我要讲的,是反着来的,不讲词,讲活。这反而后来成了我的卖点。

我刚入行讲课那会,自己也半桶水。头几场手心出汗,怕被问住。后来是一个老讲师跟我说,学员要的不是全知,是个走过路的人指方向。这话我记了四年,现在用在大模型上,竟也合适,原来带新人这条路,换了个话题,道理没变。

先是偷偷试。我把平时备课时查资料、整大纲的活,交给大模型干。原来写一份两小时的课纲要熬一下午,现在它先出个骨架,我改。省时间,但改的时候我发现,它给的东西太满、太泛,直接念学员听不进去。我得把它当草稿,不是当答案。有回它给我列了十个模块,我一看头都大,学员哪吃得下。我把它砍到三个,每个配一个我们行业真发生过的例子,才像门课。

后来有家合作方找我,说现在 AI 课火,让我赶紧出一版。报价挺诱人。我没接,因为我自己还没想清楚讲什么。我见过同行赶鸭子上架,PPT 全是网上抄的概念,学员听完一句没记住。那种课我上讲台会心虚。那家合作方后来又来催,说再不开就错过风口了。我差点点头,转头想起一个事:上个月我自己用大模型生成的一份提纲,拿去给老学员看,人家一眼指出两处过时了的玩法。我要是没发现就讲,误人子弟的是我自己。这么一想,风口不风口我不管了,先把内容磨稳。

那周我失眠了两晚,一边是钱,一边是良心。最后我想,要是讲砸了,砸的是我四年的招牌,那点合作费不值。想通了这个,睡踏实了。这之后我反而安心了,因为想清楚了自己要讲的是什么:不是教人变专家,是教人别被那些词吓住,敢动手试。

我换个法子。先在免费的社群里做小分享,每次就讲一个具体场景。头一回讲怎么用大模型把冗长的会议纪要改成行动清单,我当场演示:把一段四十分钟的会记文字贴进去,让它按谁、做什么、几点前、找谁这几个字段整理。底下几个人跟着试,有个做运营的当场就把自己组的会记整理完了,说以前这活他得熬到下班。第二回讲怎么把一堆用户反馈归类,我拿了五十条真实吐槽,让它先分大类,再让我纠。讲完让大家当场试,有问题现场答。答不上来的,我老实说我也没搞懂,回去查了再回。

也不是每次都顺。有回一个学员当场质疑,说你这演示是我看着你自己操作的,换了我回去未必会。我没慌,让他当场拿自己手机试,卡住了我一步步带。他最后做出来了,说行,是能学会。这次之后我定了规矩,每场必须留一半时间让大家自己动手,光看没用。

这样讲了五六次,反馈比我想的好。有回一个做销售的学员课后拉住我,说他每天要把十几条客户跟进记进系统,格式乱,领导看不懂。我当场让他把一段语音转的文字丢给大模型,让它按我们定的字段整理成表。他试完愣了下,说这就省了我半小时。那一刻我确定,大家要的是这种,不是听你讲那些绕口的原理。

还有一回讲怎么用大模型查一份合同里对我方不利的条款。我拿一份真合同演示,让它把付款、违约、保密这几块拎出来标风险。底下有个做采购的学员说,他以前看合同全靠律师,自己不懂,现在至少能先过一遍心里有数。这让我觉得,我不是在教人偷懒,是教人长一点自己的本事。

但我还是有顾虑。有回讲到一个点,底下有人问,这个模型为什么有时候胡说,我答得吞吞吐吐。回来我补了这方面的资料,下一次就敢讲了。准备这些分享的时候,我自己也补了不少课。有回为了讲清楚它为什么会胡说,我翻了一晚上资料,才弄明白是它容易顺着你的话编。弄懂之后,我再加一条提醒:问它事实类的问题,一定要让它标出来源,没有来源的当没说。这条现在成了我每场必讲的。我慢慢接受一件事:老师不一定比学员全知,能把你自己走过弯路、试出来的东西讲清楚,就值这个钱。

中间也有被问住的时候。有个做设计的学员问我,能不能用它直接出可印刷的图,我说这个我没法现场保证,你试的时候注意版权和精度,出错了还是得人工校。他点点头,反而说就喜欢我这种不打包票的。这话让我松了口气,原来学员要的也不是神,是个一起趟过水的人。他那种较真,反而帮我把课讲得更实。

我这人以前讲课,总怕露短,学员问偏了就绕开。现在反而敢说不会。有回一个学员问个技术细节,我老实说这块我没碰过,你试出来教我。他后来真在群里分享了做法。那一刻我懂了,半桶水不是缺点,装满了才容易摔。

第六次分享来了二十多人,比第一次多了三倍。有个姑娘加我微信,说她回去就用我讲的方法把周报整了,领导问她最近怎么利索了。这种反馈,比合作方开的条件实在。

有个做人事的学员跟我说,她用我教的方法把一堆简历初筛了,挑出符合硬条件的,省了两天。但她也说,最后面谁还是她定,机器只帮她缩小范围。这正好印证我想讲的:工具是帮你把范围缩小,决定权别交出去。

我也慢慢摸到一个门道:越具体的活,它越好用;越要担责任的活,越得人把关。所以我的课不碰那些虚的,就盯着每天躲不掉的那些琐事。

现在我打算开的小课,就叫不上大师课,就叫实操工作坊。每期只解决三五个真问题,学员带自己的活来,现场改。我不保证你学完能怎样,我只保证我讲的每一个,都是我自己真用过的。首期名额我打算控在十五人以内,多了我顾不过来,也讲不细。价格我定得不高,先跑通再说,不图一把赚够。首期我准备就讲三块:怎么把重复文档活交给它、怎么让它帮你整理乱糟糟的信息、怎么看它答得靠不靠谱。不讲那些听不懂的词,就讲明天上班能用的。每期结束我留半小时答疑,答不了的记下来,下期还问到的我就去弄懂再讲。

写这些不是劝你也去开课,是想说,怕自己不够格这件事,往往是因为你还没真去试。试过几次,够不够格你自己就有数了。

(感悟)
我这半年反复纠结的,是怕误人子弟。后来想通了,半桶水不可怕,假装满桶才可怕。我见过太多把概念讲得满天飞、自己从没真用过的课。我的真心话是,如果你也在考虑做点 AI 相关的内容,先别急着卖,拿你身边人当听众试几次,讲不通的地方就是你还得学的地方。讲通了,自然有人愿意听。别被那种速成变现的话术带跑,慢一点,反而站得稳。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书
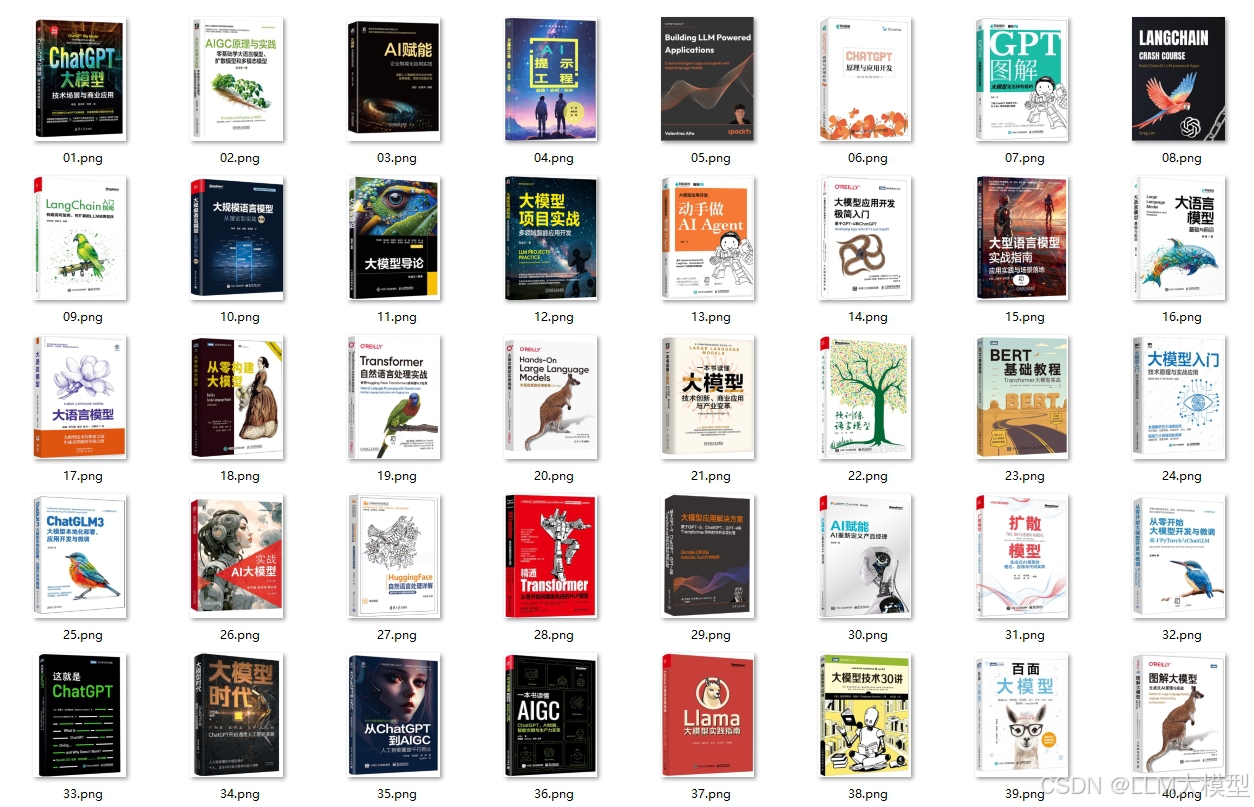
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
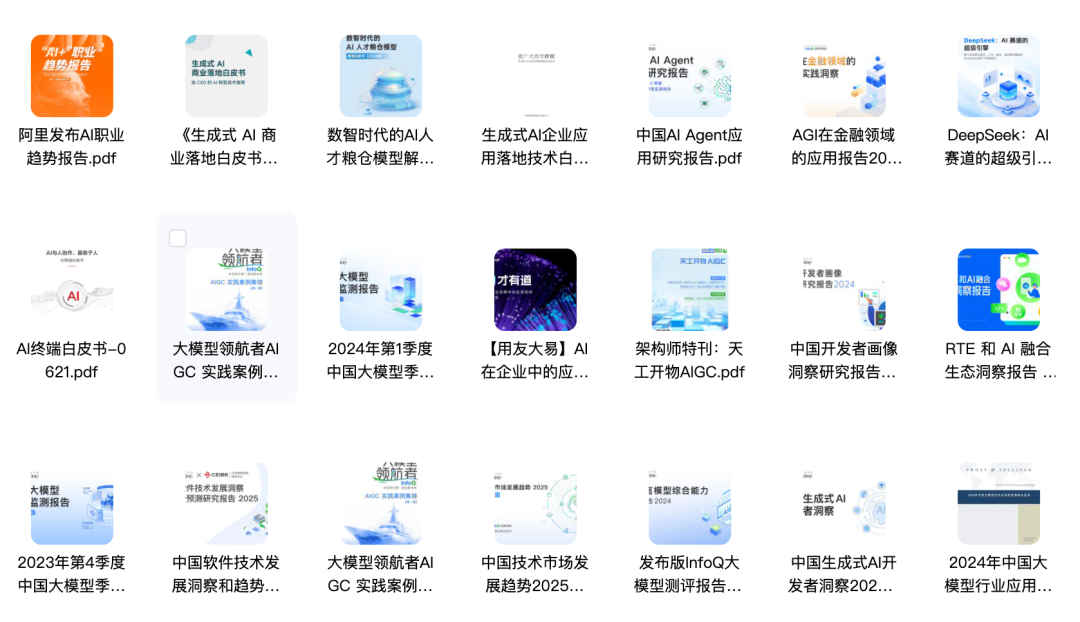
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
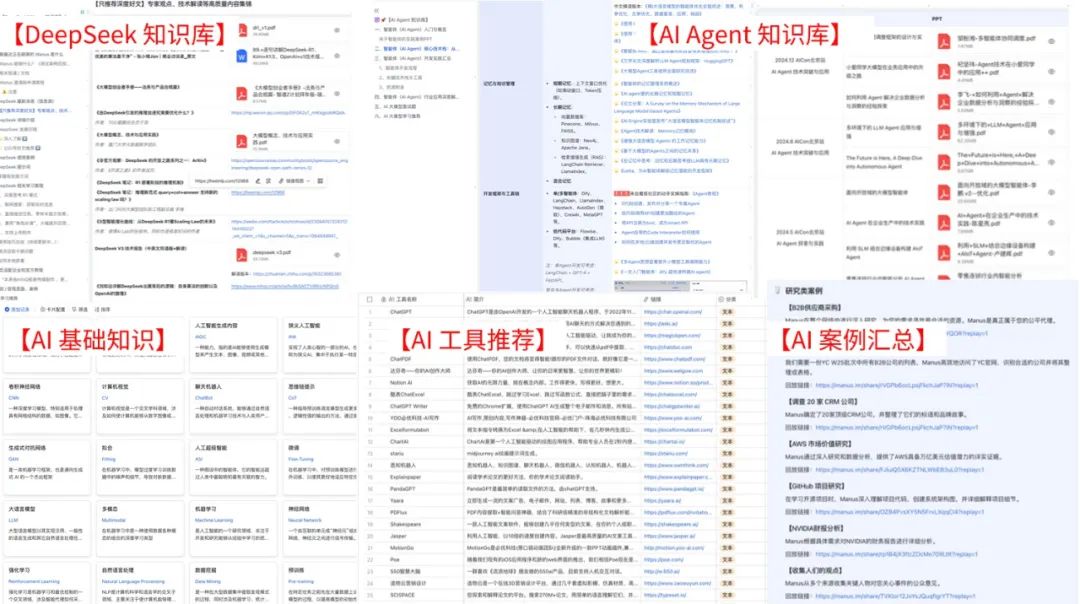
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
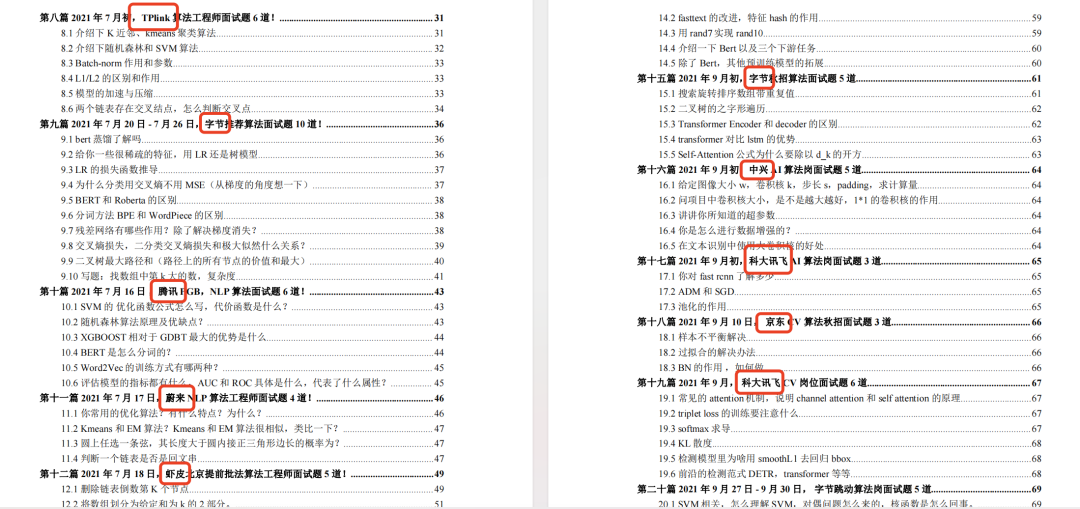
2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
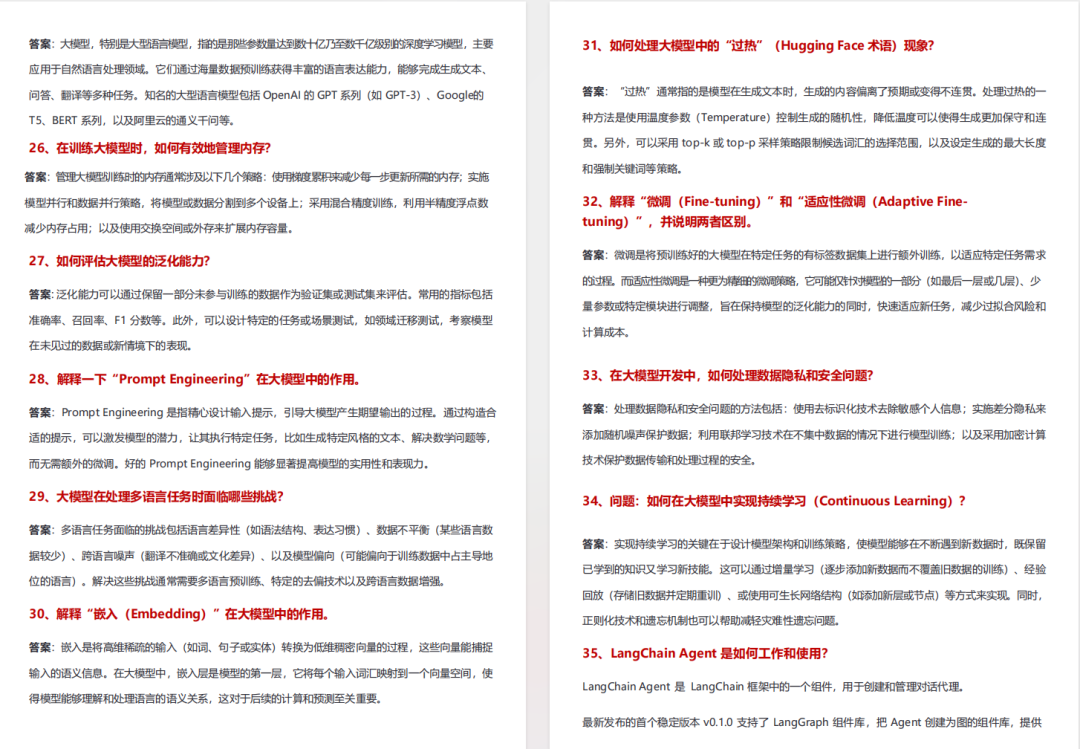
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
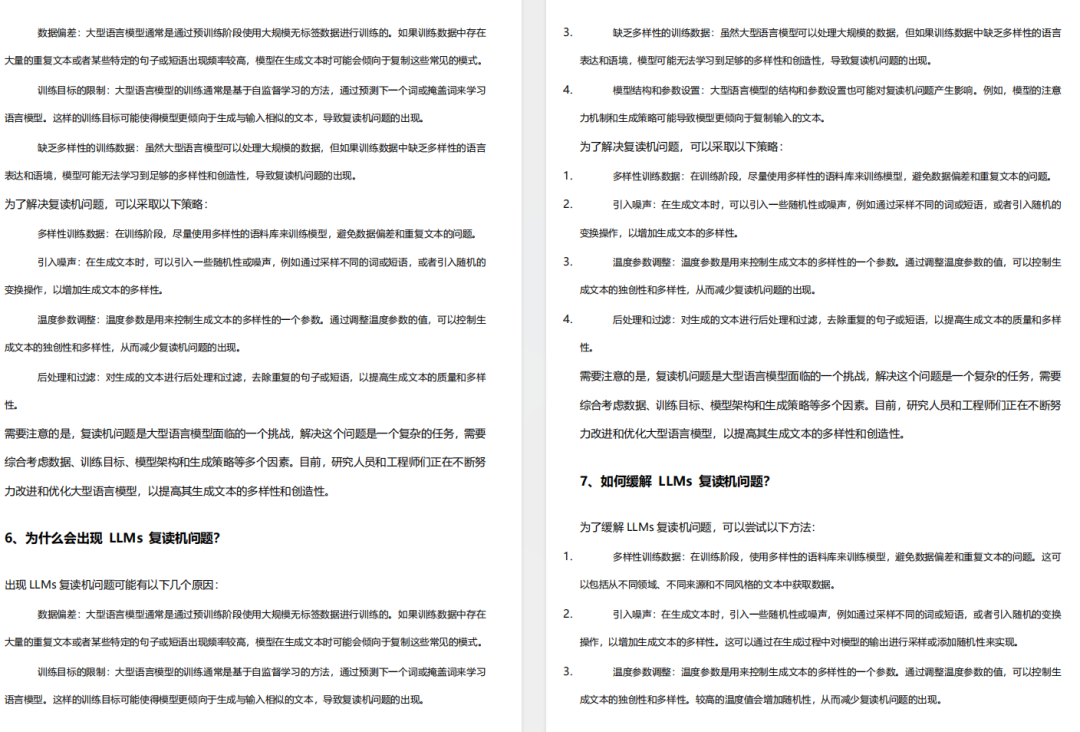

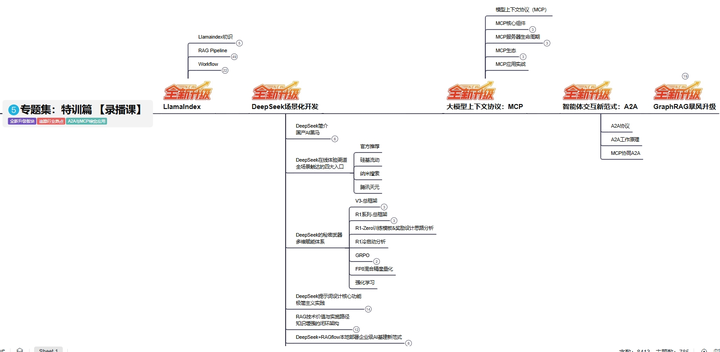
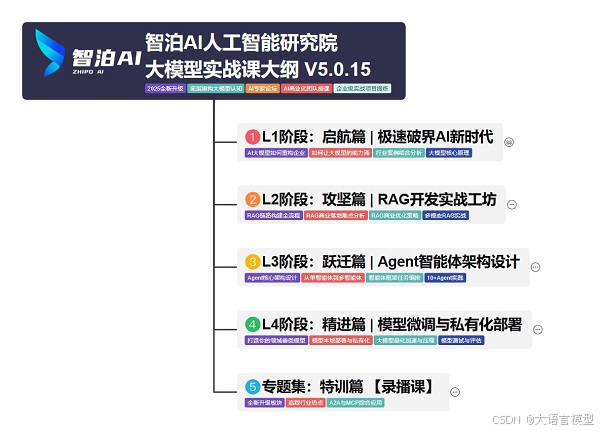
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
img

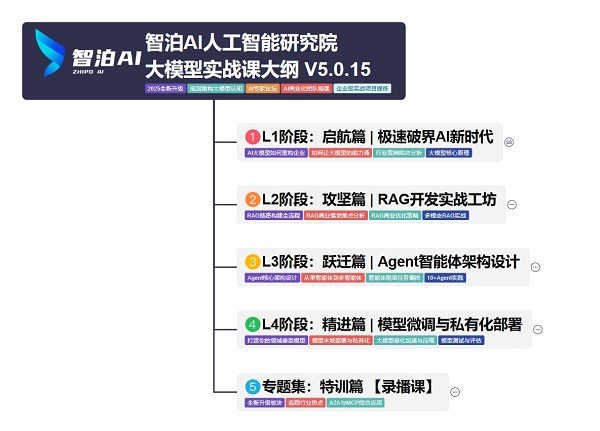
L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
img

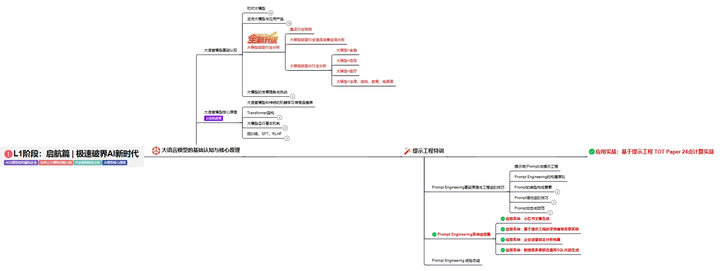
L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
img

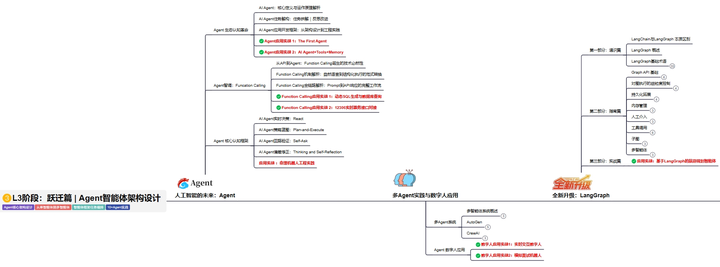
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

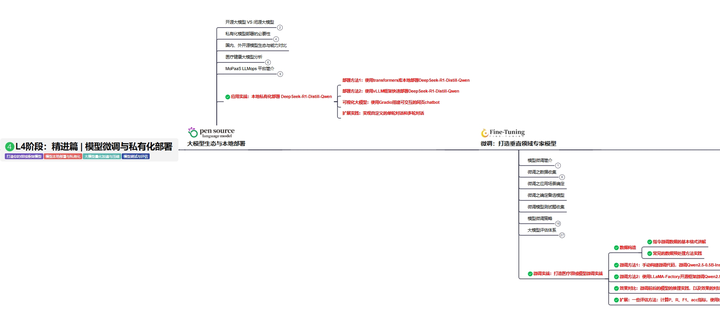
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

化学机器学习实战:分子表征与反应预测的工程化落地 分子表征是计算化学与机器学习交叉的核心基础,指将化学结构转化为可计算的数字特征,其质量直接决定模型在量子化学计算加速、ADMET预测、反应条件优化等任务中的泛化能力。原理上需兼顾拓扑结构、三维几何与量子物理属性,而非简单字符串编码;技术价值在于以低成本特征替代高成本DFT计算,显著提升研发效率;典型应用场景覆盖药物发现、催化剂设计与材料合成等小样本、高噪声、强领域约束的工业环节;本文聚焦一线化学实践者的真实工作流,深入解析ECFP4、USRCAT、DFT衍生特征等主流分子表征方法的选型逻辑、数据清洗陷阱与可 阅读详情

相关推荐

AI落地实操指南:穿透AGI hype的五年务实路径

人工智能(AI)作为当前最具变革力的技术范式,其核心价值不在于通用智能(AGI)的遥远预言,而在于窄域智能强化下的真实业务增效。从技术原理看,大语言模型本质是高阶统计压缩器,缺乏因果推理、物理世界 grounding 和持续学习能力;其可靠性瓶颈根植于目标函数设计(最大化token概率而非最小化决策损失),而非单纯的数据或算力不足。这种认知决定了AI的技术价值必须锚定在‘增强人类决策节点’而非替代角色——如RAG+规则引擎组合将保险核保人工复核率从37%压至9%,或轻量级模型重构客服流程使首次解决率提升至8

weixin_30345577的博客 524

数据导师:一线从业者向业务赋能者转型的实战路径

数据导师并非传统教育角色,而是面向企业一线数据实践者的新型能力范式——它聚焦于将真实业务问题中的分析经验、判断逻辑与验证习惯,转化为可传递、可复用、可落地的认知脚手架。其核心在于弥合业务语言与数据语言之间的认知断层,解决‘知道怎么做却说不清为什么’这一普遍卡点。依托诊断力、具象化力、渐进式设计力与反脆弱引导力四大硬核模块,数据导师帮助学员在Excel、SQL、Python等已有工具基础上,建立对指标口径、模型边界、结论可信度的深度理解。典型应用场景包括销售漏斗归因、AB测试可信验证、跨部门数据协同等高价值业

weixin_32612263的博客 320

机器学习模型上线后的72小时:生产环境稳定性实战指南

机器学习模型部署不是开发终点,而是系统稳定性的真正起点。在真实生产环境中,数据漂移、依赖服务异常、特征延迟等非算法问题,才是导致模型失效的主因。理解模型服务的运行时原理,构建具备熔断、降级、血缘追踪与漂移感知能力的MLOps系统,是保障业务连续性的技术基础。尤其在金融、电商、支付等高敏场景中,毫秒级延迟控制、可审计的决策日志、以及面向业务指标(如漏报率、GMV转化率)的监控体系,直接决定AI落地成败。本文聚焦模型上线后最关键的稳定性工程实践。

dibeichan3033的博客 346

Claude Opus 4.6凌晨空降:实测封神,你的下一位同事何必是人?

大量实测显示,Opus 4.6彻底没了前代的“偷工减料”,在面对复杂系统排错时,即便不加指令,也会表现出近乎执拗的彻底性;还攻克了困扰行业已久的“近因偏差”,即便是在20万+Token之前提到的指令,它依然能死死记住并严格执行,这种“长久专注”是处理金融审计等严肃任务的基础。Opus 4.6展现出了惊人的“长久专注”和“执行力”:它彻底告别了前代的“偷工减料”,在面对复杂的系统排错时,表现出近乎执拗的彻底性;这意味着,你的工作不再是手动点点点,而是投入创意、审美与逻辑,剩下的“苦力活”交给它。

网易智能 528

机器学习模型上线的五大生产级保障体系

机器学习模型部署不是开发终点,而是工程化落地的真正起点。在真实业务场景中,模型稳定性、性能确定性、系统集成韧性、可观测性与治理可追溯性共同构成生产级AI的核心支柱。本文围绕特征服务异常、数据漂移、协议不兼容、资源争抢等高频故障,系统拆解如何通过契约式接口、状态感知路由、三级熔断、三维健康矩阵及模型合约机制,构建抗干扰、可验证、易审计的ML系统。内容深度融合‘集成韧性’与‘可观测性’两大关键实践维度,面向风控、金融、电商等强实时要求领域,提供从混沌测试到监管就绪的全链路落地方法论。

weixin_34293059的博客 436

机器学习模型上线后如何保障生产稳定性与可靠性

机器学习模型部署不是开发终点,而是系统性工程挑战的起点。在真实业务场景中,模型需应对数据漂移、特征异常、服务延迟、组件故障等多重不确定性,其核心在于构建可观测、可降级、可审计的ML运维体系。本文围绕生产环境中的模型监控、漂移检测、压力测试、集成容错与治理合规五大维度展开,融合MLOps最佳实践与金融、电商、工业等多行业落地经验,重点解析特征契约设计、影子流量验证、五层穿透式监控、黄金三小时压力测试及模型审计就绪(ARC)等关键技术手段,为算法工程师与平台架构师提供从实验室到高可用生产系统的完整交付路径。

weixin_34277853的博客 363

机器学习模型上线后如何应对系统性风险与工程集成挑战

机器学习模型部署不是算法落地的终点,而是跨系统、跨团队的工程集成起点。其核心在于理解模型服务在真实业务流中的行为逻辑:从特征时效性、接口契约、错误容忍到资源隔离与弹性降级。技术价值体现在将不确定性转化为可监控、可回滚、可审计的确定性系统能力;典型应用场景覆盖金融风控、电商大促、保险理赔等高并发、强合规、低延迟领域。本文聚焦生产环境中模型与上下游系统的耦合治理,深入探讨特征漂移检测、决策链路追踪、混沌压测及审计就绪设计等关键实践。

weixin_33795093的博客 534

机器学习模型上线后的系统性风险与MLOps工程化实践

机器学习模型部署不是开发终点,而是进入真实业务系统的起点。从数据输入、特征服务、API契约到延迟敏感性、漂移检测与审计合规,模型必须在复杂异构环境中持续稳定运行。MLOps的核心价值在于构建可监控、可追溯、可降级、可验证的工程化闭环,而非仅关注算法指标。本文聚焦金融风控等高可用场景,深入解析模型服务在流量洪峰、特征缺失、协议不兼容、监管审计等典型压力下的落地挑战与实战方案,涵盖模型契约设计、三级熔断机制、业务敏感延迟分位数、五维健康监测及审计沙箱等关键能力。

weixin_30667649的博客 368

数据科学家工业级生存指南:从模型上线到技术债治理

数据科学已超越算法学习阶段,进入以稳定性、可维护性与业务协同为核心的工业实践期。其核心原理在于将模型生命周期嵌入真实产线约束——包括特征漂移检测、服务熔断机制、AB测试分流验证等工程化保障;技术价值体现在降低隐性成本(如解释成本、回滚耗时、跨团队协调开销),提升线上系统鲁棒性与决策可信度;典型应用场景覆盖大促实时推荐延迟治理、风控模型负样本污染诊断、跨部门‘黑箱’信任构建等高频痛点。本文聚焦数据科学家在模型上线后第7天、AB测试第三周、故障凌晨三点等具体时间切片中的关键动作,提供可验证的最小执行单元(MVU

weixin_30500473的博客 446

机器学习生产化:从模型上线到系统可靠性的实战指南

机器学习模型部署不是开发终点,而是系统性工程挑战的起点。在真实业务场景中,模型性能受数据漂移、特征缺失、服务延迟、集成语义不一致等多重因素影响,单纯追求AUC或准确率极易导致线上失效。本文聚焦ML系统落地的核心矛盾——如何构建可监控、可追溯、可降级、可审计的生产级能力。内容深度融合‘模型监控’与‘决策健康度’双视角,强调特征层漂移检测、银行级三道集成闸门、压力测试黄金三原则及左移治理实践,覆盖金融、电商、工业等多行业验证方案。关键词涵盖模型监控、生产环境可靠性、特征漂移检测、ML系统治理。

weixin_30267785的博客 322

机器学习模型上线后为何频繁故障?生产级MLOps系统性治理指南

机器学习模型部署不是开发终点,而是系统性风险的起点。当模型从离线实验进入真实业务流,它便成为分布式系统中的一个动态组件,需应对数据漂移、依赖故障、接口混沌与合规审计等多重挑战。其核心原理在于:模型稳定性取决于特征管道时效性、服务契约严谨性、降级机制自治性及监控体系业务感知能力。技术价值体现在将‘不可控衰变’转化为‘可检测、可归因、可干预’的确定性运维流程。典型应用场景覆盖金融风控、实时反欺诈、智能核保等高可用、强监管领域。本文聚焦生产环境中模型‘慢性死亡’的根因分析与工程化防御体系构建。

weixin_30580341的博客 745

AI产品上线前必须掌握的六类数据偏见与实战治理

AI偏见并非算法缺陷,而是现实世界在数据采集、标注、建模和评估各环节中留下的系统性‘投影畸变’。从历史制度惯性到传感器限制,从标注员认知盲区到测试集构建偏差,偏见根植于数据生产全链路。理解标签偏见、表示偏见等核心类型,是保障模型在真实场景(如老年语音识别、基层医疗影像)中稳健落地的技术前提。本文聚焦工程可落地的检测方法——如卡方检验识别历史偏见、t-SNE可视化揭示表示缺失、Krippendorff's Alpha量化测量信度——并提供冷启动采样、时间偏移校准器、偏见熔断机制等一线验证方案,助力产品、算法与

436

AI时代交付流速革命:从分钟级编码到分钟级上线

在AI大幅压缩编码耗时的今天,‘写完代码’已不再是交付瓶颈,真正的卡点在于端到端交付流程——代码审查、CI/CD构建、应用商店审核与组织协作等环节仍沿用传统范式。本文聚焦‘交付流速’这一核心指标,解析AI生成代码带来的新型系统摩擦,如CR验证性动作泛滥、CI环境漂移、发布黑箱延迟及权责模糊等典型问题,并提出Intent-First Review、声明式部署清单、确定性发布机制与流速导向的组织契约四大实操路径,助力团队实现从‘Code Ships in Minutes’到‘Value Delivers in

chikuai9995的博客 485

机器学习模型上线后崩塌的四大系统级断点

机器学习模型部署不是算法落地的终点,而是系统工程压力测试的起点。当模型从Jupyter Notebook进入真实业务链路,其稳定性不再由AUC或F1值定义,而取决于特征时效性、服务契约履约、降级逻辑一致性与全栈可观测性等系统能力。尤其在金融风控等高敏场景中,特征时间幻觉、决策链路隐式耦合、虚假降级陷阱和监控盲区黑洞,共同构成模型‘数学正确但业务失效’的核心原因。本文聚焦生产环境中高频暴露的四大致命断点,结合银行、支付机构一线实战方案,揭示如何通过分级熔断、决策契约、同源降级与四层黄金监控,构建具备韧性、可审

weixin_34101229的博客 464

AI已落地:业务流嵌入式AI disruption实战指南

AI disruption正从概念走向日常,其本质是将人工智能深度嵌入现有业务流程,而非替代岗位或重建系统。核心原理在于‘离用户下一个动作越近,价值越大’——通过轻量级工具链、小样本微调与工作流原生集成,实现对重复性任务的精准压缩。技术价值不再依赖算法先进性,而体现为可计量的ROI:单位任务耗时下降×人力成本×频次-API与标注成本。当前已在知识审查、产线质检、客服意图识别、创意辅助四大场景验证落地,尤其适配非技术岗位与中小企业。本文聚焦真实发生中的AI业务流嵌入实践,涵盖选型逻辑、数据生产、部署避坑与组织

weixin_30172941的博客 310

避开这些坑!RK3588安卓系统内置输入法的正确姿势(含.mk文件修改指南)

本文详细解析了在RK3588安卓系统定制中预置第三方输入法的完整流程与关键避坑指南。重点涵盖APK签名、Android.mk文件编写、系统默认输入法配置(使用adb ime list命令获取服务名)以及SeLinux策略适配等核心步骤,并指出RK3566/RK3568等兄弟平台的通用性与差异点,帮助开发者实现稳定、深度的系统集成。

tgb34567890的博客 440

机器学习生产化:从模型上线到系统治理的工程实践

机器学习模型部署不是训练完成的终点,而是系统工程的起点。当模型脱离Notebook沙盒,其本质已从数学对象转变为需满足延迟、一致性、可观测性与合规要求的生产组件。核心挑战在于数据契约与系统契约的错位、特征漂移引发的决策退化、长尾延迟导致的用户体验崩塌,以及缺乏可追溯的模型治理机制。本文聚焦MLOps落地中的真实痛点——如特征新鲜度失控、重试逻辑引发雪崩、KS/PSI驱动的轻量漂移检测、基于Runbook的可行动监控、不可变模型版本管控及语义级健康检查,为风控、支付、工业等高敏场景提供可复用的稳定性保障框架。

385

PyMiMi实战指南:midas_api配置与连接测试详解

本文详细介绍了PyMiMi库中midas_api的配置与连接测试全流程。从环境准备、API密钥获取,到核心的url_cfg配置函数使用,再到通过test_url进行连接验证,提供了清晰的步骤和代码示例。文章重点解析了配置原理、常见错误排查方法(如401错误、连接超时),并强调了API密钥的安全性管理,帮助用户稳固建立Python与Midas Civil NX之间的自动化通信桥梁。

weixin_29044713的博客 715

机器学习模型上线后的系统性风险与生产治理实战

机器学习模型部署不是开发终点,而是系统工程挑战的起点。当模型接入真实业务系统,其稳定性、可观测性、可解释性与合规性共同构成生产级可信基础。本文围绕特征服务依赖、接口契约设计、延迟水位治理、数据漂移监控、熔断降级机制及审计就绪实践等核心问题,结合金融与电商场景中的高频故障案例,解析如何构建具备业务语义感知能力的ML系统。重点涵盖模型服务与上下游系统的脆弱性协同设计、四维健康体检表、崩溃阶梯式压力响应、模型护照等落地方法论,助力团队跨越从‘能跑’到‘可信’的关键鸿沟。

weixin_30955617的博客 658

CMap数据库实战:从基因表达谱到药物重定位的可视化分析

本文详细介绍了如何利用CMap数据库进行药物重定位的可视化分析。通过实战演示,从差异基因列表准备、CMap查询参数设置,到结果筛选与高级可视化(如热图与OncoPrint风格图),系统讲解了从数据到洞察的全流程,并提供了关键的解读与验证指南,帮助研究者高效挖掘老药新用的潜力。

mango的博客 591

基于DPABI和SPM12的任务态fMRI分析笔记1——预处理

前言 原理简介 预处理

Sophia2023的博客 1万+
上一篇: 我管了五年客服,上线智能客服后一线同事的反应让我意外
下一篇: 微服务拆了五年,AI让我重新想了想还拆不拆
Llama-Turbo
博客等级 码龄4年 9901粉丝 2025原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值