一文搞懂RAG构建知识库和知识图谱

为什么说知识图谱 + RAG > 传统 RAG? 你是否曾觉得自己的大脑充斥了一团乱麻般的随机事实?知识图谱模拟了我们大脑思考事物,以及事物间关系的方式,同时又规避了大脑会遗忘和错误决策等问题。我们可以将知识图谱视为带了主语、谓语和宾语的三元组。它们将信息表示为一个由相互连接的实体组成的网络,以及实体之间的关系。本质上,知识图谱利用基于图的数据模型,其中节点代表实体(如人、地点或概念的主体和宾语),边表示这些实体之间的关系或谓语。OpenSPG 是一个语义增强的可编程知识图谱,GitHub地址如下,欢迎大家Star关注~ 阅读详情

RAG(Retrieval-Augmented Generation,检索增强生成)技术通过检索增强生成,显著提升了知识问答的准确性和时效性。在构建知识库时,RAG通过向量数据库和动态更新机制,实现了高效的知识检索与生成;在构建知识图谱时,RAG通过GraphRAG和Graphusion等框架,实现了实体关系的精准抽取与图谱融合。
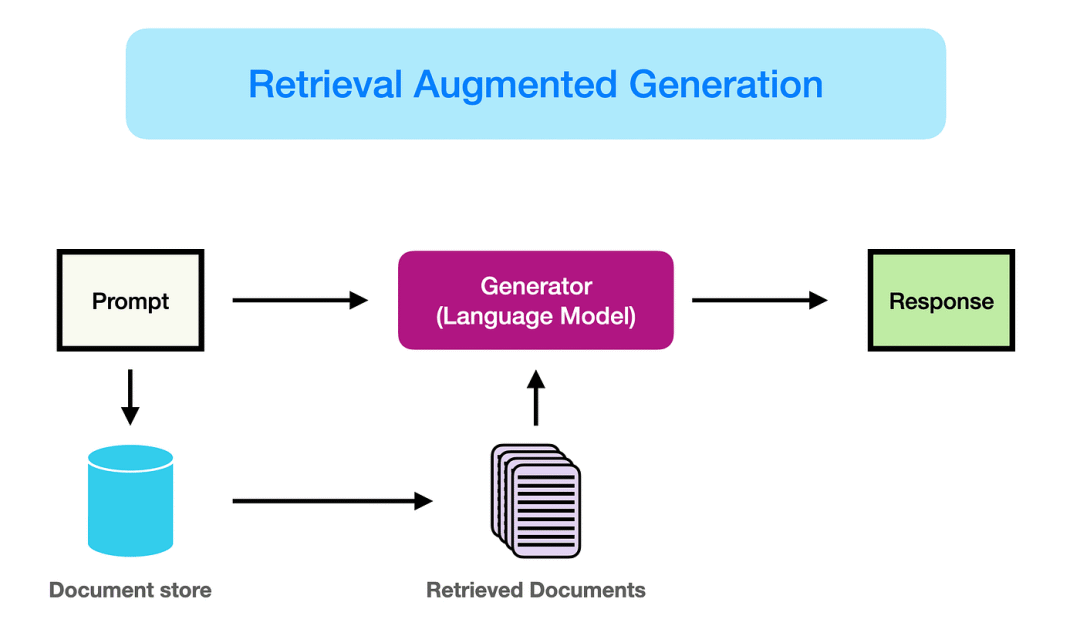
Retrieval Augmented Generation (RAG) with Spring AI | by Sudeep Moothedath  | Feb, 2025 | Medium

一、RAG

RAG(Retrieval-Augmented Generation,检索增强生成)是什么?RAG是一种结合信息检索与文本生成的人工智能技术,旨在通过引入外部知识库,解决大语言模型的幻觉问题。

RAG的核心目标是让大语言模型(LLM)在回答问题时不再仅依赖训练时的固化知识,而是动态检索最新或特定领域的资料来辅助生成答案。

RAG结合了信息检索与生成模型,通过以下三阶段工作:

  • 检索:从外部知识库(如文档、数据库)中搜索与问题相关的信息。

  • 增强:将检索结果作为上下文输入,辅助生成模型理解问题背景。

  • 生成:基于检索内容和模型自身知识,生成连贯、准确的回答。

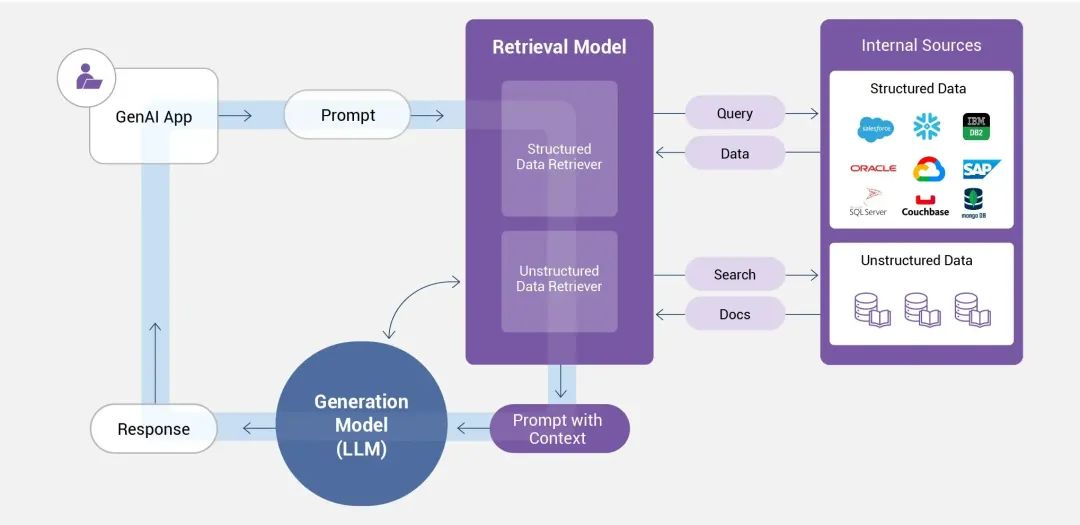
RAG Optimization. Creation of a knowledge base | by Marko Briesemann |  Medium

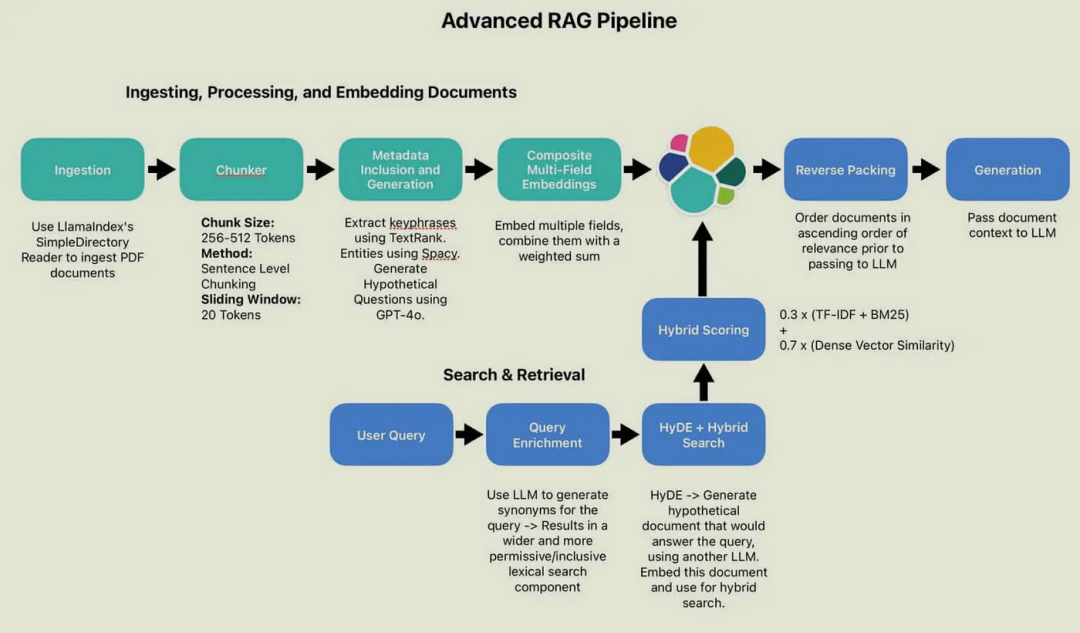
Prompt + RAG 如何实战?结合 Prompt 工程与 RAG(检索增强生成) 的实战应用需围绕数据准备、检索优化、生成控制等环节展开。

一、数据准备与向量化

1. 文档预处理与分块

文档预处理通过多模态数据清洗、词形还原与依存句法分析实现文本规范化;分块环节采用递归分割与语义边界识别技术,结合知识图谱关联优化,构建动态重叠的上下文连贯单元,以平衡检索效率与信息完整性。

# 依赖安装:pip install langchain langchain-text-splittersfrom langchain_text_splitters import RecursiveCharacterTextSplitter# 示例长文本(替换为实际文本)text = """自然语言处理(NLP)是人工智能领域的重要分支,涉及文本分析、机器翻译和情感分析等任务。分块技术可将长文本拆分为逻辑连贯的语义单元,便于后续处理。"""# 初始化递归分块器(块大小300字符,重叠50字符保持上下文)text_splitter = RecursiveCharacterTextSplitter(    chunk_size=300,    chunk_overlap=50,    separators=["\n\n", "\n", "。", "!", "?"]  # 优先按段落/句子分界[2,4](@ref))# 执行分块chunks = text_splitter.split_text(text)# 打印分块结果for i, chunk in enumerate(chunks):    print(f"Chunk {i+1}:\n{chunk}\n{'-'*50}")

2. 向量化与存储

向量化通过Embedding模型将非结构化数据(文本、图像等)映射为高维语义向量,存储则依托专用向量数据库(如ElasticSearch的dense_vector字段、Milvus)构建高效索引(HNSW、FAISS),支持近似最近邻搜索(ANN)实现大规模向量数据的快速相似性匹配。​​​​​​​

# 依赖安装:pip install sentence-transformers faiss-cpufrom sentence_transformers import SentenceTransformerfrom langchain_community.vectorstores import FAISS# 1. 文本向量化(使用MiniLM-L6预训练模型)model = SentenceTransformer('paraphrase-MiniLM-L6-v2')embeddings = model.encode(chunks)# 2. 向量存储到FAISS索引库vector_db = FAISS.from_texts(    texts=chunks,    embedding=embeddings,    metadatas=[{"source": "web_data"}] * len(chunks)  # 可添加元数据)# 保存索引到本地vector_db.save_local("my_vector_db")# 示例查询:检索相似文本query = "什么是自然语言处理?"query_embedding = model.encode([query])scores, indices = vector_db.similarity_search_with_score(query_embedding, k=3)print(f"Top 3相似块:{indices}")

二、检索优化技术

通过多路召回(如混合检索、HyDE改写、动态重排)提升查全率与排序质量,并利用上下文增强(知识图谱补充关系、指令级RAG动态生成Prompt)优化检索结果。

三、Prompt 工程实践

1. 结构化输入设计

基于角色和场景进行约束,例如法律顾问角色与合同条款咨询场景,结合《民法典》第580条知识单元,通过“用户问题→检索知识→逻辑关联→生成答案”的思维链,分点解释并标注引用来源。

2. 输出模版控制

通过预设模板化输出框架确保格式规范,并设置动态防护栏机制过滤敏感词与校验事实一致性,实现内容生成的安全性与合规性。
图片

二、知识库和知识图谱

知识库(Knowledge Base)是什么?知识库是结构化、易操作的知识集群,通过系统性整合领域相关知识(如理论、事实、规则等),为问题求解、决策支持和知识共享提供基础平台。

RAG构建知识库的核心在于将外部知识检索与大语言模型生成能力结合,通过高效检索为生成提供上下文支持,从而提升答案的准确性和时效性。(实战的重点在文本分块Chunking和向量化Embedding)

1. 文本分块(Chunking)

文本分块是将长文本分割为较小、可管理的片段,以便更高效地处理和分析。

2. 向量化(Embedding)

向量化是将文本或数据映射为高维向量空间中的数值表示,以捕获语义特征。
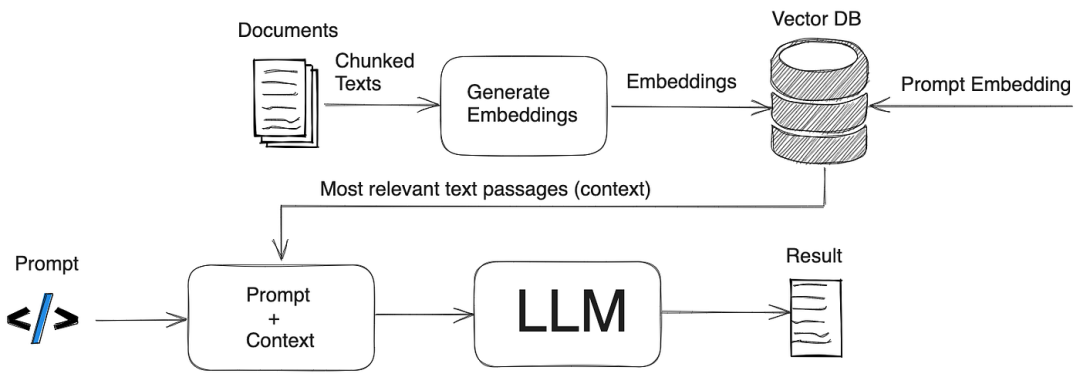
Retrieval-Augmented Generation (RAG) process using an LLM | by  LEARNMYCOURSE | Medium

知识图谱(Knowledge Graph)是什么?知识图谱是一种通过实体与关系构建的语义化网络结构,支持推理与复杂查询,而传统知识库多以非关联的扁平化方式存储数据。

RAG构建知识图谱的核心是通过结合检索技术与大语言模型(LLM),将外部知识库中的结构化与非结构化数据整合为图谱形式。知识图谱为RAG系统注入结构化推理能力,使其从“信息检索器”进化为“知识推理引擎”。

RAG构建知识图谱的关键在于检索与生成的协同,其流程包括:

  • 数据预处理:将文档分割为文本块(chunking),并通过命名实体识别(NER)提取实体与关系。
  • 知识图谱索引:基于提取的实体与关系,构建初始知识图谱后,运用聚类算法(例如Leiden算法)对图谱中的节点进行社区划分。
  • 检索增强:在用户查询时,通过本地搜索(基于实体)或全局搜索(基于数据集主题)增强上下文,提升生成答案的准确性。
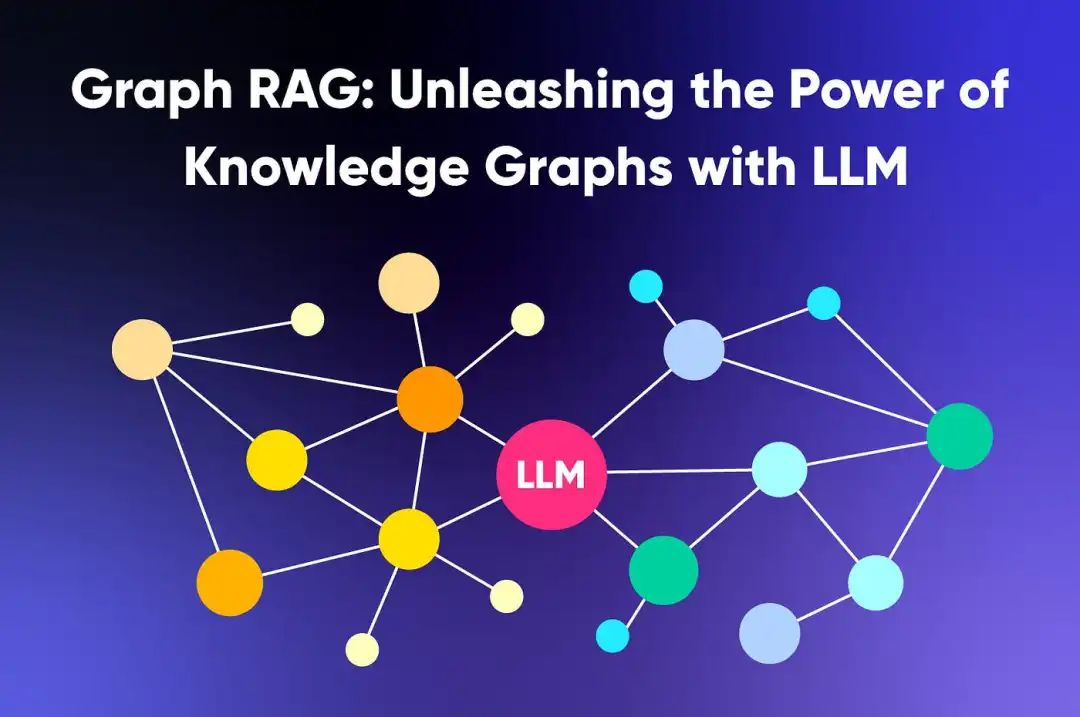
Graph RAG: Unleashing the Power of Knowledge Graphs with LLM | by  NebulaGraph Database | Medium

 如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

五、AI产品经理大模型教程

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​


RAG模型的知识图谱趋势:方法和技巧 1. 背景介绍 1.1 什么是知识图谱 知识图谱(Knowledge Graph)是一种结构化的知识表示方法,它以图的形式表示实体(Entity)之间的关系(Relation)。知识图谱的核心是实体和关系,通过实体和关系的组合,可以表示出复杂的知识体系。知识图谱在很多领域都有广泛的应用,如搜索引擎、推 阅读详情

相关推荐

RAG模型的知识图谱扩展:方法和技巧

1. 背景介绍 1.1 什么是知识图谱 知识图谱(Knowledge Graph)是一种结构化的知识表示方法,它以图的形式表示实体(Entity)之间的关系。知识图谱的核心是实体和关系,实体是知识图谱中的节点,关系是连接实体的边。知识图谱可以用于表示复杂的知识体系,为人工智能、自然语言处理、推荐系统等

AI天才研究院 946

一文带你速通RAG、知识库和LLM!

定制知识库是指一系列紧密关联且始终保持更新的知识集合,它构成了 RAG 的核心基础。这个知识库可以表现为一个结构化的数据库形态(比如:MySQL),也可以表现为一套非结构化的文档体系(比如:文件、图图片、音频、视频等),甚至可能是两者兼具的综合形式。

youmaob的博客 6305

大模型系列——一文搞懂RAG构建知识库和知识图谱

向量化通过Embedding模型将非结构化数据(文本、图像等)映射为高维语义向量,存储则依托专用向量数据库(如ElasticSearch的dense_vector字段、Milvus)构建高效索引(HNSW、FAISS),支持近似最近邻搜索(ANN)实现大规模向量数据的快速相似性匹配。RAG构建知识库的核心在于将外部知识检索与大语言模型生成能力结合,通过高效检索为生成提供上下文支持,从而提升答案的准确性和时效性。**二、知识库和知识图谱********检索与生成的协同****三、Prompt 工程实践。

2401_84052244的博客 670

RAG(大模型+知识库)落地与知识管理的春天-新的知识运营体系

大模型时代来了,可能你也知道GPT大模型是被海量知识训练出来的,但不知道你有没有问过,什么样的知识才能训练大模型?站在企业的角度,很多企业都有自己的知识库或者文档中心,很多人也都有自己积攒数年的资料库,那是不是用上大模型,就能轻松实现基于自己知识库的智能搜索/智能问答/智能推荐呢?(一)知识基础形态和知识质量在传统的搜索、问答、推荐等场景中,通常会返回一整篇的文档,我们还得在这一大篇资料中去找到自己想要的那一段具体内容。不少企业构建的知识库,其实就是文档库。

weixin_59191169的博客 4623

Docker深度详解:从原理到实践的全方位指南

本文深入解析了Docker容器化技术的核心原理与实战应用。主要内容包括:1) Docker核心架构与优势,对比容器与虚拟机的关键差异;2) 企业级部署方案,涵盖离线安装与多镜像源配置;3) 高级镜像构建技术,如参数化构建、缓存优化及安全扫描;4) 容器生命周期管理,包括健康检查、资源限制及数据持久化方案。文章提供了丰富的代码示例和生产级配置建议,如使用Trivy进行安全扫描、精确控制容器资源等技术细节,帮助开发者全面掌握现代容器化技术。

weixin_42593797的博客 1280

逆向分析美团外卖mtgsig3.0签名算法:从抓包到算法还原实战

在移动应用开发与安全领域,API接口签名是保障数据传输完整性与身份验证的核心机制。其基本原理是通过特定的算法,将请求参数、时间戳等数据与密钥结合,生成唯一的签名串,服务器通过验证签名来识别请求的合法性。这项技术的核心价值在于防止数据篡改、重放攻击和未授权访问,是构建安全客户端-服务器通信的基石。在实际应用中,签名算法广泛应用于电商、社交、金融等各类App的接口保护场景。本文以美团外卖App的mtgsig3.0签名为具体案例,详细拆解了其生成逻辑。通过结合Frida动态调试与Jadx静态分析,文章深入探讨了如

weixin_29325515的博客 1235

【AI大模型】一文搞懂RAG构建知识库和知识图谱,看到就是赚到!!

RAG(Retrieval-Augmented Generation,检索增强生成)技术通过检索增强生成,显著提升了知识问答的准确性和时效性。在构建知识库时,RAG通过向量数据库和动态更新机制,实现了高效的知识检索与生成;在构建知识图谱时,RAG通过GraphRAG和Graphusion等框架,实现了实体关系的精准抽取与图谱融合。

2401_85327249的博客 948

奥顺居PHP测算引流SEO程序_八字风水_起名解梦_星座生肖综合门户源码

奥顺居PHP测算引流SEO程序_八字风水_起名解梦_星座生肖综合门户源码 S30新框架适合多种奥顺插件。

xl1407的博客 1749

【AI大模型】一文搞懂RAG构建知识库和知识图谱,小白收藏这一篇就够了!!

一、RAG RAG(Retrieval-Augmented Generation,检索增强生成)是什么?RAG是一种结合信息检索与文本生成的人工智能技术,旨在通过引入外部知识库,解决大语言模型的幻觉问题。 RAG的核心目标是让大语言模型(LLM)在回答问题时不再仅依赖训练时的固化知识,而是动态检索最新或特定领域的资料来辅助生成答案。 RAG结合了信息检索与生成模型,通过以下三阶段工作:检索:从外部知识库(如文档、数据库)中搜索与问题相关的信息。增强:将检索结果作为上下文输入,辅助生成模型理解问题背景。

Android23333的博客 1001

告别Root!用Termux+ADB在Android上玩转自动化(保姆级教程)

本文详细介绍了如何在非Root环境下使用Termux和ADB实现Android自动化操作,无需Root权限即可运行自动化脚本。通过Termux搭建Linux终端环境,结合ADB无线调试和Python脚本,实现点击、滑动、截图等自动化功能,适用于定时任务、自动签到等场景。

weixin_42548888的博客 536

第244篇 视觉SLAM后端之BA优化——Bundle Adjustment的原理

本文介绍了SLAM后端优化中的Bundle Adjustment(BA)技术。BA通过同时优化相机位姿和3D路标点位置,最小化重投影误差,解决前端估计的累积误差问题。文章详细讲解了BA的数学原理,包括目标函数构建、Gauss-Newton法和Levenberg-Marquardt法求解过程,以及利用稀疏性和Schur补加速计算的关键技术。对比了全量BA和增量BA的优缺点,并介绍了Ceres、g2o等工程实现工具。BA作为SLAM后端的核心算法,其理解深度直接影响系统性能优化能力。

郑伟强dev的专栏 343

一文搞懂RAG构建知识库和知识图谱,大模型入门到精通,收藏这篇就足够了!

RAG通过向量数据库和动态更新机制,实现了高效的知识检索与生成;在构建知识图谱时,RAG通过GraphRAG和Graphusion等框架,实现了实体关系的精准抽取与图谱融合。

Y525698136的博客 458

RSL-RL:开源人形机器人强化学习控制研究库

摘要:RSL-RL是一款专为机器人领域设计的开源强化学习库,其核心特点是紧凑性、可修改性和高性能。该库聚焦PPO和BC两大主流算法,并整合了对称性增强、好奇心驱动等机器人专用技术。通过纯GPU训练优化,RSL-RL在大型仿真中展现出卓越的吞吐性能,已成功应用于腿足运动控制、全身协调等多个机器人研究场景。其轻量级架构包含运行器、算法和网络三个可独立修改的组件,支持TensorBoard等主流日志工具。该框架特别适合需要快速原型开发的机器人研究者,但不适用于通用机器学习基准测试。开源地址:https://git

2506_90492529的博客 1674

一文搞懂大模型的RAG(知识库和知识图谱)

给你学习,我国在这方面的相关人才比较紧缺,大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。***,通过高效检索为生成提供上下文支持,从而提升答案的准确性和时效性。光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战项目来学习。

2401_85373898的博客 1380

c#算法(5)—最小二乘法(二次曲线拟合)

最小二乘法——二次曲线拟合

qq_34059233的博客 1658

【RT-DETR有效改进】利用ASF-YOLO改进特征融合层(附代码 + 详细教程)

本文给大家带来的改进机制是ASF-YOLO(发布于2023.12月份的最新机制),其是特别设计用于细胞实例分割。这个模型通过结合空间和尺度特征,提高了在处理细胞图像时的准确性和速度。在实验中,ASF-YOLO在2018年数据科学竞赛数据集上取得了卓越的分割准确性和速度,达到了0.91的box mAP(平均精度),0.887的mask mAP,以及47.3FPS的推理速度,效果非常的好,这个结构本来是用于分割的,我将其移植到了目标检测的模型上,所以其可以适用于分割和目标检测。

Snu77的博客 2292
上一篇: 探秘 Hugging Face:何为 Hugging Face 及其核心组件全览
下一篇: 大模型入门指南 - Quantization:小白也能看懂的“模型量化”全解析
Llama-Turbo
博客等级 码龄4年 9901粉丝 2021原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值