大模型入门综述---从模型,训练,部署全方面认识大模型

Ubuntu系统进行大模型微调训练部署 Meta Llama-3-70B、Mistral-Large、阿里通义千问72B、百度文心4.0、智谱GLM-4以千亿级参数开源或半开源,支持商用,中文表现与GPT-4差距缩小,Llama-3采用分组查询注意力+SwiGLU,千问2.5引入RoPE+FlashAttention-2,推理速度提升30%。综上,Ubuntu 在“驱动新、框架全、镜像多、更新快、文档足”五维度形成正循环,使大模型团队能把有限时间花在调参与训练,而非浪费在编译兼容层,因此成为私有云与公有云部署的默认基线系统。 阅读详情

随着人工智能技术的飞速发展,大模型在各个领域的应用逐渐广泛。大模型通常指的是具有海量参数和复杂结构的深度学习模型,其性能和能力相较于传统模型有了显著的提升。本文将从大模型的硬件设备、模型、训练,微调,部署等方面进行全面综述。

硬件设备

当前用于训练大模型的硬件设备主要还是NVIDIA,进入生成式AI时代,GPU几乎是每一个AI大模型背后的“标配”,成为AI时代的“硬通货”,这也让英伟达跻身全球科技企业市值的前三榜单。英伟达目前占据了全球AI芯片80%以上的份额,不仅是硅谷的每一个人都在谈论它,就连中国对技术感兴趣的普通人也都在谈论它。当然除了英伟达,国外还有AMD,intel等可提供GPU训练,当然,国内像华为的昇腾,百度的昆仑芯片也是值得我们关注的,只不过当前国内的生态还不完善,还有巨大的进步空间,图(1)给出了用于大模型训练设备梳理框架。
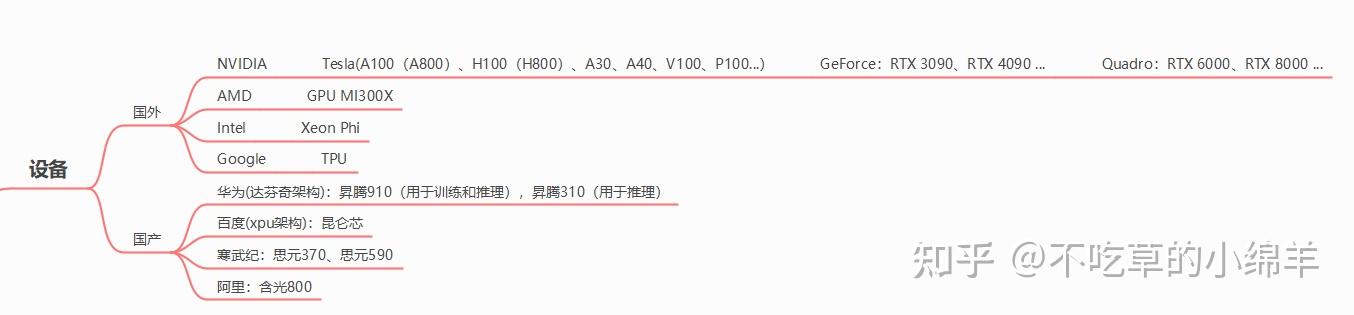
图(1) 设备梳理

大模型架构

大模型的结构主要分为三种,Encoder-only(自编码模型,代表模型有BERT),Decoder-only(自回归模型,代表模型有GPT系列和LLaMA),Encoder-Decoder(序列到序列模型,代表模型有GLM),大语言模型在自然语言处理和文本处理领域具有广泛的应用,其应用场景多种多样。以下是一些主要的应用场景种类:

聊天和交互:大语言模型可以用作聊天机器人,与用户进行自然而流畅的对话,提供信息、解答问题或进行娱乐性的交流。它们能够理解上下文,并生成相关和连贯的回应,从而提供个性化的用户体验。

问答系统:大语言模型能够构建问答系统,根据用户的问题在大量文本或知识库中检索相关信息,并生成清晰的答案。这对于智能助手、教育应用和在线支持系统等场景非常有用,能够迅速准确地回答用户的问题。

机器翻译:大语言模型在机器翻译领域也有广泛应用,能够将文本从一种语言自动翻译成另一种语言。它们能够理解源语言的含义和上下文,并生成准确且流畅的目标语言文本,促进跨语言交流。

文本生成和摘要:大语言模型可以生成各种类型的文本,如新闻报道、文章、故事、诗歌等。它们还可以根据输入的长篇文本生成摘要,提取关键信息并以简洁的形式呈现出来,帮助用户快速了解文本的主要内容。

除了上述应用场景外,大语言模型还在金融、法律、医疗等领域发挥着重要作用。如图(2)所示。
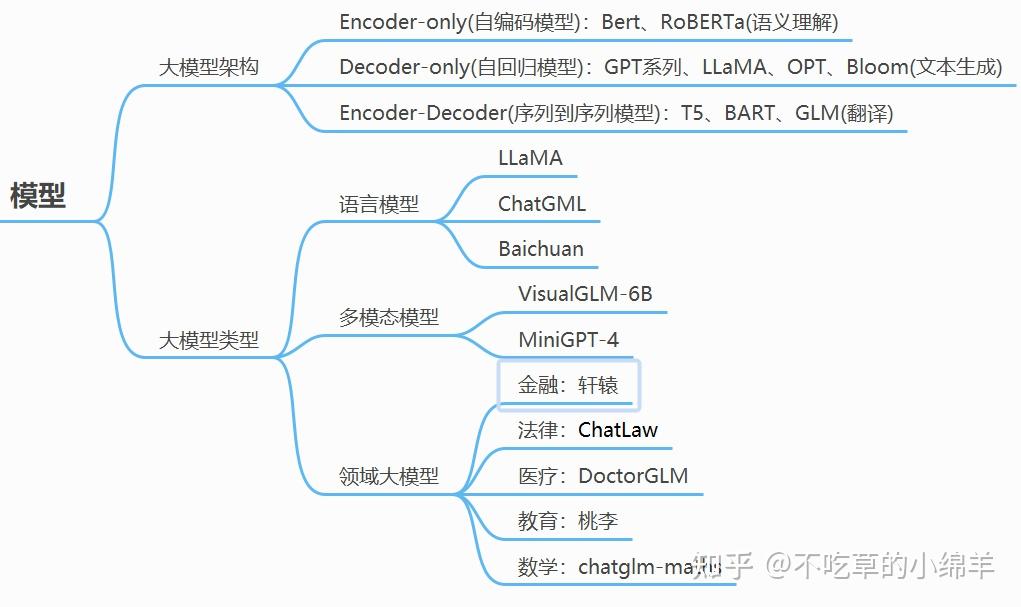
图(2) 大模型架构及种类

分布式框架及并行

在大模型训练中,分布式框架发挥着至关重要的作用,它们能够支持在大规模数据集上进行高效的模型训练。目前pytorch和TensorFlow是大模型训练中常用的分布式框架:

TensorFlow:TensorFlow是一个由Google开发的开源机器学习框架,它提供了强大的分布式训练能力。TensorFlow支持使用Parameter Server架构进行分布式训练,可以高效地处理大规模数据集和模型参数。此外,TensorFlow还提供了丰富的算法库和优化器,使得大模型训练变得更加容易。

PyTorch:PyTorch是另一个流行的深度学习框架,也具备强大的分布式训练功能。PyTorch提供了多种分布式训练策略,包括数据并行、模型并行等,可以根据具体需求进行灵活配置。此外,PyTorch还支持使用分布式数据加载器来加速数据预处理和加载过程。

图(3)中给出了分布式框架所对应的生态组合,通过最适配的组合,才能更方便开发人员在此基础上做出更便捷更好用的大模型。
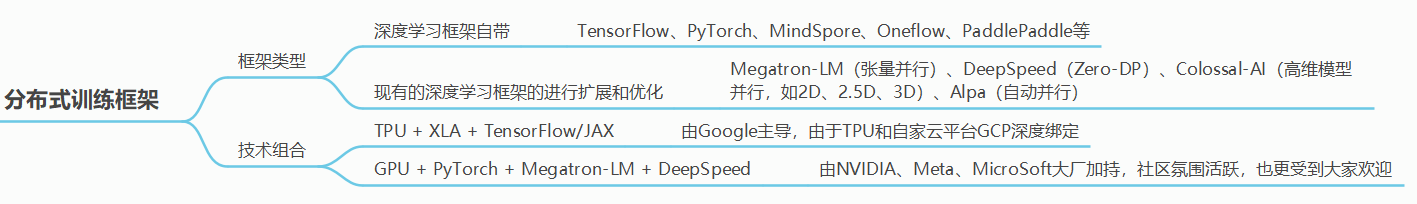
图(3) 分布式训练框架


大模型分布式训练方法主要包括以下几种:

数据并行:这是最常见的分布式训练策略。数据被切分为多份并分发到每个设备(如GPU)上进行计算。每个设备都拥有完整的模型参数,计算完成后,设备间的梯度会被聚合并更新模型参数。这种方法能够充分利用多个设备的计算能力,加快训练速度。

模型并行:在模型并行中,模型的不同部分被分配到不同的设备上进行计算。每个设备仅拥有模型的一部分,这使得超大的模型能够在有限的计算资源上训练。模型并行通常与流水线并行结合使用,数据按顺序经过所有设备进行计算。

流水线并行:流水线并行是一种特殊的模型并行方式。它将网络切分为多个阶段,并将这些阶段分发到不同的设备上进行计算。数据按照流水线的方式依次通过每个阶段,从而实现高效的并行计算。

混合并行:混合并行结合了上述多种并行策略。根据模型的结构和计算资源的特点,可以选择最适合的并行策略组合进行训练。
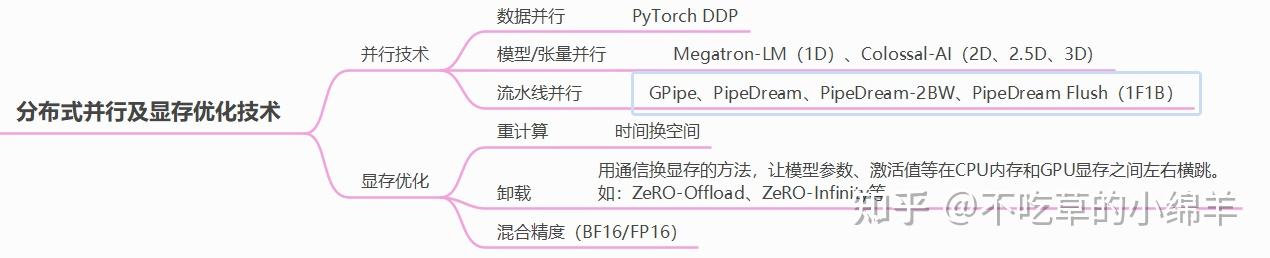
图(4) 大模型分布式训练方法

大模型微调(Fine-tuning)

大模型微调技术的详细原理在前文的有详细介绍:Chatglm3-6B大模型微调---原理篇(一) - 知乎 (zhihu.com)

,图(5)给出了Fine-tuning的框架图Chatglm3-6B大模型微调---原理篇(二) - 知乎 (zhihu.com),图(5)给出了Fine-tuning的框架图
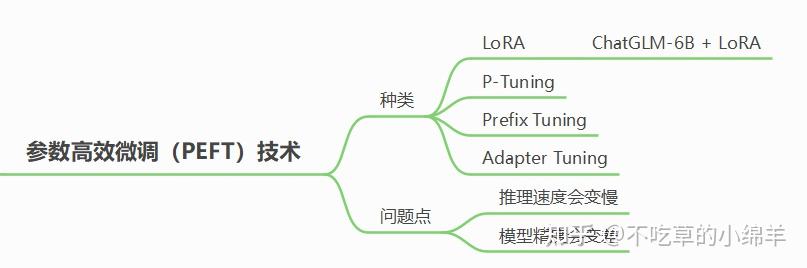
图(5) PEFT技术

大模型评估

大模型的效果评估是一个综合性的过程,涉及多个角度和维度。图(6)是一些主要的效果评估角度:
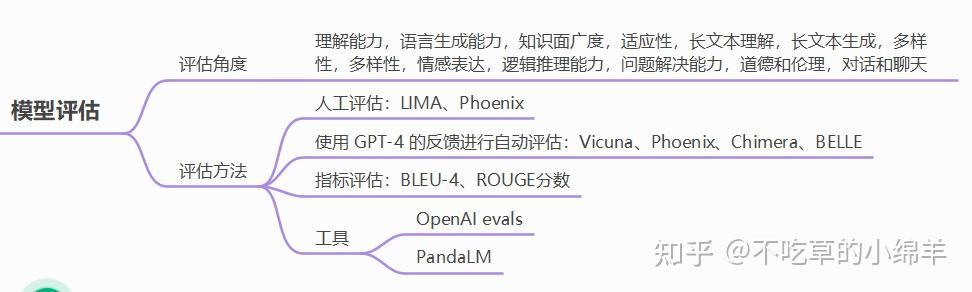
图(6) 大模型评估维度

以上是目前对大模型的一个基本认知,如有错误与不足,欢迎交流指正。

   如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

五、AI产品经理大模型教程

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

DeepSeek大模型训练及大模型训练师的价值和意义 一、训练定义与核心内容1.技术架构DeepSeek基于Transformer架构,融合稀疏注意力机制和混合专家(MoE)架构,通过自注意力机制处理长文本依赖关系,并通过MoE动态分配计算资源,实现轻量化参数与高性能的平衡。o创新点:引入专利数据管理技术减少冗余存储,优化训练效率;o模型版本:包括通用大语言模型(如DeepSeek-LLM)、代码模型(DeepSeek-Coder)及MoE模型(DeepSeek-MoE)。2.主要训练内容o数据准备。 阅读详情

相关推荐

大模型的开发训练与推理部署白皮书 2024

随着参数规模和网络结构复杂性的不断提升,大模型开发、训练和推理部署所面临的挑战愈发严峻,其研发依赖算法、算力和数据的综合支撑。**深度学习框架及配套工具为大模型的生产和应用提供了基础支撑,涉及开发、训练、压缩、推理和服务等多个环节。**此外,通过深度学习框架还可以实现与硬件的适配和协同优化,进一步提升硬件的计算和推理性能,降低大模型开发和应用的成本。由于大模型参数规模大,计算和存储的需求显著增加,与辨别式AI 模型相比,非常依赖分布式技术提升效率。

lhx17673139267的博客 2121

模型训练全流程详解之从数据准备到部署的最佳实践!

在现代机器学习与深度学习的应用中,模型训练是实现智能决策和预测能力的核心步骤。无论是在图像分类、自然语言处理,还是在语音识别、推荐系统等领域,模型训练流程的掌握和优化直接决定了模型的性能表现。前排提示,文末有大模型AGI-优快云独家资料包哦!在本文中,我们详细介绍了机器学习和深度学习中的模型训练全流程,涵盖了从数据准备、模型选择、训练优化到模型部署和维护的每一个环节。理解和掌握这些步骤,能够帮助开发者设计出更加鲁棒和高效的机器学习系统。

2301_79455190的博客 1434

大模型综述

预训练数据在大型语言模型的开发中起着关键作用。作为LLM卓越能力的基础,预训练数据的质量、数量和多样性显著影响LLM的性能。常用的预训练数据由无数的文本来源组成,包括书籍、文章和网站。这些数据经过精心整理,以确保全面代表人类知识、语言细微差别和文化观点。预训练数据的重要性在于,它能够为语言模型提供对单词知识、语法、句法和语义的丰富理解,以及识别上下文和生成连贯响应的能力。预训练数据的多样性在塑造模型的性能方面也起着至关重要的作用,LLM的选择高度依赖于预训练数据的组成部分。

Aweii__的博客 1549

超全大模型训练流程,教你如何训练自己的大模型

现在大模型发展得如火如荼,但是没有学过人工智能技术的开发者,只会调用其接口,但不清楚怎么训练一个大模型。今天就简单介绍一下自己的理解,有什么问题欢迎讨论。

qkh1234567的博客 2686

大模型之大模型的开发训练与推理部署

在通信优化方面,框架支持自适应的通信拓扑优化技术,可感知硬件集群环境的配置,搜索最优并行策略,支持大模型在不同规模集群下的高效训练,提升模型性能的同时,降低开发者配置高效大模型训练的门槛。这种方案能够快速进行量化,并且具有较高的精度,尤其对访存受限的场景,也拥有较好的效果。为实现大模型的高效训练和推理,需要通过深度学习框架实现与硬件的适配和深度协同优化,通过低成本、高效率的硬件适配方案,提升大模型与硬件的适配效率,并通过混合精度、显存复用、融合优化等软硬件协同优化技术,结合硬件特性实现系统级优化。

m0_59092412的博客 1288

大模型的训练过程

大模型的训练是一个复杂而严谨的过程,涉及数据准备、模型设计、训练配置、分布式训练、模型评估和部署等多个环节。随着计算资源和算法的进步,未来的大模型训练将变得更高效、更智能,为各类应用场景提供更强大的支持。

qq_34068440的博客 1505

训练大模型需要什么配置(非常详细),零基础入门到精通,看这一篇就够了

训练大模型需要什么配置(非常详细),零基础入门到精通,看这一篇就够了

Java癫疯的博客 3961

阿里云导出的镜像raw转换成vmdk格式工具

阿里云导出的镜像raw转换成vmdk格式工具 1.安装java环境,安装教程不介绍了 2.raw2vmdk软件下载: 在我的链接里面: 3.使用 打开cmd.bat软件: java -jar raw2vmdk.jar (原镜像)C:\\images\\raw\\disk.img (转换的镜像)D:\\images\\vmdk\\disk.vmdk 4.vmware打开vmdk文件 ...

3843

详解大模型推理训练占用的显存

AI因你而升温,记得加个星标哦!在当前开源大模型中,我们可以观察到一个普遍的现象:开源可下载模型的参数规模都集中在7B、13B、65B等特定的数值上,那这种现象背后有着怎样的原因呢?

Antai_ZHU的博客 4847

LabVIEW工程密码保护机制与移除技术详解

LabVIEW作为工业自动化领域广泛使用的图形化编程工具,其密码保护机制涉及文件加密与权限控制等核心技术。从技术实现来看,现代版本采用AES-128加密结合SHA-256哈希校验,而经典版本使用XOR加密配合Base64编码。理解这些加密原理对于工程维护、灾难恢复等合法场景至关重要。在实际应用中,密码移除工具需要处理不同版本的文件结构差异,包括解析XML描述区的Protection标签、动态识别版本并应用对应解密策略。这类技术在工业设备维护、教学研究等场景具有重要价值,但必须注意遵守法律边界,确保拥有合法的

weixin_34161083的博客 390

微磁模拟实战指南:从OOMMF安装到首个3D模型运行

本文详细介绍了OOMMF微磁模拟软件的安装与使用,从环境配置到首个3D模型运行的完整教程。涵盖Windows、Linux和macOS平台的安装避坑指南,以及MIF文件编写、并行计算优化等实战技巧,帮助研究人员快速掌握这一开源工具在磁畴壁运动、磁滞回线等微磁学问题中的应用。

weixin_29294597的博客 153

【大模型部署】AI大模型本地部署入门教程

想玩转AI大模型?这篇本地部署入门教程不容错过!从LM Studio安装到模型选择与量化,手把手教你打造专属AI环境,兼顾数据隐私与离线运行优势,为你的AI探索之旅奠定基础。

AUG2468的博客 2461

一文看懂—Agent多智能体协作

多智能体协作已成为AI应对复杂任务的关键范式,通过模拟人类团队分工,实现专业化、高效化和纠错能力。本文系统阐述了多智能体协作的核心概念(智能体分工、工作流编排、工具使用)、与产品规划的关联(任务拆解、错误处理、组织架构设计),以及典型应用场景(报告生成、客服工单、学习规划)。同时剖析了常见陷阱(循环卡死、信息失真、成本失控)及解决方案,并提供了实用工具模板(角色定义卡、工作流画布、成本仪表盘)。最后通过市场竞品分析和旅行规划两个实战案例,展示了多智能体协作的实际价值。该技术正推动AI从单点智能迈向系统智能,

lee006006的博客 1033

七天入门大模型 :大模型LLM 训练理论和实战最强总结!

模型/训练/推理深度学习领域所谓的“模型”,是一个复杂的数学公式构成的计算步骤。y = ax + b该方程意味着给出常数a、b后,可以通过给出的x求出具体的y。这个根据x求出y的过程就是模型的推理过程。在LLM中,x一般是一个句子,如“帮我计算23+20的结果”,y一般是:“等于43”。基于上面的方程,如果追加一个要求,希望a=1,b=1,x=3的时候y=10呢?这显然是不可能的,因为按照上面的式子,y应该是4。y=σ(ax+b)这个非线性变换可以理解为指数、对数、或者分段函数等。

2201_75499313的博客 1946

C#读取和写入excel表数据--手把手教详解

C#读写excel数据详解

如如水的博客 4055

CANFD加速是什么?和CANFD有什么区别?

在使用CAN设备上位机的时候,已经选择了CANFD,但还有一个选项是“CANFD加速”,那CANFD加速和不加速有什么区别呢?刚接触CANFD小伙伴肯定一脸懵,本篇主要是给大家分享一下他们的区别,如果对你有帮助,请转发,收藏,点赞💐🎉👍😊

汽车电子软件领域知识分享 1035

应该怎么训练大模型,大模型的训练流程是什么样的?

大模型的核心主要有两部分,一是训练数据,二是机器学习模型。现在大模型发展得如火如荼,但是没有学过人工智能技术的开发者,只会调用其接口,但不清楚怎么训练一个大模型。今天就简单介绍一下自己的理解,有什么问题欢迎讨论。01怎么训练一个大模型?我们知道大模型是指以神经网络为基础构建,通过大量数据学习或者说训练得到的一个模型。这里大指的是学习的数据量大,而模型是指机器学习模型。通过大量数据训练出来的机器学习模型,就是大模型。所以,训练一个大模型最重要的两个部分就是和;再加上对,就构成了一个完善的训练流程。

m0_59235245的博客 2784

智能车图像处理0-图像处理整体框架思路

1.总体框架如上所示,具体代码请查看后续文章。2.因为参与竞赛时间是大二,所以在编程中有许多不规范的地方(如变量的命名),大家见谅。3.原创文章,请勿侵权=-=

taiyuezyh的博客 1万+

从数据、训练到部署的全面梳理,大模型入门到精通,收藏这篇就足够了!

随着人工智能技术迅猛发展,大模型(如GPT-4、文心一言等)正逐步渗透至社会生活的各个领域,从医疗、教育到金融、政务,其影响力与日俱增。

2301_81940605的博客 950

YOLO11涨点优化:Loss魔改 | WIoU (Wise-IoU) v3版本全面替换,基于动态非单调聚焦机制,让模型更聪明地学习

YOLOv11目标检测中的WIoU v3损失函数改进 本文探讨了YOLOv11目标检测模型中CIoU损失函数的局限性,并提出了WIoU v3改进方案。关键发现包括: CIoU的缺陷:在低质量样本(小目标/遮挡目标)上过度惩罚,导致模型优化方向偏离,小目标AP往往比大目标低30%左右。 WIoU v3的创新: 动态非单调聚焦机制:根据样本"离群度"智能分配梯度 让模型重点优化中等质量样本,减少对低质量样本的无效关注 采用指数移动平均来自适应调整质量评判标准 实际效果:WIoU v3在保持大

2601_95807009的博客 422

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大模型是什么?大模型该怎么训练?

大模型是指具有数百万或数十亿个参数的深度神经网络模型,经过专门的训练过程,能够对大规模数据进行复杂的处理和任务处理。大模型具有巨大的规模,通常包含数十亿个参数,模型大小可以达到数百GB甚至更大。大模型需要强大的计算资源和存储空间来保证它的训练和部署,训练大模型通常需要数百甚至上千个GPU,以及大量的时间,通常在几周到几个月。大模型拥有强大的表达能力和学习能力,可以学习到更广泛和泛化的语言理解能力。

2301_79455190的博客 1129

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

大模型全攻略:数据准备、模型微调到部署,一文全解析!

如果想自定义整个webui的名字、登录进来的用户角色等等,则需要对docker的镜像进行一定的修改。

chengxuyuanyy的博客 2452

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

上一篇: AI大模型LangChain框架基础与使用示例(附教程)
下一篇: 如何才能高性价比的完成DeepSeek的私有化部署?
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值