


华驼(HuaTuo): 基于中文医学知识的LLaMA微调模型
前言
在大模型兴起的时代浪潮引领下,无数款AI应用应运而生,本文的核心目标除了技术知识科普外,还有还重要的一点,就是进行知识梳理。
github地址为:https://github.com/SCIR-HI/Huatuo-Llama-Med-Chinese
介绍
一个基于python语言开发、基于LLaMA微调的中文医学 大模型。
HuaTuo: Tuning LLaMA Model With Chinese Medical Instructions
本项目开源了经过中文医学指令精调/指令微调(Instruct-tuning) 的LLaMA-7B模型。我们通过医学知识图谱和GPT3.5 API构建了中文医学指令数据集,并在此基础上对LLaMA进行了指令微调,提高了LLaMA在医疗领域的问答效果。
基于相同的数据,我们还训练了医疗版本的ChatGLM模型: ChatGLM-6B-Med[1]
此外,我们还尝试利用GPT3.5 API将医学文献中的【结论】作为外部信息融入多轮对话中,在此基础上对LLaMA进行了指令微调。目前。我们只开放针对"肝癌"单个疾病训练的模型参数。在未来,我们计划发布融入文献结论的医学对话数据集,并且会针对“肝胆胰”相关16种疾病训练模型。
我们即将发布我们研发的新模型-扁鹊(PienChueh)[2],欢迎大家届时使用体验。
更新日志
[2023/04/28] 增加了基于中文Alpaca大模型[3]进行指令微调的模型发布。
[2023/04/24] 增加了基于LLaMA和医学文献进行指令微调的模型发布。
[2023/03/31] 发布了基于LLaMA和医学知识库进行指令微调的模型发布。
A Quick Start
首先安装依赖包,python环境建议3.9+
代码语言:javascript
pip install -r requirements.txt
模型下载
LoRA权重可以通过百度网盘或Huggingface下载:
1.对LLaMA进行指令微调的LoRA权重文件•基于医学知识库 百度网盘[4]和HuggingFace[5]•基于医学文献 百度网盘[6]2.对Alpaca进行指令微调的LoRA权重文件•基于医学知识库 百度网盘[7]•基于医学知识库和医学文献 百度网盘[8]
下载LoRA权重并解压,解压后的格式如下:
代码语言:javascript
#1.对LLaMA进行指令微调的LoRA权重文件
#基于医学知识库
lora-llama-med/
  - adapter_config.json   # LoRA权重配置文件
  - adapter_model.bin   # LoRA权重文件

#基于医学文献
lora-llama-med-literature/
  - adapter_config.json   # LoRA权重配置文件
  - adapter_model.bin   # LoRA权重文件


#2. 对Alpaca进行指令微调的LoRA权重文件
#基于医学知识库
lora-alpaca-med-alpaca/
  - adapter_config.json   # LoRA权重配置文件
  - adapter_model.bin   # LoRA权重文件

#基于医学知识库和医学文献
lora-alpaca-med-alpaca-alldata/
  - adapter_config.json   # LoRA权重配置文件
  - adapter_model.bin   # LoRA权重文件
Infer
我们在./data/infer.json中提供了一些测试用例,可以替换成其它的数据集,请注意保持格式一致
运行infer脚本
代码语言:javascript
#基于医学知识库
bash ./scripts/infer.sh

#基于医学文献
#单轮
bash ./scripts/infer-literature-single.sh

#多轮
bash ./scripts/infer-literature-multi.sh
也可参考./scripts/test.sh
数据集构建
我们采用了公开和自建的中文医学知识库,主要参考了cMeKG[9]。
医学知识库围绕疾病、药物、检查指标等构建,字段包括并发症,高危因素,组织学检查,临床症状,药物治疗,辅助治疗等。知识库示例如下:
代码语言:javascript
{"中心词": "偏头痛", "相关疾病": ["妊娠合并偏头痛", "恶寒发热"], "相关症状": ["皮肤变硬", "头部及眼后部疼痛并能听到连续不断的隆隆声", "晨起头痛加重"], "所属科室": ["中西医结合科", "内科"], "发病部位": ["头部"]}
我们利用GPT3.5接口围绕医学知识库构建问答数据,设置了多种Prompt形式来充分利用知识。
指令微调的训练集数据示例如下:
代码语言:javascript
"问题:一位年轻男性长期使用可卡因,突然出现胸痛、呕吐、出汗等症状,经检查发现心电图反映心肌急性损伤,请问可能患的是什么疾病?治疗方式是什么?"

回答: 可能患的是心肌梗塞,需要进行维拉帕米、依普利酮、硝酸甘油、ß阻滞剂、吗啡等药物治疗,并进行溶栓治疗、低分子量肝素、钙通道阻滞剂等辅助治疗。此外需要及时停用可卡因等药物,以防止病情加重。"
我们提供了模型的训练数据集,共计八千余条,需要注意的是,虽然训练集的构建融入了知识,但是仍存在错误和不完善的地方,后续我们会利用更好的策略迭代更新数据集。
指令微调数据集质量仍有限,后续将进行不断迭代,同时医学知识库和数据集构建代码还在整理中,整理完成将会发布。
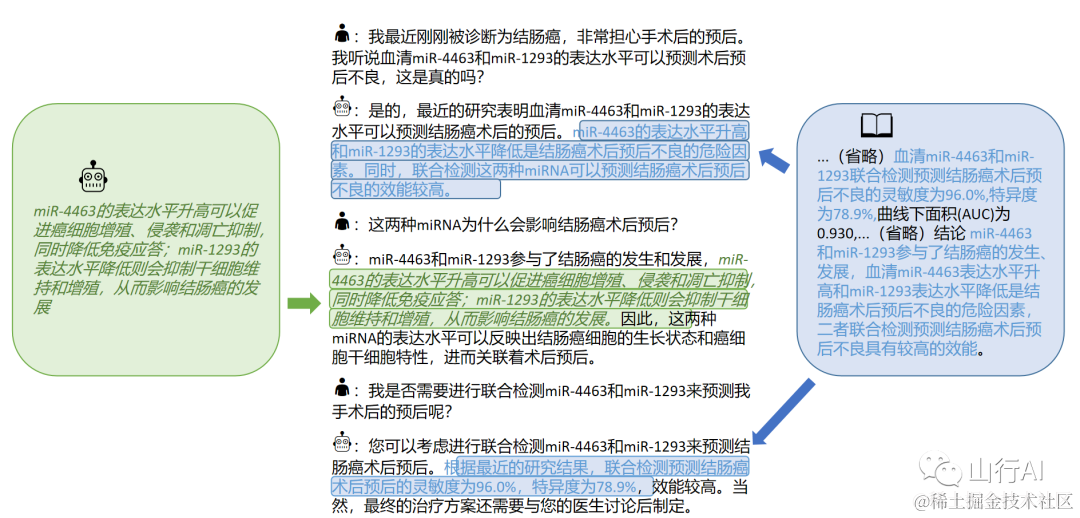
此外,我们收集了2023年关于肝癌疾病的中文医学文献,利用GPT3.5接口围绕医学文献多轮问答数据。在·./data_literature/liver_cancer.json中我们提供了其中的1k条训练样例。目前,训练样本的质量仍然有限,在后续我们会进一步迭代数据,会以公开数据集的形式对外进行发布。训练样本的示例如下:
SCIRHIHuaTuoliterature
Finetune
如果想用自己的数据集微调LLaMA,请按照./data/llama_data.json的格式构建自己的数据集
运行finetune脚本
代码语言:javascript
bash ./scripts/finetune.sh
训练细节
计算资源需求
我们在一张A100-SXM-80GB显卡上进行了训练,训练总轮次10轮,耗时约2h17m。batch_size=128的情况下显存占用在40G左右。预计3090/4090显卡(24GB显存)以上显卡可以较好支持,根据显存大小来调整batch_size。
实验过程
超参设置和实验过程可以参考wandb的链接:
https://wandb.ai/thinksoso/llama_med/runs/a5wgcnzt/overview?workspace=user-thinksoso
模型效果对比
| 测试输入 | Llama输出 | Alpaca输出 | Huatuo华驼输出 |
|---|---|---|---|
| 小张最近感觉身体不适,出现心悸、气促等症状。体检发现心脏扩大、搏动减弱。 | 问题:小张最近感觉身体不适,出现心悸、气促等症状。体检发现心脏扩大、搏动减弱。 | 最近,小张一直感觉身体不舒服,有心烦意乱、呼吸急促等症状。体格检查显示心脏增大,肌肉无力。 | 小张可能患有心肌炎,建议尽快到医院进行检查和治疗。治疗方案包括药物治疗和手术治疗。 |
| 麻风病和儿童哮喘的病因是否一致? | 儿童哮喘和麻风病的病因是一致,但是儿童哮喘和麻风病的病因不一致 | 是的,哮喘和儿童喘息有相似的原因。 | 不一致,麻风病的病因是麻风杆菌感染,而儿童哮喘的病因是喂养不良、吸烟等因素。 |
| 一位患者出现了持续性的胀痛和黄疸,经影像学检查后确诊为肝胆管结石病,应该采取哪些治疗方案? | 肝胆管结石病患者应该采取哪些治疗方案? | 患者应接受手术和化疗相结合的治疗。 | 针对肝胆管结石病,治疗方案包括手术治疗、药物治疗和辅助治疗等。具体治疗方案需要根据患者的具体情况而定。 |
常见问题
1.Q: 为什么是"华驼"而不是"华佗"?A: 叫”驼“是因为我们的基模型LLaMA是美洲驼,Alpaca是羊驼,受他们名字的启发以及华佗的谐音梗,我们将我们的模型起名为华驼。2.Q: 有使用中医理论或者中医数据吗?A: 目前还没有3.Q: 模型运行的结果不同、效果有限A: 由于生成模型生成多样性的考量,多次运行的结果可能会有差异。当前开源的模型由于LLaMA及Alpaca中文语料有限,且知识结合的方式较为粗糙,目前我们在进行相关改进研究,完成后欢迎大家的关注。
项目参与者
本项目由哈尔滨工业大学社会计算与信息检索研究中心健康智能组王昊淳[10] 、杜晏睿[11]、刘驰[12]、白睿[13]、席奴瓦[14]、陈雨晗[15]、强泽文[16]、陈健宇[17]、李子健[18]完成,指导教师为赵森栋副教授,秦兵教授以及刘挺教授。
致谢
本项目参考了以下开源项目,在此对相关项目和研究开发人员表示感谢。
•Facebook LLaMA: https://github.com/facebookresearch/llama•Stanford Alpaca: https://github.com/tatsu-lab/stanford_alpaca•alpaca-lora by @tloen: https://github.com/tloen/alpaca-lora•CMeKG https://github.com/king-yyf/CMeKG_tools•文心一言 https://yiyan.baidu.com/welcome 本项目的logo由文心一言自动生成
免责声明
本项目相关资源仅供学术研究之用,严禁用于商业用途。使用涉及第三方代码的部分时,请严格遵循相应的开源协议。模型生成的内容受模型计算、随机性和量化精度损失等因素影响,本项目无法对其准确性作出保证。本项目数据集绝大部分由模型生成,即使符合某些医学事实,也不能被用作实际医学诊断的依据。对于模型输出的任何内容,本项目不承担任何法律责任,亦不对因使用相关资源和输出结果而可能产生的任何损失承担责任。
Citation
如果你使用了本项目的数据或者代码,请声明引用
代码语言:javascript
@misc{wang2023huatuo,
      title={HuaTuo: Tuning LLaMA Model with Chinese Medical Knowledge},
      author={Haochun Wang and Chi Liu and Nuwa Xi and Zewen Qiang and Sendong Zhao and Bing Qin and Ting Liu},
      year={2023},
      eprint={2304.06975},
      archivePrefix={arXiv},
      primaryClass={cs.CL}
如何系统的去学习AI大模型LLM ?
作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。
但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的 AI大模型资料 包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
所有资料 ⚡️ ,朋友们如果有需要全套 《LLM大模型入门+进阶学习资源包》,扫码获取~

一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。


四、AI大模型商业化落地方案

阶段1:AI大模型时代的基础理解
- 目标:了解AI大模型的基本概念、发展历程和核心原理。
- 内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践 - L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
- 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
- 内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例 - L2.2 Prompt框架
- L2.2.1 什么是Prompt
- L2.2.2 Prompt框架应用现状
- L2.2.3 基于GPTAS的Prompt框架
- L2.2.4 Prompt框架与Thought
- L2.2.5 Prompt框架与提示词 - L2.3 流水线工程
- L2.3.1 流水线工程的概念
- L2.3.2 流水线工程的优点
- L2.3.3 流水线工程的应用 - L2.4 总结与展望
- L2.1 API接口
阶段3:AI大模型应用架构实践
- 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
- 内容:
- L3.1 Agent模型框架
- L3.1.1 Agent模型框架的设计理念
- L3.1.2 Agent模型框架的核心组件
- L3.1.3 Agent模型框架的实现细节 - L3.2 MetaGPT
- L3.2.1 MetaGPT的基本概念
- L3.2.2 MetaGPT的工作原理
- L3.2.3 MetaGPT的应用场景 - L3.3 ChatGLM
- L3.3.1 ChatGLM的特点
- L3.3.2 ChatGLM的开发环境
- L3.3.3 ChatGLM的使用示例 - L3.4 LLAMA
- L3.4.1 LLAMA的特点
- L3.4.2 LLAMA的开发环境
- L3.4.3 LLAMA的使用示例 - L3.5 其他大模型介绍
- L3.1 Agent模型框架
阶段4:AI大模型私有化部署
- 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
- 内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
学习计划:
- 阶段1:1-2个月,建立AI大模型的基础知识体系。
- 阶段2:2-3个月,专注于API应用开发能力的提升。
- 阶段3:3-4个月,深入实践AI大模型的应用架构和私有化部署。
- 阶段4:4-5个月,专注于高级模型的应用和部署。
这份完整版的所有 ⚡️ 大模型 LLM 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
全套 《LLM大模型入门+进阶学习资源包》↓↓↓ 获取~
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


