python机器学习评估指标

python机器学习评估指标(1) 不知道你们用的什么环境,我一般都是用的Python3.6环境和pycharm解释器,没有软件,或者没有资料,没人解答问题,都可以免费领取(包括今天的代码),过几天我还会做个视频教程出来,有需要也可以领取~给大家准备的学习资料包括但不限于:Python 环境、pycharm编辑器/永久激活/翻译插件python 零基础视频教程Python 界面开发实战教程Python 爬虫实战教程Python 数据分析实战教程python 游戏开发实战教程Python 电子书100本。 阅读详情

介绍

狙击手

不仅在机器学习中,而且在一般生活中,尤其是商业生活中,您都会听到诸如“您的产品有多准确?”之类的问题。或“你的机器有多精确?”。当人们收到诸如“这是该领域最准确的产品!”之类的回复时。或“这台机器具有可以想象的最高精度!”,这两个答案让他们感到很欣慰。他们不应该吗?事实上,术语accurate和precise经常可以互换使用。我们将在本文后面给出确切的定义,但简而言之,我们可以说:准确度是对某些测量值与特定值的接近程度的度量,而精度是测量值彼此之间的接近程度。

这些术语在机器学习中也非常重要。我们需要它们来评估 ML 算法或改善其结果。

我们将在 Python 机器学习教程的本章中介绍四个重要指标。这些指标用于评估分类结果。指标是:

  • 准确性
  • 精确
  • 记起
  • F1-Score

我们将介绍这些指标中的每一个,并讨论每个指标的优缺点。每个指标衡量分类器性能的不同之处。这些指标对于我们机器学习教程的所有章节都至关重要。

准确性

准确度是测量值与特定值的接近程度的度量,而精度是测量值彼此之间的接近程度,即不一定与特定值接近。换句话说:如果我们有一组来自相同数量的重复测量的数据点,如果它们的平均值接近被测量数量的真实值,则称该组是准确的。另一方面,如果值彼此接近,我们称集合为精确的。这两个概念是相互独立的,这意味着数据集可以是准确的,也可以是精确的,或者两者兼而有之,或者两者都不是。我们在下图中展示了这一点:
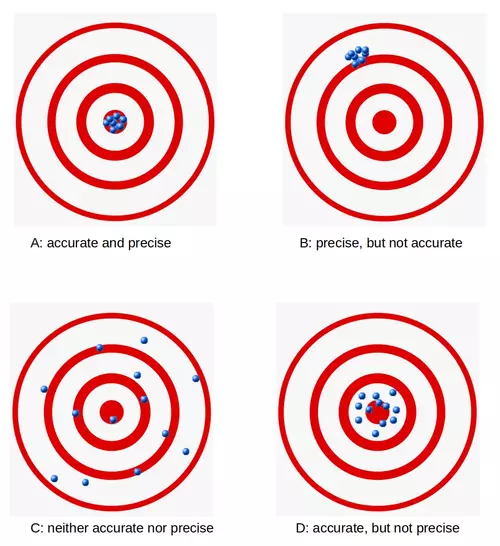
准确度与精密度

混淆矩阵

在我们继续使用术语 之前accuracy,我们要确保您了解混淆矩阵的含义。

混淆矩阵,也称为列联表或误差矩阵,用于可视化分类器的性能。

矩阵的列代表预测类的实例,行代表实际类的实例。(注意:也可以反过来。)

在二进制分类的情况下,该表有 2 行和 2 列。

我们想用一个例子来演示这个概念。

混淆矩阵示例

预测类别
猫狗
实际
班级
猫428
狗1832

这意味着分类器在 42 个案例中正确预测了一只猫,并将 8 个猫实例错误地预测为狗。它正确地将 32 个实例预测为狗。18 例被错误地预测为猫而不是狗。

分类准确度

我们对机器学习感兴趣,准确性也被用作统计指标。准确度是一种统计量度,定义为分类器做出的正确预测(真阳性 (TP) 和真阴性 (TN))的商除以分类器做出的所有预测的总和,包括假阳性 (FP)和假阴性(FN)。因此,量化二进制精度的公式为:

准确性=吨磷+吨N吨磷+吨N+F磷+FN

其中: TP = 真阳性;FP = 误报;TN = 真阴性;FN = 假阴性

对应的混淆矩阵如下所示:

预测类别
消极的积极的
实际
班级
消极的田纳西州FP
积极的FNTP

我们现在将计算猫狗分类结果的准确性。我们在这里看到的不是“真”和“假”,而是“猫”和“狗”。我们可以这样计算准确度:

TP  =  42 
TN  =  32 
FP  =  8 
FN  =  18

精度 =  ( TP  +  TN ) / ( TP  +  TN  +  FP  +  FN )
打印(精度)

输出:

0.74

假设我们有一个分类器,它总是预测“狗”。

预测类别
猫狗
实际
班级
猫050
狗050

在这种情况下,我们的精度为 0.5:

TP , TN , FP , FN  =  0 , 50 , 50 , 0
精度 =  (TP  +  TN )/ (TP  +  TN  +  FP  +  FN )
打印(精度)

输出:

0.5

准确性悖论

我们将证明所谓的准确性悖论。

垃圾邮件识别分类器由以下混淆矩阵描述:

预测类别
垃圾邮件火腿
实际
班级
垃圾邮件41
火腿491
TP , TN , FP , FN  =  4 , 91 , 1 , 4
准确性 =  (TP  +  TN )/ (TP  +  TN  +  FP  +  FN )
打印(准确性)

输出:

0.95

以下分类器仅预测“ham”并具有相同的准确性。

预测类别
垃圾邮件火腿
实际
班级
垃圾邮件05
火腿095
TP , TN , FP , FN  =  0 , 95 , 5 , 0
精度 =  (TP  +  TN )/ (TP  +  TN  +  FP  +  FN )
打印(准确性)

输出:

0.95

该分类器的准确率为 95%,即使它根本无法识别任何垃圾邮件。

精确

精度是正确识别的阳性案例与所有预测的阳性案例的比率,即正确和错误预测的案例为positive。精度是检索到的与查询相关的文档的比例。公式:

pr电子C一世秒一世○n=吨磷吨磷+F磷

我们将通过一个例子来证明这一点。

预测类别
垃圾邮件火腿
实际
班级
垃圾邮件1214
火腿0114

我们可以计算precision我们的例子:

TP  =  114 
FP  =  14 
# 公式中不需要 FN (0) 和 TN (12)!
精度 =  TP  /  ( TP  +  FP )
打印( f "precision: {precision:4.2f} " )

输出:

精度:0.89

练习:在继续阅读文本之前,请先考虑该值的precision含义。如果您查看我们的垃圾邮件过滤器示例的精确度度量,它会告诉您关于垃圾邮件过滤器质量的什么信息?理想垃圾邮件过滤器的混淆矩阵的结果是什么样的?什么更糟,高 FP 或 FN 值?

您将在以下说明中间接找到答案。

顺便说一下,理想的垃圾邮件过滤器的 FP 和 FN 值都为 0。

先前的结果意味着 100 封邮件中有 11 封会被归类为火腿,即使它们是垃圾邮件。89 个被正确归类为火腿。这是我们应该讨论错误分类成本的地方。当垃圾邮件不被识别为“垃圾邮件”,而是作为“火腿”呈现给我们时,这很麻烦。如果百分比不是太高,这很烦人但不是灾难。相比之下,当非垃圾邮件被错误地标记为垃圾邮件时,该电子邮件在许多情况下不会显示甚至自动删除。例如,这会带来失去客户和朋友的高风险。该措施precision没有对最后提到的这个问题类别作出任何声明。其他措施呢?

我们将看看recall和F1-score。

记起

召回率,也称为灵敏度,是正确识别的阳性案例与所有实际阳性案例的比率,它是“假阴性”和“真阳性”的总和。

r电子C一个升升=吨磷吨磷+FN

TP  =  114 
FN  =  0 
# 公式中不需要 FT (14) 和 TN (12)!
召回 =  TP  /  ( TP  +  FN )
打印( f "recall: {recall:4.2f} " )

输出:

召回:1.00

值 1 表示没有非垃圾邮件被错误地标记为垃圾邮件。对于一个好的垃圾邮件过滤器来说,这个值应该是 1 很重要。我们之前已经讨论过这个。

F1-分数

我们将检查的最后一个指标是 F1 分数。

F1=21r电子C一个升升+1pr电子C一世秒一世○n=2⋅pr电子C一世秒一世○n⋅r电子C一个升升pr电子C一世秒一世○n+r电子C一个升升

TF  =  7  # 我们将 True false 值设置为 5 % 
print ( " FN FP TP pre acc rec f1" ) 
for  FN  in  range ( 0 ,  7 ): 
    for  FP  in  range ( 0 ,  FN + 1 ): 
        # the sum FN、FP、TF 和 TP 的
        值为100:TP  =  100  -  FN  -  FP  -  TF 
        #print(FN, FP, TP, FN+FP+TP+TF) 
        precision  =  TP  /  ( TP  +  FP)
        准确率 =  ( TP  +  TN ) / ( TP  +  TN  +  FP  +  FN )
        召回率 =  TP  /  ( TP  +  FN ) 
        f1_score  =  2  * 准确率 * 召回率 /  (准确率 + 召回率)
        打印( f " {FN:6.2f} {FP:6.2f}{TP:6.2f} " ,  end = "" )
        打印( f" {precision:6.2f}{accuracy:6.2f}{recall:6.2f}{f1_score:6.2f} " )

输出:

  FN FP TP pre acc rec f1
  0.00 0.00 93.00 1.00 1.00 1.00 1.00
  1.00 0.00 92.00 1.00 0.99 0.99 0.99
  1.00 1.00 91.00 0.99 0.99 0.99 0.99
  2.00 0.00 91.00 1.00 0.99 0.98 0.99
  2.00 1.00 90.00 0.99 0.98 0.98 0.98
  2.00 2.00 89.00 0.98 0.98 0.98 0.98
  3.00 0.00 90.00 1.00 0.98 0.97 0.98
  3.00 1.00 89.00 0.99 0.98 0.97 0.98
  3.00 2.00 88.00 0.98 0.97 0.97 0.97
  3.00 3.00 87.00 0.97 0.97 0.97 0.97
  4.00 0.00 89.00 1.00 0.98 0.96 0.98
  4.00 1.00 88.00 0.99 0.97 0.96 0.97
  4.00 2.00 87.00 0.98 0.97 0.96 0.97
  4.00 3.00 86.00 0.97 0.96 0.96 0.96
  4.00 4.00 85.00 0.96 0.96 0.96 0.96
  5.00 0.00 88.00 1.00 0.97 0.95 0.97
  5.00 1.00 87.00 0.99 0.97 0.95 0.97
  5.00 2.00 86.00 0.98 0.96 0.95 0.96
  5.00 3.00 85.00 0.97 0.96 0.94 0.96
  5.00 4.00 84.00 0.95 0.95 0.94 0.95
  5.00 5.00 83.00 0.94 0.95 0.94 0.94
  6.00 0.00 87.00 1.00 0.97 0.94 0.97
  6.00 1.00 86.00 0.99 0.96 0.93 0.96
  6.00 2.00 85.00 0.98 0.96 0.93 0.96
  6.00 3.00 84.00 0.97 0.95 0.93 0.95
  6.00 4.00 83.00 0.95 0.95 0.93 0.94
  6.00 5.00 82.00 0.94 0.94 0.93 0.94
  6.00 6.00 81.00 0.93 0.94 0.93 0.93

我们可以看到,这f1-score最能反映 FN 值上升的最坏情况,即 ham 被归类为垃圾邮件!

Python 机器学习 基础 之 模型评估与改进 【评估指标与评分】的简单说明 Python是一种跨平台的计算机程序设计语言。是一种面向对象的动态类型语言,最初被设计用于编写自动化脚本(shell),随着版本的不断更新和语言新功能的添加,越多被用于独立的、大型项目的开发。Python是一种解释型脚本语言,可以应用于以下领域: Web 和 Internet开发、科学计算和统计、人工智能、教育、桌面界面开发、软件开发、后端开发、网络爬虫。Python 机器学习是利用 Python 编程语言中的各种工具和库来实现机器学习算法和技术的过程。 阅读详情

相关推荐

Python机器学习笔记(二十四 模型评估与改进-评估指标与评分)

在监督学习中,选择合适的评估指标对模型性能的评估至关重要。常用的指标包括精度(用于分类)和R2(用于回归),但这些指标并不总是适用于所有应用场景。选择指标时应考虑最终目标,即商业指标,如减少交通事故或增加用户消费。对于不平衡数据集,精度可能误导,因此需要更合适的指标如混淆矩阵、准确率、召回率和F1分数。此外,准确率-召回率曲线和ROC曲线提供了更全面的模型性能视图,AUC(ROC曲线下面积)是评估不平衡数据集的有力工具。在多分类问题中,可以使用宏平均、加权平均或微平均F1分数。在模型选择中,可以通过scor

FreedomLeo1的博客 324

Python机器学习:评价指标

评价指标

faltas的博客 1585

FreeRtos——10、全局看门狗设计

RTOS 里的看门狗不只是为了证明 CPU 还在动,而是为了证明每个业务逻辑都在按预期的节奏“呼吸”。

qq_40170041的博客 905

机器学习模型常用性能指标和Python代码实现

理解机器学习性能指标,助力算法模型推广应用。

taozibaby的博客 2354

Ansys Lumerical + HFSS + optiSLang 三剑客:手把手教你优化行波MZM调制器(附完整参数配置)

本文详细介绍了如何利用Ansys Lumerical、HFSS和optiSLang三款工具构建自动化协同设计流程,以优化行波马赫曾德尔调制器(TW-MZM)的性能。通过参数化仿真、流程集成与元模型技术,该方案能高效解决多物理场耦合挑战,实现调制带宽、驱动电压等多目标的全局优化,显著提升光子集成芯片的设计效率与性能潜力。

weixin_29251131的博客 589

5G NR切换测量事件解析:从A1到B2的实战应用指南

本文深入解析5G NR切换测量事件,从A1到B2的实战应用指南。详细介绍了系统内切换事件(A1-A6)和系统间切换事件(B1-B2)的触发条件与配置建议,帮助优化网络性能。通过实际案例分享,展示如何调整参数提升切换成功率和降低乒乓切换率,适用于5G网络优化工程师。

tcp8optimizer的博客 516

如何用python完成评分功能呢_python进行机器学习(五)之模型打分

#!/usr/bin/pythonimportpandas as pdimportnumpy as npimportcsv as csvimportmatplotlibimportmatplotlib.pyplot as pltfrom sklearn.linear_model importRidge, RidgeCV, ElasticNet, LassoCV, LassoLarsCVfrom s...

weixin_39968436的博客 491

GNSS差分码偏差(DCB)从原理到实战:如何避免数据处理中的常见错误

本文深入解析GNSS差分码偏差(DCB)的原理及其对高精度定位的关键影响。针对数据处理中因忽略DCB校正导致的常见错误,如单系统PPP高程偏差、多系统融合精度下降及电离层研究失真等,提供了实战解决方案与主流DCB产品获取、集成方法,帮助用户有效规避陷阱,提升数据处理精度。

k5l6m的博客 224

Python通过机器学习实现对个人信用评估

在银行贷款行为中,银行最关心的就是贷款人是否会违约从而造成贷款损失。而避免贷款被发放给可能违约的贷款人的主要手段就是对贷款人进行信用评估。信用评估是银行对借款人信用情况进行评估的一种活动。银行贷款的最基本条件是信用,信用好就容易取得银行贷款支持,信用差就难以取得银行贷款支持。而借款人信用是由多种因素构成的,包括借款人资产负债状况、经营管理水平、产品经济效益及市场发展趋势等等。为了对借款人信用状况有一个统一的基本的正确的估价,以便正确掌握银行贷款,就必须对借款人信用状况进行评估。信用评估包括个人信用评分、企业

毕业作品网站 3980

Ubuntu22.04如何安装cuDNN8.9.7

本文详细介绍了在Ubuntu 22.04系统上为CUDA 12.2安装适配cuDNN 8.9.7的完整流程,特别针对RTX A6000显卡。主要内容包括:1)选择与CUDA 12.2兼容的cuDNN版本;2)使用deb包方式的安装步骤(添加仓库、导入密钥、安装组件);3)通过MNIST示例验证安装;4)版本锁定、卸载旧版等补充说明;5)性能测试方法。文中强调了版本匹配的重要性,并提供了多卡配置建议,为搭建深度学习开发环境提供完整指导。

2501_93651177的博客 1845

【机器人学】常用的小车底盘运动学模型推导(附C++代码)

认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长!本文先对小车底盘运动学模型介绍做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章提示:以下是本篇文章正文内容对于小车的分析,仅仅考虑XY轴的线速度和Z轴的角速度,不考虑和横滚和俯仰的速度,【防盗标记–盒子君hzj】也不考虑Z轴的高度变化【即:车底盘的运动可以用三个独立变量来描述:x轴平动、y轴平动、yaw轴转动】

qq_35635374的博客 1932

python评价指标_机器学习中的评价指标

:数据科学、人工智能从业者的在线大学。数据科学(Python/R/Julia)数据分析、机器学习、深度学习 Q群:874447702前 言在人工智能领域,机器学习的效果需要用各种指标来评价。本文将阐述机器学习中的常用性能评价指标,矢量卷积与神经网格的评价指标不包括在内。训练与识别当一个机器学习模型建立好了之后,即模型训练已经完成,我们就可以利用这个模型进行分类识别。比如,给模型输入一张电动车的照片...

weixin_39551993的博客 851

腾讯Android开发面试准备指南及参考答案

腾讯元宝高级Android开发职位面试准备指南 该职位要求扎实的Kotlin基础、架构设计能力和性能优化经验,重点关注Android客户端开发。面试流程约3轮,支持线上面试,流程较快。候选人需准备以下核心内容: 基础技术:Kotlin特性、Android开发生命周期、多线程编程 架构设计:MVVM/MVI模式应用、组件化解耦方案 性能优化:流畅度提升、内存管理、启动时间优化等实战案例 加分技能:Jetpack Compose开发、音视频处理、跨平台开发经验 建议结合项目经验准备具体案例,突出技术深度和问题解

郑伟强dev的专栏 1196

机器学习模型评估指标与Python实现

准确率是分类问题中最常用的评估指标之一,定义为模型预测正确的样本数占总样本数的比例。AccuracyTPTNTPTNFPFNAccuracyTPTNFPFNTPTN​: 真正例,模型正确预测为正类的样本数。: 真负例,模型正确预测为负类的样本数。: 假正例,模型错误预测为正类的样本数。: 假负例,模型错误预测为负类的样本数。

木头大左的博客 1324

python基础:工作会用到的90%的python代码都在这了(万字详解!)

Python 备忘单是 Python 3 编程语言的单页参考表 著名的“Hello World”程序在 Python 中的实现 Python 不能在没有赋值的情况下声明变量 变量可以存放不同类型的值 内置数据类型 序列指一批有序的元素,集合指一批无序且不重复的元素查看: 数据类型 查看: 字符串 查看: 列表 查看: 判断 查看: 循环 查看: 函数 查看: 文件处理 表示 x 和 y 的商, 表示 x 和 y 的底商,另见 StackOverflow f-字符串 (Python 3.6+) 查看

数据知道的博客 1万+

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

44、Python机器学习的模型评估指标【用Python进行AI数据分析进阶教程】

摘要:本文介绍了Python机器学习中常用的模型评估指标,包括均方误差(MSE)、均方根误差(RMSE)、平均绝对误差(MAE)和决定系数(R²)。这些指标用于衡量模型的预测性能和拟合程度。MSE反映预测值与真实值之间的平均误差大小,但对异常值敏感;RMSE是MSE的平方根,单位与原始数据一致,更直观;MAE衡量预测值与真实值的平均绝对偏差,对异常值相对不敏感;R²衡量模型对数据的拟合优度,越接近1表示模型拟合效果越好。

imewe的博客 1339

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

python accuracy_机器学习模型性能评估指标总结以及python实现

混淆矩阵(Confusion Matrix)混淆矩阵是衡量分类型模型准确度中最基本,最直观,计算最简单的方法。简单来说,混淆矩阵就是一张表格。他的四个基础指标如下: TP(true positive):真实值是positive,预测值也是positive的值数量TN(true negative):真实值是negative,预测值也是negative的值数量FP(false positive):真实...

weixin_39636857的博客 2221

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

《Python机器学习基础教程》第五章模型评估与改进5.18 深度解析:如何在模型选择中有效利用评估指标

分类任务准确率(Accuracy)精确率(Precision)召回率(Recall)F1分数(F1 Score)ROC曲线下的面积(AUC-ROC)回归任务均方误差(MSE)均方根误差(RMSE)R²分数(R-Squared)平均绝对误差(MAE)

1166

python中sgd模型_第63集 python机器学习:在模型中使用评估指标

前面我们学习了许多评估方法,以及如何根据真实情况和具体模型来应用这些评估方法。同时我们希望在使用GridSearchCV或cross_val_score进行模型选择时能够使用AUC等指标。我们知道,在scikit-learn中提供了一种非常简单的实现方法——scoring参数。它可同时用于GridSearchCV和cross_val_score。我们只需要提供一个字符串指定其评估方式即可。我们仍然...

weixin_34500880的博客 215

机器学习模型性能评估指标总结以及python实现

模型性能指标总结目录新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 目录 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解一下Mar

qq_37537170的博客 2628

Python机器学习模型评估指标全解析与应用指南

机器学习模型评估是算法落地的关键环节,其核心在于根据数据特性和业务场景选择合适的评估指标。在分类问题中,准确率、召回率、F1 Score和AUC等指标各有适用场景——金融风控关注召回率以避免漏检,医疗诊断需要平衡精确率与召回率。回归问题则需根据误差分布选择MSE、MAE或MSLE等指标。Python的scikit-learn库提供了丰富的评估工具,如precision_recall_curve和roc_auc_score等函数。实际工程中还需考虑时间序列交叉验证、概率校准等高级技术,并构建自动化评估流水线。

weixin_30385925的博客 406

Python机器学习笔记:sklearn库的学习、常用评估指标的用法

Python机器学习笔记:sklearn库的学习 https://www.cnblogs.com/wj-1314/p/10179741.html Python机器学习笔记:常用评估指标的用法 https://www.cnblogs.com/wj-1314/p/9400375.html ...

xianglock的博客 509

《Python机器学习基础教程》第五章模型评估与改进5.14 深度解析:二分类评估指标详解与实战

准确率是指分类正确的样本数占总样本数的比例。AccuracyTPTNTPFPFNTNAccuracyTPFPFNTNTPTN​其中,TP(True Positive)表示真正例,TN(True Negative)表示真负例,FP(False Positive)表示假正例,FN(False Negative)表示假负例。

1208

《Python机器学习基础教程》第五章模型评估与改进5.13 深度解析:如何根据具体问题选择合适的评估指标

评估指标是用于衡量模型性能的标准。它们可以帮助我们了解模型在预测任务中的表现,从而进行模型选择和调优。常见的评估指标包括准确率、精确率、召回率、F1分数等。

1076

Python机器学习--算法评估指标--各类型算法评估指标

聚类算法常用评估指标:轮廓系数 SSE(误差平方和) - 分类算法常用评估指标:准确率,查准率,查全率,F1-score,PR曲线,ROC曲线和AUC指标,ROC曲线下的面积就是AUC指标. - 回归算法的评估指标:R方范围[-inf,1] (真实值与预测 ),MSE,MAE,RMSE...

寒江之雪,披蓑独钓的博客 3728

【Python机器学习模型评估终极指南】:掌握5大核心指标提升模型准确率

掌握Python机器学习模型评估核心方法,提升模型准确率与泛化能力。详解准确率、精确率、召回率、F1分数和AUC-ROC五大指标,覆盖分类、预测等典型场景。实用代码示例+指标对比解析,助你高效评估模型性能,值得收藏。

CompiTide的博客 532
上一篇: 机器学习术语
下一篇: 数据的数据表示和可视化
程序员孔乙己
博客等级 码龄5年 1191粉丝 81原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值