redis再战之AKF的Z轴拆分和代理集群搭建《八》

Amber-Garden:面向生产落地的扩展性工程实践体系 扩展性不是上线后的补救措施,而是架构设计的默认属性。从AKF扩展模型到纵向/横向扩展实操,从Tomcat NIO线程池调优到Caffeine+Redis缓存协同,再到数据库覆盖索引与填充因子优化,本文聚焦高可用性与可测试性两大核心诉求,系统拆解真实业务场景中流量增长、慢查询激增、连接池耗尽等典型问题的技术根因与可复用解法。内容覆盖服务端缓存、数据库分片、读写分离、非阻塞IO等高频搜索关键词,强调‘数据驱动决策’与‘故障前置防御’,适用于SaaS、电商、高并发中后台等成长型系统架构演进。 阅读详情

容量问题

单机redis在使用的时候会碰到三个问题:单点故障、容量不足、访问压力。

  • 因此我们可以对redis进行AKF拆分,站在x轴的角度上可以对redis进行 主从复制 + 哨兵机制。
  • 主从复制:slave做master的全量备份保证数据的可靠性。master对外提供读写,slave对外提供读操作(读写分离),解决了部分访问压力。
  • 哨兵机制:对master做高可用,使用 哨兵集群 监控master健康状态,哨兵之间相互通信,如果发现master挂了会进行投票选举 其中一个个slave作为新的master。解决了单点故障的问题。
  • 但是由于slave是master的全量数据,在容量这个维度上来说,redis依然是一个单实例的。对于臃肿的redis实例来说,还需要对其进行y轴个z轴的拆分。

Z轴拆分

原因
Y轴拆分后某一业务的数据量还是很大,我们可以对Z轴方向上,在Client端根据 算法 继续拆分。(sharding 分片)

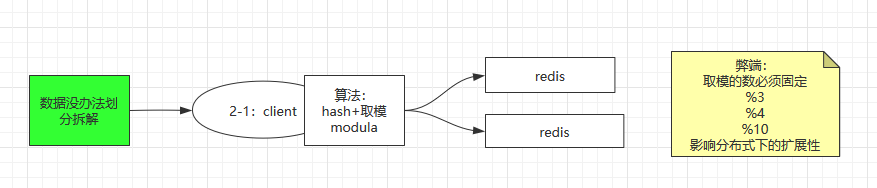
1. modula(hsah + 取模):
在这里插入图片描述

  • 这种方式是在Client增加算法逻辑,把要存入数据的进行 % 运算,后边有几个redis实例,就和几进行 % 运算,根据取模的值,把数据存入到不同的redis实例。

优点: 简单,容易操作。

缺点: 取模的值是固定的,影响分布式下的扩展性,如果添加新的redis实例会使 模数值 发生改变,再取数据的时候根据 模数 去取就无法查找到数据了。

2. random:
在这里插入图片描述

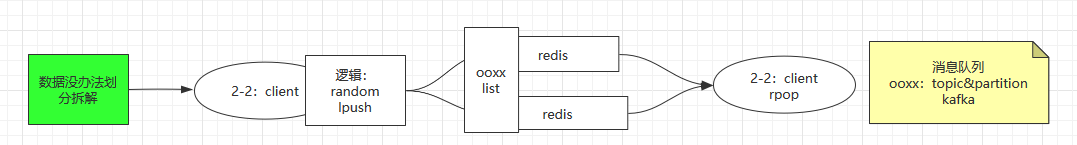
  • Client把数据随机放到不同的redis实例中:

应用

随机把数据放入不同的redis,取出成本很高?根本找不到数据?

如果存入的是一个list类型(lpush),key为ooxx,那么就会在两个redis中都生成ooxx的key,这个时候消费者并不是执行lpush的Client,而是执行rpop的另一个Client,都会从ooxx中取数据,无论从哪个redis取,都会取到key为ooxx的数据。这样就形成了一个类似于消息队列的功能。

3. ketama(一致性hash):
在这里插入图片描述

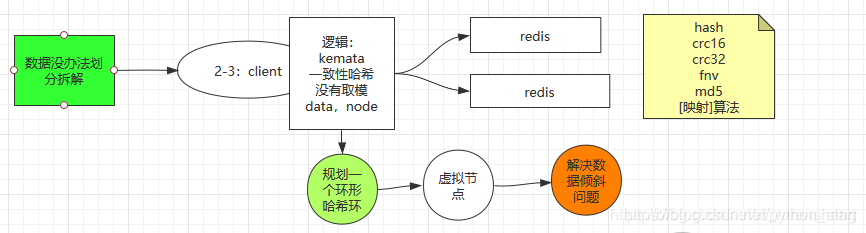
  • 在得到一个长度随机的字符串后(redis的key),经过算法得到一个等宽的其他的值(算法:hash、crc16、crc32、fnv、md5),这个值会和字符串做一个映射。
  • 和hash取模算法不同的是,一致性hash没有取模的过程(即:不会影响分布式扩展性),并且要求key和node都要参与计算。
  • 会在内存中虚拟出一个环形(哈希环)。
  • 在这里插入图片描述
  • 哈希环由0 -2^32个数字组成,每一个数字都是一个点。无论后面有多少个redis实例,或新增,或减少,都会给这些redis实例一个ID号(或者IP+Port之类的)唯一标识。

优点:

  • 没有固定node数量的限制,不会造成全局洗牌。

缺点:

  • 新增节点后,造成一小部分数据无法命中。
  • 如上图,新增一个节点 node3,把node3的ID进行hash运算得到一个数值,这个数值对应 哈希环 的点 恰好在之前数据映射的点和它存入node之间(data -> node2 变为 data -> node3 -> node2), 此时如果查询data,不会从node2查询,而是会从node3里面查找data,因此查询结果为null。
  • 这种方式只适合做缓存而不适合做数据库,缓存大多为期限,即使node2里面data数据永远不会被查询到,data也会随着时间的推移而被清除掉,或者开启缓存清理策略LRU、LFU。并且node3里面无法查询到数据,可以走数据库从新缓存到node3(缓存击穿),也可以修改为从比自己大的两个node中查找数据。

扩展:虚拟节点

  • 原因
    如果node1和node2映射在哈希环的点分别在最左边和最右边,把哈希环切分成了 上半环 和 下半环,在添加数据的时候就可能出现 数据集中在某个半环上而导致 数据量的倾斜。
  • 解决
    我们可以每个node ID后面依次拼10个数字,让一个ID变成10个,用这些ID做hash运算映射到 哈希环 不同的点上,如果是两个设备在 哈希环 上面就会有20个点,这样做的目的是让一个物理设备出现在多个点上,就可以间接的解决数据倾斜的问题。

redis的连接成本很高

可以在Client和redis之间增加一个代理层(proxy),类似于Nginx这种应用层 的反向代理,基于反向代理的基础上负载均衡服务器。

  • redis自带的拆分:cluster
  • twemproxy
  • predixy

扩展
proxy是不需要记录Client状态,本身不存在数据库存储,所以proxy是无状态的 ,很容易的就可以把proxy一变多。

为了提高可用性,可以搭建LVS四层负载均衡服务器对两个proxy做负载均衡。

但是LVS也是一个单点,并且不能对后端的proxy集群做健康检查,所以可以使用keepalived建立VIP对LVS做主备HA高可用。
在这里插入图片描述

redis自带的拆分:cluster

规避了ketama新增redis实例时截断数据
在这里插入图片描述
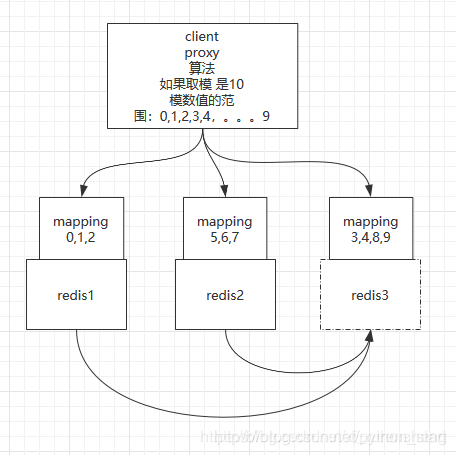
拆分逻辑中进行预分区
redis1映射0,1,2,3,4
redis2映射5,6,7,8,9
(各领取5个槽位)。
如果redis3加入集群,会让redis1和redis2让出几个槽位,比如从redis1中拿到了3和4,在redis2中拿到了8和9(如上图)。移动数据的时候,不需要把redis全部rehash,只需要把3,4,8,9槽位的时点数据找到直接传输给redis3,redis3接收完数据后,会根据时点数据跟redis1和redis2传输期间内的数据做一个追平更新,追平的一刹那,再往3,4,8,9槽位存数据就会直接存入redis3。
Client只需要知道映射关系,就可以根据槽位正确的读取数据了

存取数据

Client想要存入k1,会随机访问redis1和redis2。可以让每个redis实例都能当家做主。k1随机进入一个redis实例后(假设这个实例是redis2),redis2会先拿k1进行hash取模算出槽位,用计算的槽位和自己的mapping映射的槽位做一个匹配,如果和自己匹配就直接存入redis2,如果不匹配再和redis2内保存的其他实例的槽位映射关系进行匹配,就能找到k1需要存的redis实例是哪个,把k1返回给Client并重定向到正确的redis实例中(假设匹配结果为redis3)。redis3拿到k1后同样要进行hash运算并且把结果和自身映射槽位进行匹配,匹配成功直接存入自己这个实例当中。

Redis 集群没有使用一致性hash, 而是引入了 哈希槽的概念。
Redis 集群有16384个哈希槽,每个key通过CRC16校验后对16384取模来决定放置哪个槽.集群的每个节点负责一部分hash槽

问题: 聚合操作很难实现

操作的key都在相同的节点,可以用 hash tag 。
比如:把key设置成为{oo}k1,{oo}k2,{oo}k3这种带有{}内部有固定标识的 格式,这样在存入key的时候会使用 oo 进行取模,而不会使用k1,k2,k3进行取模。进而存入同一个redis节点。

twemproxy搭建过程

github

git clone https://github.com/twitter/twemproxy.git
yum install automake   libtool -y
cd twemproxy
autoreconf -fvi

报错:autoconf版本过低
解决办法

wget -O /etc/yum.repos.d/epel.repo http://mirrors.aliyun.com/repo/epel-6.repo
yum clean all
yum install  autoconf268
cd twemproxy
autoconf268  -fvi
./configure
make
cd scripts/
cp nutcracker.init /etc/init.d/twemproxy
cd /etc/init.d/
chmod +x twemproxy  
mkdir  /etc/nutcracker/
cd  twemproxy /conf
cp ./*     /etc/nutcracker/
cd  twemproxy/src
cp nutcracker  /usr/bin
cd /etc/nutcracker
cp nutcracker.yml nutcracker.yml.back
vi nutcracker.yml
service twemproxy start

nutcracker.yml


alpha:
  listen: 127.0.0.1:22121
  hash: fnv1a_64
  distribution: ketama
  auto_eject_hosts: true
  redis: true
  server_retry_timeout: 2000
  server_failure_limit: 1
  servers:
   - 127.0.0.1:6379:1
   - 127.0.0.1:6380:1

客户端直接连接22121端口
谈到集群管理不得不又说到数据的分片管理(shard),为了满足数据的日益增长和扩展性,数据存储系统一般都需要进行一定的分片,如传统的MySQL进行横向分表和纵向分表,然后应用程序访问正确的位置就需要找的正确的表。这时候,这个数据定向工作一般有三个位置可以放:

数据存储系统本身支持,Redis Cluster就是典型的试图在数据存储系统上支持分片;
客户端支持,Memcached的客户端对分片的支持就是客户端层面的;
代理支持,twemproxy就是试图在服务器端和客户端中间建代理支持;

predixy搭建过程

github

mkdir predixy
cd predixy/
wget https://github.com/joyieldInc/predixy/releases/download/1.0.5/predixy-1.0.5-bin-amd64-linux.tar.gz
cd predixy/

vi predixy.conf
GENERAL模块:Bind 127.0.0.1:7617    			//设置对外暴露的统一接口
SERVERS模块:Include sentinel.conf				//引入哨兵配置文件

vi sentinel.conf

sentinel.conf

SentinelServerPool {
    Databases 16
    Hash crc16
    HashTag "{}"
    Distribution modula
    MasterReadPriority 60
    StaticSlaveReadPriority 50
    DynamicSlaveReadPriority 50
    RefreshInterval 1
    ServerTimeout 1
    ServerFailureLimit 10
    ServerRetryTimeout 1
    KeepAlive 120
    Sentinels {
        + 127.0.0.1:26379								//三个哨兵的 IP+端口
        + 127.0.0.1:26380
        + 127.0.0.1:26381
    }
    Group ooxx {						//一套哨兵可以监控多套主从,一个Group为一套主从。
    }									//Client写入的数据会被打散分别存入ooxx主从的master和xxoo主从的master。
    Group xxoo {
    }
}

配置哨兵

vi 26379.conf 
port 26379
sentinel monitor ooxx 127.0.0.1 36379 2			//第一套主从ooxx的master ID+ Port,组为ooxx
sentinel monitor xxoo 127.0.0.1 46379 2			//第二套主从xxoo的master ID+ Port	组为xxoo

vi  26380.conf
port 26380
sentinel monitor ooxx 127.0.0.1 36379 2
sentinel monitor xxoo 127.0.0.1 46379 2

vi  26381.conf
port 26381
sentinel monitor ooxx 127.0.0.1 36379 2
sentinel monitor xxoo 127.0.0.1 46379 2

#启动哨兵
redis-server 26379.conf --sentinel
 redis-server 26380.conf --sentinel
redis-server 26381.conf --sentinel

# 建立四个个文件夹36379、36380、46379、46380,分别进去启动对应的redis

redis-server --port 36379
redis-server --port 46379

//开启两个从机,追随对应的主机
 redis-server --port 36380 --replicaof 127.0.0.1 36379
 redis-server --port 46380 --replicaof 127.0.0.1 46379

//进入代理predixy的根目录
./predixy ../conf/predixy.conf 

//客户端连接
redis-cli -p 7617

cluster操作演示

#自带配置
cd utils/create-cluster
vim create-cluster
./create-cluster start
./create-cluster create
redis-cli -c -p 3000


./create-cluster satrt				//启动节点
 ./create-cluster create			//创建集群
./create-cluster stop				//停止集群和节点
 ./create-cluster clean				//清理数据文件

# 手工启动的redis实例需要在配置文件中开启 cluster-enabled yes 
redis-cli --cluster create 127.0.0.1:30001 127.0.0.1:30002 127.0.0.1:30003 127.0.0.1:30004 127.0.0.1:30005 127.0.0.1:30006 --cluster-replicas 1

redis-cli --cluster reshard 127.0.0.1:30001

redis-cli --cluster info 127.0.0.1:30001		//随便选一个节点的ip端口

redis-cli --cluster check 127.0.0.1:30001	

总结:

  1. 三种搭建都是分摊redis的内存压力,将数据分到不同的redis
  2. 正常数据会分到不同节点上,不支持事务
  3. 人为干涉将数据分到同一个redis从而支持事务,watch也是一样的道理
  4. {tag}key 可以分发到同一redis支持事务
[springboot专栏]利用redis实现集群多节点应用session共享 因为我们在同一台机器上启动多个实例,ip相同所以session是共享的。如果你在不同的服务器上启动多个实例(IP)不同,你需要在应用前方加上负载均衡逆向代理才可以实现session共享。但cookies是可以跨域共享的,但是不能跨域名(IP)共享。在启动类上方加上注解,启动SpringSession管理应用的session,并设置session数据的有效期30分钟。为了实现验证一个应用的多个实例的session共享,我们启动多个服务实例。做好上文的配置之后,并加入如下的测试代码,后文测试的时候会用到。... 阅读详情

相关推荐

redis的集群(四)

文章目录单机、单节点、单实例redis主从复制redis的高可用redis的分区分区基本概念客户端分区代理分区twemproxypredixy分区的优点分区的缺点预分片持久化数据还是缓存redis的集群Redis集群介绍Redis 集群的数据分片Redis 集群的主从复制模型Redis 一致性保证redis集群搭建槽位移动windows中启动多个redis实例 单机、单节点、单实例 容易引发的问题: 单点故障 容量有限 压力大(如IO压力) 以上三个问题解决方案:独立方案和整合方案 AKF:通过x、y、

fanfanfan的博客 516

【文档熟肉】Redis分区:如何在多个Redis实例之间分割数据

Partitioning: how to split data among multiple Redis instances. 分区:如何在多个Redis节点间分割数据 Partitioning is the process of splitting your data into multiple Redis instances, so that every instance will only contain a subset of your keys. The first part of this do

不想睡觉的橘子君的博客 1080

从零到一:基于JasperGold的FPV实战入门与避坑指南

本文详细介绍了基于JasperGold的形式化验证(FPV)实战入门指南,涵盖环境搭建、SVA断言编写、TCL脚本调试等关键步骤。通过实际案例解析,帮助IC设计工程师掌握FPV技术,有效验证RTL设计中的复杂逻辑和corner case,提升验证效率与质量。

weixin_30899023的博客 360

使用Redis分区将数据分割到多个Redis实例

分区是将所有的数据分割到多个Redis实例的过程,所以每个Redis实例存放的是所有键值的子集。Redis分区主要有两个目标:1)允许使用多台计算机的内存来存放更大的数据。如果不做分区的话,单台计算机的内存又限制。2)使用多台计算的计算能力和网络带宽有许多不同的分区场景,假设有4个Redis实例R0,R1,R2,R3,有很多表示用户的键值比如user:1,user:2,use...

weixin_34162695的博客 442

深入浅出CenterFusion

结合论文和代码理解CenterFusion

Untitled的专栏 5101

新手必看:SMIC 0.18um PDK安装保姆级教程(附Cadence IC617环境配置)

本文提供SMIC 0.18um PDK在Cadence IC617环境下的详细安装教程,涵盖环境准备、文件解压、安装脚本运行、环境变量配置及Cadence集成验证等关键步骤,特别针对初学者常见问题提供解决方案,助力快速掌握芯片设计工具配置。

weixin_30522183的博客 488

predixy cluster.conf参数配置介绍

1:关于MasterReadPriority,DynamicSlaveReadPriority,StaticSlaveReadPriority 如果您的Redis部署意味着使用Sentinel或其他集群节点自动发现节点,那么将使用DynamicSlaveReadPriority选项;如果您计划手动将predixy config中的节点添加到服务器,那么可使用StaticSlaveReadPriority。换句话说,predixy可以发现自动添加的Redis相关节点,还可以将查询路由到这些服务器,从而无需手

雅冰石的专栏 1709

21、使用 FastHenry 进行片上电感器的模拟与参数预测

本文介绍了使用 FastHenry 对片上电感器进行模拟和参数预测的方法。讨论了 FastHenry 的适用场景、线圈几何形状的选择与离散化方法,以及如何考虑模拟中的寄生效应。同时对比了 FastHenry 和 Magnet 在不同基板电阻率下的模拟精度,并提出了优化电感器设计的策略,为高效准确地预测电感参数提供了技术指导。

y9z0a1b的博客 292

超详细 高性能redis集群搭建 —— 第二篇(predixy搭建)

超详细 高性能redis集群搭建之路 —— 第一篇(cluster搭建)

秋丞的博客 3249

如何免费快速的部署一个自用免VIP的自动追剧工具!NAS新玩法!豆瓣与迅雷结合,轻松实现自动下载电影自动追剧功能(支持Windows,群晖nas,飞牛nas,软路由,服务器等Docker快速部署)

追剧党狂喜!豆瓣追剧神器,自动添加云盘,自动下载,微信通知,一键搞定!

XiaoqiangClub的博客 4582

数仓建模—数据治理框架选型

全名主要亮点覆盖面最广:从数据治理、架构、质量、安全到元数据、主数据、数据仓库等等,几乎所有数据管理主题都能在DMBOK里找到相应章节。概念权威统一:帮助组织建立通用术语和知识基础,减少“部门之间说法不一致”的沟通成本。适用场景:如果你所在公司(或团队)正准备系统梳理数据管理的方方面面,DMBOK是一份非常全面的指导手册,尤其适合培养新人或为整个组织统一认知。需要注意:DMBOK偏“知识指引”,不直接提供成熟度模型或实施路线图。想要落地,还需要结合其他评估模型或项目管理方法。小案例举例:某。

2401_84052244的博客 4743

8.Redis- 集群:AKF拆分(y轴和z轴),twemproxy,predixy,cluster

Redis- 集群:AKF拆分,CAP,主从复制,哨兵机制

xi_rurensheng的博客 1514

C#与天文观测:Celestia模拟星空的奇幻之旅

Celestia就像一艘穿梭在星海中的小飞船,带领我们遨游宇宙。C#则是这艘飞船的智能导航系统,用代码指挥它飞向任何我们向往的星球或星系。首先,下载并安装Celestia,熟悉其基本操作和功能。创建一个星空目标列表,包括不同的恒星、行星和星系。// 示例:定义观察目标列表new SpaceObject("太阳"),new SpaceObject("月球"),new SpaceObject("火星")

java专栏 1455

Redis中AKF原则的应用

Redis 单机 、单节点、单实例 缺点:1. 单点故障(一台服务如果挂了,整个系统不可用了) 2. 容量有限 3. 压力 为了解决 单机的 问题 ,引入了AKF 原则 AKF X轴:直接水平复制应用进程来扩展系统(全量,镜像) Y轴 : 将业务、功能拆分出来扩展系统 Z轴:基于用户信息扩展系统(根据 优先级、逻辑拆分) 通过上面的AKF 拆分 一遍多后,带来了数据一致性问题 解决方案: 1. 同步阻塞方式(所有阶段阻塞直到数据全部一致),强一致性 ,但是强一致性 会破坏可用

任意门的博客 2871

堆一呼一吸之间:动态扩缩容引发JVM堆内存震荡的伸缩算法、代际传导与容器定容解析

Kubernetes扩容后,新Java实例的GC频率常比老实例高出数倍,堆容量反复伸缩。本文从一次支付系统的GC陡增出发,结合HotSpot源码与JDK 8实测,拆解堆伸缩的记账规则:期望容量以GC后已用量为基数、以Xms为下限,按空闲比例判断扩缩,收缩只在老年代回收后按0%、10%、40%、100%步进;再剖析年轻代随老年代联动、晋升风暴与元空间触发线,对比Parallel、G1、ZGC等收集器及JDK 26的变化,讨论容器分账、HPA共振与原地扩缩容,最后给出分级定容、预热与监控的方案。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 15万+

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Redis主存复制与集群

Redis单机问题 随着互联网的急速发展,单机的redis已经不足以应对日常的需求,单机的redis主要存在以下问题: 1.单点故障,在单机环境下,一旦redis宕机,那么整个系统将会崩溃。 2. 容量有限,redis是一个内存型数据库,而一台机器的内存是非常有限的,一台机器只能将内存的一部分分配给redis用,故而单机的redis存在容量问题。 3. 访问压力,当访问量急速增加时,单机的redis将会出现瓶颈,无法为所有的用户提供服务。 问题解决方案 对于上述存在的问题,业界一般采用AKF原则来进行解决,

小匠杨的博客 439

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Redis主从复制 AKF

Redis主从复制 文章目录Redis的数据一致性Redis高可用 Redis的数据一致性 单机Redis会带来哪些问题 单点故障问题 容量有限问题 (IO、CPU)压力 利用AKF理论解决上述的问题,分别从XYZ三个轴解决问题。 X轴:是进行全量的复制,相当于镜像的功能,解决了单点故障,并分担了主机压力。 Y轴:安装业务、功能进行区分。解决了容量的问题。 Z轴:按照优先级再拆分。如果按照Y轴redis的容量还不够,那么再进行全量的复制,也就是对业务的redis执行全量的镜像功能。 但是,通过AKF

qq_40223516的博客 392

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Redis 系列--高可用&集群方案

一般我们在使用 Redis 时,鉴于单机存在的单点故障,容量有限,高并发压力问题,都不会采用单机模式,那么该如何设计 Redis 的部署方式来解决诸如单点故障,容量有限,高并发压力这样的问题呢? 首先来看下单点故障的问题,单点故障一般就是指提供服务的节点或实例只有一个,当这个节点出现故障就导致这个服务不可用。解决这种问题一般会引入主备或主从的概念。主备模式就是主机向外提供服务,备机从主机同步数据,只有当主机出现故障时,备机才代替主机向外提供服务。主从模式下,从节点从主节点同步数据,同时也提供部分服务(对于主

phaeton_lai的博客 1560

06.Redis集群分布式模型

本篇文章介绍了redis的主从、主备、主主分布式模型。

起个破名真费劲..的博客 399

Redis(五)redis的高可用理论推导,主从复制,哨兵,cluster,分区,代理,实操twemproxy/Predixy/cluster

redis的高可用理论推导,主从复制,哨兵,cluster,分区,代理,实操twemproxy,Predixy,cluster

书院二层楼 669

P8实战(一):架构概论,从过去到未来

P8架构概论 从过去到未来 缓冲、缓存、复用、分治、亲密性、技术选型 回顾一下软件工程学中的几个重要词汇,整个信息化进程中,做调优离不开这些: buffer 缓冲,包括:消息队列 ;操作系统中的IO方式(积攒一个buffer),解决上下游处理速度不匹配的问题;批量计算;啤酒理论 cache 缓存,包括:pagecache页缓存;缓存热点数据提升io速度;CPU的多级缓存;数据库缓存中间件 缓冲是解决单次大小问题的,缓存是用来复用的 pool 复用,池化,包括:连接池、线程池、对象池、字符串常量池、

寒泉 6万+

redis主从复制实际操作

一、主从复制说明 在实际的场景当中单一节点的redis容易面临风险。 比如: 机器故障。我们部署到一台 Redis 服务器,当发生机器故障时,需要迁移到另外一台服务器并且要保证数据是同步的。而数据是最重要的,如果你不在乎, 基本上也就不会使用 Redis 了。 1.2 什么是主从复制 主从复制,是指将一台Redis服务器的数据,复制到其他的Redis服务器。前者称为主节点(master),后者称...

yshir 194

Redis集群模式与代理模式

Redis集群模式与代理模式 为了解决redis主从复制或者哨兵模式一个实例存储全量的数据,内存空间可能不足的问题,需要对数据进行分区(Partitioning)。 分区的实现方式 客户端分区:例如原来一个商城的所有缓存都存在一个redis,现在按模块进行区分,订单模块放到一个redis,支付模块放到一个redis。 代理分区:客户端将请求发送给代理端,代理根据一致性哈希算法算出key对应在哪个redis实例上,然后将请求发送给对应的redis实例,最后将结果返回给客户端。 查询路由:将请求随机发给一个r

morris 1万+

【读书笔记】【思考总结】《AKF15条架构原则》

N + 1设计 永远不要少于两个,通常为三个。比方说无状态的Web/API一般部署服务器至少>=2个。(高可用) 回滚设计 确保系统可以回滚到以前发布过的任何版本。可以通过发布系统保留历史版本。发布阶段做到可监控、可灰度、可回滚。(高可用) 禁用设计 高可用:能够关闭任何发布的功能。如注册中心节点下线,或者使用动态开关机制(Feature Switch),可以按需一键打开,如发现问题随时关闭禁用。(高可用) 监控设计 高可用:在设计阶段就必须考虑监控,而不是在实施完毕之后补充。例如在需求阶段就要考虑关

在路上的德尔菲的博客 549

微服务拆分原则之 AKF

当我们搭建集群的时候,首先要想明白需要解决哪些问题,搞清楚这个之前,想想单节点、单实例、单机有哪些问题?单点故障容量有限可支持的连接有限(性能不足)......为了解决这些问题,我们需要对服务器进行集群,一变多,具体怎们扩充服务器呢?这儿引入一个概念,微服务设计原则之一——AKF原则微服务拆分原则之AKF首先来看单节点的单点故障这个问题,既然单节点容易挂,那么就可以进行复...

架构文摘 908

java cap_【Java】分布式CAP原则

CAP原则介绍CAP原则又称CAP定理,指的是在一个分布式系统中,一致性(Consistency)、可用性(Availability)、分区容错性(Partition tolerance)。CAP 原则指的是,这三个要素最多只能同时实现两点,不可能三者兼顾。CAP的三个指标一致性(Consistency)“all nodes see the same data at the same time”,...

weixin_29603489的博客 4137
上一篇: Redis再战之AKF、CAP、哨兵机制《七》
下一篇: spark和flink源码编译
漂吧
博客等级 码龄8年 15粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
