爬虫入门(五)——BeautifulSoup4

使用 Python 编写网络爬虫:从入门到实战 网络爬虫是一种自动化程序,通过模拟浏览器的行为向网络服务器发送 HTTP 请求,获取网页内容并进一步提取所需信息的过程。网络爬虫主要用于数据采集、信息监控、搜索引擎等领域,为用户提供更便捷、全面的数据检索服务。发送 HTTP 请求:模拟浏览器向目标网站发送请求,获取网页内容。解析网页内容:使用解析库解析 HTML 或其他标记语言,提取所需信息。处理信息:对提取的信息进行处理、存储或进一步分析。循环操作:根据需求循环执行上述步骤,实现自动化的数据采集和处理。 阅读详情

本文参考Beautiful Soup 4.2.0 文档,仅列举部分内容,详细内容见原文档,链接为:https://www.crummy.com/software/BeautifulSoup/bs4/doc/index.zh.html#id14

1. bs4简介

1.1 基本概念

BeautifulSoup 是⼀个可以从HTML或XML⽂件中提取数据的网页信息提取库(简称bs4),它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式

1.2 源码分析
  • github下载源码
  • 安装:
    pip install lxml(解析器)
    pip install bs4

2.bs4的用法在这里插入图片描述
2.1 bs4的对象种类
  • tag : 标签
  • NavigableString : 可导航的字符串
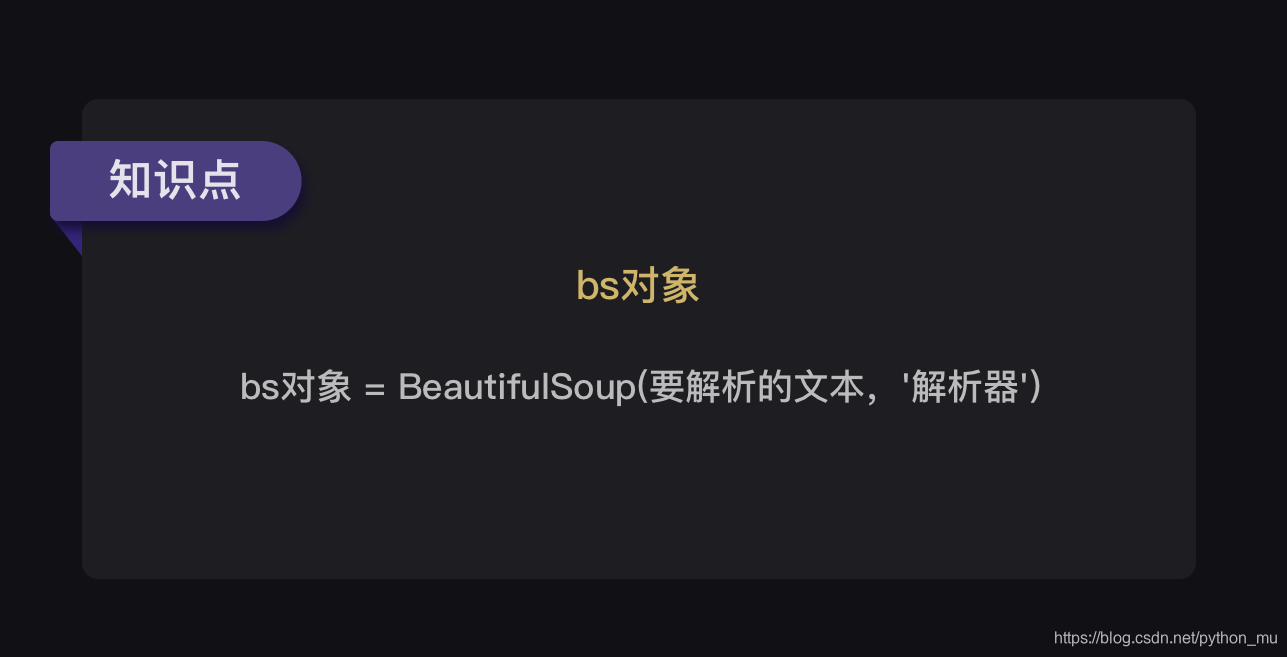
  • BeautifulSoup : bs对象
  • Comment : 注释
2.2 bs4的用法

直接上代码理解:

from bs4 import BeautifulSoup

html_doc = """
<html><head><title>The Dormouse's story</title></head>
<body>
<p class="title"><b>The Dormouse's story</b></p>

<p class="story">Once upon a time there were three little sisters; and their names were
<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,
<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and
<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;
and they lived at the bottom of a well.</p>

<p class="story">...</p>
"""

soup=BeautifulSoup(html_doc,'lxml')
print(soup.prettify())  #美化代码格式,使代码能按照标准的缩进格式的结构输出

print(soup.title)  #获取<title>标签:<title>The Dormouse's story</title>
print(soup.title.name)  #获取标签名称:title
print(soup.title.string)  #获取<title>标签中的文字:The Dormouse's story
print(soup.title.parent)  #获取<title>标签的父标签:<head><title>The Dormouse's story</title></head>
print(soup.title.parent.name)  #获取父标签名称:head

print(soup.p['class'])  #获取<p>标签中class属性值:['title']
print(soup.find_all('p'))  #获取<p>标签的所有内容,返回内容为列表形式

print(soup.a)  # 获取第一个<a>标签 
print(soup.find_all(id="link3")) #获取id="link3"的<a>标签,并返回列表形式:[<a class="sister" href="http://example.com/tillie" id="link3">Tillie</a>]

#找到所有<a>标签的链接
links=soup.find_all('a') #print(type(links)):<class 'bs4.element.ResultSet'>
for link in links:    #print(type(link)):<class 'bs4.element.Tag'>
    print(link['href']) #获取<a>标签中的链接

#获取所有文字内容转化为二进制形式
print(soup.get_text())

3.遍历树

3.1 遍历子节点
  • contents:返回的是⼀个列表
  • children:返回的是⼀个迭代器通过这个迭代器可以进⾏迭代
  • descendants:返回的是⼀个⽣成器遍历⼦⼦孙孙
  • string:获取标签⾥⾯的内容。如果一个tag仅有一个子节点,那么这个tag也可以使用 .string 方法,输出结果与当前唯一子节点的 .string 结果相同。果tag包含了多个子节点,tag就无法确定 .string 方法应该调用哪个子节点的内容
  • strings:返回是⼀个⽣成器对象⽤过来获取多个标签内容
  • stripped_strings:和strings基本⼀致但是它可以把多余的空格去掉

用代码展示:

#contents
head_tag=soup.head
print(head_tag)  #<head><title>The Dormouse's story</title></head>
print(head_tag.contents)  #[<title>The Dormouse's story</title>]
title_tag=head_tag.contents[0]
print(title_tag.contents)  #["The Dormouse's story"]

#children
for child in title_tag.children:
    print(child)  #The Dormouse's story

#descendants
for child in head_tag.descendants:
    print(child)  
    #<title>The Dormouse's story</title>
    #The Dormouse's story

# string
print(title_tag.string)  #The Dormouse's story
print(soup.html.string)  #tag包含多个子节点,无法确定调用哪个,输出结果为None

# strings
for string in soup.strings:
    print(string)
    print(repr(string))  #将字符串以标准形式返回,空格也以"/n"的形式出现
	#"The Dormouse's story"
    # '\n'
    # '\n'
    # "The Dormouse's story"
    # '\n'
    # 'Once upon a time there were three little sisters; and their names were\n'
    # 'Elsie'
    # ',\n'
    # 'Lacie'
    # ' and\n'
    # 'Tillie'
    # ';\nand they lived at the bottom of a well.'
    # '\n'
    # '...'
    # '\n'
    
#stripped_strings
for string in soup.stripped_strings:
    print(repr(string))
    # "The Dormouse's story"
    # "The Dormouse's story"
    # 'Once upon a time there were three little sisters; and their names were'
    # 'Elsie'
    # ','
    # 'Lacie'
    # 'and'
    # 'Tillie'
    # ';\nand they lived at the bottom of a well.'
    # '...'
    
#stripped_strings
for string in soup.stripped_strings:
    print(repr(string))
    # "The Dormouse's story"
    # "The Dormouse's story"
    # 'Once upon a time there were three little sisters; and their names were'
    # 'Elsie'
    # ','
    # 'Lacie'
    # 'and'
    # 'Tillie'
    # ';\nand they lived at the bottom of a well.'
    # '...'
3.2 遍历父节点
  • parent直接获得⽗节点
  • parents获取所有的⽗节点
3.3 遍历兄弟节点
  • next_sibling 下⼀个兄弟结点
  • previous_sibling 上⼀个兄弟结点
  • next_siblings 下⼀个所有兄弟结点
  • previous_siblings上⼀个所有兄弟结点

4. 搜索树

  • 字符串过滤器
  • 正则表达式过滤器
    我们⽤正则表达式⾥⾯compile⽅法编译⼀个正则表达式传给 find 或者findall这个⽅法可以实现⼀个正则表达式的⼀个过滤器的搜索
  • 列表过滤器
  • True过滤器
  • ⽅法过滤器
# 字符串过滤器
a_tag2 = soup.a
# 查找所有<b>标签
b_tag = soup.find_all('b')
print(b_tag)  #[<b>The Dormouse's story</b>]

# 正则表达式过滤器
import re
for tag in soup.find_all(re.compile('t')):
    print(tag.name)  
    #html                 
    #title

# 列表过滤器
print(soup.find_all(['p','a']))  #找到所有的p标签和a标签 
print(soup.find_all(['title','b']))  #[<title>The Dormouse's story</title>, <b>The Dormouse's story</b>]   

# True过滤器
for tag in soup.find_all(True):
    print(tag)  #层层递减,从最外层标签一直返回到最小标签
    print(tag.name)

#方法过滤器
def fn(tag):
    return tag.has_attr('class')
print(soup.find_all(fn)) #得到所有<p>标签

5. find_all() 和 find()

5.1 find_all()
  • find_all()⽅法以列表形式返回所有的搜索到的标签数据
  • find()⽅法返回搜索到的第⼀条数据

find_all()的方法参数:
deffind_all(self,name=None,attrs{},recursive=True,text=None,limit=None, kwargs)
name : tag名称
attr : 标签的属性
recursive : 是否递归搜索
text : ⽂本内容
limli : 限制返回条数
kwargs : 关键字参数

5.2 find_parents()、find_parent()find_next_siblings()、find_next_sibling()
  • find_parents() 搜索所有⽗亲
  • find_parrent() 搜索单个⽗亲
  • find_next_siblings()搜索所有兄弟
  • find_next_sibling()搜索单个兄弟
5.3 find_previous_siblings()、find_previous_sibling()、find_all_next()、find_next()
  • find_previous_siblings() 往上搜索所有兄弟
  • find_previous_sibling() 往上搜索单个兄弟
  • find_all_next()
  • 往下搜索所有元素 find_next()往下查找单个元素

6. 修改文档树

Beautiful Soup的强项是文档树的搜索,但同时也可以方便的修改文档树

  • 修改tag的名称和属性
  • 修改string 属性赋值,就相当于⽤当前的内容替代了原来的内容
  • append()向tag中添加内容,就好像Python的列表的 .append() ⽅法
  • decompose()修改删除段落,对于⼀些没有必要的⽂章段落我们可以给他删除掉
什么是网络爬虫 又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者,是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以根据指定的规则,从互联网上下载网页、图片、视频等内容,并抽取其中的有用信息进行处理。网络爬虫的工作流程包括获取网页源代码、解析网页内容、存储数据等步骤。根据其目的和工作方式的不同,网络爬虫可以分为多种类型。常见的网络爬虫包括通用爬虫、聚焦爬虫、增量式爬虫等。 阅读详情

相关推荐

Python 网络爬虫入门全知道

Python 网络爬虫入门全知道

安年的小小博客有大大的梦想 2742

爬虫bs4

CSS 选择器:BeautifulSoup4 和 lxml 一样,Beautiful Soup 也是一个HTML/XML的解析器,主要的功能也是如何解析和提取 HTML/XML 数据。 lxml 只会局部遍历,而Beautiful Soup 是基于HTML DOM的,会载入整个文档,解析整个DOM树,因此时间和内存开销都会大很多,所以性能要低于lxml。 BeautifulSoup 用来...

weixin_30673611的博客 794

Python 网络爬虫入门与实战

网络爬虫(Web Crawler)是自动访问网络并提取信息的程序。它可以模拟人类用户在浏览器中的行为,访问网页、抓取数据并存储到本地或数据库中。网络爬虫在信息检索、数据挖掘、搜索引擎等领域有广泛应用。Scrapy 是一个强大的爬虫框架,支持异步处理和数据存储。它适合大型爬虫项目,可以高效抓取和解析数据。yield item通过本文的学习,您应该对 Python 网络爬虫有了全面的了解。从基础的 Requests 库到高级的 Scrapy 框架,再到实战案例,涵盖了网络爬虫的方方面面。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 2214

Beautifulsoup4解析网页入门

举例说明用bs4提取出某个网页特定某个信息常用形式。 学习资料:Beautifulsuop4文档 举例:解析网页的内容,提取出这个网页标题。 如果这个标签只出现一次,直接通过find_all() print('title:',soup.find_all('h2')[0].string) 通过find_all()方法的attrs参数定义一个字典参数来搜索包含特殊属性的

笔记 1664

Python网络爬虫入门指南

很高兴看到你对网络爬虫和Python的介绍。网络爬虫的确是一个强大且有趣的技术,而Python作为一种简单易学且功能丰富的编程语言,非常适合用于编写网络爬虫。   在本文中,我们将深入探讨Python网络爬虫的基本原理,介绍常用的工具和库,以及通过实战案例来帮助读者入门这个领域。我们将重点介绍如何发送HTTP请求、解析HTML页面、提取所需信息等基本技术,同时也会涉及一些高级的爬虫技术和注意事项。

不迁怒,不贰过。小知识,大智慧。 1999

Python:Beautifulsoup4库的使用

使用requests库获取HTML页面并将其转换成字符串后,需要进一步解析HTML页面格式,提取有用信息,这需要处理HTML和XML的函数库。beautifulsoup4库,也称为Beautiful Soup库或bs4库,用于解析和处理HTML和XML。需要注意的是,它不是BeautifulSoup库。它的最大优点是能根据HTML和XML语法建立解析树,进而高效解析其中的内容。

衍生星球的博客 5621

python爬虫入门(五)------beautifulsoup4库实例

爬取股票信息并保存到自己电脑上 import requests from bs4 import BeautifulSoup import re def getHTMLText(url, code='utf-8'): try: r = requests.get(url, timeout=30) r.raise_for_status() r.encoding = code return r.text except:

qq_43556844的博客 455

[Python从零到壹] 五.网络爬虫之BeautifulSoup基础语法万字详解

欢迎大家来到“Python从零到壹”,在这里我将分享约200篇Python系列文章,带大家一起去学习和玩耍,看看Python这个有趣的世界。所有文章都将结合案例、代码和作者的经验讲解,真心想把自己近十年的编程经验分享给大家,希望对您有所帮助,文章中不足之处也请海涵。Python系列整体框架包括基础语法10篇、网络爬虫30篇、可视化分析10篇、机器学习20篇、大数据分析20篇、图像识别30篇、人工智能40篇、Python安全20篇、其他技巧10篇。您的关注、点赞和转发就是对秀璋最大的支持,知识无价人有情,希望

杨秀璋的专栏 1万+

Python 网络爬虫入门详解

什么是网络爬虫          网络爬虫又称网络蜘蛛,是指按照某种规则在网络上爬取所需内容的脚本程序。众所周知,每个网页通常包含其他网页的入口,网络爬虫则通过一个网址依次进入其他网址获取所需内容。 优先申明:我们使用的python编译环境为PyCharm   一、首先一个网络爬虫的组成结构: 爬虫调度程序(程序的入口,用于启动整个程序) url管理器(用于管理未爬取得url及已经爬...

Seven丶Echo的博客 11万+

STM32CubeIDE离线安装芯片PACK包全攻略(附离线包下载与导入步骤)

本文详细介绍了在STM32CubeIDE中离线安装芯片PACK包的完整流程,包括官方和第三方资源获取方法、本地安装步骤及常见问题解决方案。特别针对网络隔离环境下的嵌入式开发需求,提供了实用的版本管理和自动化部署技巧,帮助开发者高效完成芯片固件支持包的离线配置。

weixin_30825581的博客 300

PID控制参数整定(调节方法)原理+图示+MATLAB调试

序 首先最重要的是了解每个参数调节了系统响应的那些属性,通过观察响应从而调节参数改变属性。 PID的作用概述: 1、P产生响应速度和力度,过小响应慢,过大会产生振荡,是I和D的基础。 2、I在有系统误差和外力作用时消除偏差、提高精度,同时也会增加响应速度,产生过冲,过大会产生振荡。 3、D抑制过冲和振荡,过小系统会过冲,过大会减慢响应速度。D的另外一个作用是抵抗外界的突发干扰,阻止系统的突变。 同时调节的顺序是:P>I>D 下面了解的一个很重要的就是调节的目标,也就是最好的响应曲线.

viafcccy的博客 16万+

网络爬虫是什么?怎么学python爬虫

网络爬虫又称网络蜘蛛、网络机器人,它是一种按照一定的规则自动浏览、检索网页信息的程序或者脚本。网络爬虫能够自动请求网页,并将所需要的数据抓取下来。通过对抓取的数据进行处理,从而提取出有价值的信息。

Itmastergo的博客 3万+

vuecil3+版本下,兼容ie等不支持es6的低版本浏览器

*综上,完成兼容性涉及到的配置的文件有,对应在页面中查看代码,就不单独附代码了:main.js。

yhr0322的博客 833

从入门到精通:网络爬虫开发实战总结

学习是一种持续不断的过程,无论在什么领域,都需要不断地努力和探索。在这段爬虫学习历程中,我不仅获得了丰富的知识和技能,也结交了很多志同道合的朋友和粉丝,他们对我的学习和进步都提供了极大的支持和鼓励,支持我继续写下去。 总的来说,这段时间的学习和写作让我认识到了自己的不足和缺陷,也让我更加坚定了继续学习和进步的决心。我相信,在未来的学习和工作中,这段经历将成为我前行的动力和支撑。在这里,我将过去写过的爬虫文章总结一下,不仅是在爬虫学习这里留下一个里程碑,也是为了能够总结一下阶段性学习成果。

weixin_50804299的博客 6560

保姆级教程:用OpenCV搞定鱼眼双目相机的标定与测距(附完整C++代码)

本文详细介绍了使用OpenCV进行鱼眼双目相机标定与测距的全流程,包括环境搭建、数据采集、单目标定、双目标定、立体校正和视差计算等核心步骤。通过完整的C++代码示例和参数调优指南,帮助开发者快速实现高精度的双目测距系统,适用于机器人导航、VR全景拍摄等领域。

weixin_42573113的博客 388

音乐生成 - 使用LSTM或Transformer模型进行音乐生成,如MIDI音乐生成。

在本篇博客中,我们将介绍如何使用LSTM和Transformer模型生成MIDI音乐。我们将首先概述音乐生成的一般流程,然后深入了解LSTM和Transformer模型的特点和实现。最后,我们将通过Python代码演示如何使用这两种模型生成MIDI音乐。

斌擎科技 1720

『哈士奇赠书33期』- 『Python网络爬虫入门到实战』

『哈士奇赠书33期』- 『Python网络爬虫入门到实战』

易编橙 · 终身成长社群,相遇已是上上签! 1万+

【Oracle】Oracle rman工具使用(真的细)

Oracle RMAN(Recovery Manager)是Oracle数据库备份和恢复的官方工具,它提供的备份和恢复功能非常强大和可靠。RMAN可以备份整个数据库或特定表空间、数据文件、控制文件和归档日志,同时还可以进行增量备份和增量恢复。RMAN还提供了诸如备份验证、备份优化、备份复制、备份集管理、恢复操作、自动备份、自动恢复等高级功能。它使用的备份和恢复格式是Oracle通用的备份集(Backup Set),这使得备份和恢复非常灵活和高效。

tttzzzqqq2018的博客 8502

从入门到实战:Python网络爬虫指南

网络爬虫(Web Crawler)是一种自动获取互联网信息的程序,它通过访问网页、提取数据并保存数据的方式来实现信息的获取。网络爬虫可用于从网站中收集数据、监视网站的变化、搜索引擎索引等多种应用。在本文中,我们介绍了Python网络爬虫的基础知识,包括网络爬虫的概念、Python在网络爬虫中的应用以及如何构建简单的网络爬虫。通过学习如何编写网络爬虫,您可以更好地利用互联网上的数据资源,加快信息收集的效率。

努力是为了站在万人之中,成为别人的光 8824

DAB协议解读ETSI TS 103 461

数字信号广播( Digital Audio Broadcasting 简称DAB)是继AM、FM传统模拟广播之后的第三代广播--数字信号广播,它提供了接近CD质量的声音,广播及商机无限的附加数据服务,具有抗噪声、抗干扰、抗电波传播衰落、适合高速移动接收等优点,保证固定、携带及移动时接收信号的质量。DAB的原始版本使用MP2音频编解码器。该系统的升级版本于2007年2月发布,称为DAB+,它使用基于改进的离散余弦变换(MDCT)的HE-AACv2(AAC+)音频编解码器。

qflook的博客 4477

华为OD机试 - 学校的位置 - 数学问题(Python/JS/C/C++ 2024 B卷 100分)

华为OD机试 2024E卷题库疯狂收录中,刷题。

学Java,找哪吒 455

【好书推荐3】Python网络爬虫入门到实战

本书介绍了Python3网络爬虫的常见技术。首先介绍了网页的基础知识,然后介绍了urllib、Requests请求库以及XPath、Beautiful Soup等解析库,接着介绍了selenium对动态网站的爬取和Scrapy爬虫框架,最后介绍了Linux基础,便于读者自主部署编写好的爬虫脚本。本书所有代码和相关素材可以到GitHub下载获取,地址为https://github.com/sfvsfv/Crawer。本书主要面向对网络爬虫感兴趣的初学者。杨涵文。

定期分享我的发现和想法,感谢你的陪伴和支持 7919

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

零基础爬虫入门(一) | 初识网络爬虫

本篇博文主要介绍网络爬虫的基本概念、工作原理以及开发环境。 我们为什么要了解网络爬虫? 因为当今从事科学研究等,需要大量的数据,但是这些数据公开的又非常的少,大量的数据都在大公司的手中。我们这些普通人本身并没有那么多数据,但是我们又需要大量的数据。那么,这时我们就需要用到网络爬虫了。 Chapter01 | 初识网络爬虫一、什么是网络爬虫1、爬虫产生的背景1.1、万维网的高速发展1.2、搜索引...

不温卜火 6722

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

网络爬虫解析

网络爬虫(也称为网页蜘蛛、网络机器人)是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以用于从网站提取数据,例如监测社交媒体平台上的活动,或者从网上收集新闻和文章。它们也可以用于搜索引擎,如Google和Bing,来抓取和索引网页,以便在用户进行搜索时提供结果。URL通常由多个部分组成,包括协议类型(如HTTP、HTTPS)、主机名(域名或IP地址)、路径(资源在主机上的位置)以及可选的查询参数(用于传递额外的信息)。通过URL,用户可以方便地访问和定位到特定的网络资源。

2301_82032652的博客 2634

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

上一篇: Xpath爬取豆瓣top250电影
下一篇: 三分钟了解js2py模块
北木x
博客等级 码龄7年 6粉丝 13原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值