《Python机器学习基础教程》第二章笔记:用于多分类的线性模型-三分类数据集

c调python类_《Python机器学习基础教程 》笔记-第2章 Github链接:《第2章》分类与回归分类是预测标签,包括二分类与多分类。回归是预测连续值,比如预测收入、房价。泛化、过拟合与欠拟合随着模型算法逐渐复杂,其在训练集上的预测精度将提高,但在测试集上的预测精度将降低,因此模型的复杂度需要折衷。模型过于复杂,将导致模型泛化能力差,即过拟合。 模型过于简单,将导致模型精度在训练集表现就很差,更不用说测试集的表现了,此时即欠拟合。模型复杂度与数据集大小的关... 阅读详情

《Python机器学习基础教程》第二章笔记:用于多分类的线性模型-三分类数据集

一、疑问

第一个数据集的可视化:

from sklearn.linear_model import LogisticRegression
from sklearn.svm import LinearSVC
import mglearn
from matplotlib import pyplot as plt
from sklearn.model_selection import train_test_split

X, y = mglearn.datasets.make_forge()
print(y)

fig, axes = plt.subplots(1, 2, figsize=(10, 3))

for model, ax in zip([LinearSVC(), LogisticRegression()], axes):
clf = model.fit(X, y)

mglearn.plots.plot_2d_separator(clf, X, fill=False, eps=0.5,
                                ax=ax, alpha=.7)#画线的命令
mglearn.discrete_scatter(X[:, 0], X[:, 1], y, ax=ax)#画点的命令
ax.set_title(clf.__class__.__name__)
ax.set_xlabel("Feature 0")
ax.set_ylabel("Feature 1")
axes[0].legend()
plt.show()	

其实就是45页的图2-15的Logistic回归
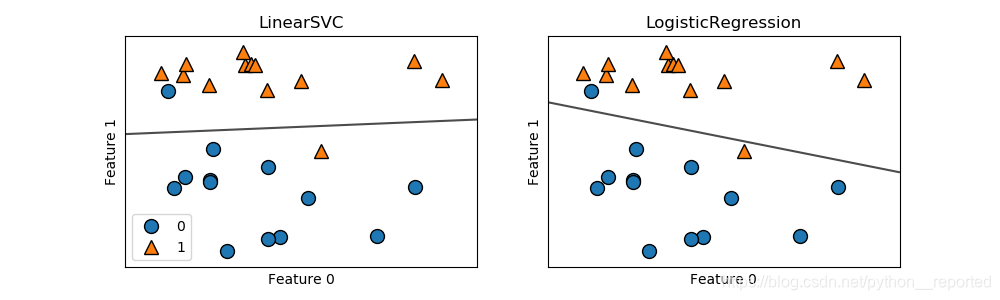
在这里插入图片描述

第二个数据集的可视化:

from sklearn.datasets import make_blobs
import mglearn
from matplotlib import pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.svm import LinearSVC


X, y = make_blobs(random_state=42)#random_state=42报持随机一致

mglearn.discrete_scatter(X[:, 0], X[:, 1], y)
#plt.scatter(X[:, 0], X[:, 1], y)#这也是两个数据集
plt.xlabel("Feature 0")
plt.ylabel("Feature 1")
plt.legend(["Class 0", "Class 1", "Class 2"])
plt.show()

就是50页图2-19:
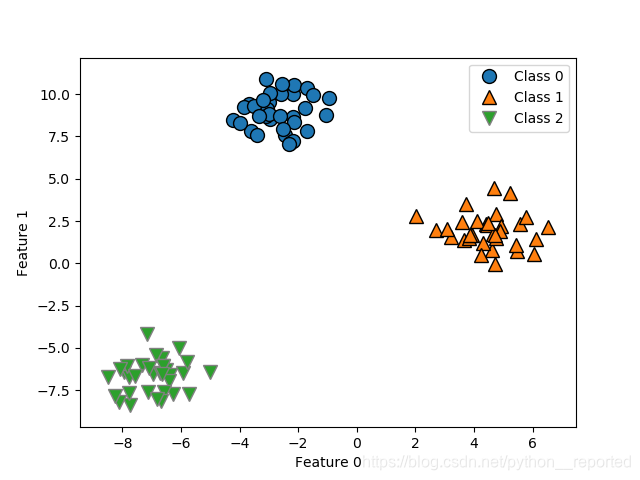
在这里插入图片描述

问题:

都是:mglearn.discrete_scatter(X[:, 0], X[:, 1], y)

问什么一个是两类一个是三类

为此还专门对第二个数据集利用matplotlib进行可视化,发现确实是两个数据,
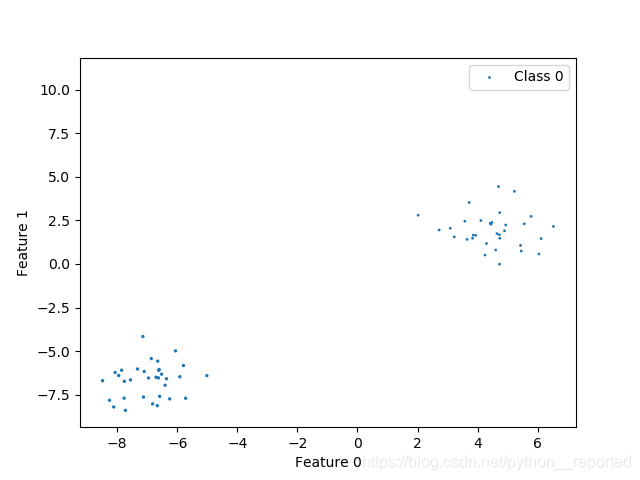
在这里插入图片描述

应该一样啊!为什么第二个数据集会有三类

二、理解

命令行中X为二维数据集因而[:, 0]第一列# 输入X第0列和第1列作为x轴,将y作为y轴,纯数据上来说是应该与matplotlib进行可视化一样只有两类,

但是mglearn绘图并不是xy绘图,即y不是x的值,y就是类别本身

第一个数据集只有两类是因为y值只有0、1
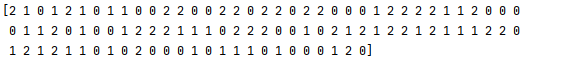
例如第一个数据集的y
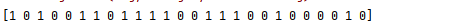
在这里插入图片描述

第二个数据集的y
在这里插入图片描述

这个0、1、2就像鸢尾花数据集中的[‘target’]一样只是一个类别代数

Python机器学习基础篇二《监督学习》 前言 前期回顾: Python机器学习基础篇一《为什么用Python进行机器学习》 前面说过,监督学习是最常用也是最成功的机器学习类型之一。本章将会详细介绍监督学 习,并解释几种常用的监督学习算法。我们在第 1 章已经见过一个监督学习的应用:利用 物理测量数据将鸢尾花分成几个品种。 记住,每当想要根据给定输入预测某个结果,并且还有输入 / 输出对的示例时,都应该使 用监督学习。这些输入 / 输出对构成了训练集,我们利用它来构建机器学习模型。我们的 目标是对从未见过的新数据做出准确预测。监督学习通常需要人力来 阅读详情

相关推荐

sklearn数据集——iris鸢尾花数据集_iris数据集

通过上面的描述信息,我们可以知道该数据集包含150条数据,每50条数据属于一个类别,即有三个类别,每一条数据有四个特征。target_names 键对应的值是一个字符串数组,里面包含我们要预测的花的品种: 输出: 由此,我们可以知道鸢尾花数据集iris包含3类鸢尾花,分别为山鸢尾(Iris-setosa)、杂色鸢尾(Iris-versicolor)和维吉尼亚鸢尾(Iris-virginica)feature_names 键对应的值是一个字符串列表,对每一个特征进行了说明: 输出: 由此,我们可以知道每条数据

2401_84010362的博客 1308

Python机器学习基础教程6

Python机器学习基础教程6

weixin_56368033的博客 1940

python机器学习小记——基于逻辑回归模型的多分类场景预测实战

【阿里天池云-龙珠计划】python机器学习小记 <task01: 基于sklearn的Logistic Regression分类实现> 目录【阿里天池云-龙珠计划】python机器学习小记一、逻辑回归算法原理及应用介绍 二、入门Demo 三、基于鸢尾花(iris)数据集的逻辑回归分类实践 那么我们开始吧~~ 1. 逻辑回归算法原理及应用介绍 1.1. 逻辑回归的介绍 逻辑回归(Logistic regression,简称LR)是一个分类模型,并且广泛应用于各个领域之中。 其最为突出的两点

Cedric_Chen_的博客 3117

利用mglearn绘图报错:TypeError: ‘(slice(None, None, None), 0)‘ is an invalid key

想利用mglearn可视化有俩个特征的数据时,出现了如上的报错。 data = pd.read_csv('ex2data1.txt', names=['score1', 'score2', 'Admission']) m, n = data.shape x = data[['score1', 'score2']] y = data[['Admission']] mglearn.discrete_scatter(x[:, 0], x[:, 1], y) plt.show() 这是因为没有将数据转化为

weixin_46088823的博客 7525

鸢尾花数据集的线性多分类实验

目录一 一

CHL的博客 3830

Python 机器学习 线性回归算法

线性回归是一种预测数值型数据的监督学习算法。线性回归是统计学和机器学习中最基础且广泛应用的预测模型之一。实现在建立自变量(X)和因变量(Y)之间的线性关系。在 Python 的机器学习库 scikit-learn 中,可以方便地使用线性回归模型进行数据分析和预测。

weixin_42098295的博客 1792

多分类svm代码python_python机器学习:用于多分类的线性模型

许多线性分类模型只适用于二分类,不能轻易推广到多类别问题(除了logisitic回归)。将二分类算法推广到多分类算法的一种常见的方法是“一对其余”。在“一对其余”中对每个类别都学习一个二分类模型,将这个类别与所有其他类别尽量分开,这样就生成了类别个数一样多多的二分类。在测试点上运行所有二分类器来进行预测,在对应类别上分数最高的分类器“胜出”,将这个类别标签返回作为预测结果。每个类别都对应一个二分类...

weixin_32679187的博客 2721

机器学习笔记九——线性模型原理以及python实现案例

线性模型1、线性模型概述2 广义线性模型3、经典的线性模型3.1 线性回归3.1.1 单变量线性回归3.1.2 多变量线性回归 1、线性模型概述 给定一个由d个属性描述的实例x=(x1;x2;...;xd)x=(x_1;x_2;...;x_d)x=(x1​;x2​;...;xd​) ,其中xix_ixi​是 ​ 是x在第i个属性上的取值,线性模型(linear model) 的原理是试图学得一个通过属性的线性组合来进行预测的函数,即 f(x)=ω1x1+ω2x2+...+ωdxd+df(x)=\omega_

weixin_45666566的博客 4662

Python机器学习基础教程

Python机器学习基础教程1. 引言1.1 机器学习能够解决的问题1.3 scikit-learn1.4 必要的库和工具1.4.3 Scipy1.4.4 matplotlib1.4.6 mglearn1.7 第一个应用:鸢尾花分类1.7.1 初识数据1.7.2 衡量模型是否成功:训练数据与测试数据1.7.3 要事第一:观察数据1.7.4 构建第一个模型:k近邻算法1.7.5 做出预测1.7.6 评估模型2. 监督学习 1. 引言 监督学习(supervised learning)的方法中,用户将成对的输入

adamlay的博客 8769

机器学习Python实现之线性模型

本文将详细解释线性分类的几个常用模型:线性回归、对数回归、对数几率回归,并简要介绍其优化方法。文末附有Python代码实现。如果问题,欢迎留言交流~线性回归(linear regression)模型设样本表示为dd维列向量xx,其标记为yy,记x̂ =(x1)\hat{x}=\left( \begin{matrix} x\\ 1 \end{matrix} \right),线性回归的基本模型:

冷江 5509

YOLO车辆检测三类别数据集 car-detect-dataset-1793.zip

YOLO车辆检测三类别数据集,车辆数据集,用于车辆检测, 标签类型为VOC格式和YOLO格式两种,类别名为car、bus、truck三类,每张图包含多个类别,图片中目标清晰,数量为1793张

机器学习 线性回归模型(Python实现)

本文介绍机器学习中的线性模型的基本形式和求解线性回归方程方法 设问题为:判断一个同学对机器学习算法的掌握程度 有以下观点:1.数学基础 2.高级语言掌握程度 ...

BTboay 1万+

3分钟搞定!QQ音乐歌单导出Excel保姆级教程(含歌单ID获取技巧)

本文提供了一份详细的QQ音乐歌单导出Excel保姆级教程,帮助用户轻松备份和管理个人音乐收藏。教程核心在于获取歌单ID,并利用浏览器开发者工具执行脚本提取数据,最后通过Excel导入功能快速生成结构化表格。整个过程无需编程基础,3分钟即可搞定,是个人数据管理的实用技巧。

weixin_29008691的博客 1412

Python机器学习实践(三)监督学习篇2(线性模型--分类)

Python机器学习 学习笔记与实践 环境:win10 + Anaconda Python3.8 该篇总结各类监督学习算法的实践使用方法 1、二分类 线性模型也广泛应用于分类问题。我们首先来看二分类。这时可以利用下面的公式进行预测: ŷ = w[0] * x[0] + w[1] * x[1] + …+ w[p] * x[p] + b > 0 如果函数值小于 0,我们就预测类别 -1;如果函数值大于 0,我们就预测类别 +1。对于所有用于分类的线性模型,这个预测规则都是通用的。 最常见的两种线性分类算

AiTingDeTong的博客 2022

机械臂速成小指南(八):标准DH法实战——从连杆坐标系到运动学方程

本文详细介绍了机械臂运动学建模中的标准DH法,从连杆坐标系的建立到运动学方程的求解,提供了实用的操作步骤和代码示例。通过DH参数表和变换矩阵的构建,帮助读者快速掌握机械臂运动学建模的核心技术,并解决实际应用中的常见问题。

oo7890的博客 211

详解在linux上安装vpn客户端

详解在linux上安装vpn客户端

FuncPlotCalc 8433

线性模型,python实现

参考用书:python机器学习基础教程 [德]Andreas C.Muller [美]Sarah Guido 著 张亮 译 线性模型利用输入特征的线性函数(linear function)进行预测。 普通最小二乘法(ordinary least squares,OLS),是回归问题最简单也最经典的线性方法。线性回归寻找参数 w 和 b,使得对训练集的预测值与真...

qq_39119949的博客 2246

如何使用Google Maps API爬取地理数据:详细教程与Python实现

Google Maps API 是一组服务的集合,允许开发者访问地图、地点、路线等地理信息。:将地址转换为地理坐标,或将地理坐标转换为地址。:计算两点之间的行车路线、步行路线等。Places API:获取附近的地点、商店、餐馆等。:计算多个地点之间的距离和时间。在接下来的代码中,我们将结合这些 API,展示如何获取并处理地理数据。本文详细介绍了如何使用 Google Maps API 获取地理数据,涵盖了从地址转经纬度、获取地点详情、计算路线、计算多个地点的距离与时间等多个功能。

2201_76125261的博客 733

【Python机器学习】线性模型——用于多分类的线性模型

很多线性分类模型只使用与二分类问题,将二分类算法推广到多分类算法的一种常见方法是“一对其余”方法。在“一对其余”方法中,对每个类别都学习一个二分类模型,将这个类别和其他类别尽量区分,这样就生成了与类别数相同的二分类模型数。在测试点上运行所有分类器进行预测,在对应类别上分数最高的分类器“胜出”,将这个类别标签范围作为预测结果。

weixin_39407597的博客 942

攻克反光难题!YOLOv9工业缺陷检测实战:高反光件、微小划痕精准识别(附抗反光代码+产线数据)

文章摘要:本文针对不锈钢、铝合金等高反光工业件的缺陷检测难题,提出了一套“硬件抗反光+YOLOv9小目标增强”的解决方案。通过分析反光干扰(镜面/漫反射)和微小划痕(0.1mm级)两大核心问题,详细介绍了500万像素工业相机+偏振光源的硬件配置方案,以及基于偏振图像融合和超分辨率放大的预处理方法。最终实现误检率1.2%、微小划痕检出率99.3%的工业级检测效果,并提供了可落地的代码实现和车间实测数据。(148字)

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1043

量子编程专业权威教程(十四):Shor 算法

本文系统阐述了Shor算法的原理与实现,重点解析了将大数分解问题转化为周期寻找问题的数论基础,以及模幂运算量子电路的设计方法。通过以N=15为例的完整算法流程演示,展示了量子计算在因数分解问题上的指数级优势。文章详细拆解了受控幺正操作构建、量子傅里叶变换应用等关键技术环节,并提供了可复现的Qiskit代码实现。同时指出了当前量子硬件在比特数、相干时间和错误率等方面面临的工程挑战,这些限制使得分解大整数仍需长期技术突破。该研究为理解量子计算优势提供了典型范例,对后量子密码学发展具有重要启示意义。

分享知识,拥抱变化 800

机器学习入门实践--线性模型-多分类问题(python)

本文不涉及细节理论,只做必要性的介绍,侧重代码实现。 线性模型-多分类问题的理论分析 只有二分类是完全不够用的,因此需要其他的算法来解决多分类问题。 例如识别数字0-9有10种情况。 多分类问题模型是从二分类延申出来的。类比二分类即可学习。 1.确定拟合函数h(x) 从单样本开始 对于一组样本{x,y=j}j∈[1,k]来说。对于x的预测结果可能有多个,如何确定最终的结果呢?判断概率P(y=j∣θ,x),那个概率更大,就预测那个值用hθ(x)表示就是:预测结果hθ(x)={P(y=1∣θ,x)P(y=2∣θ

永远鲜红の幼月的博客 3628

多物理场光学仿真软件:Lumerical_(15).多物理场耦合仿真案例分析

在多物理场光学仿真中,Lumerical 软件提供了强大的工具来模拟复杂的光学系统,包括光子学、热学、力学和电学等多物理场的耦合。本节将通过具体的案例分析,展示如何在 Lumerical 中进行多物理场耦合仿真的开发和实现。我们将从简单的热光效应仿真入手,逐步深入到更复杂的多物理场耦合场景,如光电效应和光力学效应。每个案例都将包括详细的原理说明和具体的代码示例,帮助读者更好地理解和应用这些技术。

kkchenjj的博客 1023

机器学习(超详细讲解):利用Logistic Regression(逻辑回归)实现多分类

机器学习:利用Logistic Regression(逻辑回归)实现多分类 文章目录机器学习:利用Logistic Regression(逻辑回归)实现多分类1.Logistic Regression的引入2.损失函数3.梯度下降法4.参数更新5 多分类器介绍5.1 一对一分类器(OvO)5.1 一对其余分类器(OvR)6 Python实战(Iris数据集准确率93%)6.1 读取数据集(划分训练集和测试集)6.2 二分类任务6.3 采用OVO方式训练多分类器6.4 测试模型准确率7.完整代码 本文章利用逻

qq_44350242的博客 1万+

060、模型蒸馏:把扩散模型压进单步的魔法

《端侧文生图模型蒸馏实战:从32步到1步的优化之道》摘要:针对边缘设备部署难题,本文分享了扩散模型蒸馏的核心经验。通过重构损失函数(感知损失+对抗训练+KL散度)、优化采样轨迹截取策略和改造学生模型架构,成功将Stable Diffusion压缩至单步推理。关键发现包括:小批量训练更有效、标签平滑保障生成多样性、双模型策略平衡质量与速度。在Cortex-A53芯片上实现300ms内生成,内存占用控制在200MB以下。特别强调工业部署需权衡压缩率与稳定性,建议保留迭代模式开关以适配不同场景需求。

2601_95651806的博客 150

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Python机器学习日记6:线性模型(用于分类的线性模型)

用于分类的线性模型 线性模型也广泛应用于分类问题。 1. 二分类 二分类可以利用下面的公式进行预测: ŷ = w[0] * x[0] + w[1] * x[1] + … + w[p] * x[p] + b > 0 这个公式看起来与线性回归的公式非常相似,但我们没有返回特征的加权求和,而是为预测设置了阈值(0)。如果函数值小于 0,我们就预测类别 -1;如果函数值大于 0,我们就预测类别 +1。对于所有用于分类的线性模型,这个预测规则都是通用的。同样,有很多种不同的方法来找出系数(w)和截距(b)。

大家好,欢迎来到鱼尾的博客! 1942

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

上一篇: 《Python机器学习基础教程》第二章笔记:random_state的作用
下一篇: 《Python机器学习基础教程》第二章笔记:ValueError: cannot reshape array of size 4000000 into shape (1000,1000)
python__reported
博客等级 码龄7年 249粉丝 141原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值