


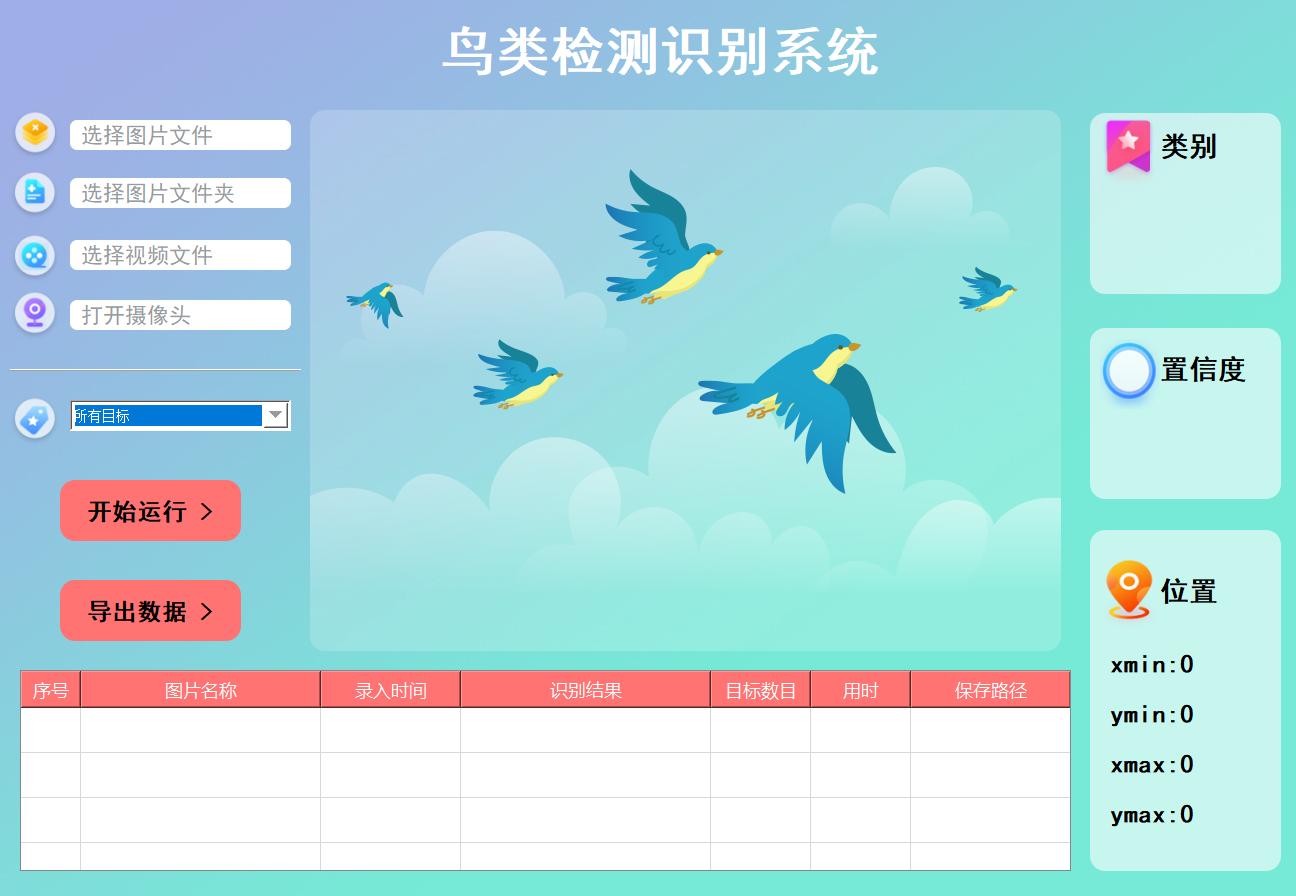

摘要:鸟类检测识别系统在相关领域中起着至关重要的作用,不仅能有效提升检测效率,还为自动化识别提供了可靠的数据支撑。本文介绍了一款基于YOLOv8、YOLOv5等深度学习框架的目标检测模型,该模型使用了大量图片进行训练,能够准确识别多种目标。系统可在不同场景下进行检测,包括多目标场景、复杂背景、光线变化等。
此外,我们开发了一款带有UI界面的检测系统,支持实时检测不同种类的目标,并通过图形界面直观展示检测结果。系统基于Python与PyQt5开发,能够处理图片、视频及摄像头输入,检测结果可以保存以供后续分析。本文还提供了完整的Python代码及详细的使用指南,供有兴趣的读者参考,完整代码资源请见文章末尾。
项目介绍
项目中所用到的算法模型和数据集等信息如下:
算法模型:
- yolo26、yolo26 + SE注意力机制
- yolo11、yolo11 + SE注意力机制
- yolo12、yolo12 + SE注意力机制
- yolov8、yolov8 + SE注意力机制
- yolov5、yolov5 + SE注意力机制
- 算法还在持续更新中。。。。不同算法的界面是不一样的,不用担心重复问题。
目前有上面这些不同的算法模型、每个算法有两个训练好的模型。模型十分重要,因为有些同学的电脑没有 GPU,无法自行训练。
数据集:
网上下载的数据集,格式都已转好,可直接使用。
界面:
PyQt5
以上是本篇博客的简单说明,添加注意力机制可作为模型的创新点 。
前言
鸟类检测识别系统在相关领域中发挥着至关重要的作用。在实际应用中,快速且精准地识别不同种类的目标,能够有效提高工作效率,减少人力成本,尤其是在自动化监测系统中,准确识别目标是各项应用的基础。同时,检测系统还为相关人员提供了重要的实时数据反馈,帮助他们及时掌握运行状态的变化情况,推动相关工作的科学化和高效化。
目标检测技术已在多个领域得到了广泛应用,如工业检测、智能监控、科学研究、自动识别等场景中,都依赖于高效准确的检测技术。通过自动化的识别系统,相关机构可以在实际应用过程中实时识别目标的种类和数量,并根据识别到的数据做出相应的决策,从而提高工作效率。
在现代管理环境中,检测系统还可以与其他智能化管理系统结合使用,如环境监测、智能调度和预警系统,形成一个完整的智能管理体系,帮助相关人员更高效地掌握动态。在特殊环境或复杂的场景中,系统能够快速识别不同类型的目标,为相关人员提供更为精准的数据。
本文通过收集与检测相关的数据和图像,利用YOLOv8、YOLOv5等目标检测技术,结合Python与PyQt5,开发出了一款界面简洁的检测系统。该系统支持图片、视频及摄像头检测,并能够保存识别结果,为用户提供直观便捷的检测体验。
目录
功能展示:
部分核心功能如下:
- 功能1: 支持单张图片识别
- 功能2: 支持遍历文件夹识别
- 功能3: 支持识别视频文件
- 功能4: 支持摄像头识别
- 功能5: 支持结果文件导出(xls格式)
- 功能6: 支持切换检测到的目标查看
更多的其他功能可以通过下方视频演示查看。视频中详细讲解了环境安装、模型训练、模型评估、项目结构说明以及常见问题答疑,跟着视频操作即可顺利完成部署。
04-基于YOLO12的鸟类检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络
04-基于深度学习的鸟类检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)
04-基于深度学习的鸟类检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)
04-基于深度学习的鸟类检测识别系统(yolov5)(附赠任务书、开题报告模板课程)
🌟 一、数据集介绍
本项目使用的数据集已按照 YOLO 标准格式整理完毕,包含 train、val、test 三个子目录,标注文件为 YOLO 标准的 .txt 格式,每行包含 class x_center y_center width height,可以直接用于训练和评估,无需额外转换步骤。数据集的类别信息在 traindata.yaml 中定义。
🌟 二、深度学习算法介绍
本系统集成了多个不同的算法版本和界面版本,以下是对这些版本的概述:
算法版本方面,系统提供了多种深度学习算法和传统图像处理技术,用户可以选择最合适的算法进行任务处理。此外,各算法版本经过严格的测试和优化,以提供更高的准确率和效率。
在界面版本方面,系统设计了多种用户界面风格,可以选择简约、直观的界面,快速上手进行操作;也可以选择功能丰富的专业界面,满足复杂任务的需求。界面设计注重用户体验,确保用户在操作过程中能够方便地访问各种功能。
此外,系统还支持实时更新和扩展,可以根随时添加新的算法模块或界面选项。这种灵活性不仅提高了系统的适用性,也为未来的技术发展预留了空间。
总之,本系统通过多个算法和界面版本的组合,提供了丰富的选择和强大的功能。
下面是对包含到的算法的大概介绍:
1. yolov8相关介绍
YOLOv8 是当前深度学习领域内的一个SOTA(State-Of-The-Art)模型,凭借其前代版本的技术积累,再次引领了目标检测算法的发展方向。与其前辈不同,YOLOv8在模型结构和计算方式上都做了创新性调整,旨在实现更高效的计算和更灵活的应用场景适应能力。全新的骨干网络设计,结合Anchor-Free 检测头,让模型在面对不同输入尺寸、不同目标尺度时的表现更加出色,极大提升了性能和准确性。
此外,YOLOv8 的另一个重要进步在于它采用了全新的损失函数,使得训练过程更加稳定和高效。无论是在传统的CPU平台上运行,还是在更强大的GPU平台上进行加速,YOLOv8 都能够适应不同硬件资源的场景,确保在各种场合下保持高效的推理速度和精确的检测能力。
不过,值得注意的是,ultralytics 这一开发团队并没有直接将其开源库命名为 YOLOv8,而是采用了ultralytics的品牌名来命名整个项目。这并非单纯的命名策略,而是反映了其定位的重大变化。ultralytics 将这个库不仅视为一个算法框架,而非仅仅一个 YOLO 版本的延续。其设计目标之一是打造一个能够适应不同任务的算法平台,无论是目标检测、分类、分割,还是姿态估计,都能够在这个框架中被高效地支持。
这也意味着,未来的ultralytics 开源库将不仅限于 YOLO 系列,它的可扩展性为用户提供了更大的可能性。无论是使用非 YOLO 系列模型,还是面对不同应用领域的特定需求,ultralytics都提供了灵活且高效的解决方案。
总的来说,ultralytics 开源库 的优势可以归纳为以下几个要点:
-
融合当前最前沿的深度学习技术,让用户可以轻松实现复杂的计算任务。
-
具有极高的扩展性,未来将不仅支持 YOLO 系列,还会支持更多非 YOLO 的算法,适用于广泛的任务场景。
如此一来,ultralytics 不仅能够帮助开发者在算法研究和工程应用上取得突破,更能推动未来智能视觉领域的进一步发展。

网络结构如下:

2. yolov5相关介绍
YOLOV5有YOLOv5n,YOLOv5s,YOLOv5m,YOLOV5l、YOLO5x五个版本。这个模型的结构基本一样,不同的是deth_multiole模型深度和width_multiole模型宽度这两个参数。就和我们买衣服的尺码大小排序一样,YOLOV5n网络是YOLOV5系列中深度最小,特征图的宽度最小的网络。其他的三种都是在此基础上不断加深,不断加宽。不过最常用的一般都是yolov5s模型。

本系统采用了基于深度学习的目标检测算法YOLOv5,该算法是YOLO系列算法的较新版本,相比于YOLOv3和YOLOv4,YOLOv5在检测精度和速度上都有很大的提升。YOLOv5算法的核心思想是将目标检测问题转化为一个回归问题。此外,YOLOv5还引入了一种称为SPP(Spatial Pyramid Pooling)的特征提取方法,这种方法可以在不增加计算量的情况下,有效地提取多尺度特征,提高检测性能。
在YOLOv5中,首先将输入图像通过骨干网络进行特征提取,得到一系列特征图。然后,通过对这些特征图进行处理,将其转化为一组检测框和相应的类别概率分数,即每个检测框所属的物体类别以及该物体的置信度。YOLOv5中的特征提取网络使用CSPNet(Cross Stage Partial Network)结构,它将输入特征图分为两部分,一部分通过一系列卷积层进行处理,另一部分直接进行下采样,最后将这两部分特征图进行融合。这种设计使得网络具有更强的非线性表达能力,可以更好地处理目标检测任务中的复杂背景和多样化物体。

在YOLOv5中,每个检测框通过其左上角坐标(x, y)、宽度(w)、高度(h)以及置信度(confidence)来表示。此外,YOLOv5对于每个检测框还会预测C个类别的概率得分,每个类别的概率得分总和为1。这意味着每个检测框最终可以被表示为一个维度为(C+5)的向量,包括类别概率、位置和置信度信息。
在训练过程中,YOLOv5使用了交叉熵损失函数来优化模型,该损失函数由定位损失、置信度损失和分类损失三个部分组成。YOLOv5还采用了Focal Loss和IoU Loss等优化方法,以缓解正负样本不平衡及目标尺寸变化等问题。这些优化不仅提高了模型的准确性,还改善了在不同尺寸目标下的表现。
从网络结构来看,YOLOv5分为四个主要部分:Input(输入)、Backbone(骨干网络)、Neck(颈部结构)和Prediction(预测)。其中,Input部分负责将数据引入网络,采用了Mosaic数据增强技术,能够通过随机裁剪和拼接输入图片,进一步提升网络的泛化能力。
Backbone部分是YOLOv5提取图像特征的关键模块,其特征提取能力直接影响了整个模型的性能表现。相比前代YOLOv4,YOLOv5在Backbone中引入了Focus结构。Focus结构通过切片操作将图片的宽度(W)和高度(H)信息转移到通道空间中,从而实现了2倍的下采样操作,同时保证了不丢失关键信息。
3. yolo11相关介绍
YOLO11采用改进的骨干和颈部架构,增强了特征提取能力,提高了物体检测的精确度和复杂任务的表现。YOLO11引入精炼的架构设计和优化的训练流程,实现更快的处理速度,同时保持精度和性能之间的最佳平衡。通过模型设计的进步,YOLO11m在COCO数据集上实现了更高的均值平均精度(mAP),同时使用比YOLOv8m少22%的参数,使其在不妥协准确性的情况下更加计算高效。YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台以及支持NVIDIA GPU的系统,确保最大灵活性。无论是物体检测、实例分割、图像分类、姿态估计,还是定向物体检测(OBB),YOLO11都旨在应对多样的计算机视觉挑战。

1. Ultralytics YOLO11相比于之前版本的主要改进有哪些?
Ultralytics YOLO11在其前身基础上引入了几项重要进步。主要改进包括:
增强的特征提取: YOLO11采用改进的骨干和颈部架构,增强了特征提取能力,提高了物体检测的精确度。
优化的效率和速度: 精炼的架构设计和优化的训练流程实现了更快的处理速度,同时保持了准确性和性能之间的平衡。
更高的准确性与更少的参数: YOLO11m在COCO数据集上实现了更高的均值平均精度(mAP),同时使用比YOLOv8m少22%的参数,使其在不妥协准确性的情况下更加计算高效。
环境适应性强: YOLO11可以在多种环境中部署,包括边缘设备、云平台以及支持NVIDIA GPU的系统。
支持广泛的任务: YOLO11支持多种计算机视觉任务,如物体检测、实例分割、图像分类、姿态估计和定向物体检测(OBB)。
我们先来看一下其网络结构有什么变化,可以看出,相比较于YOLOv8模型,其将CF2模块改成C3K2,同时在SPPF模块后面添加了一个C2PSA模块,且将YOLOv10的head思想引入到YOLO11的head中,使用深度可分离的方法,减少冗余计算,提高效率。

2. C3K2的网络结构
从下面图中我们可以看到,C3K2模块其实就是C2F模块转变出来的,它代码中有一个设置,就是当c3k这个参数为FALSE的时候,C3K2模块就是C2F模块,也就是说它的Bottleneck是普通的Bottleneck;反之当它为true的时候,将Bottleneck模块替换成C3模块。

3. C2PSA的网络结构
C2PSA是对 C2f 模块的扩展,它结合了PSA(Pointwise Spatial Attention)块,用于增强特征提取和注意力机制。通过在标准 C2f 模块中引入 PSA 块,C2PSA实现了更强大的注意力机制,从而提高了模型对重要特征的捕捉能力。

4. PyQt5介绍
PyQt5 是 Python 语言的一个图形用户界面(GUI)开发框架,基于 Qt库 开发而成。Qt 是一个广泛使用的跨平台 C++ 图形库,支持开发适用于 Windows、macOS、Linux 等多个操作系统的应用程序。PyQt5 提供了对 Qt 类库的完整封装,使开发者可以使用 Python 语言构建功能强大、界面美观的桌面应用。
PyQt5 包含了丰富的组件,如窗口、按钮、文本框、表格等,可以通过拖拽和代码的方式快速布局,极大地简化了 GUI 开发流程。同时,它还支持 事件处理 和 信号与槽机制,使得用户与界面之间的交互更加灵活。
通过 PyQt5,开发者能够轻松实现跨平台桌面应用,同时结合 Python 的易用性和 Qt 的强大功能,既适合初学者学习 GUI 编程,也适合资深开发者进行复杂项目的开发。
🌟 四、模型训练步骤
项目工程中提供详细的模型训练步骤,如果有需要的话,可以在自己的电脑上训练模型。
-
使用pycharm打开代码,找到
train.py打开,示例截图如下:

-
修改 model_yaml 的值,以符合实际情况。如果你打算训练 YOLOv8s 模型,请将其修改为 model_yaml = yaml_yolov8s。如果你想训练添加 SE注意力机制 的模型,请将其修改为 model_yaml = yaml_yolov8_SE。
-
修改 data_path 的数据集路径。这里默认指定的是 traindata.yaml 文件。如果你使用的是我提供的数据,可以不用修改。
-
修改 model.train() 中的参数,根据自己的需求和电脑硬件的情况进行调整。
# 文档中对参数有详细的说明 model.train(data=data_path, # 数据集 imgsz=640, # 训练图片大小 epochs=200, # 训练的轮次 batch=2, # 训练batch workers=0, # 加载数据线程数 device='0', # 使用显卡 optimizer='SGD', # 优化器 project='runs/train', # 模型保存路径 name=name, # 模型保存命名 ) -
修改
traindata.yaml文件, 打开traindata.yaml文件,如下所示:

在这里,只需修改 path 的值,其他的都不用改动(仔细看上面的黄色字体),我提供的数据集默认都是到yolo文件夹,设置到 yolo 这一级即可,修改完后,返回train.py中,执行train.py。 -
打开
train.py,右键执行。

-
出现如下类似的界面代表开始训练了

-
训练完后的模型保存在runs/train文件夹下

🌟 五、模型评估步骤
-
打开
val.py文件,如下图所示:

-
修改
model_pt的值,是自己想要评估的模型路径 -
修改
data_path,根据自己的实际情况修改,具体如何修改,查看上方模型训练中的修改步骤 -
修改
model.val()中的参数,按照自己的需求和电脑硬件的情况更改model.val(data=data_path, # 数据集路径 imgsz=300, # 图片大小,要和训练时一样 batch=4, # batch workers=0, # 加载数据线程数 conf=0.001, # 设置检测的最小置信度阈值。置信度低于此阈值的检测将被丢弃。 iou=0.6, # 设置非最大抑制 (NMS) 的交叉重叠 (IoU) 阈值。有助于减少重复检测。 device='0', # 使用显卡 project='runs/val', # 保存路径 name='exp', # 保存命名 ) -
修改完后,即可执行程序,出现如下截图,代表成功(下图是示例,具体以自己的实际项目为准。)

-
评估后的文件全部保存在在
runs/val/exp...文件夹下

🌟 六、训练结果
我们每次训练后,会在 run/train 文件夹下出现一系列的文件,如下图所示:
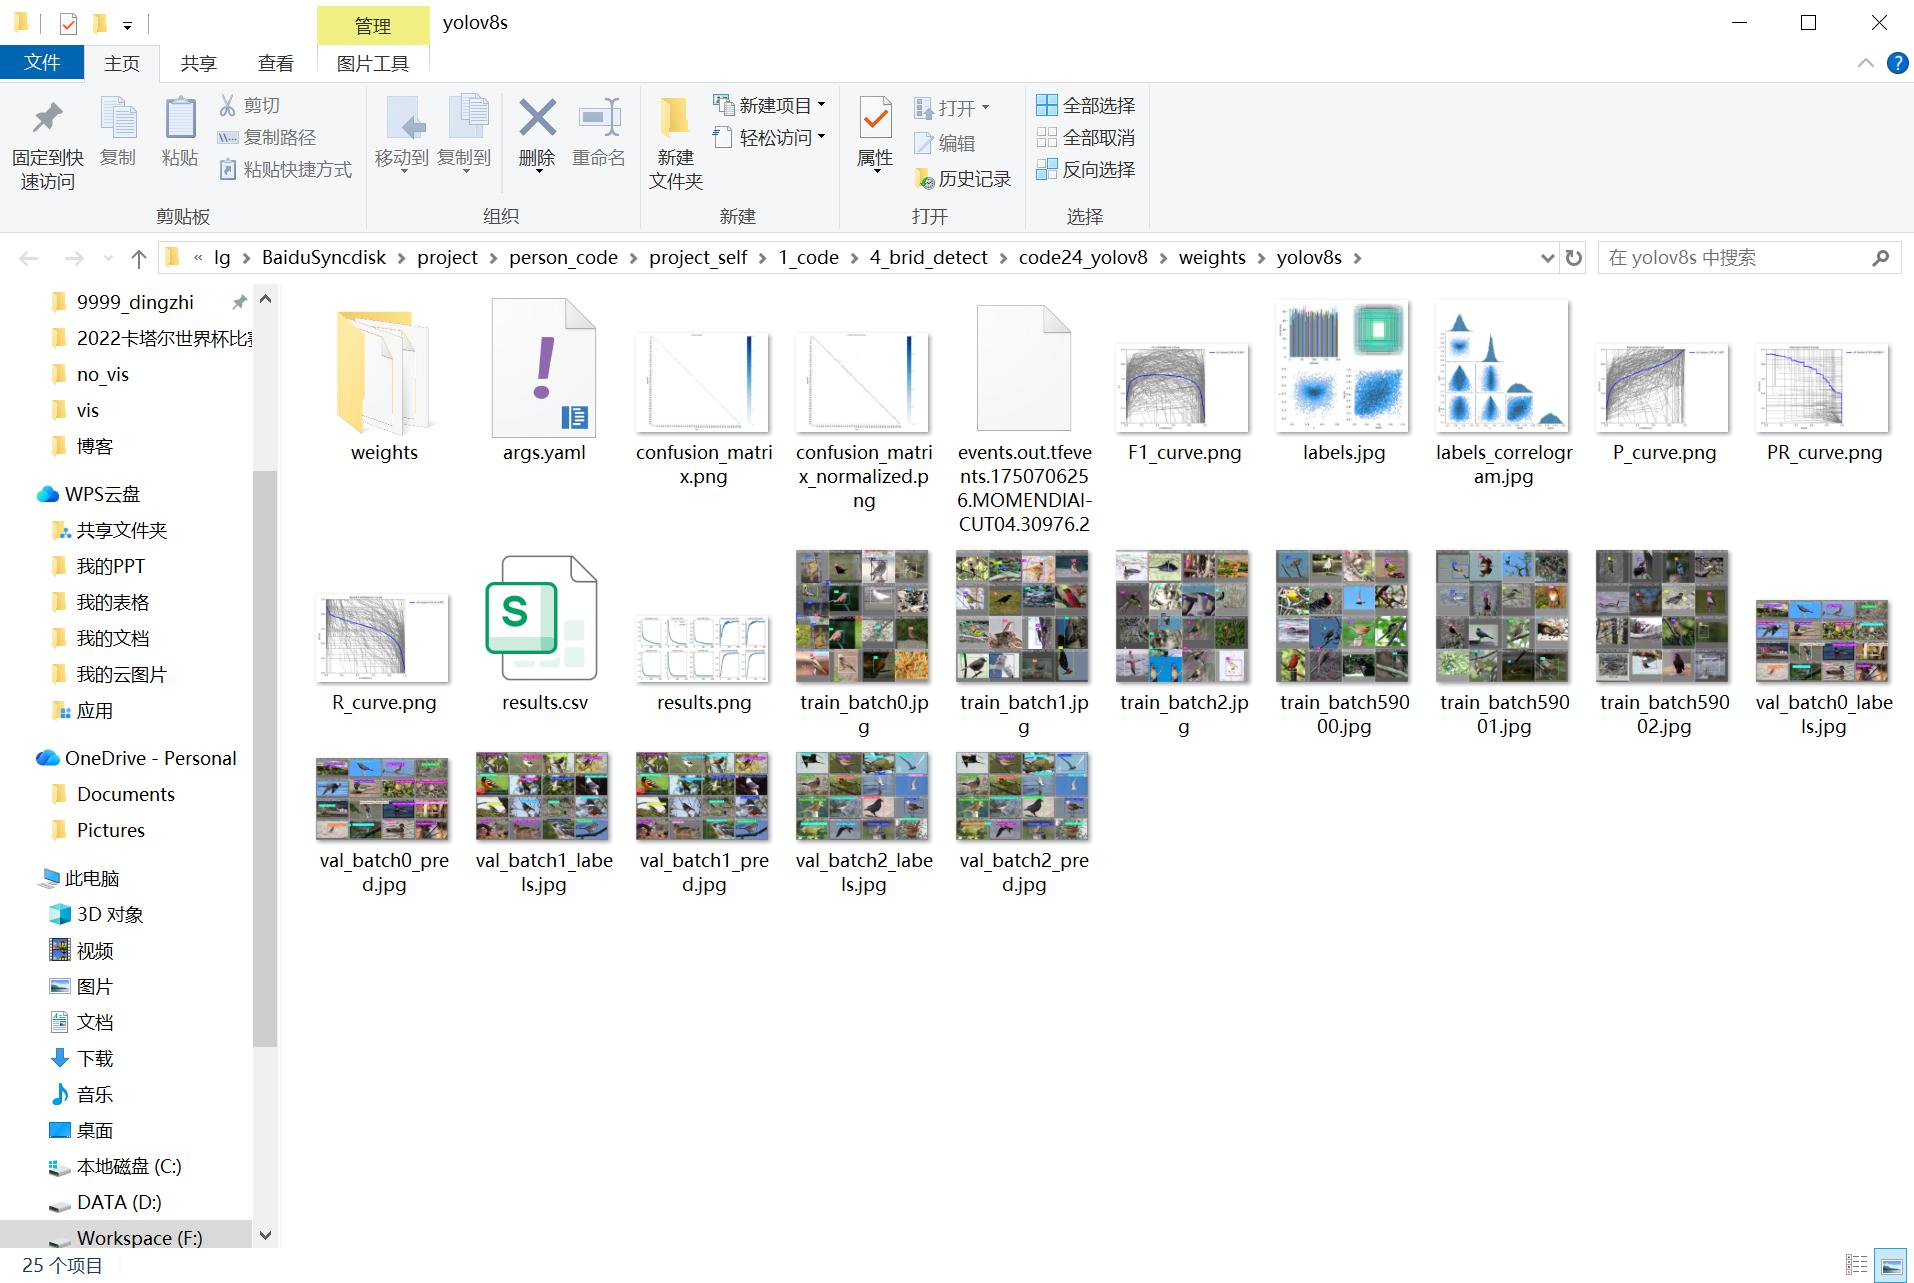
如果大家对于上面生成的这些内容(confusion_matrix.png、results.png等)不清楚是什么意思,可以参考一下我写的文档,查看这些指标的具体含义,示例截图如下:

结束语 🌟 🌟🌟🌟
下面图片是对每个文件夹作用的介绍:

其实用yolo算法做系统非常的简单,但是博客文字有限,如果有介绍不明白的地方,也可以看一下下面的视频,也许会更容易理解。视频中介绍了如何进行训练、预测,简单修改界面等。
演示与介绍视频: 04-基于YOLO12的鸟类检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络
演示与介绍视频: 04-基于深度学习的鸟类检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)
演示与介绍视频: 04-基于深度学习的鸟类检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)
演示与介绍视频: 04-基于深度学习的鸟类检测识别系统(yolov5)(附赠任务书、开题报告模板课程)
由于博主的能力有限,文中提到的方法虽经过实验验证,但难免存在一些不足之处。为不断提升内容的质量与准确性,欢迎您指出任何错误和疏漏。这不仅将帮助我在下次更新时更加完善和严谨,也能让其他读者受益。您的反馈对我至关重要,能够推动我进一步完善相关内容。
此外,如果您有更优秀的实现方案或独到的见解,也非常欢迎分享。这将为大家提供更多思路与选择,促进我们共同的成长与进步。期待您的宝贵建议与经验交流,非常感谢您的支持!
参考文献:
-
Redmon, J., & Farhadi, A. (2018). YOLOv3: An Incremental Improvement. arXiv preprint arXiv:1804.02767.
该文献介绍了YOLO(You Only Look Once)系列模型的第三版,是一种广泛用于实时目标检测的深度学习模型,为目标检测提供了技术支持。
-
Bochkovskiy, A., Wang, C. Y., & Liao, H. Y. M. (2020). YOLOv4: Optimal Speed and Accuracy of Object Detection. arXiv preprint arXiv:2004.10934.
该文献介绍了YOLOv4模型,在目标检测的精度和速度方面进行了优化。
-
Jocher, G., et al. (2023). Ultralytics YOLOv8. https://github.com/ultralytics/ultralytics.
该文献介绍了YOLOv8模型,是当前目标检测领域的SOTA模型之一,支持检测、分割、分类等多种任务。
ang, C. Y., & Liao, H. Y. M. (2020). YOLOv4: Optimal Speed and Accuracy of Object Detection. arXiv preprint arXiv:2004.10934.该文献介绍了YOLOv4模型,在目标检测的精度和速度方面进行了优化。
 1294


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


