scrary爬取---新浪新闻

新浪新闻爬取代码 初学者学习网络爬虫,爬取新浪新闻的代码,代码结构完整,并可以显示出爬取成功次数 立即下载

创建名令:
1 scrapy startproject Myspider
2 scrapy genspider sina sina,com
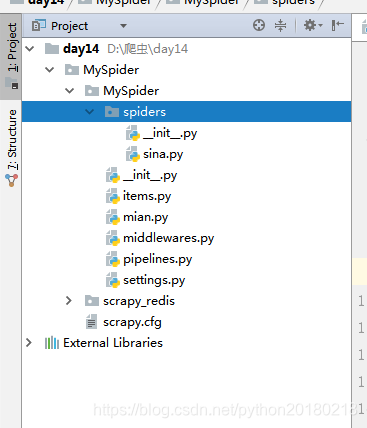
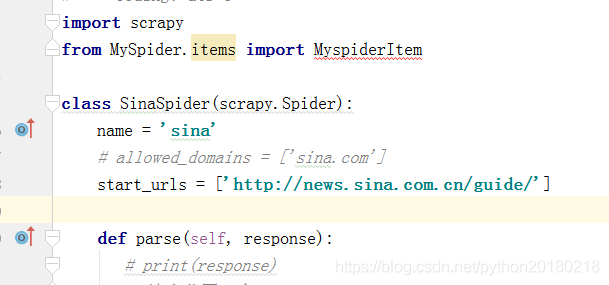
在这里插入图片描述

在这里插入图片描述
spider下面sina里面的代码

import scrapy
import re
#导入items类,用于实例化对象,将字段存入items
from mySpider.items import MyspiderItem
#新建一个爬虫类,用于继承spider`
class XiaChuFang(scrapy.Spider):
    #定义爬虫名称
    name = 'xcf'
    #定义爬虫起始的url
    start_urls=["http://www.xiachufang.com/category/40076/"]
    #定义解析response的parse函数
    def parse(self, response):
        # print(response)
        # html=response.body.decode('utf-8')
        # print(html)
        # with open('xcf.html','w',encoding='utf-8') as f:
        #     f.write(html)
        #首先缩小范围:
        li_list=response.xpath('//div[@class="pure-u-3-4 category-recipe-list"]//div[@class="normal-recipe-list"]/ul[@class="list"]/li')
        # print(len(li_list))
        # print(li_list)
        #循环遍历每一个li标签
        for li in li_list:
            #爬取图片:
            pic=li.xpath('.//img/@data-src').extract()[0]
            # print(pic)
            # print(type(pic))
            pic=re.sub('[@?](.*)','',pic)
            # print(pic)
            #获取名称
            food_name=li.xpath('.//p[@class="name"]/a/text()').extract()[0].strip()
            food_name=re.findall("[\u4e00-\u9fa5|a-z|\w]+",food_name,re.I)[0]
            # print(food_name)
            # print(food_name)
            #获取分数
            score=li.xpath('.//span[@class="score bold green-font"]/text()').extract()
            score=float(score[0]) if score else  0.0
            # print(score)
            #获取原料
            food_source=li.xpath('.//p[@class="ing ellipsis"]//text()').extract()
            food_source=''.join(food_source).strip()
            food_source = re.findall("[\u4e00-\u9fa5|a-z|\w]+", food_source, re.I)[0]
            # print(food_source)
            #昵称
            nick_name=li.xpath('.//p[@class="author"]/a/text()').extract()[0]
            # print(nick_name)
            #获取深度爬取的url
            detail_url = li.xpath('.//p[@class="name"]/a/@href').extract()[0]
            detail_url='http://www.xiachufang.com'+detail_url
            # print(detail_url)

            #实例化item类,将字段存入item
            item = MyspiderItem()
            #item类型是一个类似于字典类型
            # print(item)
            item['pic']=pic
            item['food_name']=food_name
            item['score']=score
            item['food_source']=food_source
            item['nick_name']=nick_name
            item['detail_url']=detail_url
            #返回使用 yield 返回给pipelines
            #触发pipelines文件中process_item
            #url表示进一步爬取的url,callback表示回调函数,接受详情url返回的界面。
            #meat表示传递给parse函数的列表页数据。
            # dont_filter  True表示不对url过滤,爬过的可以重复爬取。
            #yield是一个迭代器。使用yeild可以让我们的函数继续执行,return会直接结束函数
            #使用yeild可以不用等待上一次运行结束就可以开始运行。
            yield scrapy.Request(url=detail_url,callback=self.parse_detail,
                                 meta={'data':item},dont_filter=False)


        #获取下一页的url
        next_page_url=response.xpath('//a[@class="next"]/@href').extract()
        print(next_page_url)
        #最后一页为空直接跳过结束。
        if next_page_url:
            #拼接完整的下一页url
            next_page_url="http://www.xiachufang.com"+next_page_url[0]
            # print(next_page_url)
            #递归调用自己
            yield scrapy.Request(url=next_page_url,callback=self.parse)

    #解析详情页信息
    def parse_detail(self,response):

        # print(response.meta)
        # print(response.url)

        # 接受item参数
        item=response.meta['data']
        # print(item)
        #做过这道菜的人数
        cooker_number=response.xpath('//div[@class="cooked float-left"]//span[@class="number"]/text()').extract()[0]
        # print(cooker_number)

        cooker_method=response.xpath('//div[@class="steps"]/ol//li//p[@class="text"]/text()').extract()
        cooker_method='|'.join(cooker_method)
        cooker_method = re.findall("[\u4e00-\u9fa5|a-z|\w\|]+", cooker_method, re.I)
        cooker_method=''.join(cooker_method)
        # print(cooker_method)
        # print(cooker_method)

        #将数据放入item中,然后返回给pipelins中
        item['cooker_number']=int(cooker_number)
        item['cooker_method']=cooker_method
        yield item

item里面的定义代码

import scrapy


class CarspiderItem(scrapy.Item):
    # define the fields for your item here like:
    # name = scrapy.Field()
    pic=scrapy.Field() #图片
    title=scrapy.Field()# 标题
    price=scrapy.Field()# 价格
    details_url=scrapy.Field()#详情页
    sourse_id=scrapy.Field()#车源号
    pic_list=scrapy.Field()#详情页图片列表
    regist_time=scrapy.Field()#注册时间
    ckg=scrapy.Field()#注册时间

管道里面的代码,包括写入数据库

import pymongo
class MyspiderPipeline(object):
    def __init__(self):
        self.count=1
        self.db=self.conn_mongo()
    def conn_mongo(self):
        client=pymongo.MongoClient(host='127.0.0.1',port=27017)
        #选择数据库:
        return client.sina
    def process_item(self, item, spider):
        print(self.count,item)
        #将item存入Mongo数据库中
        self.db.sina.insert(dict(item))
        self.count += 1
        return item

打开setting里面的中间件
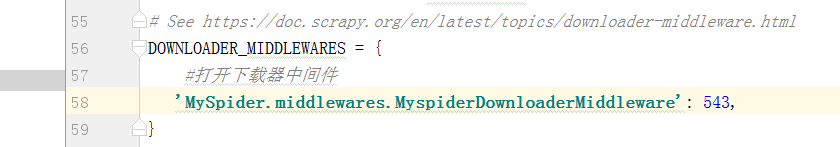
在这里插入图片描述
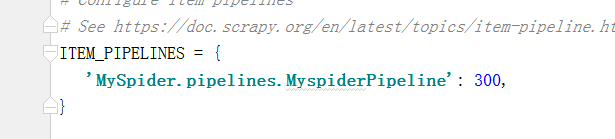
打开管道
在这里插入图片描述
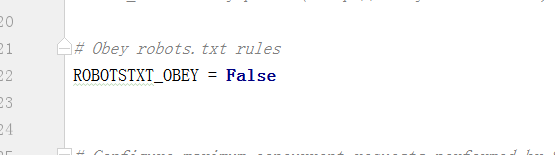
规定的true 改成false
在这里插入图片描述

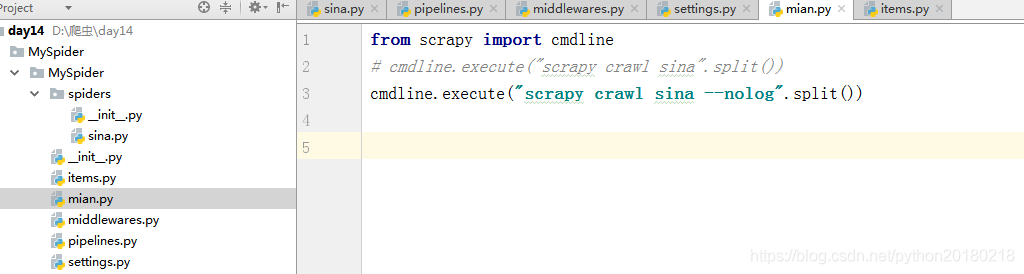
启动名令
在这里插入图片描述

新浪新闻爬虫程序 用java代码实现对新浪新闻的部分模块进行自动爬取,导出保存为TXT文本。 立即下载

相关推荐

python爬虫:爬取新浪新闻数据

1. 爬虫的浏览器伪装原理: 我们可以试试爬取新浪新闻首页,我们发现会返回403 ,因为对方服务器会对爬虫进行屏蔽。此时,我们需要伪装成浏览器才能爬取。 1.实战分析: 浏览器伪装一般通过报头进行: 打开某个网页,按F12—Network— 任意点一个网址可以看到:Headers—Request Headers中的关键词User-Agent用来识别是爬虫还是浏览器。 import urllib.request\nurl='http://weibo.com/tfwangyuan?is_hot=1' headers=('User-Agent','Mozilla/5.0 (Windows NT 10.

scrary框架的安装和简单的操作

今天在这里我向大家简单的谈论一下关于scrapy框架的安装,不当之处望大神给予指出。 1.关于scrapy框架 Scrapy是用纯Python实现一个为了爬取网站数据、提取结构性数据而编写的应用框架,用途非常广泛。 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页内容以及各种图片,非常之方便。 Scrapy 使用了 Twisted['twɪs...

qq_42543254的博客 1232

工业互联网工控安全与工业质检AI大模型建设方案.pptx

工业互联网工控安全与工业质检AI大模型建设方案.pptx

python 爬取排行榜小说和文本

# -*- coding: utf-8 -*- import scrapy import sys sys.path.append("D:\\pycodes\\novel") class XiaoshuoSpider(scrapy.Spider): name = 'xiaoshuo' start_urls = ['https://www.qu.la/paihangbang/']

learn_is_happy的博客 1510

GD32F303调试小记(一)之USART(接收中断、接收空闲中断+DMA、发送DMA)

前言 之前写了GD32F103调试小记(二)之USART(接收中断、接收空闲中断+DMA、发送DMA)一文。这次我们来看看GD32F303的USART是如何配置的,结合这两篇文章,相信大家GD32的USART配置流程会十分熟悉。 DMA 能大大减轻CPU负荷的东西,建议场景合适的情况下,都去用DMA功能。 USART 一种串行通信协议, ...

欢喜6666的博客 3万+

SecureCRT串口连接保姆级教程:从驱动安装到波特率设置(附常见问题解决)

本文提供SecureCRT串口连接的保姆级教程,涵盖从USB转串口驱动安装、端口识别到波特率等核心参数设置的完整流程。针对连接失败、乱码、键盘输入无响应等高频问题,给出了深度排查与解决方案,帮助网络与嵌入式开发新手快速掌握串口调试技能。

weixin_29281941的博客 432

Scrapy

Scrapy介绍      Scrapy一个开源和协作的框架,其最初是为了页面抓取(更确切来说,网络抓取)所设计的,使用它可以快速、简单、可扩展 的方式从网站中提取所需的数据。但目前Scrapy的用途十分广泛,可用于如挖掘、监测和自动化测试等领域,也可以应用在API 所返回的数据(例如Amazon Associates Web Services)或者通用的网络爬虫。       Scrap...

HukDog的博客 7625

stm32开发3D打印机(一)——介绍(已完成)

如何运用stm32开发3D打印机

Nico_jion的博客 1万+

scrapy避免被禁止

在scrapy 项目中,主要可以通过以下方法来避免被禁止: 1)禁止cookies 2)设置下载延时 3)使用ip池 4)使用用户代理; 5)其他方法,比如进行分布式爬取等(这个就不介绍了) 1.禁止cookies        如果我们要禁止使用cookies,可以在对应scrapy爬虫项目中的settings.py文件进行相应的设置。打开settings.py文件找到一下    ...

偷得浮生半日闲 2105

银河麒麟v10离线安装docker二进制包

因为工作需要在银河麒麟v10系统上离线部署k8s集群,k8s部署的前提是具有docker环境,因此离线安装docker成为必然。 1.下载docker包:Index of linux/static/stable/x86_64/ 选择自己合适的版本,我下载的是20.10.7 选择自己放置docker包的路径进行解压: cd /home/huawei/zq tar -zxvf docker-20.10.7.tgz 2. 给docker包解压出来的docker文件夹下的二进制文件赋..

q_hsolucky的博客 7683

[Python]:热血传奇-Wzl,Wzx的解析

首先我们要了解,wzl与wzx的对应关系,wzx里面存的是每张二进制图片数据在wzl中的偏移量,所以取到wzx中的偏移数据就可以取到wzl每张图片数据,其实就这么简单。结构体为 [Byte][Byte][Byte][Byte][short][short][short][short][int]-读取44至48字节代表为,[wzx中偏移值总数量] [int类型] [4字节]-根据在wzx中取得的偏移值总数量,每张图片偏移值在wzl中取图片数据。2.[取wzl中图片偏据]:根据wzx中取得数据对[

qq_36138506的博客 3444

scrapy

简介 Scrapy,Python开发的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试. Scrapy主要包括了以下组件: 引擎(Scrapy) 用来处理整个系统的数据流处理, 触发事务(框架核心) 调度器(Scheduler) 用来接受引擎发过来的请求, 压入队列中, 并在引擎再次请求的时候返回...

张艳秋的博客 1万+

从零开始讲DDR(8)——AXI 接口MIG 使用(1)

我们简单拆解了MIG AXI接口中测试文件的整体框架,首先在sim_tb_top.sv文件中例化了DDR模型和example_top。在example_top中,又例化了MIG IP和一个流量产生器ddr4_v2_2_8_axi_tg_top。在ddr4_v2_2_8_axi_tg_top中的主要功能是分别例化了boot_mode_gen,prbs_mode_gen,custom_mode_gen和axi_opcode_gen。

apple_53311083的博客 1587

scrapy使用心得(入门教程)

scrapy官网:https://doc.scrapy.org/en/latest/topics/settings.html 基本上没有什么教程可以媲美官方文档的,所有的教程不过是在解读官方文档。所以,如果你有耐心的话可以自己看官方文档。使用谷歌浏览器自带的谷歌翻译可以看得懂,不像python官方的文档,机翻出来基本天书。 关于各组件的功能,我觉得这个博客写的很好。可以看一下https://www...

Qwertyuiop2016的博客 2733

Mac安装Typescript报错

根本原因是系统级目录的权限限制。推荐通过修改目录权限或使用nvm彻底解决问题。

江拥羡橙的博客 210

手把手教你学Simulink——四开关 Buck‑Boost(FSBB)变换器的无缝模式切换仿真

本文详细介绍了四开关Buck-Boost(FSBB)变换器的Simulink仿真方法,重点解决模式切换时的直通风险和输出电压波动问题。通过统一电压PI控制、迟滞比较模式仲裁(Buck/Boost/Pass-Through)和200ns死区设计,实现了Vin从26V到22V变化时Vout稳定在12V±0.15V。关键步骤包括:搭建功率级电路、Stateflow模式判断、PI控制器输出占空比映射(Buck模式D≈Vo/Vin,Boost模式D≈1-Vo/Vin),以及带死区的PWM信号分配。仿真验证了切换过程中

MHD0815的博客 114

Scrapy工作原理

一、Scrapy架构图 Scrapy框架主要由六大组件组成,它们分别是调试器(Scheduler)、下载器(Downloader)、爬虫(Spider)、中间件(Middleware)、实体管道(Item Pipeline)和Scrapy引擎(Scrapy Engine) 1、Scrapy Engine(引擎): 引擎负责控制数据流在系统的所有组件中流动,并在相应动作发生时触发事件。 2、...

可爱程序员 1万+

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

scrapy 快速入门

安装Scrapy Scrapy是一个高级的Python爬虫框架,它不仅包含了爬虫的特性,还可以方便的将爬虫数据保存到csv、json等文件中。 首先我们安装Scrapy。 pip install scrapy 在Windows上安装时可能会出现错误,提示找不到Microsoft Visual C++。这时候...

weixin_34246551的博客 1487

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Scrapy爬虫框架,入门案例(非常详细)

Scrapy,Python开发的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试. 其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的, 后台也应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫. Scrapy吸引人的地...

ck784101777的博客 21万+

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

python爬虫新浪新闻_python爬虫之获取新浪新闻信息

一:前言windows平台:1):谷歌的chrome浏览器;python3.6的软件安装包,需要导入的库有:[python] view plaincopypipinstallrequestspipinstallBeautifulSoup42):直接用集成好的软件Anaconda;linux平台下:1):火狐浏览器;Ubuntu16.04已经自动安装了python2.7和python3.6...

weixin_28717611的博客 3420

一、Scrapy爬虫概述

Scrapy是一个Python编写的开源网络爬虫框架。它是一个被设计用于爬取网络数据、提取结构性数据的框架。

IT瘾君子的博客 2152

Python爬虫爬取新浪新闻内容

首先感谢丘祐玮老师在网易云课堂的Python网络爬虫实战课程,接下来也都是根据课程内容而写.一来算是自己的学习笔记,二来分享给大家参考之用。 课程视频大概是在16年11月录制的,现在是18年2月.其中有几处因网站更新升级产生的不同,小小修改后仍是爬虫学习的高价值资料. 本教程十分适合爬虫初学者(像我这样),涉及知识内容很基础.下面正式开始: 一 首先布置开发语言和环境 1.1 python...

小龙狗的博客 2万+

pandas网络爬虫(一)

说到网络爬虫,就要提到正则表达式和urllib库 python自带re模块和urllib模块 -------------------------------------------------------------------------------------------------------------------------------- 正则表达式 正则表达式,又称规则表达式,...

qq_39577827的博客 2130

python 之 scrapy 入门 (初入)

在网上浏览了众多scrapy入门教程 作为小白的我总结一下: 最重要的一点就是安装Scrapy 前提是安装好了Anaconda Navigator过后 简直是如履平地啊! 可以借鉴https://blog.youkuaiyun.com/zjiang1994/article/details/52689144这篇博客的安装方法 1 . 只需要python编译环境满足的条件下 不需要那么繁琐的操作 2 ...

CN-LILU的博客 1万+

python3爬取新浪新闻内容

代码如下:#commentsUrl用于获取新闻评论数等json信息 commentsUrl = 'http://comment5.news.sina.com.cn/page/info?version=1&format=js&channel=gn&newsid=comos-{}&group=&compress=0&ie=utf-8&oe=utf-8&page=1&page_size=20&jsvar=

Alan_Xiang的博客 3512

Python爬取新浪新闻

打开网址输入 news.sina.com.cn 这里我选择了国际新闻,然后点击检查 通过查看可以发现新闻的相关信息存放在如下图的js文件里面 在上图中我们通过点击相关元素便能轻易的找到需要的信息,通过层层分析最后编写爬虫:代码如下:import json import requests from bs4 import BeautifulSoup import pymongo from pymo

God_favored_one的博客 4434
上一篇: scrapy框架爬取---链家房网
下一篇: Python爬虫监控简介
Mis相遇
博客等级 码龄8年 87粉丝 90原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值