


使用LLM进行股价预测(附代码)
注意
- 代码是完整的,但是需要 https://github.com/wxy2ab/akinterpreter 才能完整运行
利用 Python 和 AkShare 进行股票数据分析与预测:以中远海控为例
在本文中,我们将使用 Python 的 akshare 库获取中远海控(股票代码:601919.SH)2024 年的日线股票数据,并结合机器学习模型进行股价预测。接着,我们会可视化历史数据与预测结果,并生成一份简短的市场分析报告。整个过程涵盖了数据获取、处理、预测、可视化和分析等多个环节。
1. 获取中远海控2024年日线股票数据
首先,我们利用 akshare 库中的 stock_zh_a_daily 函数来获取中远海控股票的日线数据。
import akshare as ak
import datetime

# 获取今天日期
today = datetime.date.today()

# 将日期转换成 yyyyMMdd 格式
end_date = today.strftime("%Y%m%d")

# 使用 stock_zh_a_daily 函数获取中远海控2024年日线股票数据
cosco_daily_data_2024 = ak.stock_zh_a_daily(symbol="601919.SH", start_date="20240101", end_date=end_date)

# 打印返回的数据
print(cosco_daily_data_2024)
在这段代码中,我们通过 ak.stock_zh_a_daily 函数获取了从 2024 年 1 月 1 日到今天的中远海控股票数据,并将其打印出来进行检查。
2. 数据预处理与预测
我们将获取的数据进行一些预处理,确保数据格式适合机器学习模型的输入。然后,我们使用机器学习模型(假设通过某个 llm_client 客户端)进行未来 5 天股价的预测。
2.1 数据处理函数
这里定义了两个函数,一个用于处理输入数据,另一个用于处理模型预测结果。
import pandas as pd
import re

# 准备输入数据
input_data = cosco_daily_data_2024[['date', 'close']].set_index('date')

# 定义数据处理函数
def data_processor(data):
    return data.asfreq('D').fillna(method='ffill').iloc[-30:]  # 使用最近30天的数据

# 定义响应处理函数
def response_processor(response, num_of_predict):
    # 使用正则表达式提取预测结果中的数字
    numbers = re.findall(r'\d+\.\d+', response)
    predictions = [float(num) for num in numbers[-num_of_predict:]]
    return pd.Series(predictions, name='close', index=pd.date_range(start=input_data.index[-1] + pd.Timedelta(days=1), periods=num_of_predict))
data_processor函数:将数据处理为按日频率,填充缺失值,并返回最近 30 天的数据。response_processor函数:处理模型的预测结果,提取出预测的股价数据,并将其转换为 PandasSeries对象。
2.2 进行预测
接下来,我们使用 llm_client 进行预测,假设该客户端能够接收历史数据并返回预测结果。
# 使用llm_client进行预测
predictions = llm_client.predict(input_data, num_of_predict=5, data_processor=data_processor, response_processor=response_processor)
在这一步,我们将处理过的 input_data 传递给 llm_client,并设置预测天数为 5 天。预测结果通过 response_processor 处理,转换为 Pandas Series。
3. 数据可视化
我们使用 matplotlib 和 seaborn 库来绘制中远海控的历史股价和预测股价曲线。在此之前,我们还需要确保字体设置正确,以支持中文显示。
3.1 配置中文字体
import os
from matplotlib import font_manager

# 设置中文字体
def configure_matplotlib_for_chinese():
    import platform
    system = platform.system()
    if system == 'Windows':
        font_name = 'SimHei'
    elif system == 'Darwin':
        font_name = 'STHeiti'
    else:  # For Linux
        font_path = '/usr/share/fonts/truetype/wqy/wqy-zenhei.ttc'
        if os.path.exists(font_path):
            font_manager.fontManager.addfont(font_path)
            font_name = font_manager.FontProperties(fname=font_path).get_name()
        else:
            raise FileNotFoundError(f"Font file not found: {font_path}")

    # Set the font properties
    plt.rcParams['font.sans-serif'] = [font_name]
    plt.rcParams['font.family'] = 'sans-serif'
    plt.rcParams['axes.unicode_minus'] = False

# 运行配置函数
configure_matplotlib_for_chinese()
为了在可视化图表中正确显示中文,我们根据不同的操作系统设置了合适的中文字体。对于 Windows 和 macOS,分别使用了系统自带的字体;对于 Linux,则使用了 wqy-zenhei 字体。
3.2 绘制图表
import matplotlib.pyplot as plt
import uuid

# 访问之前步骤的数据
historical_data = cosco_daily_data_2024
prediction_data = predictions

# 合并历史数据和预测数据
historical_data['date'] = pd.to_datetime(historical_data['date'])
historical_data.set_index('date', inplace=True)
combined_data = pd.concat([historical_data['close'], prediction_data['close']])

# 绘制图表
plt.figure(figsize=(12, 6))
plt.plot(historical_data.index, historical_data['close'], label='历史数据')
plt.plot(prediction_data.index, prediction_data['close'], color='red', label='预测数据')
plt.title('中远海控股价历史数据和预测')
plt.xlabel('日期')
plt.ylabel('收盘价')
plt.legend()
plt.grid(True)

# 保存图表
file_name = f"output/{uuid.uuid4()}.png"
plt.savefig(file_name)
plt.close()
在这段代码中,我们将历史股价与预测股价合并,并绘制出两条曲线。historical_data 显示历史的收盘价曲线,prediction_data 则用红色表示未来 5 天的预测股价。图表保存为 PNG 格式,并保存在 output 文件夹中。
4. 统计数据与市场分析
绘制图表后,我们还可以计算一些统计数据,比如股价变化率,并生成简短的市场分析。我们使用 LLM(大语言模型)来生成对未来股价的分析和投资建议。
4.1 计算统计数据
# 计算一些统计数据
last_historical_price = historical_data['close'].iloc[-1]
first_prediction_price = prediction_data['close'].iloc[0]
prediction_change = (prediction_data['close'].iloc[-1] - first_prediction_price) / first_prediction_price * 100
这里我们计算了:
last_historical_price:最后一个历史数据点的收盘价。first_prediction_price:预测的第一天收盘价。prediction_change:预测期间股价的变化率。
4.2 使用 LLM 进行市场分析
# 使用LLM API进行分析
llm_client = llm_factory.get_instance()
prompt = f"根据以下数据分析中远海控未来5天的股价趋势:最后历史价格 {last_historical_price:.2f},预测5天后价格 {prediction_data['close'].iloc[-1]:.2f},预测期间变化率 {prediction_change:.2f}%。请给出简短的市场分析和投资建议。"
response = llm_client.one_chat(prompt)
在这段代码中,我们构建了一个包含历史和预测数据的提示词,并通过 llm_client 发送给 LLM 模型,请求对未来 5 天的股价趋势进行分析。
4.3 生成最终报告
# 准备返回值
results = []
results.append(f"")
results.append("主要发现:")
results.append(f"1. 最后一个历史数据点的收盘价为 {last_historical_price:.2f}")
results.append(f"2. 预测的第一天收盘价为 {first_prediction_price:.2f}")
results.append(f"3. 预测期间的价格变化率为 {prediction_change:.2f}%")
results.append(f"4. 预测显示未来5天的股价呈现{('上升' if prediction_change > 0 else '下降')}趋势")
results.append("5. LLM分析结果:")
results.append(response)
# 将结果保存到 analysis_result 变量
analysis_result = "\n".join(results)
最终,我们将所有的结果整合到 analysis_result 中,这包括:
- 图表文件的引用。
- 主要发现,包括历史收盘价、预测收盘价和价格变化率。
- LLM 生成的市场分析。
5. 总结
本项目演示了如何使用 Python 进行股票数据的获取、处理、预测与可视化。通过 akshare 获取数据,结合机器学习模型进行预测,再借助 matplotlib 绘制图表,最后生成简短的市场分析。
完整代码
import akshare as ak
import datetime
# 获取中远海控2024年的日线股票数据
# 中远海控的股票代码是 "601919.SH"
# 使用stock_zh_a_daily函数获取数据
# 获取今天的日期
today = datetime.date.today()
# 将日期转换成yyyyMMdd格式
end_date = today.strftime("%Y%m%d")
# 使用stock_zh_a_daily函数获取数据
cosco_daily_data_2024 = ak.stock_zh_a_daily(symbol=symbol, start_date="20240101", end_date=end_date)
# 直接打印返回的数据,不做任何处理
print(cosco_daily_data_2024)
import pandas as pd
import re
# 准备输入数据
input_data = cosco_daily_data_2024[['date', 'close']].set_index('date')
# 定义数据处理函数
def data_processor(data):
return data.asfreq('D').fillna(method='ffill').iloc[-30:] # 使用最近30天的数据
# 定义响应处理函数
def response_processor(response, num_of_predict):
# 使用正则表达式提取数字
numbers = re.findall(r'\d+\.\d+', response)
predictions = [float(num) for num in numbers[-num_of_predict:]]
return pd.Series(predictions, name='close', index=pd.date_range(start=input_data.index[-1] + pd.Timedelta(days=1), periods=num_of_predict))
# 使用llm_client进行预测
predictions = llm_client.predict(input_data, num_of_predict=5, data_processor=data_processor, response_processor=response_processor)
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import uuid
import os
from matplotlib import font_manager
# 确保output文件夹存在
os.makedirs('output', exist_ok=True)
# 设置中文字体
def configure_matplotlib_for_chinese():
import platform
system = platform.system()
if system == 'Windows':
font_name = 'SimHei'
elif system == 'Darwin':
font_name = 'STHeiti'
else: # For Linux
font_path = '/usr/share/fonts/truetype/wqy/wqy-zenhei.ttc'
if os.path.exists(font_path):
font_manager.fontManager.addfont(font_path)
font_name = font_manager.FontProperties(fname=font_path).get_name()
else:
raise FileNotFoundError(f"Font file not found: {font_path}")
# Set the font properties
plt.rcParams['font.sans-serif'] = [font_name]
plt.rcParams['font.family'] = 'sans-serif'
plt.rcParams['axes.unicode_minus'] = False
# 运行配置函数
configure_matplotlib_for_chinese()
# 访问之前步骤的数据
historical_data = cosco_daily_data_2024
prediction_data = predictions
# 合并历史数据和预测数据
historical_data['date'] = pd.to_datetime(historical_data['date'])
historical_data.set_index('date', inplace=True)
combined_data = pd.concat([historical_data['close'], prediction_data['close']])
# 绘制图表
plt.figure(figsize=(12, 6))
plt.plot(historical_data.index, historical_data['close'], label='历史数据')
plt.plot(prediction_data.index, prediction_data['close'], color='red', label='预测数据')
plt.title('中远海控股价历史数据和预测')
plt.xlabel('日期')
plt.ylabel('收盘价')
plt.legend()
plt.grid(True)
# 保存图表
file_name = f"output/{uuid.uuid4()}.png"
plt.savefig(file_name)
plt.close()
# 计算一些统计数据
last_historical_price = historical_data['close'].iloc[-1]
first_prediction_price = prediction_data['close'].iloc[0]
prediction_change = (prediction_data['close'].iloc[-1] - first_prediction_price) / first_prediction_price * 100
# 准备返回值
results = []
results.append(f"")
results.append("主要发现:")
results.append(f"1. 最后一个历史数据点的收盘价为 {last_historical_price:.2f}")
results.append(f"2. 预测的第一天收盘价为 {first_prediction_price:.2f}")
results.append(f"3. 预测期间的价格变化率为 {prediction_change:.2f}%")
results.append(f"4. 预测显示未来5天的股价呈现{('上升' if prediction_change > 0 else '下降')}趋势")
# 使用LLM API进行分析
llm_client = llm_factory.get_instance()
prompt = f"根据以下数据分析中远海控未来5天的股价趋势:最后历史价格 {last_historical_price:.2f},预测5天后价格 {prediction_data['close'].iloc[-1]:.2f},预测期间变化率 {prediction_change:.2f}%。请给出简短的市场分析和投资建议。"
response = llm_client.one_chat(prompt)
results.append("5. LLM分析结果:")
results.append(response)
# 将结果保存到analysis_result变量
analysis_result = "\n".join(results)
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

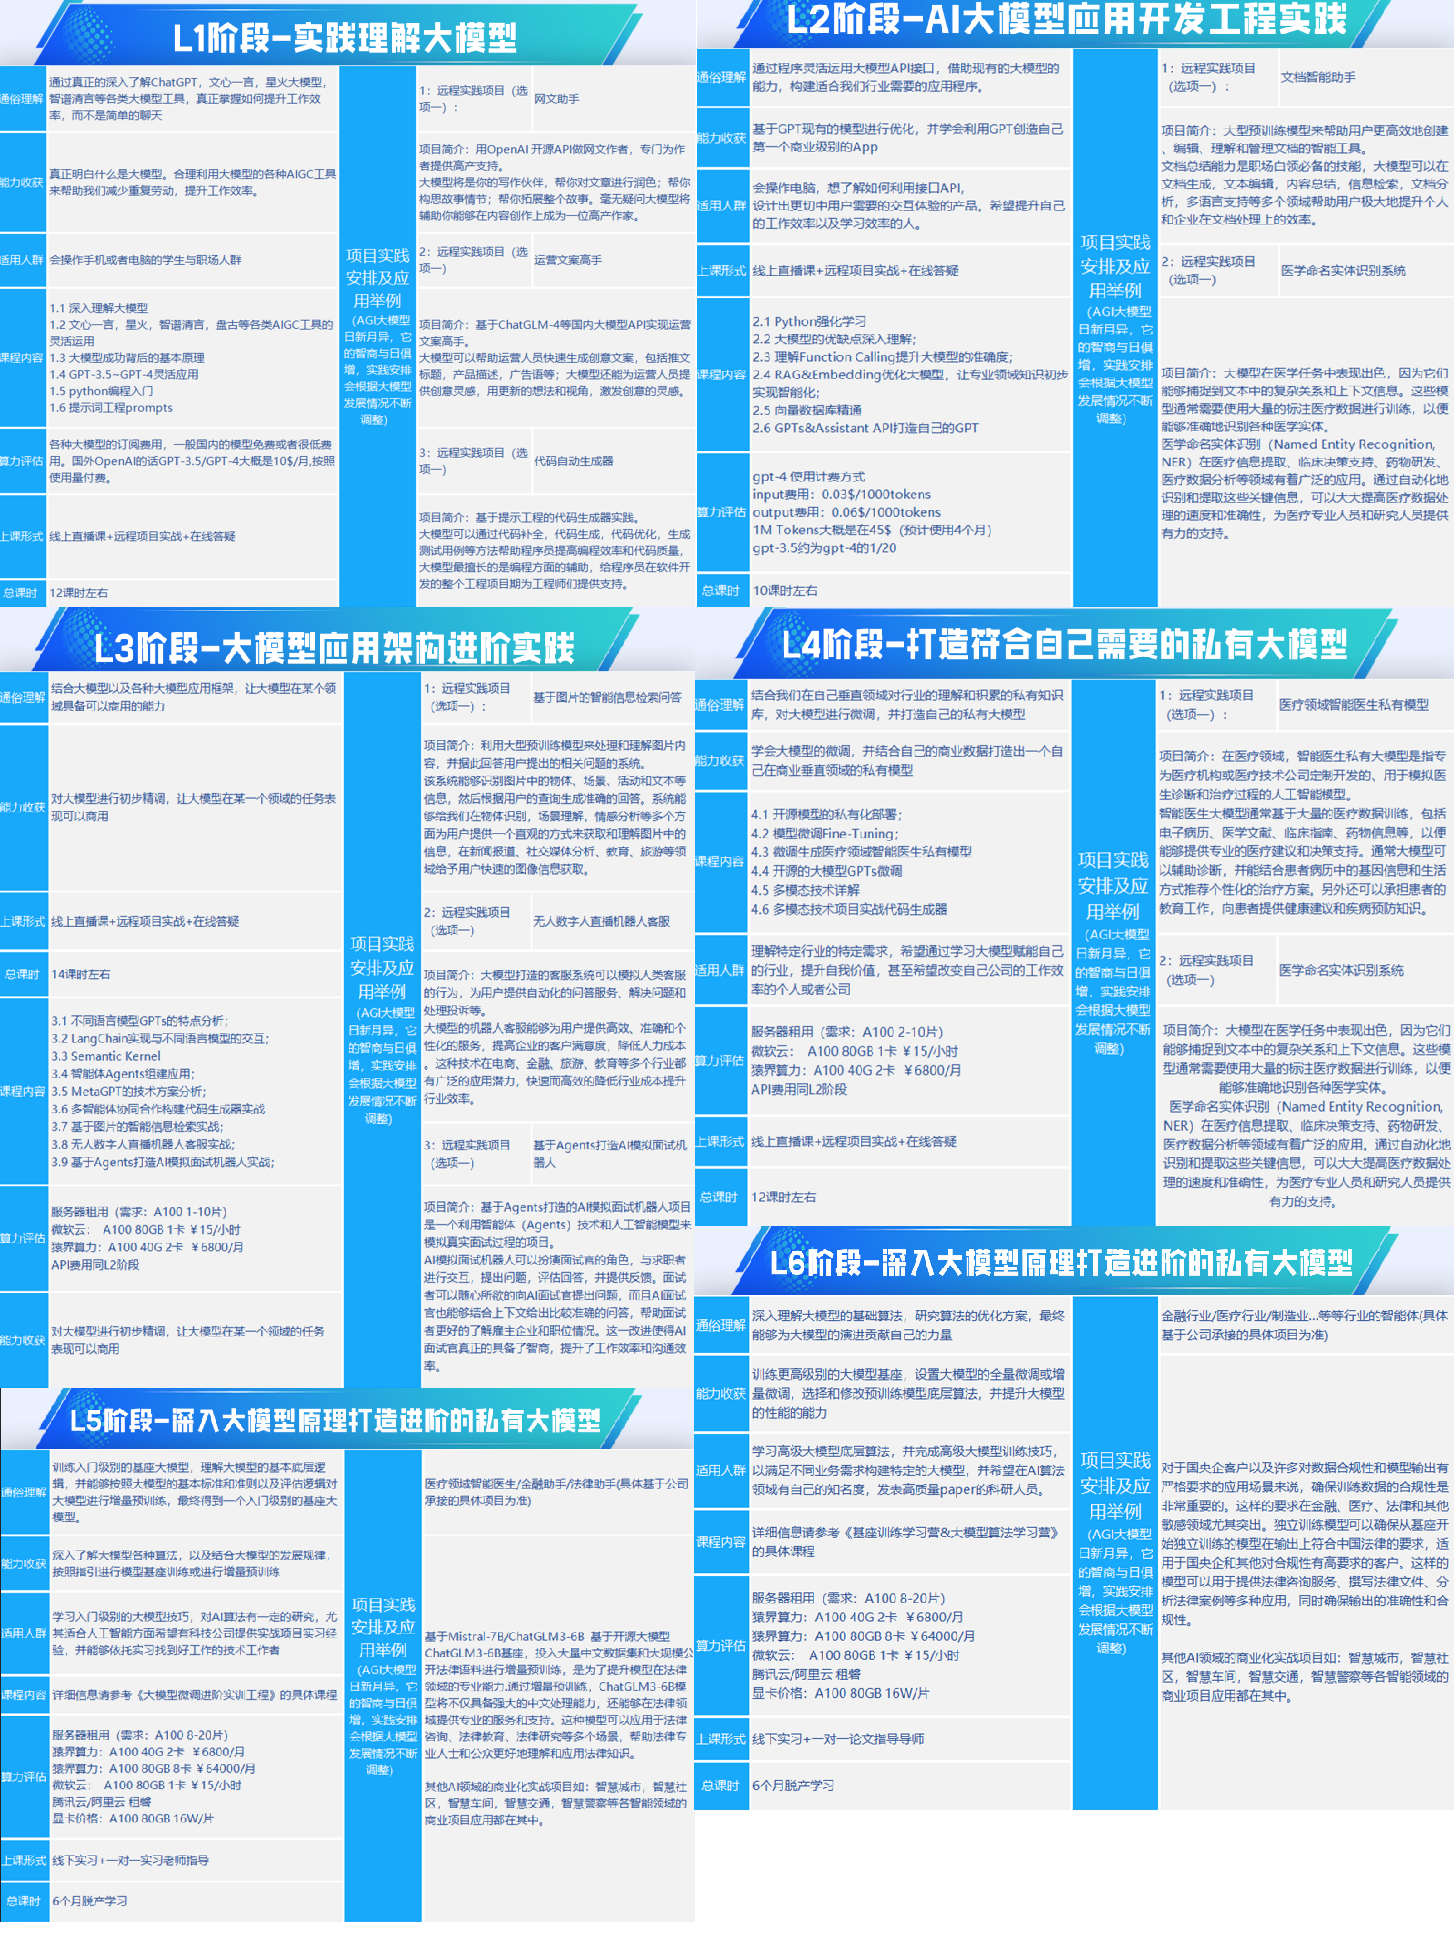
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
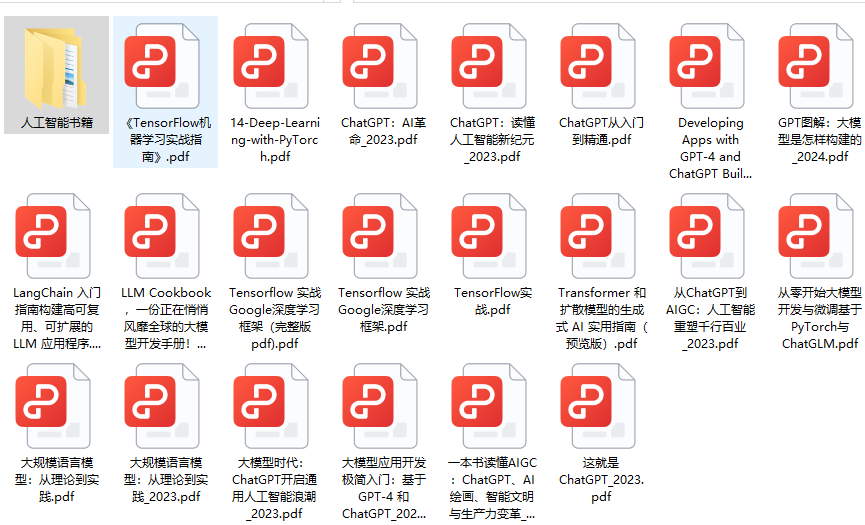
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


