小白必看!用多层汉堡轻松理解Transformer大模型架构(收藏版)

手把手实现Bigram语言模型:从概率计算到PyTorch实战 统计语言模型(SLM)是自然语言处理的基石,其核心是建模条件概率P(wₙ|w₁,…,wₙ₋₁),用于预测下一个词。Bigram模型作为最简形式,仅依赖前一个词,以可解释、低资源、高透明性成为NLP入门首选。它通过词频统计或可学习嵌入(Embedding)实现概率估计,在输入法、文本补全等场景中广泛支撑基础预测能力。本文聚焦Bigram的原理落地,结合PyTorch实现词嵌入+全连接架构,揭示P('is'|'this')等具体概率如何从数据中学习而来,并兼顾词汇表构建、OOV处理、训练稳定性等工程细节,为理解 阅读详情

本文以“多层汉堡”为比喻,深入浅出地解析了Transformer架构的核心原理。从输入层到输出层,详细介绍了注意力机制、残差连接、前馈网络(及MoE)的作用,并阐述了多层堆叠如何实现从词性到语义的逐层抽象。对比RNN和CNN,突出了Transformer在并行能力、长距离依赖、训练稳定性及扩展性上的优势。最后,文章还探讨了现代模型在注意力、位置信息、前馈、归一化等方面的优化升级,揭示了Transformer架构如何助力大模型实现“快、稳、深、大”。

基于前面的一篇文章继续思考,神经网络是多层的,主流架构是Transformer。虽然以前接触过这个概念,但还是很模糊,以至于我很好奇它究竟是什么。

我试着向AI请教,它给出了一个形象的比喻:Transformer就像一个多层汉堡。

每一层结构相同(注意力 + 前馈网络),但参数独立不同。从输入到输出一层层堆叠,中间用残差连接 + 一层归一化当酱料固定。

PS:前馈网络(FFN)由两个全连接层加一个激活函数组成,对每个词独立进行非线性变换,词与词之间没有信息交互。MoE(混合专家)就是在原来放FFN的位置,换成多个并行的"专家"加一个路由器,让数据只找最对口的专家处理——活更精、人更省。


01 输入:从文字到向量

用户输入一句话,模型先拆成token,每个token转成一个向量——相当于这个词在高维空间里的一个坐标点。

一开始,向量只代表孤立的词义。比如"苹果"既可以是水果,也可以是公司,模型还不知道该往哪个方向理解。于是,它需要上下文。

原始文本 → 分词器(Tokenizer) → token ID 序列 → 嵌入层(Embedding Layer) → 初始向量序列 →多层Transformer堆叠 → 上下文感知的向量序列


02 注意力机制:每个词注意所有词

每一层最开始,所有词同时相互"打量",看谁跟谁关系大。这个过程是并行的,不用排队等。

注:在GPT这类生成式模型中,每个词只能注意到它前面的词,不能“偷看”后面。

具体操作:

  • 每个词通过三个不同的权重矩阵,从输入向量映射出查询(Q)、键(K)、值(V)

  • 用Q和K匹配得到相关分数,归一化成权重

  • 用权重加权求和所有词的V

结果:每个词的新向量里,混进了整句话中跟它最相关的信息。

这就是注意力机制——它让每个词都能从整句话里按相关性加权汇总信息,相当于把分散但相关的词语“聚合”到当前词的表示中,而不是简单地做聚类。


03 残差连接:每一层都要传递

Transformer每个子层(注意力层、前馈网络)后面都有一个固定操作:把输入和输出加起来,再传给下一部分。这叫残差连接。

作用很简单,让每一层保留原始输入的部分信息,即使堆到上百层,前面的信息也不会丢失,训练也更稳定。


04 前馈网络:每个词都要思考

注意力层让词与词完成了"交流"。接下来,每个词需要自己消化这些信息,做非线性变换,提取更高层特征。

这就是前馈网络(FFN)的作用,通常由两个全连接层加一个激活函数(如ReLU或SwiGLU)组成。

在普通模型里这一步就是FFN。但在很多现代大模型(如DeepSeek、Mixtral)中,这里换成了混合专家模型(MoE)——设置一组专家网络,加一个路由机制,每个词只激活最合适的少数专家来处理。

MoE的思路:

  • 把原来一块"前馈肉饼"的位置,换成多个并排放着的小肉饼,每个叫一个"专家"

  • 每个专家是一个独立的小型FFN,它们擅长的模式并非人工指定,而是在训练过程中,由路由机制自动分配。模型会自然地把不同类型的词或模式分配给不同的专家处理。

  • 对每个词,路由器给所有专家打分,只挑分数最高的前几名(如前2个)来计算

  • 最后按路由分数加权求和,得到这一层的最终结果

好处是:总参数可以非常大,但每个词实际用到的参数很少,既保证效果,又控制成本。


05 多层堆叠:词性语义,层层抽象

上面说的"注意力 → 前馈/MoE"只是一个层。Transformer由几十甚至上百个这样的层堆叠而成。

每一层在做不同抽象层次的工作:

  • 底层:更关注局部搭配和词与词之间的邻近关系。比如“苹果”和“好吃”在位置上接近

  • 中层:开始形成短语级别的语义,比如“苹果很好吃”被理解为一个整体描述

  • 高层:学会逻辑、情感、全局意图。比如整句话是在表达喜好

汉堡包一层层往上,从字词理解走到句子理解,甚至段落理解。


06 用汉堡来概括整个架构

整个结构就像一个多层汉堡:

  • 最底下是输入层(原始向量)
  • 往上每一层都是两片肉饼:
  • 第一片:多头注意力(词与词交流)
  • 第二片:前馈网络或MoE(词自身思考)
  • 两片肉饼之间,用残差连接 + 层归一化当酱料固定
  • 一层做完再往上叠一层,结构相同,但每层参数不同

汉堡叠得越高,模型能学到的语义就越深。


07 为什么选Transformer架构?

为什么现在所有大模型都用这个"多层汉堡",而不是以前的架构?

用比喻来理解三种架构的区别:

  • RNN

    像按顺序看书,一行一行往下读,读到后面容易忘记前面,而且没法一目十行(难以并行)

  • CNN

    用在视觉模型上,像用滑动窗口看句子,一次只看一小部分,想看远距离关联就得加深层数来逐步扩大感受野(感受野:一个神经元(或一个输出)能看到原始输入的“范围”有多大。)

  • Transformer

    把整段文字摊开,每个词同时看所有词,通过注意力机制自动找出哪些词关系最紧密

RNN的短板:必须等上一步算完,串行导致慢,GPU使不上劲;难以做深,处理长句子时,早期信息经过层层传递后容易衰减或丢失(即梯度消失),导致模型记不住前面的内容。

CNN的短板:擅长捕捉局部模式,长距离依赖需要加深网络来间接扩大视野,不如Transformer直接。

Transformer的优势:

  • 并行能力:所有词同时算注意力,训练快

  • 长距离依赖:一层之内所有词直接相连,不管隔多远都能一步到位

  • 训练稳定性:残差连接+层归一化,信息在每一层都保留原始副本,可稳稳堆上百层

  • 扩展性:架构能大能深,配合MoE可做到万亿级参数

简单说,就是四个字:快、稳、深、大。


08 现代模型:在这个汉堡上做优化

现在的GPT、DeepSeek、LLaMA等主流模型,都长得像这个汉堡,但在细节上做了很多"食材升级":

  • 注意力

    标准多头注意力(MHA)每个头都需要缓存KV,显存开销大。现在流行的分组查询注意力(GQA)让多个头共享KV缓存,省显存、速度快

  • 位置信息

    原来加固定"位置编号"作为绝对位置编码,限制了长度外推能力。现在换成旋转位置编码(RoPE),通过旋转矩阵编码相对位置,能更好地外推至更长文本

  • 前馈

    有的换成MoE——把一块大肉饼换成多个并行小肉丁,每次只挑最合适的几粒炒;有的将激活函数换成SwiGLU,换了一种更香的调料配方

  • 归一化

    原来在每层做完后才抹酱(后置归一化),容易训练不稳。现在大多改成先抹酱再煎肉饼(前置归一化),并把酱料简化成RMSNorm,既稳当又清爽

这些升级有的为了省显存、有的为了跑更快、有的为了能读更长文章。但不管怎么换,多层汉堡的结构始终没变:依然是"注意力 + 前馈"两块肉饼,中间用残差和归一化当酱料,一层层摞起来。


09 总结思考

Transformer就是一个多层汉堡:

  • 神经网络是多层的
  • 每一层结构相同,但参数独立不同
  • 每一层都由注意力机制和前馈网络(或MoE)组成
  • 中间用残差连接 + 层归一化固定
  • 一层层堆叠,让理解从词性逐步抽象到语义

相比RNN和CNN,Transformer用注意力机制实现了彻底并行,用残差+归一化撑起了上百层深度,让大模型真正"大"了起来。

一个多层汉堡,每一层都夹着注意力与思考,再用残差把每一层的味道都留住。


从RNN按顺序一行行读,到Transformer基于注意力留意关键词之间的上下文、对不同关键词给予不同关注度,这是模型之间的演变过程。

我就在想:

这种过程很有意思,这种演变不只是技术上的,也像极了我们处理或者思考信息的一种方式。

从串行到并行、从局部到全局的思维演变。

看书的时候,如果按顺序一行行读,很容易读了后面忘了前面。但如果能"直接通过注意力"来读,先看清整体,再让关键概念之间彼此关联,根据不同重要性投入不同的关注度,理解就会深得多。

那么如何学习大模型 AI ?

对于刚入门大模型的小白,或是想转型/进阶的程序员来说,最头疼的就是找不到系统、全面的学习资源,要么零散不成体系,要么收费高昂,白白浪费时间走弯路。今天就给大家精心整理了一份全面且免费的AI大模型学习资源包,覆盖从入门到实战、从理论到面试的全流程,所有资料均已整理完毕,免费分享给各位!

核心包含:AI大模型全套系统化学习路线图(小白可直接照做)、精品学习书籍+电子文档、干货视频教程、可直接上手的实战项目+源码、2026大厂面试真题题库,一站式解决你的学习痛点,不用再到处搜集拼凑!

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

1、大模型系统化学习路线

学习大模型,方向比努力更重要!很多小白入门就陷入“盲目看视频、乱刷资料”的误区,最后越学越懵。这里给大家整理的这份学习路线,是结合2026年大模型行业趋势和新手学习规律设计的,最科学、最系统,从零基础到精通,每一步都有明确指引,帮你节省80%的无效学习时间,少走弯路、高效进阶。
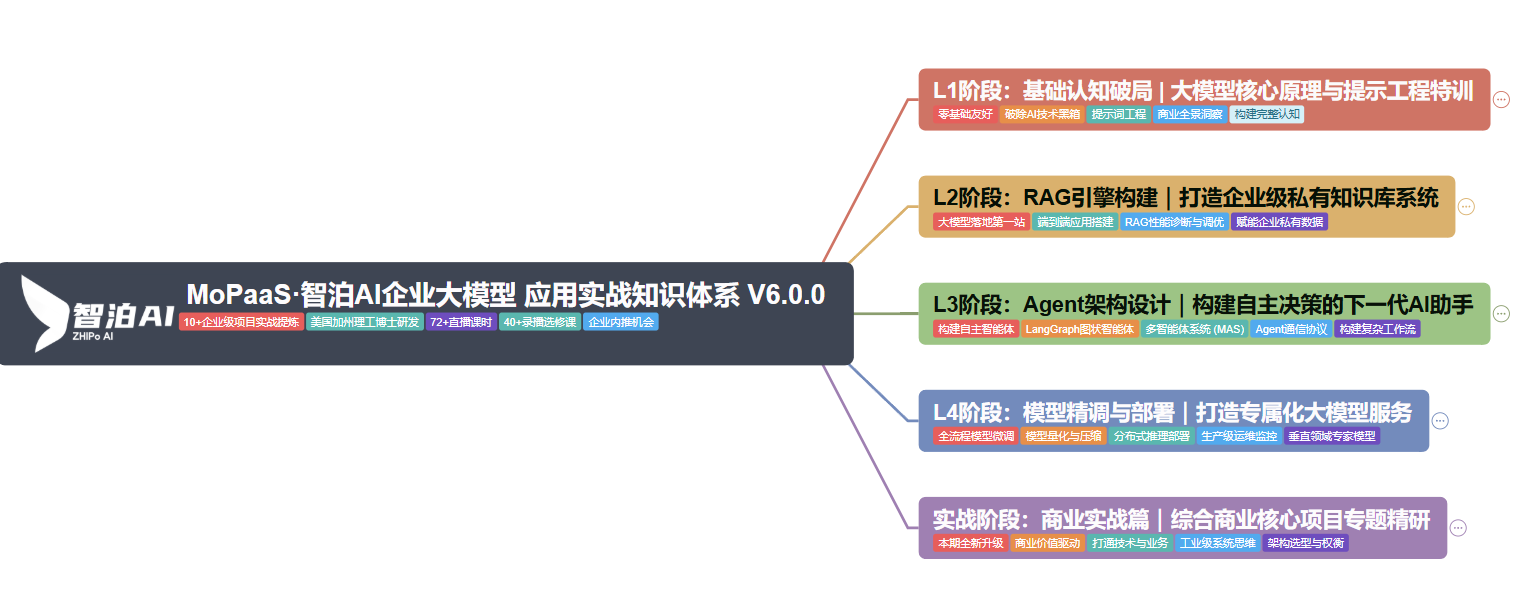
在这里插入图片描述

2、大模型学习书籍&文档

理论是实战的根基,尤其是对于程序员来说,想要真正吃透大模型原理,离不开优质的书籍和文档支撑。本次整理的书籍和电子文档,均由大模型领域顶尖专家、大厂技术大咖撰写,涵盖基础入门、核心原理、进阶技巧等内容,语言通俗易懂,既有理论深度,又贴合实战场景,小白能看懂,程序员能进阶,为后续实战和面试打下坚实基础。
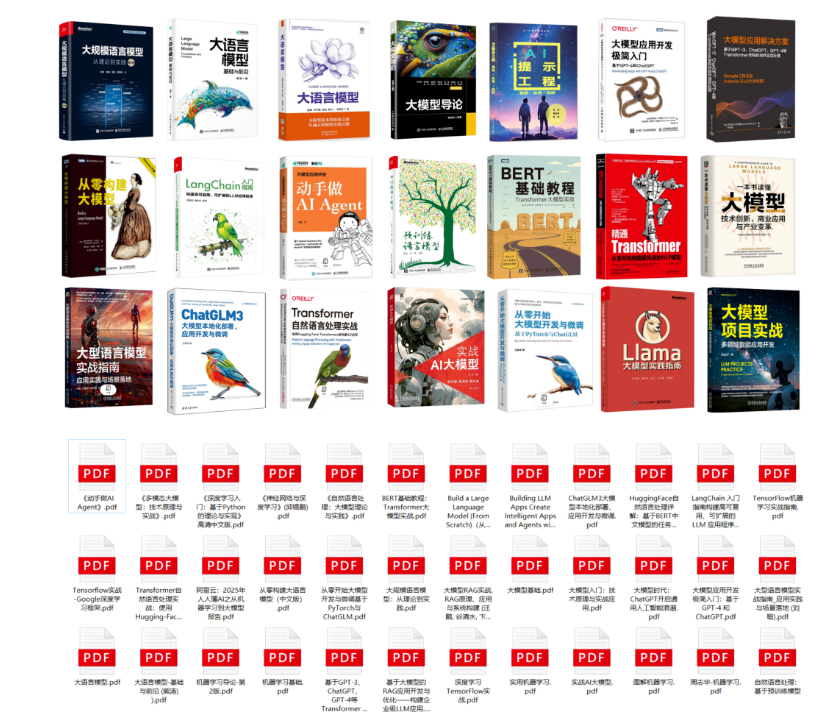
在这里插入图片描述

3、AI大模型最新行业报告

无论是小白了解行业、规划学习方向,还是程序员转型、拓展业务边界,都需要紧跟行业趋势。本次整理的2026最新大模型行业报告,针对互联网、金融、医疗、工业等多个主流行业,系统调研了大模型的应用现状、发展趋势、现存问题及潜在机会,帮你清晰了解哪些行业更适合大模型落地,哪些技术方向值得重点深耕,避免盲目学习,精准对接行业需求。值得一提的是,报告还包含了多模态、AI Agent等前沿方向的发展分析,助力大家把握技术风口。
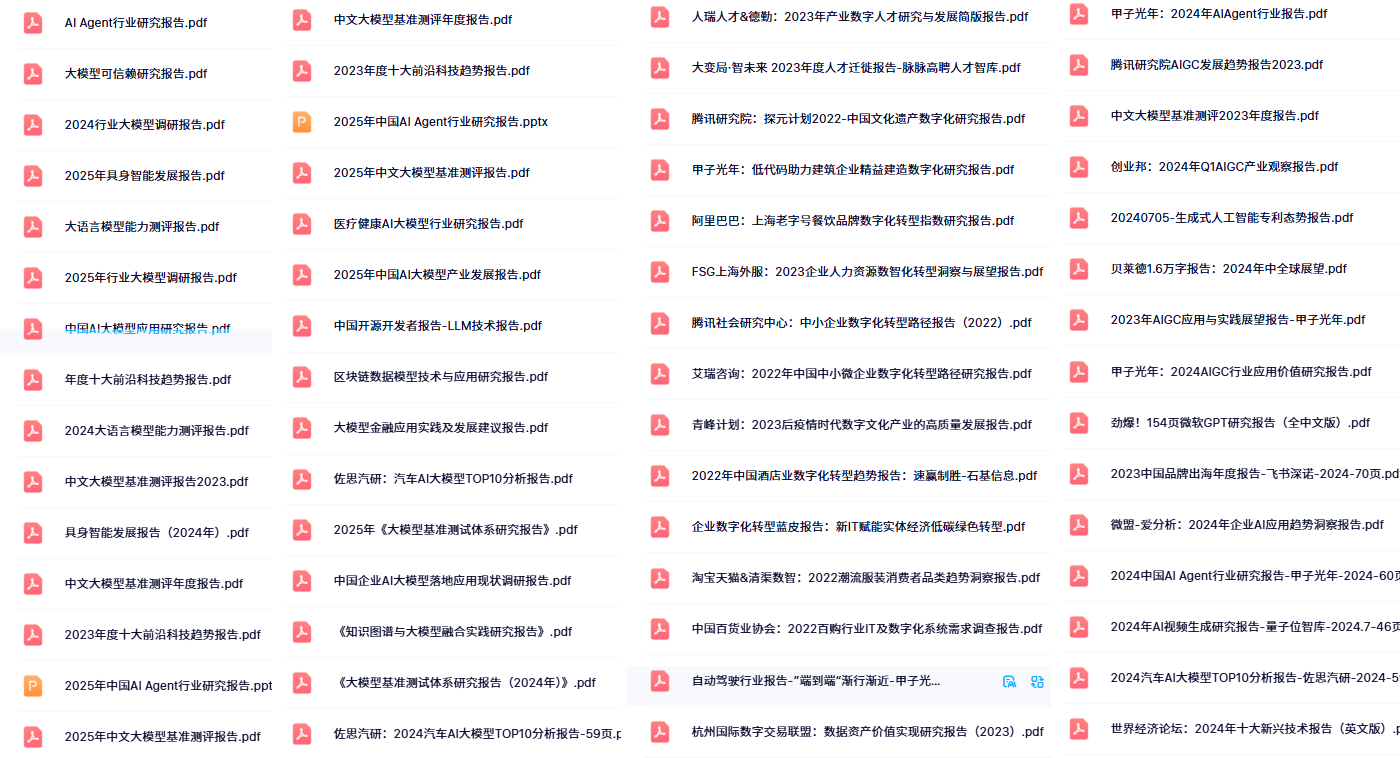
在这里插入图片描述

4、大模型项目实战&配套源码

对于程序员和想落地能力的小白来说,“光说不练假把式”,只有动手实战,才能真正巩固所学知识,将理论转化为实际能力。本次整理的实战项目,涵盖基础应用、进阶开发、多场景落地等类型,每个项目都附带完整源码和详细教程,从简单的ChatPDF搭建,到复杂的RAG系统开发、大模型部署,难度由浅入深,小白可逐步上手,程序员可直接参考优化,既能练手提升技术,又能丰富简历,为求职和职业发展加分。

img

5、大模型大厂面试真题

2026年大模型面试已从单纯考察原理,转向侧重技术落地和业务结合的综合考察,很多程序员和新手因为缺乏针对性准备,明明技术不错,却在面试中失利。为此,我精心整理了各大厂最新大模型面试真题题库,涵盖基础原理、Prompt工程、RAG系统、模型微调、部署优化等核心考点,不仅有真题,还附带详细解题思路和行业踩坑经验,帮你精准把握面试重点,提前做好准备,面试时从容应对、游刃有余。

img

6、四阶段精细化学习规划(附时间节点,可直接照做)

结合上述资源,给大家整理了一份可直接落地的四阶段学习规划,总时长约2个月,小白可循序渐进,程序员可根据自身基础调整节奏,高效掌握大模型核心能力,快速实现从“入门”到“能落地、能面试”的跨越。

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

3、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Donut模型实战:端到端收据信息提取与微调指南 文档智能是企业自动化处理非结构化票据的核心能力,其本质是视觉与语言的联合建模。传统OCR+规则方案受限于图像质量与格式碎片化,而Donut通过Document Image Tokenizer(DiT)和统一解码器,实现原始图像到结构化JSON的端到端映射,天然具备空间语义理解能力。该技术显著提升关键字段识别鲁棒性,尤其适用于超市小票、电子发票等真实噪声场景。结合轻量级微调策略与ONNX部署优化,可在单卡RTX 3090上完成全流程落地,兼顾精度(F1达94.1%)与工程可行性。本文聚焦Donut在收据信息抽 阅读详情

相关推荐

信创改造实战:SpringBoot项目迁移到宝兰德BES 9.5.5的完整避坑指南(附依赖与web.xml配置)

本文详细介绍了将SpringBoot项目迁移到宝兰德BES 9.5.5的完整流程,包括依赖改造、web.xml配置降级等关键步骤。通过实战案例和避坑指南,帮助开发者高效完成国产中间件适配,确保项目平稳运行。特别针对Tomcat依赖排除和BES适配器选择提供了专业建议。

weixin_30689307的博客 742

TripoSR模型架构深度解析:理解transformer在3D重建中的创新应用

TripoSR作为一款革命性的**3D重建模型**,通过巧妙融合transformer架构实现了从单张图片快速生成高质量三维模型的能力。这个**AI驱动的3D生成工具**在计算机视觉领域带来了突破性进展,让任何人都能轻松创建专业级的三维内容。 ## 🔍 为什么TripoSR在3D重建中如此重要? 传统的**3D重建技术**通常需要多角度拍摄、复杂的设备或专业的知识。而TripoSR通过**t

gitblog_00418的博客 1163

[原创]Linux 802.11n CSI tool安装教程(亲测可用)

Linux 802.11n CSI tool安装教程 前言 网上关于Intel5300 CSI tool的教程繁多,实际有效的可以说极少,各种疏漏错误。装的时候被坑无数次,终于调通。其实装这个工具并不太难,但是很多人把它弄得极其复杂,所以写这篇博客来帮助和我有一样困扰的人。我基本沿用的是官方文档旧版本的安装方案,针对其冗杂之处做了大量改进。 旧版安装教程: http://dhalperi....

u014645508的博客 4万+

别再死磕论文了!用labml-nn这个带注释的PyTorch库,5分钟看懂Transformer核心代码

本文介绍了如何使用labml-nn这个带注释的PyTorch库快速理解Transformer核心代码。通过逐行解释的代码注释、模块化实现和交互式可视化,开发者可以在5分钟内掌握Transformer的多头注意力机制和位置编码等关键组件,大幅提升学习效率。

746

EMC原理-传导(共模、差模)与辐射(近场、远场)详解

本文深入介绍了电磁兼容(EMC)的基本概念,包括EMI和EMS,以及如何处理传导干扰(共模、差模)和辐射干扰(近场、远场)。详细讨论了近场感应、远场辐射的原理,滤波器和屏蔽技术在抑制噪声信号中的作用。此外,探讨了差模和共模干扰的来源、影响及滤除方法,如使用差模电感、电容和共模线圈。最后,提到了穿心电容在滤除高频噪声中的应用。

让你爱上电路设计 3554

基于FPGA设计的信号分析仪(项目资料ID:28)

基于现场可编程门阵列(FPGA)设计的信号分析仪。该信号分析仪旨在实现对各类信号的精确分析,具备频率、幅度、相位等参数测量功能。通过采用 FPGA 作为核心处理单元,充分利用其并行处理能力和可重构特性,提高了系统的处理速度和灵活性。论文介绍了信号分析仪的总体设计方案,包括硬件电路设计和软件算法实现。

以培养嵌入式工程师为己任 1万+

收藏|2026 年版【小白兔解 LLM】Transformer 位置编码 小白必看懂

位置编码不是简单的1, 2, 3编号。它是在没有任何时序结构的数学框架下,强行注入了“时间”和“空间”的维度。没有位置编码:Transformer 是一个处理集合的工具。有了位置编码:Transformer 变成了一个处理序列的利器。我一直在感慨,Transformer 的精妙之处就在于,它把所有感性的语言问题,都转化成了理性的几何问题。词是向量,语法是权重,顺序是旋转,牛逼。

大模型教程的博客 407

6、哈代空间、算子函数及相关概念解析

本文深入探讨了数学中哈代空间与算子函数的核心概念,包括强函数的因式分解、半单零点的定义与性质、Blaschke-Potapov乘积的存在性、Nagy-Foias模型算子的结构与谱分析、可数集合的相关性质(如Carlesonian集合、稀有集合等)、简单分式族的可分性与基性质,以及指数型整函数的增长特性。文章还分析了这些数学对象之间的内在联系,并通过图表与表格形式直观呈现了集合性质与函数空间结构的关系。这些理论不仅在数学分析和泛函分析中具有重要意义,也在信号处理、量子力学等应用领域具有广泛价值。

yhn4567890的博客 170

深度解析Moondream:轻量级视觉语言模型的技术架构与实践应用

在边缘计算和本地化AI部署日益重要的今天,Moondream作为一款超轻量级视觉语言模型,以其仅2B参数的紧凑架构和强大的图像理解能力,为开发者提供了在资源受限环境中部署先进视觉AI的解决方案。这款开源项目通过精巧的模块化设计,实现了视觉编码、文本生成和区域识别的无缝集成,让本地化视觉智能触手可及。 ## 核心关键词与长尾关键词 **核心关键词**:轻量级视觉语言模型、Moondream架构、

gitblog_00689的博客 345

用一组可复现实验讲清 ABAP 内表 Standard / Sorted / Hashed 的性能差异

摘要(150字): SAP项目中性能问题常源于ABAP内表选型不当。标准表(STANDARD TABLE)写入快但查找慢(线性扫描),适合遍历场景;排序表(SORTED TABLE)保持有序,支持二分查找,适合范围查询;哈希表(HASHED TABLE)基于唯一键实现常数级查找,适合高频精确匹配。实验表明:标准表+BINARY SEARCH需预排序,成本可能高于直接使用排序表;哈希表在键匹配时性能最优。Gateway和RAP场景中,内表选型直接影响接口响应,建议根据读写负载(追加/遍历/精确查找)选择对应类

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 203

SpringBoot + MyBatis-Plus 高效实现数据变更记录:从注解到通用审计方案(附源码)

*** 数据变更审计插件* 拦截增删改操作,自动记录变更日志*/@Component@Resource/*** 拦截SQL执行*/@Override/*** 数据变更审计插件* 拦截增删改操作,自动记录变更日志/*** 拦截SQL执行。

2601_94871597的博客 561

从一张图片到三维世界:TripoSR如何用AI重塑3D内容创作

想象一下,你拍了一张普通的照片——也许是你最爱的茶壶、一个可爱的机器人玩具,或者一张独角兽的插画。然后,在几秒钟内,这张平面图像就变成了一个完整的3D模型,可以在虚拟空间中旋转、缩放,甚至用于3D打印或游戏开发。这不是科幻电影中的场景,而是TripoSR带给我们的现实。 TripoSR是一个革命性的开源AI工具,它能够从单张2D图像快速生成高质量的3D模型。这个由Tripo AI和Stabili

gitblog_00329的博客 374

工业级C#+YOLOv8缺陷检测系统:准确率98.5%、延迟<50ms的完整实现

本文分享了基于C#和YOLOv8的工业级表面缺陷检测系统实现方案。针对汽车零部件冲压件检测需求(60件/分钟,准确率>98%,延迟<100ms),作者对比了多种技术方案后选择了C#+YOLOv8+ONNX Runtime的组合,最终实现98.5%准确率和42ms延迟。 系统采用分层模块化架构,包含硬件层、采集层、推理层、业务层和控制层。核心优势包括:1)C#在工业环境下的稳定性和集成便利性;2)YOLOv8对复杂缺陷的泛化能力;3)ONNX Runtime GPU加速提升性能。文章详细介绍了硬件

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1141

ViT图像分类-中文-日常物品识别成果展示:覆盖衣食住行全品类样例

本文介绍了如何在星图GPU平台上自动化部署ViT图像分类-中文-日常物品镜像,快速搭建中文图像识别服务。该模型能精准识别衣食住行等日常物品,并直接输出中文标签,可广泛应用于智能相册自动分类、电商产品图片审核等场景,为应用便捷添加视觉理解能力。

CrystalwaveHawk54的博客 855

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

如何用0.5秒将2D照片变成3D模型?TripoSR单图重建技术全解析

想象一下这样的场景:你刚刚设计了一个精美的汉堡🍔,想为它创建3D模型用于电商展示;或者你拍摄了一张独角兽🦄的照片,希望将它变成游戏角色;又或者你手头只有一张产品图片,却需要快速生成3D原型进行3D打印。传统3D建模可能需要数小时甚至数天时间,而今天我要介绍的TripoSR,只需要0.5秒就能完成这一切! TripoSR是由Tripo AI与Stability AI联合开发的开源3D重建模型,

gitblog_01116的博客 383

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

如何在5分钟内用DiT扩散模型生成高质量图像:终极实践指南

你是否想过用最新的Transformer架构生成媲美真实照片的图像?DiT(Diffusion Transformer)正是这样一个革命性的开源项目,它将扩散模型与Transformer架构完美结合,让你能够在ImageNet数据集上生成256x256和512x512分辨率的惊艳图像。无论是技术爱好者还是中级开发者,本文都将带你快速上手这个前沿的AI图像生成工具。 ## 核心功能展示:DiT的惊

gitblog_00703的博客 457

AI专题:春节期间全球AI发展要点梳理

今天分享的是深度研究报告:《页。

weixin_54883418的博客 958

Qwen-Image能否用于生成科普插画?科学准确性验证

本文探讨Qwen-Image在科普插画生成中的科学准确性,分析其基于MMDiT架构的图文理解能力、对复杂生物概念的表现力,以及在人机协同流程中如何提升效率,并指出需结合提示词优化、微调与专家审核以确保内容正确。

weixin_32747681的博客 679

最轻巧的AI视觉助手:Moondream本地部署全攻略

你是否曾因大型AI模型的硬件门槛望而却步?是否想在自己的电脑上体验图像理解的乐趣?本文将带你零门槛部署Moondream——这款仅需普通电脑就能流畅运行的视觉语言模型(Vision Language Model,VLM),让AI看懂图片不再依赖云端算力。读完本文,你将掌握从环境配置到实际应用的完整流程,轻松实现图片描述、视觉问答等功能。 ## 项目概述:小而美的AI视觉解决方案 Moondre...

gitblog_00361的博客 508

ViT图像分类-中文-日常物品:社交平台内容审核利器

本文介绍了如何在星图GPU平台上自动化部署ViT图像分类-中文-日常物品镜像,并将其应用于社交平台内容审核。该模型能快速、准确地识别图片中的日常物品,例如自动检测并标记包含香烟、酒瓶等违禁品的图片,从而大幅提升审核效率与准确性。

weixin_42433737的博客 96

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2964

SignAgent:基于大语言模型智能体的手语数据自动化标注系统

在人工智能与多模态计算领域,数据标注是模型训练的基础环节,其质量直接影响最终性能。传统视频动作标注依赖人工逐帧处理,效率低且成本高昂。通过引入智能体(Agent)架构与大语言模型(LLMs)的规划与推理能力,系统能够主动协调视觉感知、关键点提取与语言学知识库,实现从原始视频到结构化标注的自动化流水线。这种技术路径不仅大幅提升了标注效率,更通过语言学接地(Linguistically-Grounded)确保了标注结果的专业性与可用性,为手语识别、虚拟人驱动、无障碍通信等应用场景提供了高质量的数据基石。Sign

weixin_34209851的博客 373

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 381

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 300

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 230

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 266
上一篇: 收藏!AI时代程序员的新出路:你不可替代的3大能力!
下一篇: 3个问题快速检测你的AI应用能力,小白程序员必备(收藏版)
冻感糕人~
博客等级 码龄3年 8926粉丝 2393原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
