


本文深入解析 Agent Memory 模块的设计要点,从认知科学的三种记忆类型(语义、情节、程序性)出发,结合短期记忆和长期记忆的双层架构,详细阐述了记忆的提取、写入、管理和检索流程。特别介绍了 Mem0 框架的四种记忆操作(ADD、UPDATE、DELETE、NOOP)以及记忆冲突的处理机制。文章最后总结了记忆系统设计的三个维度,帮助读者全面掌握 Agent Memory 模块的设计思路,提升面试竞争力。
前段时间一位读者在后台私信我,说去字节面试,聊到了他做的 Agent 项目。
面试官问:“你的 Agent 有没有记忆能力?”
他说:“有,用户上周问过的问题这周还记得。”
面试官接着问:“那这个记忆存在哪?”
他说:“存在向量数据库里。”
面试官继续追:“向量数据库里有多少条记忆?怎么检索出来的?全量检索还是按用户过滤?”
他说:“用语义相似度检索,取 Top5。”
面试官没停:“那如果用户上周说他有两个孩子,这周又说他有三个孩子,你怎么处理?追加一条还是更新原来那条?系统怎么判断的?”
他当场卡住了,答不上来。
面试官最后说了一句话,点到了根上:“你知道怎么查记忆,但你不知道怎么管记忆。记忆管理才是 Agent 可用不可用的分水岭。”
这篇文章,我们就来系统讲清楚 Agent 的 Memory 模块该怎么设计。
为什么 Agent 需要 Memory?
先说一个具体的背景。
我们在做的项目是银行对公客户智能咨询助手"拓业智询",服务的对象是企业客户,咨询的内容涉及理财产品、贷款方案、汇率避险等专业金融问题。
这类客户有个特点:需求复杂,决策周期长,一个项目要咨询好几次。客户经理要记住每位客户的偏好、资质、历史问题——这是基本功。但如果 AI 每次都"失忆",客户每次都要重新介绍自己,体验极差。
我们做了一组对比测量:
- 没有 Memory 模块:用户第二次咨询时要重新介绍需求,平均多说 3-4 轮对话才能进入正题
- 有 Memory 模块:系统识别到回头用户后,直接基于历史偏好给出回答,满意度提升 23%,平均对话轮次减少 2.1 轮
这组数据说明,Memory 不是锦上添花,是 Agent 落地的基础能力。
那 Memory 到底是什么?它不是把所有对话记录存起来,而是一套结构化的信息管理体系——哪些信息值得记,怎么存,怎么取,怎么更新,怎么删。
要回答这些问题,先得搞清楚 Agent 的记忆到底有哪几种,每种记忆的性质不同,对应的存储和检索策略也完全不一样。
认知科学视角:三种记忆类型
在设计 Agent Memory 之前,我们先从认知科学借一个框架。人类的记忆分为三种类型,Agent 的记忆设计也可以完全对照这套体系来做。
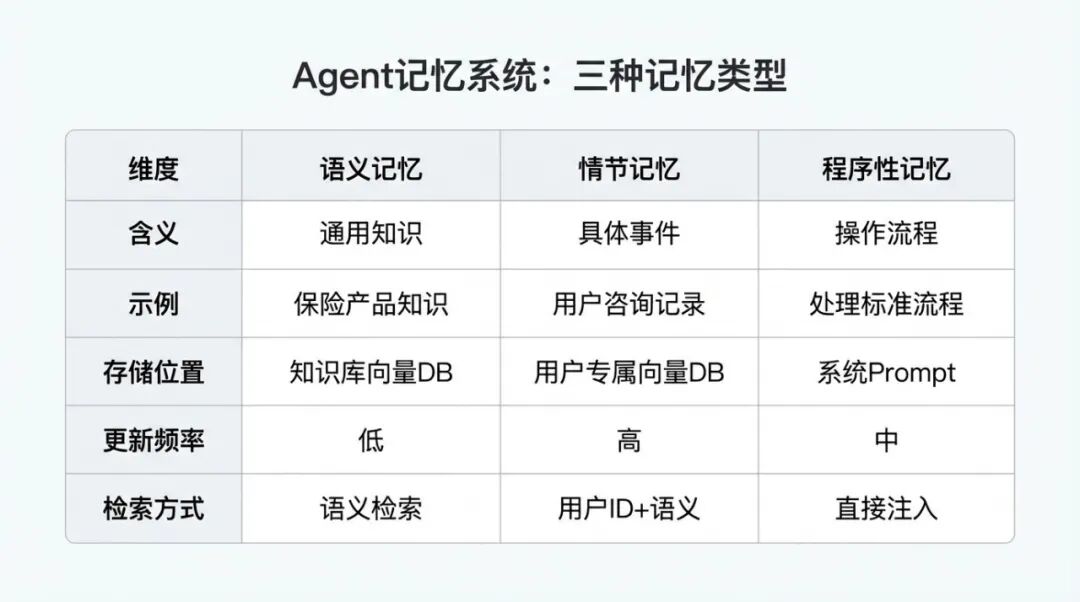
Agent记忆系统三种类型
语义记忆(Semantic Memory)
语义记忆是关于世界的通用知识,不依附于特定时间和人物。
在"拓业智询"里,语义记忆包括:
- 各类金融产品的说明和条款
- 监管政策、利率基准、汇率规则
- 常见业务问答,如"对公账户开户需要哪些材料"
这类信息的特点是长期稳定,更新频率低,对所有用户共享。存储方式是传统的知识库向量数据库,按内容语义检索。
示例:"平安银行对公理财产品的起购金额为100万元,最短持有期30天。"
这条信息对所有咨询用户都适用,存在共享向量库里,任何用户问到都可以检索到。
情节记忆(Episodic Memory)
情节记忆是具体事件的记录,与时间、人物绑定。
在项目里,情节记忆包括:
- 用户张三在 2024 年 3 月询问过重疾险的保障范围
- 用户李四的企业注册资本 5000 万,属于中型企业客户
- 用户王五明确表示不接受股票类高风险产品
- 用户赵六上次咨询时提到公司准备做跨境业务
这类信息是每个用户独有的,与用户 ID 强绑定,更新频率高。存储时必须按用户 ID 隔离,检索时先过滤用户再做语义匹配。
这是 Agent 产生"认识你"感知的核心来源。
程序性记忆(Procedural Memory)
程序性记忆是操作流程和行为规则,对应的是"怎么做"而不是"知道什么"。
在项目里,程序性记忆包括:
- 处理理赔咨询时,先查保单状态,再查对应条款
- 涉及高净值客户时,优先推荐私行产品线
- 客户首次咨询时,先确认企业性质和注册地
这类信息不需要检索,直接固化为系统 Prompt,在每次对话开始时注入。更新方式是修改系统 Prompt 而不是检索时注入。
这三种记忆类型对应完全不同的存储和检索策略,混在一起处理是很多初学者踩的第一个坑。
分清楚了记忆的内容分类,接下来要解决的是时效性问题——同样是情节记忆,当前对话里刚说的话和三个月前记录的偏好,处理方式是完全不同的。这就引出了短期记忆和长期记忆的双层架构。
短期记忆与长期记忆的双层架构
三种类型是对记忆内容的分类,接下来说的是对记忆时效的分类——短期记忆和长期记忆。
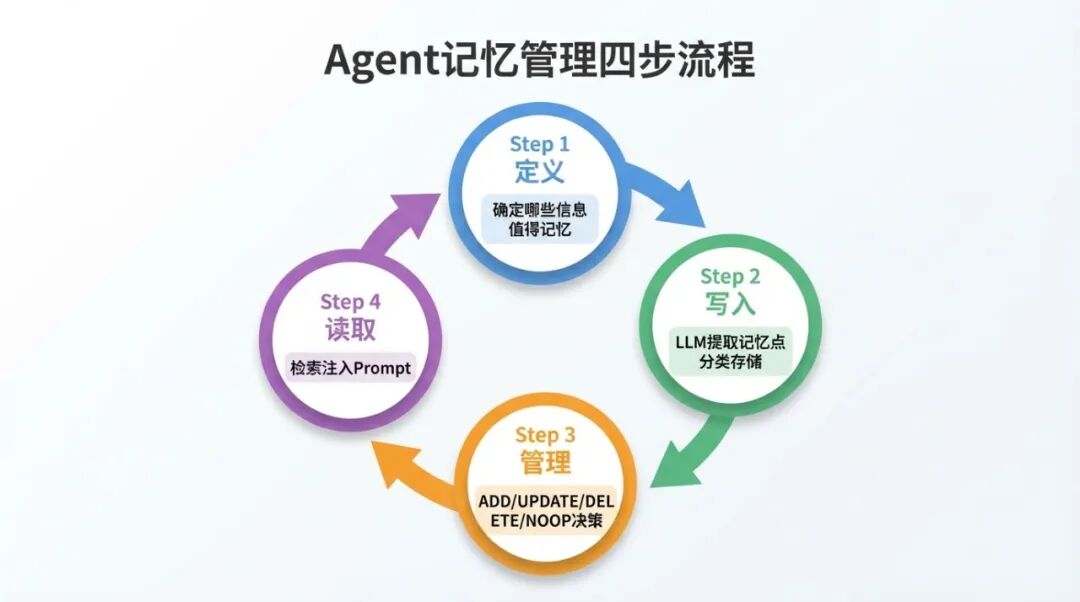
Agent记忆管理四步流程
短期记忆:对话上下文窗口
短期记忆就是当前对话的消息历史,存在 LLM 的上下文窗口里。
实现上用滑动窗口管理,保留最近 N 轮对话:
class ShortTermMemory: def __init__(self, window_size: int = 10): self.window_size = window_size self.messages = [] def add_message(self, role: str, content: str): self.messages.append({"role": role, "content": content}) # 超出窗口大小则移除最早的消息 if len(self.messages) > self.window_size * 2: # 每轮包含user+assistant两条 self.messages = self.messages[-self.window_size * 2:] def get_context(self) -> list: return self.messages
短期记忆的局限很明显:对话结束后就消失了,下次会话无法访问。这就是长期记忆存在的原因。
长期记忆:向量数据库分区存储
长期记忆存在向量数据库里,在"拓业智询"里我们用 Milvus。
存储结构上,按记忆类型和用户 ID 分区:
# Milvus集合设计 schema = { "collection_name": "agent_memory", "fields": [ {"name": "memory_id", "type": "VARCHAR", "max_length": 64}, {"name": "user_id", "type": "VARCHAR", "max_length": 64}, {"name": "memory_type", "type": "VARCHAR", "max_length": 32}, # semantic/episodic {"name": "content", "type": "VARCHAR", "max_length": 2048}, {"name": "embedding", "type": "FLOAT_VECTOR", "dim": 1536}, {"name": "created_at", "type": "INT64"}, # Unix timestamp {"name": "ttl", "type": "INT64"}, # 过期时间,-1表示永久 {"name": "is_deleted", "type": "BOOL"} # 软删除标记 ] }
语义记忆分区:user_id 字段为空或固定值 "global",对所有用户共享 情节记忆分区:user_id 字段绑定具体用户,检索时必须带 user_id 过滤条件
这个分区设计解决了两个问题:隔离性(用户 A 不会检索到用户 B 的记忆)和性能(先按 user_id 过滤再做向量检索,检索范围大幅缩小)。
对话结束时的记忆提取
一次对话结束后,系统需要从对话内容里提取值得长期保存的记忆点:
MEMORY_EXTRACTION_PROMPT = """ 你是一个记忆提取助手。请从以下对话中提取值得长期记忆的信息。 只提取以下类型的信息: 1. 用户明确表达的偏好(如风险偏好、产品偏好) 2. 用户的基本信息(企业规模、行业、注册地等) 3. 用户的重要决策或需求变化 4. 对未来咨询有参考价值的关键事件 不要提取:普通的问答内容、系统的标准回复、临时性的闲聊 对话内容: {conversation} 请以JSON格式输出,每条记忆包含:content(内容)、memory_type(episodic/semantic) """ async def extract_memories(conversation: list, user_id: str) -> list: prompt = MEMORY_EXTRACTION_PROMPT.format( conversation="\n".join([f"{m['role']}: {m['content']}" for m in conversation]) ) response = await llm.ainvoke(prompt) memories = json.loads(response.content) return memories
这个提取步骤是 Memory 系统的入口,提取质量直接决定长期记忆的有效性。
有了提取结果,下一个问题是:新提取出来的记忆怎么写入?如果每次都无脑追加,时间一长记忆库里就会充满相互矛盾的信息,这正是 Mem0 框架要解决的核心问题。
Mem0 框架:四种记忆操作
提取出来的记忆怎么写入?这里就要谈到记忆管理的核心问题——当新信息到来时,系统应该做什么操作?
Mem0 是目前最成熟的 Agent Memory 开源框架,它把记忆操作抽象为四种:ADD、UPDATE、DELETE、NOOP。
# Mem0的记忆管理接口 from mem0 import Memory memory = Memory() # ADD:新增记忆(全新信息,之前没有记录过) memory.add("用户偏好低风险产品,不接受股票类投资", user_id="user_001") # UPDATE:更新记忆(信息发生了变化) memory.update(memory_id="mem_xxx", data="用户已升级为VIP客户,授信额度从50万提升到200万") # DELETE:删除记忆(信息已过期或不再有效) memory.delete(memory_id="mem_xxx") # 如用户注销账户后 # NOOP:不操作(信息已存在,内容一致,无需重复写入) # 系统自动判断,不需要手动调用
这四种操作看起来简单,但背后的判断逻辑是整个 Memory 系统最有技术含量的地方。
Mem0 的核心机制是:每次写入新记忆前,先用 LLM 比较新信息和现有记忆的语义关系,然后决定做哪种操作。
MEMORY_DECISION_PROMPT = """ 你是一个记忆管理助手。请判断以下新信息与现有记忆的关系,并决定操作类型。 新信息:{new_info} 现有记忆(相关度最高的5条): {existing_memories} 请判断: - ADD:新信息是全新的,现有记忆中没有相关内容 - UPDATE:新信息是对某条现有记忆的更新(同一实体,信息变化了) - DELETE:新信息表明某条现有记忆已经失效 - NOOP:新信息与现有记忆完全一致,无需操作 输出JSON格式:{{"action": "ADD/UPDATE/DELETE/NOOP", "target_memory_id": "如果是UPDATE/DELETE则填写目标记忆ID", "reason": "判断理由"}} """
这套判断逻辑在测试环境下运转流畅,但在实际业务中会遇到更复杂的情况——用户的信息前后矛盾了,该更新还是保留?这就是记忆冲突问题,也是面试官最喜欢深挖的地方。
面试官追问的核心:记忆冲突怎么处理?
回到文章开头的面试场景,那个让读者答不上来的问题:用户上周说有两个孩子,这周说有三个孩子,怎么处理?
这是记忆冲突问题,也是 Memory 系统工程挑战里最难的一个。
方案一:语义去重判断
用 LLM 比较新旧信息的语义相似度,相似度超过阈值则判断为同一实体的更新:
async def check_memory_conflict( new_memory: str, existing_memories: list, similarity_threshold: float = 0.85 ) -> dict: """ 检查新记忆是否与现有记忆冲突 返回:{"action": "ADD/UPDATE", "conflict_memory_id": str or None} """ if not existing_memories: return {"action": "ADD", "conflict_memory_id": None} # 对每条现有记忆计算语义相似度 new_embedding = await embedder.aembed_query(new_memory) for mem in existing_memories: similarity = cosine_similarity(new_embedding, mem["embedding"]) if similarity > similarity_threshold: # 相似度高,判断为同一实体——需要更新而不是追加 # 进一步用LLM确认是否真的是更新 is_update = await llm_confirm_update(new_memory, mem["content"]) if is_update: return {"action": "UPDATE", "conflict_memory_id": mem["memory_id"]} return {"action": "ADD", "conflict_memory_id": None}
"用户有两个孩子"和"用户有三个孩子"的语义相似度会很高(都是关于孩子数量的描述),系统判断为 UPDATE 操作,用新信息替换旧信息,而不是同时保留两条相互矛盾的记录。
方案二:记忆过期与 TTL 管理
有些记忆天然有时效性,过了有效期就应该删除而不是保留。
# 写入带TTL的记忆 def add_memory_with_ttl( content: str, user_id: str, ttl_days: int = -1 # -1表示永久,>0表示有效天数 ): ttl_timestamp = -1 if ttl_days > 0: ttl_timestamp = int(time.time()) + ttl_days * 86400 memory_record = { "memory_id": str(uuid.uuid4()), "user_id": user_id, "content": content, "created_at": int(time.time()), "ttl": ttl_timestamp, "is_deleted": False } milvus_client.insert("agent_memory", memory_record) # 示例:本月预算信息,有效期30天 add_memory_with_ttl( content="用户本月可用于理财的预算为5万元", user_id="user_001", ttl_days=30 ) # 定时清理任务(每天运行) async def cleanup_expired_memories(): current_time = int(time.time()) expired = milvus_client.query( collection_name="agent_memory", filter=f"ttl > 0 && ttl < {current_time} && is_deleted == false" ) for mem in expired: milvus_client.update( collection_name="agent_memory", filter=f"memory_id == '{mem['memory_id']}'", data={"is_deleted": True} )
"用户本月预算是 5 万"这类信息,30 天后就过期了,继续保留反而会干扰后续回答。TTL 机制让系统自动完成清理,不需要人工干预。
方案三:隐私合规与"被遗忘权"
金融行业有严格的数据合规要求,用户有权要求删除自己的所有数据,这就是 GDPR 和国内个人信息保护法里的"被遗忘权"。
工程上的实现方式是软删除配合审计日志:
async def forget_user(user_id: str, operator: str, reason: str): """ 软删除用户的所有记忆,保留审计日志 """ # 1. 标记所有记忆为已删除 milvus_client.update( collection_name="agent_memory", filter=f"user_id == '{user_id}' && is_deleted == false", data={"is_deleted": True} ) # 2. 写入审计日志(审计日志不删除,用于合规审查) audit_log = { "operation": "USER_FORGET", "user_id": user_id, # 保留user_id用于审计 "operator": operator, "reason": reason, "timestamp": int(time.time()), "memory_count": deleted_count } audit_db.insert(audit_log) return {"status": "success", "message": f"已删除用户{user_id}的所有记忆数据"}
注意:审计日志本身不删除,这是合规要求——监管机构有权审查数据处理记录,但实际的用户数据(记忆内容)通过 is_deleted 标记在业务查询中完全屏蔽。
冲突处理、过期清理、合规删除,这三个机制解决了记忆"怎么管"的问题。记忆存好之后,每次对话时怎么把它用起来,才是最终落地的关键。
记忆检索:如何把记忆注入 Prompt
记忆存好了,每次对话开始时怎么用?
async def retrieve_memory(query: str, user_id: str) -> str: """ 检索与当前问题相关的历史记忆,返回格式化的Prompt片段 """ # 第一步:向量检索用户相关记忆(先过滤user_id,再做语义检索) relevant_memories = memory.search( query=query, user_id=user_id, limit=5 ) if not relevant_memories: return "" # 第二步:格式化为Prompt片段 memory_context = "\n".join([ f"- {m['memory']} (记录于{m['created_at']})" for m in relevant_memories ]) return f""" 【用户历史信息】 以下是该用户的历史偏好和关键信息,请在回答时参考: {memory_context} """ # 在对话流程中注入 async def chat(user_message: str, user_id: str, session_id: str): # 检索相关记忆 memory_context = await retrieve_memory(user_message, user_id) # 构建完整的系统Prompt system_prompt = BASE_SYSTEM_PROMPT if memory_context: system_prompt += "\n\n" + memory_context # 调用LLM response = await llm.ainvoke( messages=[ {"role": "system", "content": system_prompt}, *short_term_memory.get_context(), {"role": "user", "content": user_message} ] ) # 更新短期记忆 short_term_memory.add_message("user", user_message) short_term_memory.add_message("assistant", response.content) return response.content
有几个细节值得注意:
第一,检索时一定要先按 user_id 过滤,再做向量相似度计算,不能把所有用户的记忆混在一起检索。不然不同用户的信息会相互污染,也是严重的隐私问题。
第二,limit=5 不是固定值,要根据 Prompt 长度预算来决定。如果上下文窗口紧张,可以减少到 3 条;如果问题复杂、需要更多背景信息,可以增加到 8 条。
第三,检索到的记忆要带上时间戳,让 LLM 知道这条信息是什么时候记录的,方便它判断信息的时效性。
把定义、写入、管理、检索这四个环节串起来,就得到了一套完整的记忆管理闭环,下面用一个统一的流程图把它梳理清楚。
四步记忆管理流程
把上面所有内容串起来,完整的记忆管理流程是四步:
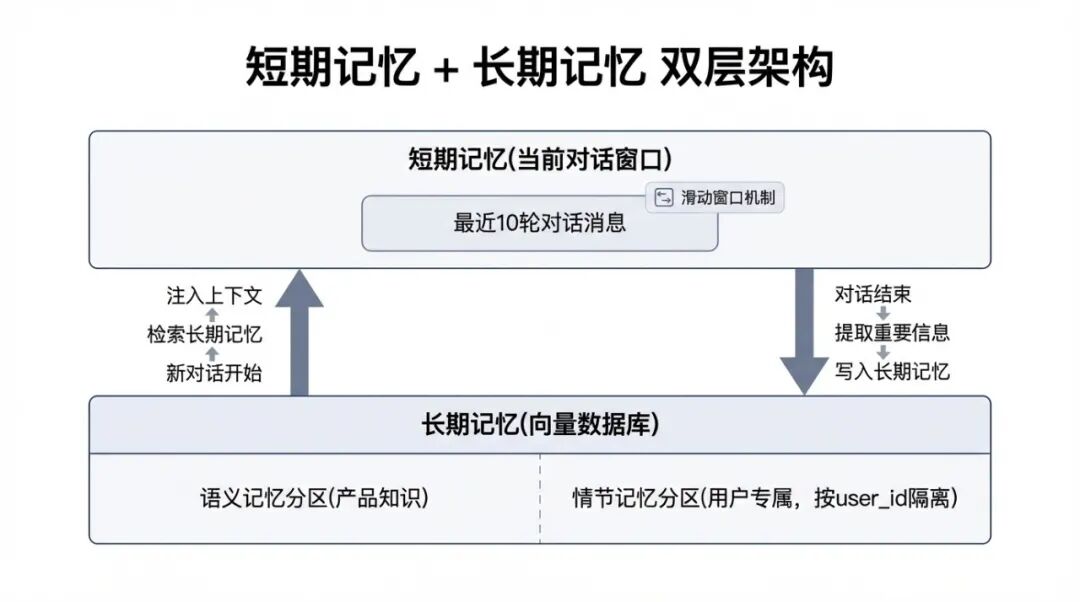
短期记忆+长期记忆双层架构
第一步:Define(定义)
明确哪些信息值得记忆。不是所有对话内容都有保存价值,要聚焦在:
- 用户明确表达的偏好(风险偏好、产品偏好、服务偏好)
- 用户的基本信息(企业规模、行业、注册地)
- 用户的重要决策和关键事件
- 对后续服务有实质参考价值的信息
"今天天气真好"不值得记忆,"我们公司明年计划做出口业务"值得记忆。
第二步:Write(写入)
用 LLM 从对话中提取记忆点,按类型分类后写入对应的存储:
- 情节记忆:写入向量数据库,绑定 user_id
- 语义记忆:写入共享知识库
- 程序性记忆:更新系统 Prompt 配置
第三步:Manage(管理)
写入前做冲突检测,决定 ADD/UPDATE/DELETE/NOOP 操作:
- 语义相似度 > 0.85 且内容有变化:UPDATE
- 新信息表明旧记忆已失效:DELETE
- 新信息之前没有类似记录:ADD
- 新信息与现有记忆一致:NOOP
第四步:Read(读取)
每次对话开始时:
- 先检索长期记忆,取相关度最高的 5 条
- 格式化后注入系统 Prompt
- 拼接短期记忆(最近 N 轮对话)
- 发送给 LLM 生成回答
这四步构成一个闭环,每次对话既消费记忆,又产生新的记忆。
理解了这套完整的设计体系,回到面试场景,就能把面试官的每一层追问都接住。
面试怎么答 Agent Memory 设计?
回到面试场景,如果面试官问你"Agent 的 Memory 模块怎么设计",可以按这个框架回答:
第一层:分类
“我们把记忆分三类,参考认知科学的语义记忆、情节记忆、程序性记忆。语义记忆是通用知识,对所有用户共享,存知识库;情节记忆是用户专属的历史信息,按用户 ID 隔离存储;程序性记忆是操作规则,直接固化为系统 Prompt。”
第二层:架构
“架构上分短期和长期两层。短期记忆是当前对话的上下文窗口,用滑动窗口保留最近 10 轮;长期记忆存在向量数据库里,我们用 Milvus,按用户 ID 分区,支持语义检索。”
第三层:管理
“写入时用 Mem0 框架的四种操作——ADD/UPDATE/DELETE/NOOP,写入前先做语义去重,比较新信息和现有记忆的相似度,超过 0.85 判断为同一实体需要更新,避免同一信息的矛盾版本并存。时效性信息加 TTL 字段,定时清理。”
第四层:检索
“每次对话开始时,先按用户 ID 过滤,再做向量相似度检索,取相关度最高的 5 条,格式化后注入系统 Prompt。”
第五层:合规
“金融场景下还要考虑被遗忘权,实现方式是软删除加审计日志——业务查询屏蔽已删除记忆,但审计日志保留用于合规审查。”
这五个层次说完,面试官想追问的点基本都覆盖了。
在理解这套体系的过程中,还有一个概念上的混淆需要特别说清楚,它会影响你在面试中的表达精确度。
一个常见误区
最后说一个我见过很多人踩的坑:把 Memory 和 RAG 混为一谈。
RAG(检索增强生成)是从知识库里检索文档来回答问题,检索的是通用知识内容。
Memory 是存储和检索用户专属的历史信息,检索的是与特定用户相关的个性化记忆。
两者的区别很清晰:RAG 处理的是"世界知道什么",Memory 处理的是"我知道关于这个用户什么"。
在"拓业智询"里,这两个模块并存:
- 用户问"贷款利率是多少" → RAG 从产品知识库里检索回答
- 用户问"我上次咨询的那个方案怎么样了" → Memory 从用户历史记录里检索上下文
两者都需要,功能不重叠,不能相互替代。
把这个区分讲清楚,整套 Memory 设计的轮廓就完整了,用三个维度做个收尾。
总结
Agent Memory 系统的设计,可以用三个维度来概括:
第一个维度是分类——区分语义记忆、情节记忆、程序性记忆,对应不同的存储位置和检索策略;
第二个维度是架构——短期记忆用滑动窗口管理当前对话,长期记忆用向量数据库按用户 ID 分区存储;
第三个维度是管理——写入时做冲突检测(ADD/UPDATE/DELETE/NOOP),过期信息用 TTL 自动清理,用户注销时软删除保留审计。
面试官问的"存在哪、怎么检索、什么时候更新、什么时候删除",这四个问题的答案都在这个框架里。
最后
2026 年春节前后,国内大模型迎来史无前例的集体爆发与同台竞技。短短不到一个月,主流厂商几乎全部登场:字节跳动 Seedance 2.0 刷屏科技圈,各大互联网公司纷纷推出 AI 红包新玩法,一场场精心准备的 “大模型春晚” 轮番上演,吸引无数 AI 爱好者围观喝彩👏。
大模型赛道竞争如此激烈,普通人到底该怎么入局,抢占未来 10 年的行业红利?
如果你还不知道从何开始,我特别整理了一套全网最全、最细的大模型零基础教程。我也是一路自学走过来的,太清楚小白前期学习的痛点:没人带、没方向、没资源,真的很难学进去!
下面这套资料,就是我专门为零基础、想转行、想提升的同学准备的全套学习方案。
👇👇扫码免费领取全部内容👇👇

资料包分享
1、大模型完整学习路线图
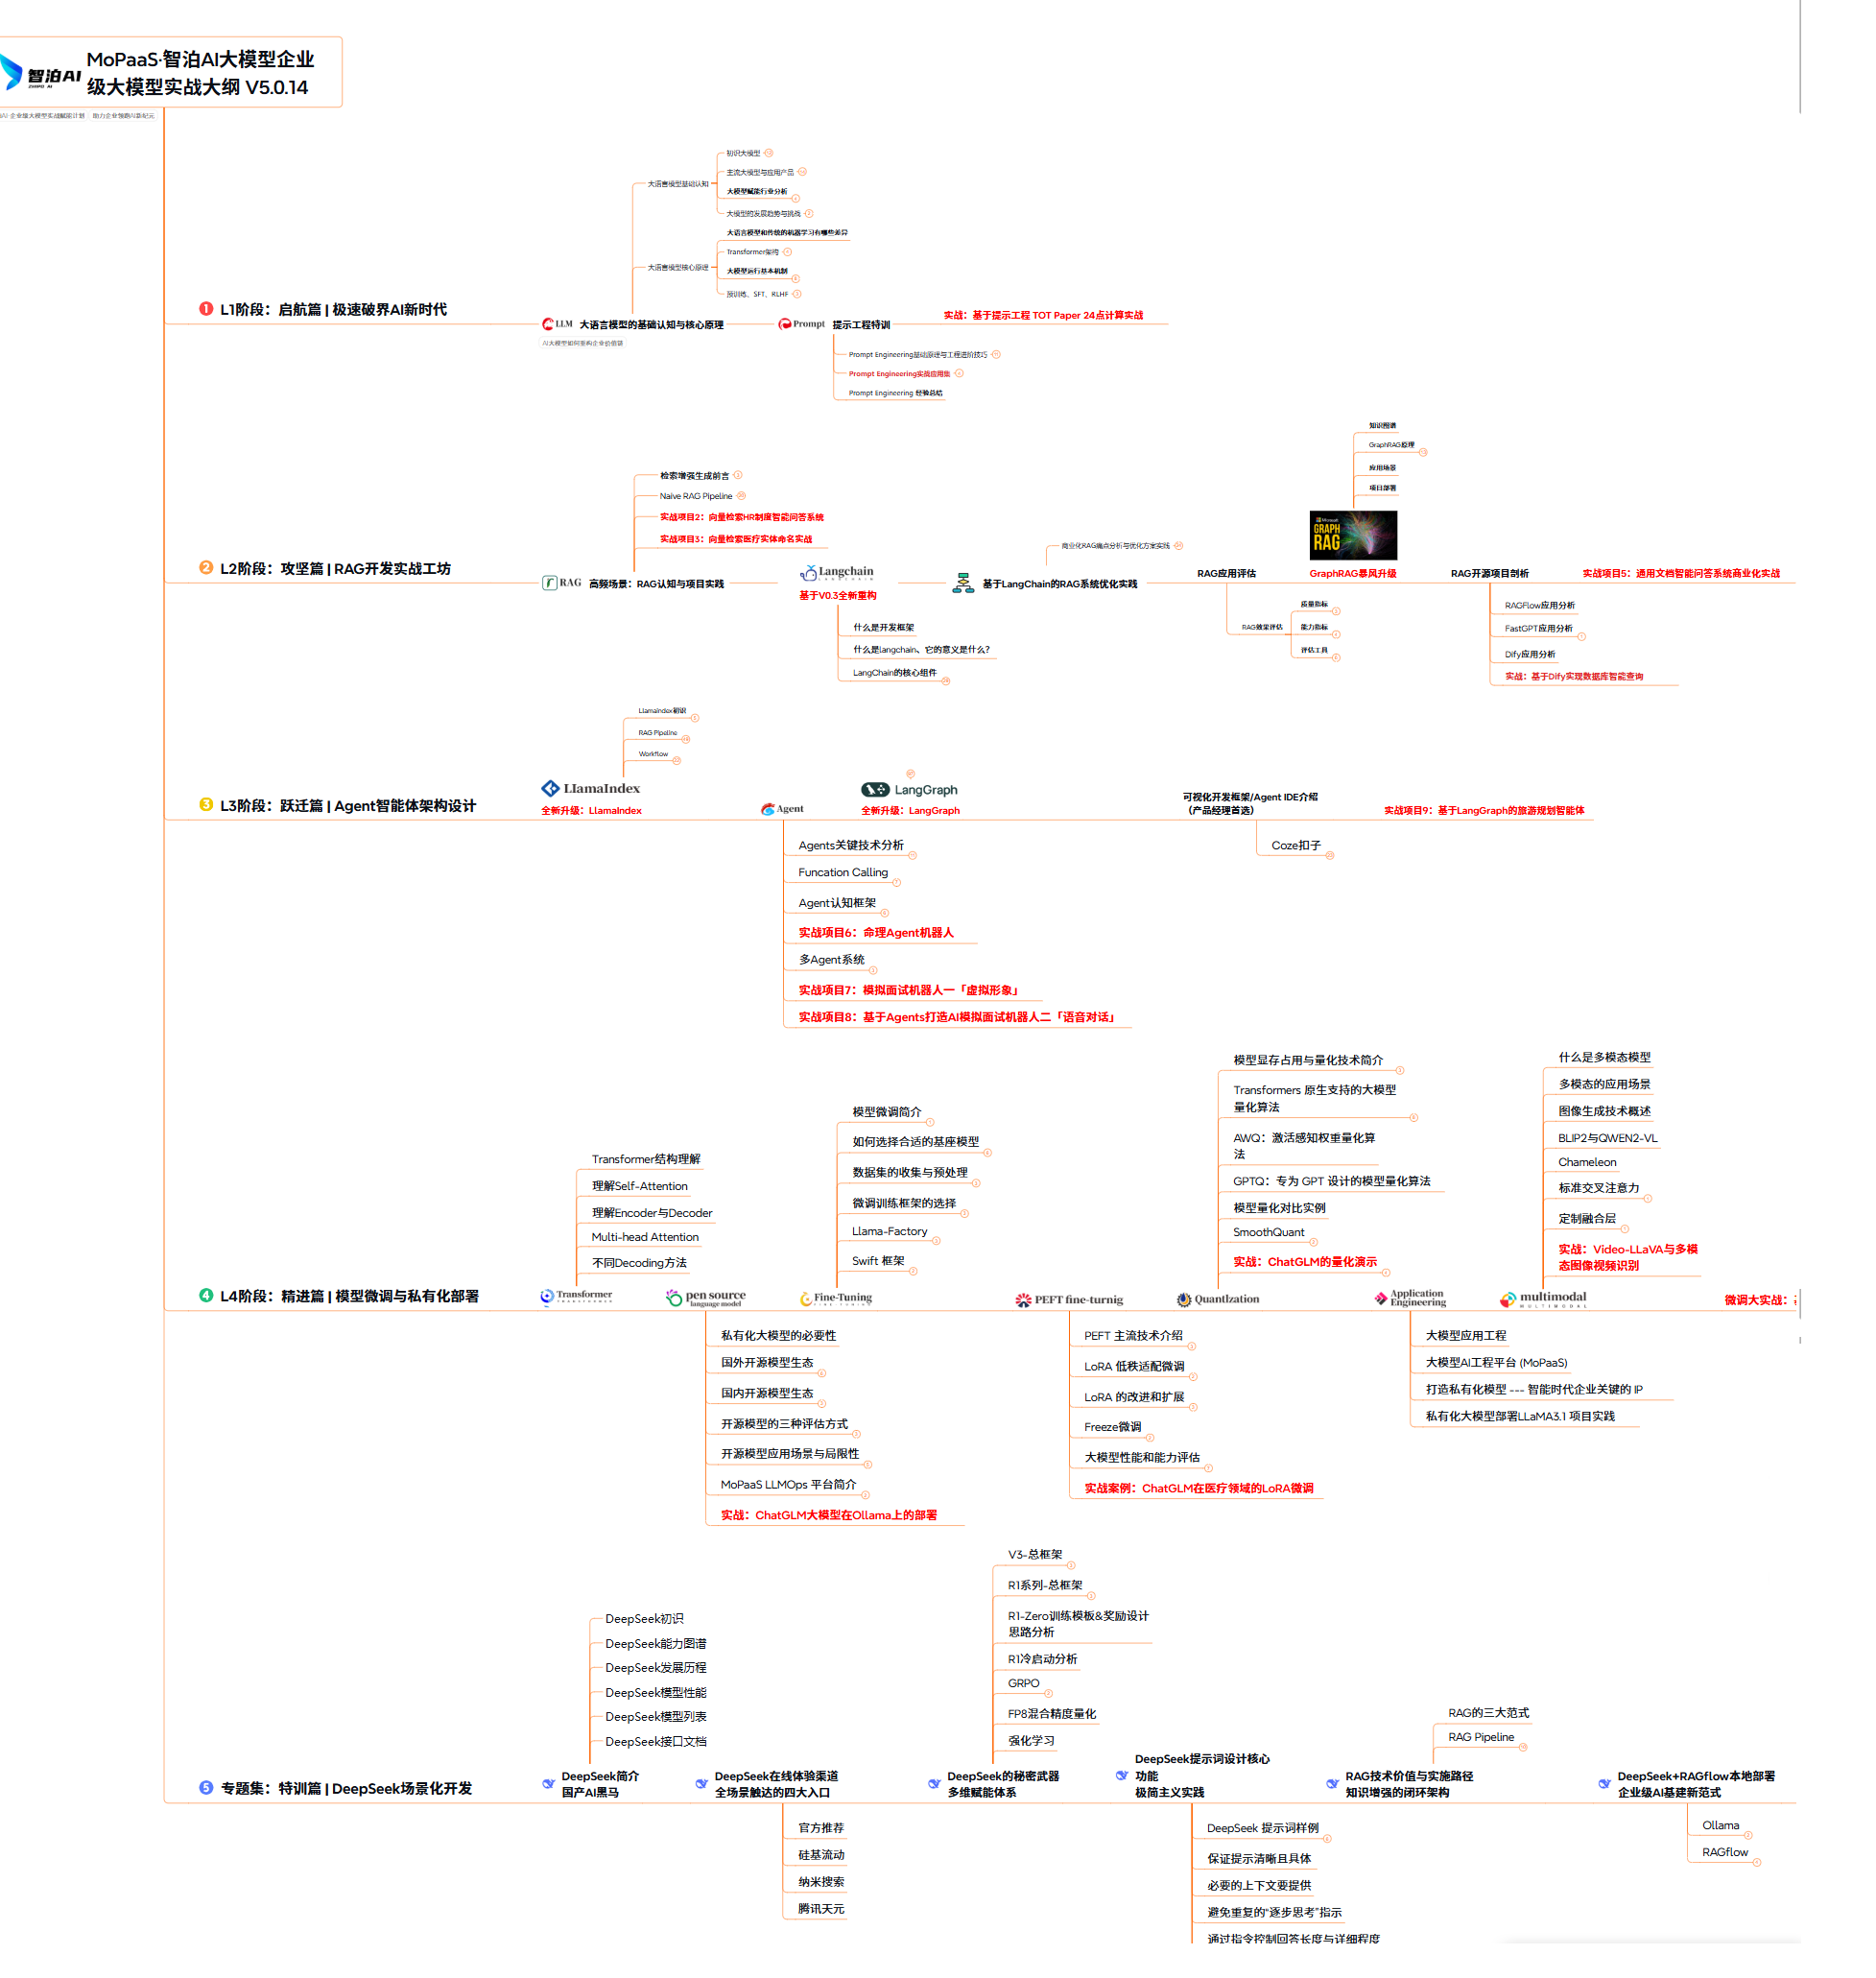
2、从 0 到进阶大模型视频教程
从入门到实战,全套视频都整理好了,跟着学效率更高
3、入门必看:精选书籍 & 核心文档(PDF 版)
市面上技术书太多,我已经帮你筛选出最值得看的一批,还有大量补充资料不在图里,一并打包给你
4、 AI大模型最新行业报告
2026 年最新行业报告,系统分析各行业现状、趋势、痛点与机会,帮你看清:哪些行业最适合落地大模型,哪里才有真正的机会。

5、面试试题/经验

【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 1175


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


