大模型面试必刷100题(2026最新版)|三个月面遍大厂,MoE/量化/部署/训练全攻略【建议收藏】

基于Codex平台与AI Agent技能开发,实现抖音爆款视频分析与脚本自动生成 大家好,我是专注于AI应用开发的技术博主。最近在探索如何利用AI工具自动化内容创作时,我发现了一个非常有趣的组合:通过Codex平台创建自定义的Skill(技能),来批量分析抖音平台的爆款视频,并基于分析结果自动生成新的带货视频脚本。这听起来像是内容团队的“黑科技”,但实现起来其实有清晰的路径可循。本文将为你完整拆解这个实战项目,从环境搭建、Skill编写、数据抓取到视频脚本生成,手把手教你打造自己的“AI内容助理”。无论你是想了解AI Agent的开发,还是对短视频自动化创作感兴趣,都能从本文中获得可直接 阅读详情

从今年3月开启大模型算法岗求职,到现在整整奋战近三个月,我先后面试了互联网大厂、中型企业、初创公司等数十家企业,完整体验了大模型赛道不同规模、不同业务方向的面试风格与核心考点,也积累了超实用的一线面试经验。

我是前杭州头部互联网大厂算法工程师,核心深耕大模型MoE效果调优、模型量化压缩、端侧推理部署、高质量数据清洗,以及电商垂类多模态大模型算法设计与落地,在大模型工程化、训练优化、部署落地方向有丰富实战经验。

这篇文章我把求职期间遇到的高频大模型面试题做了全网最全汇总,既是对自己求职历程的复盘沉淀,也为大家整理了一份可直接背诵的面试知识库,希望能帮到正在备战大模型面试的算法小白、转行程序员和求职的同学,少走弯路,直通offer!

Q1:QAT过程中怎么确定哪些层可以量化而哪些层需要保留精度?

模型量化感知训练(QAT)中,敏感层判断是保证模型精度不崩的核心,我结合大厂面试高频考点和实战经验,整理了最全面的判断规则+分析方法,面试直接用!

1. 敏感层判断指标(面试必背)

✅ 必须保留FP32精度(绝对不能量化)
输入层(首层卷积/Embedding层)、输出层(分类头/回归头)、ResNet残差连接层、所有归一化层(BatchNorm/LayerNorm/RMSNorm)。

✅ 建议保留FP32精度(量化极易掉点)
小通道卷积/全连接层、Transformer结构中的QKV矩阵、MoE专家层核心权重。

✅ 扩展敏感层类型(加分项)

  • 激活函数层:Swish、GELU、SiLU等非线性激活,量化后特征信息丢失严重;
  • 注意力机制Softmax层:输入数值范围跨度大,量化会破坏概率分布,导致注意力失效;
  • 小尺寸卷积:1x1卷积参数量少,量化误差被放大,影响整体效果;
  • 低秩分解层:矩阵分解后的子层数值敏感度极高,不建议量化。

✅ 任务专属敏感层(业务向加分回答)

  • 目标检测:边界框回归头必须高精度;
  • 语义分割:解码器最后一层像素分类层保留FP32;
  • 生成式模型/GAN:生成器+判别器输出层全量保留高精度。

2. 敏感层分析方法(工程实战向)

逐层量化消融实验(最通用)
  1. 搭建全量化基线:所有层量化为INT8,记录基准精度A_base;
  2. 逐层恢复FP32:依次将单层还原为高精度,重新测试精度A_layer;
  3. 敏感度排序:计算delta=A_layer-A_base,delta越大说明该层越敏感,必须保留高精度。
梯度重要性分析

核心原理:量化误差对模型损失的影响,可通过梯度幅值直接判断。

  • QAT训练中实时监控各层梯度;
  • 梯度幅值越大的层,量化后优化越不稳定,优先保留FP32。
自动化敏感度评估工具(大厂标配)
  • 神经架构搜索:DARTS+Q、QAAS自动搜索最优量化配置;
  • 开源工具:NNCF框架内置量化敏感度分析API,一键生成敏感层报告;
  • 误差传播分析:通过FakeQuant伪量化节点模拟误差,用KL散度、PSNR统计判断敏感层。

Q2:Pytorch中怎么实现混合精度量化/推理,有什么注意事项?

混合精度是大模型推理、训练的基础技能,面试必考实操+避坑点,我整理了最简实现方案+高频踩坑总结!

1. 混合精度推理(自动FP16/FP32切换)

PyTorch通过torch.cuda.amp模块实现自动混合精度(AMP),核心用torch.autocast管理精度,代码极简:

import torch
from torch.cuda.amp import autocast

# 推理核心代码
model.eval()
with autocast(device_type="cuda", dtype=torch.float16):
    output = model(input_data)

2. 核心注意事项(面试必答)

✅ 溢出检查:必须定期检测梯度是否出现NaN/Inf,避免训练崩溃;
✅ 动态缩放:训练时通过scaler.update()自动调整梯度缩放因子,防止FP16下溢;
✅ 算子兼容性:log/exp/pow等数学算子强制使用FP32,自定义CUDA内核需显式声明精度;
✅ 部署兼容:导出ONNX需指定opset_version≥15,TensorRT启用FP16需配合--fp16参数。


Q3:使用TensorRT部署量化模型时,如何评估模型推理速度和显存占用?

TensorRT部署是大模型工程化必考考点,重点考察性能评估工具+显存优化方案,纯干货总结:

1. 性能评估核心工具组合

trtexec + Nsight Systems(NVIDIA官方标配,面试必说)

  • 延迟测试:一键生成FP32/FP16/INT8精度下的推理延迟、吞吐量报告;
  • 显存分析:定位高显存消耗层,快速排查瓶颈;
  • 可视化分析:GPU时间线、显存带宽利用率一目了然。

trtexec 实战命令

# 测试多batch size+多精度性能
trtexec --onnx=model.onnx --shapes=input:32x3x224x224 --fp16 --int8 --verbose

Nsight Systems 核心功能

  • GPU时间线:识别卷积、注意力等计算密集型阶段;
  • 显存带宽分析:判断模型是否受限于显存数据传输瓶颈。

2. TensorRT核心价值

  • 极致加速:层融合、量化、内核自动优化,降低推理延迟;
  • 显存节省:大幅减少GPU显存占用,提升并发量;
  • 全场景部署:支持云端GPU(A100)、边缘端(Jetson),适配实时AI业务。

3. 显存优化策略(面试加分)

  • 层融合:合并Conv+BN+ReLU连续算子,消除中间显存占用;
  • 显存池:通过--workspace参数调整TensorRT工作空间;
  • 动态形状:--minShapes/--optShape/--maxShape适配可变输入尺寸;
  • 硬件适配:Jetson系列启用DLA加速器,多GPU用NCCL优化通信。

Q4:将QAT模型导出为ONNX格式时,有哪些常见的兼容性问题,如何解决?

量化模型导出是工程化高频坑点,面试常问问题定位+解决方案,我整理了3类最常见问题:

问题1:PyTorch/ONNX版本不兼容

  • 原因:PyTorch<1.8对量化导出支持极差,ONNX opset<13不支持量化节点;
  • 解决方案:升级PyTorch≥2.0(推荐2.1+),导出时指定opset_version=17。

问题2:量化节点丢失/异常

  • 原因:伪量化节点(FakeQuant)未正确嵌入计算图;
  • 解决方案:用Netron可视化工具检查模型结构,确保量化节点正常插入。

问题3:自定义层不支持量化

  • 原因:空洞卷积、自定义注意力层等非标算子,ONNX无原生支持;
  • 解决方案:
    1. 简单替换:将自定义层拆分为标准算子组合;
    2. 高级方案:注册符号函数,编写C++自定义算子并编译加载。

Q5:模型并行、梯度检查点和流水线并行的协同优化,如何提升大模型训练效率?

千亿/万亿参数大模型训练必考,核心考察三大技术协同逻辑,小白也能听懂的总结:

1. 模型并行:横向拆分模型,降低单卡负载

  • 张量并行:拆分Transformer权重矩阵(Megatron-LM列并行/行并行);
  • 流水线并行:按模型层划分多阶段,用Micro-batch隐藏跨卡通信延迟。

2. 梯度检查点:纵向节省显存,支持超大模型

  • 核心逻辑:用重计算换显存,不存储中间激活值;
  • 实战方案:对FFN、注意力等高显存层插入检查点,用checkpoint_sequential实现。

3. 协同通信优化(关键加分点)

  • All-reduce优化:采用Ring-Allreduce(NCCL)降低通信开销;
  • 异步通信:反向传播与梯度传输同步执行,隐藏等待时间;
  • 混合精度通信:用FP16传输梯度,减少50%带宽占用。

4. 硬件基建建议

  • 高速互联:NVLink/InfiniBand降低多卡通信延迟;
  • 存储优化:分布式文件系统加速模型 checkpoint 读写。

Q6:400卡规模训练视觉-语言大模型,loss周期性震荡(>30%)如何解决?

这是大厂分布式训练超高频面试题,考察故障定位+解决方案,直接背标准答案:

核心原因(4点必答)

  1. 梯度同步异常:部分GPU节点梯度爆炸/消失,全局参数更新紊乱;
  2. 模态收敛冲突:视觉(稠密高维)与文本(稀疏低维)梯度方向相反,互相干扰;
  3. 通信带宽瓶颈:跨节点All-Reduce同步延迟,参数更新滞后;
  4. 硬件资源争抢:网络/存储I/O竞争,导致集群训练步调不一致。

实战解决方案(面试满分答案)

  1. 梯度异常检测:实时监控梯度L2范数,隔离异常节点,自动回滚Checkpoint;
  2. 模态梯度均衡:对视觉/文本分支梯度做归一化,平衡收敛速度;
  3. 分层通信优化:视觉特征用NCCL+FP16,文本特征用gRPC+动态编码,降低41%通信开销。

Q7:常见Pytorch模型训练问题排查对照表

我整理了大厂算法工程师日常训练高频故障速查表,涵盖loss不下降、梯度消失、显存溢出等问题,遇到故障直接对照解决!
Pytorch训练问题排查对照表

最后

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?

答案只有一个:人工智能(尤其是大模型方向)

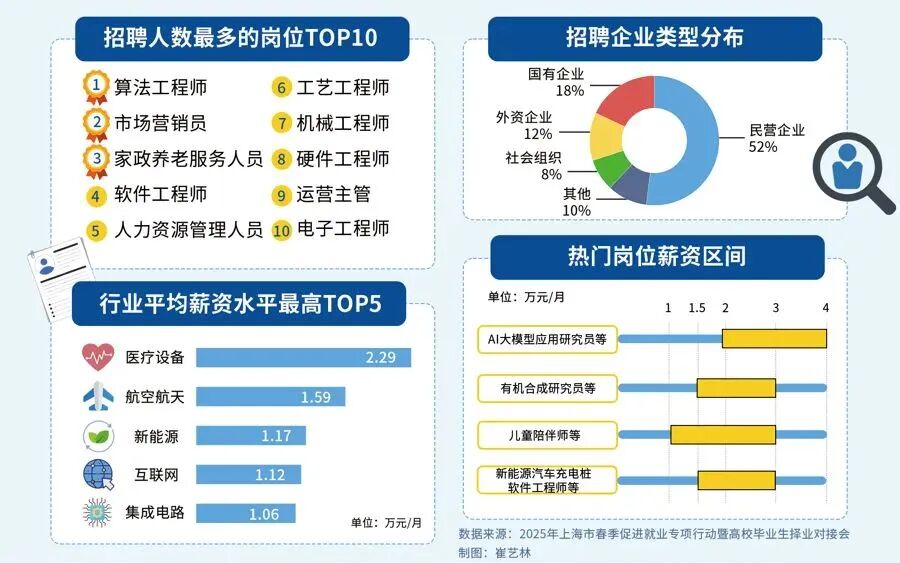
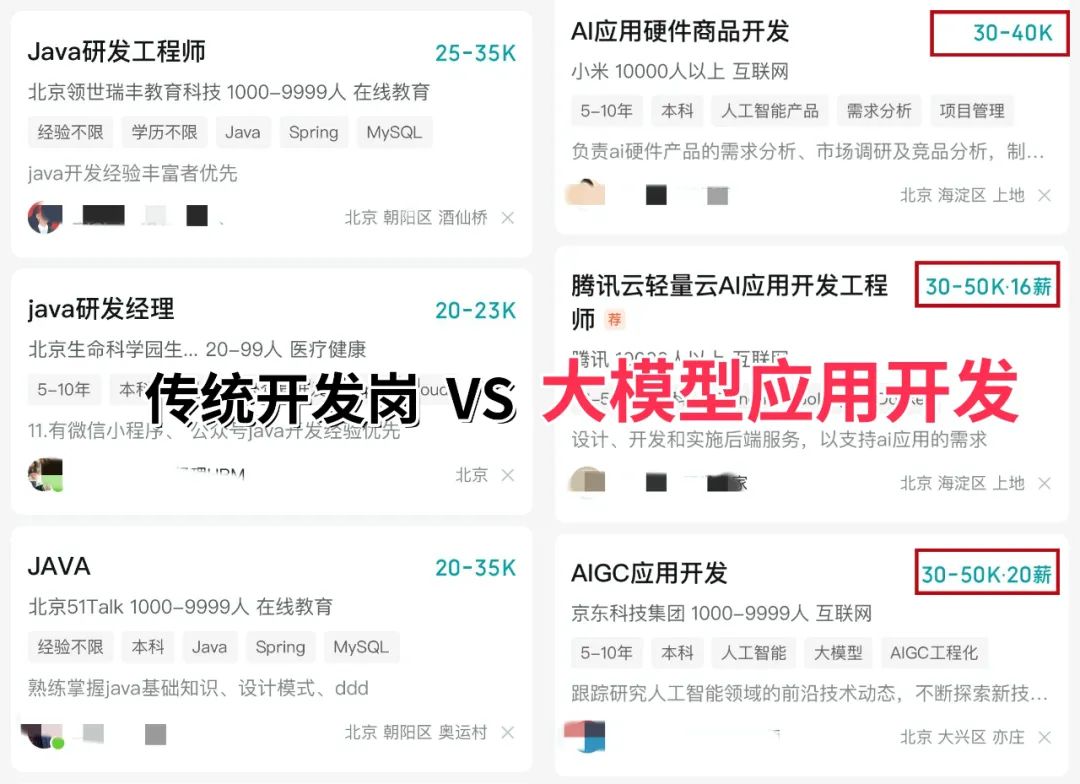
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
图片
图片
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。

如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!

下面是我整理的大模型学习资源,希望能帮到你。

图片

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

最后

1、大模型学习路线

img

2、从0到进阶大模型学习视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

在这里插入图片描述

4、 AI大模型最新行业报告

2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

5、面试试题/经验

img

【大厂 AI 岗位面经分享(107 道)】

img

【AI 大模型面试真题(102 道)】

img

【LLMs 面试真题(97 道)】

img

6、大模型项目实战&配套源码

img

适用人群

在这里插入图片描述

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

    👇👇扫码免费领取全部内容👇👇

    在这里插入图片描述

3、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

YOLOv13:目标检测的全面攻略与实战指南 本文是关于 YOLOv13 的全攻略文章。先回顾 YOLO 系列发展,点明 YOLOv13 在该系列中的创新地位,阐述其基于 HyperACE、FullPAD 和轻量级卷积替换等技术的独特优势。深入剖析各核心技术原理,通过与其他版本及实际场景对比展现其性能优势。介绍项目结构与使用方式,分享数据增强、锚框优化等实用技巧,并列举安防监控、自动驾驶等领域应用案例。最后总结 YOLOv13 价值,展望目标检测技术未来发展趋势,为读者提供全面的 YOLOv13 学习与实践指导。 阅读详情

相关推荐

高速光耦在隔离串口通信中的选型与优化策略

本文深入探讨了高速光耦在隔离串口通信中的关键作用与选型优化策略。针对串口通信中因普通光耦响应慢导致的误码问题,文章详细分析了响应时间、电流传输比、供电电压与隔离耐压等核心选型指标,并对比了6N137、HCPL-0601等主流型号。同时,提供了电路设计、PCB布局的优化技巧及实用的调试指南,旨在帮助工程师实现高速、稳定的隔离串口通信。

grpc6streamer的博客 322

RabbitMQ 面试题

你发一条消息,在网络上并不是一个整体飞过去的。如果消息比较大,RabbitMQ 的底层协议会把它切成多个数据包(帧),按顺序发送,Broker 收到后再拼起来。假设线程 T1 和 T2 同时用同一个 Channel 发消息:T1 发消息 A,被切成三个帧:[A1] [A2] [A3]T2 发消息 B,也被切成三个帧:[B1] [B2] [B3]如果没有任何保护,这两个线程的帧可能交错到达 Broker,变成 [A1] [B1] [A2] [B2] [A3] [B3]。

互联网叫兽 538

用废旧汽车电池DIY家用UPS:手把手教你低成本搭建Wi-Fi不断电系统

本文详细介绍了如何利用废旧汽车电池DIY低成本家用UPS系统,确保Wi-Fi设备在断电时持续供电。通过精选材料、电路搭建和安全防护,实现高效稳定的电源转换与智能切换,成本仅为市售UPS的三分之一。特别适合家庭办公和远程工作者提升网络供电可靠性。

weixin_29200485的博客 464

smart-tunnel-ai · 隧道/高速智慧化 AI 应用项目

面向的工程师:一个能跑通、能改、能讲清楚的 Spring Boot + Spring AI 项目。:它不是「调了个 ChatClient 输出一句话」,而是把切块策略、增量入库、来源溯源、防幻觉、工具调用、结构化输出、评估集、密钥守卫、CI 护栏这些工程问题都落到了代码里。每一处都能指向具体类讲取舍。详见。

futurn_hero的博客 305

立创星火计划:基于STM32H743VIH6的Maverick_H743_MK1.0高性能开源飞控硬件全解析

本文详细解析了基于STM32H743VIH6核心的Maverick_H743_MK1.0高性能开源飞控硬件设计。重点阐述了采用双IMU冗余设计、高精度气压计、多路独立电源管理以及丰富接口(如CAN总线)的考量,旨在为穿越机、科研无人机等平台提供强大、可靠的飞行控制解决方案。

weixin_28787801的博客 198

微信小程序——01开发前的准备和开发工具

微信小程序——01开发前的准备和开发工具

总裁余(余登武)博客 1万+

LeetCode 面试经典 150_多维动态规划_交错字符串(97_C++_中等)

LeetCode 面试经典 150_多维动态规划_交错字符串(97_C++_中等) 题目描述: 给定三个字符串 s1、s2、s3,请你帮忙验证 s3 是否是由 s1 和 s2 交错 组成的。 两个字符串 s 和 t 交错 的定义与过程如下,其中每个字符串都会被分割成若干 非空 子字符串: - s = s1 + s2 + ... + sn - t = t1 + t2 + ... + tm - |n - m| <= 1 - 交错 是 s1 + t

huayimenghan的博客 209

海康VisionMaster与西门子Smart 200进行S7通信

海康VisionMaster与西门子Smart 200进行S7通信

haier123888的博客 8180

Spring 原理高频面试题全解:Bean 生命周期、三级缓存与 @Transactional 失效(2026 招聘 JD 真题复盘)

按 2026 招聘 JD 与一线面经整理 10 道 Spring 高频题:Bean 生命周期与扩展点顺序、AOP 代理生成时机、三级缓存为何必须三级、构造器注入循环依赖为何无解、@Transactional 六类失效与自调用修复三法、REQUIRES_NEW 连接池耗尽风险、事件总线同步语义与 @TransactionalEventListener、自动配置从 spring.factories 到 imports 的演进、自定义 Starter 三步走,附速查表与三条追问链。

蒙眼过河 318

Lumerical 教程,包含作者个人理解及相关设计案例 (目前共计184篇,持续更新中)

4138。

u011699626的博客 1622

三菱MC协议(MC/TCP):避坑指南|C#实现三菱MC协议:软元件(X/Y/M/D)读写与帧格式解析

核心避坑逻辑:MC协议的坑80%集中在“PLC配置”“地址编码”“字节序”,先解决这三点,通信就成功了一半;实战优先级:新手优先用开源库(Mitsubishi.MCProtocol),避免手动拼接帧格式的复杂坑;进阶再研究帧格式解析;排坑技巧:先Ping通→用调试助手验证→写C#代码,分层排查,不要混在一起找问题。掌握这些避坑技巧后,你可以轻松实现C#与三菱全系列PLC的稳定通信,满足工业场景中数据采集、设备控制等核心需求。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 2194

Docker镜像优化:面试高频翻车的简单题

本文深入探讨Docker镜像优化的两大核心层面:体积优化与构建速度优化。指出仅关注镜像瘦身(如使用Alpine)是表面理解,真正关键在于平衡空间与时间——在DevOps流水线中,构建速度常优先于体积。文章详解了多阶段构建、缓存利用、.dockerignore文件等高效策略,并揭示Alpine镜像虽小但存在兼容性、依赖缺失等风险,强调需结合业务场景权衡选择。掌握这些细节,方能在面试中展现真实技术深度,脱颖而出。

java后端架构 212

【2026最新】3分钟Windows极速部署OpenClaw,完整可复制命令+全链路避坑指南

很多新手在Windows环境部署OpenClaw时,总会遇到各种玄学问题:WSL环境配置失败、Docker镜像拉取超时、容器启动后无法访问、权限报错、数据丢失……网上大量教程要么是Linux环境的,要么是早已过时的旧版本配置,照着操作不仅没法3分钟部署,反而要花几小时踩坑填坑。

2601_94871597的博客 493

AI 全栈开发工程师【二面】

传统的大模型应用通常采用:用户输入 → Prompt → LLM → 输出结果这种模式适合简单问答、文本生成和信息提取等任务。但对于复杂业务,仅依靠一次模型调用往往不够。例如,用户提出:帮我查询某个地区近三个月销量最高的产品,并分析销量变化原因。理解用户需求。拆解查询条件。调用数据库或外部工具。获取查询结果。分析数据。生成最终报告。Agent 的核心价值在于让大模型不仅能够生成文本,还能够根据任务目标进行规划、调用工具、观察执行结果,并根据结果调整后续行动。

qq_22841387的博客 454

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【AI Agent面试系列】上下文管理1

工具返回价值密度最低、体积最大(常占 30%~60%),清理它收益最高、损失最小。摘要对话会丢语义细节,代价更高。按"价值密度从低到高"排序,不是按"体积从大到小"。

357

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

邓明 Agent 系统面试-意图识别学习笔记

不要只是做意图识别而不做测评,就好像要评估 RAG 准确性,在接口服务要测试响应时延,超时控制等等,这里也要关注意图识别准确率,如果面试官认为项目指标太高是在吹牛,关键就是回答因为 Agent 解决的是特定领域的意图识别,识别场景单一,另外就是因为用户输入相对简单。意图识别影响 prompt/spec 的加载,意图识别影响上下文组织,意图识别影响工具选择,意图识别影响 prompt 建议,意图识别得到的意图不是让模型随机生成而是候选类别里去做选择。2.意图识别的原因,以及意图识别得到的是什么?

m0_57222081的博客 215

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

上位机面试:值类型 vs 引用类型

大部分教程会告诉你"值类型在栈上,引用类型在堆上"。如果 ④ 和 ⑤ 都用 99,⑤ 打印出 99 时你分不清是"第 3 条和第 4 条是最容易混的,也是面试最爱追问的地方。很多人把"传引用类型的参数"当成"引用传递",这是错的。所以那句"引用类型比较就是比地址"不是通则——跑 100 万次对比,数量级差异很明显。记住这张图,下面所有现象都能推出来。这一行,才是真正的"按引用传递"。的核心原因——泛型不需要装箱。生效了"还是"根本没生效"。,比背"栈和堆"高一个层次。,这是测试设计的基本要求。

hanxiaodihhh的博客 241

华为运维面试题

华为面试注重真实经历与价值观契合,主管面采用STAR+价值观锚点+反思闭环框架,强调“我”的决策与量化结果。运维手撕题重思路表达与边界处理,需清晰复述、分步讲解、主动验证。云场景设计题须先澄清需求,再分层设计,兼顾可靠性与成本,突出取舍意识。通用心法:聚焦“我”、结构先行、主动说明边界与改进,以数字和反思收尾,展现复盘能力与华为文化匹配度。

dp340823的博客 170

AI 应用开发工程师(Agent 方向)【二面】

面试后半段,面试官介绍了团队的组织情况、技术方向以及岗位未来的工作内容。维度主要信息团队背景IT 部门负责生产、销售、财务、人资、物流等领域的信息化系统AI 发展方向将大模型与传统决策模型、RPA 等技术结合团队建设新成立 AI 智能应用研究团队技术平台更倾向于建设符合企业内部需求的 Agent 开发平台自建原因需要对接 ERP 和外部业务系统,同时满足权限、安全及业务逻辑要求岗位定位前期参与实际项目落地,逐步承担更完整的需求和方案设计工作成长方向。

qq_22841387的博客 262

# Linux 系统编程深度解析:从文件 I/O 到高并发网络

Linux 系统编程,就是用 C/C++ 等语言,直接调用 Linux 内核提供的接口(系统调用)来操作硬件资源(文件、内存、CPU、网络)的编程方式。你写过的 、、、,全部都是系统调用;你写过的 、、,是库函数,库函数底层最终还是调用系统调用。CPU 有特权级别(x86 上 ring 0 是内核态,ring 3 是用户态):应用程序跑在用户态。当你调用 时,CPU 会通过 或 指令触发陷入(trap),切换到内核态,由内核完成真正的磁盘读取,再切回用户态返回结果。 为什么要区分两个态? 安全:用户

LJM_X的博客 369

C++ 运行时多态与虚函数机制全面剖析【面试重点】

构成C++ 运行时多态必须是基类的指针或者引用调用虚函数。被调用的函数必须是虚函数,并且派生类必须对该虚函数完成重写/覆盖(Override)。只有基类的指针或引用才能既指向基类对象,又指向派生类对象(切片机制);而只有完成了虚函数重写,派生类与基类才具备不同的函数行为,达到“指向谁就调用谁”的效果。在类成员函数的前面加上virtual关键字修饰,该成员函数就成为了虚函数。public:// 成员函数前加 virtual 修饰,声明为虚函数。

Fuyo_0209的博客 438

[特殊字符]中粮集团秋招|11.7线上笔试+AI双环节

#中粮集团校招 #中粮笔试题库 #中粮笔试 #2027秋招 #央企笔试 #职豚题库 #秋招笔试 #AI面试 #校招备考。✨拉开分差重点,一定要背 ▪部分岗位附带专业考题 ▪笔试结束马上衔接 AI 面试,高频题:自我介绍、求职动机、岗位匹配,提前备好思路。收到中粮笔试邮件的宝子集合📩 这次是线上笔试 + AI 面试连在一起按顺序作答 很多人容易忽略 AI 面试环节,踩大坑!✅考试:11 月 7 日(周六)10:00–11:40,合计 100 分钟 ✅。

Bxy886的博客 221

AI面试复盘系统:从模糊感受到可迭代优化

复盘的价值不在于给上一场打分,而在于把“我好像不太行”转换成“第 3 类追问下我的方案缺少容量估算”——后者才是能改变的。系统的作用,是让这个转换每次都发生,并且在下一次面试时告诉你它到底有没有发生。海量精选技术文档和实战案例持续更新,敬请关注【风骏时光少年】

m0_55877125的博客 176

Android 面试题逐题简析:28 个专题,232 题

常见原因是未在 onMeasure 处理 AT_MOST 下的期望尺寸,沿用了默认测量而占满可用区域,或未考虑内容、padding 和最小尺寸。应计算 desiredWidth/Height,再通过 resolveSizeAndState 等与父约束合并。wrap_content 是测量输入,框架不会自动知道自定义内容想要多大。

一个踩这七色彩虹的路人甲 152

LeetCode 面试经典 150_数学_阶乘后的零(133_172_C++_中等)

LeetCode 面试经典 150_数学_阶乘后的零(133_172_C++_中等) 题目描述: 给定一个整数 n ,返回 n! 结果中尾随零的数量。 提示 n! = n * (n - 1) * (n - 2) * ... * 3 * 2 * 1

huayimenghan的博客 119

运维面试情况1105和1111

1、RHEL 系(rpm、dnf/yum)2、Debian 系(deb、apt)3、SUSE 系(rpm、zypper)4、国产信创(鲲鹏 ARM 会遇到)5、特色发行版。

2501_91384465的博客 203
上一篇: 收藏!刷屏的“红色小龙虾”OpenClaw,藏着2026程序员高薪密码|小白必看
下一篇: 小白也能学会!收藏这份Agent入门指南,轻松玩转大模型
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值