【AI学习收藏】一文读懂多模态RAG:让AI真正理解图文混合文档的新技术

DeepSeek多模态模型上线:图文理解与本地部署实战指南 多模态模型正在重塑AI应用开发范式,它通过融合视觉编码器与语言模型主干,让机器同时理解图像和文本,从而简化传统“OCR+文本模型”的多链路处理流程。这项技术的核心价值在于,开发者无需再为图片识别和语义理解分别搭建系统,一个模型即可完成文档解析、图表问答、截图信息抽取等复杂任务。无论是构建RAG文档检索、增强Agent视觉能力,还是实现电商图片自动描述,多模态模型都大幅降低了工程复杂度。本文围绕DeepSeek多模态模型的落地路线,讲解API调用和本地vLLM部署两种接入方式,并提供批量任务测试与环境配置建议 阅读详情

2024年是多模态大模型元年,RAG技术正从单语言模态进化到多模态RAG。传统方法将文档中的图片、表格等转换为文本后再进行RAG,但会导致信息丢失。随着多模态大模型技术突破,原生多模态RAG成为可能,如DSE和ColPali方法直接使用原始文档图像,通过延迟交互技术提高检索效率和精度,无需广义OCR转换过程。这标志着多模态RAG突破了传统图像检索,具备大规模非结构化多模态数据深度理解能力,将有更多商业应用价值。
1、什么是RAG

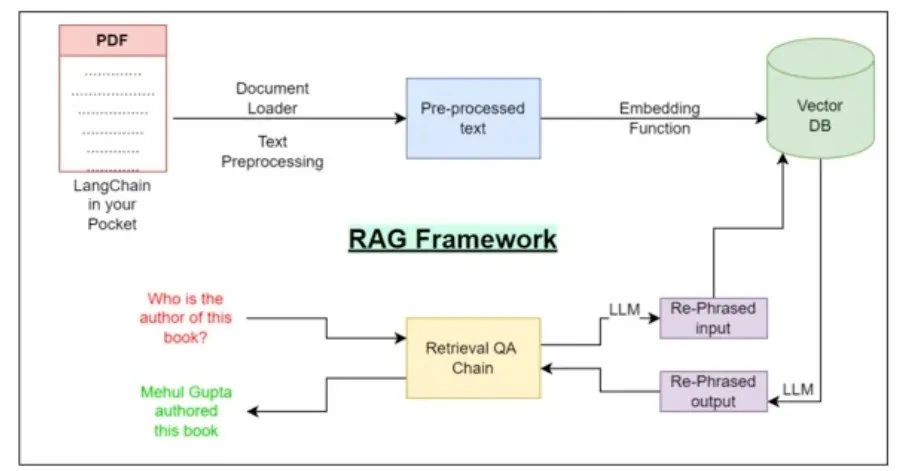
什么是RAG: Retrieval Augmented Generation,检索增强生成。是一种结合了信息检索技术和大型语言模型提示功能的框架。它通过从数据源检索信息来辅助LLM生成答案,提高了模型在知识密集型任务中的准确性和可信度。

我们为什么需要RAG: 大型语言模型通常基于固定的历史数据集进行训练,这意味着它们的知识是过时的,无法涵盖最新的信息或特定领域的专业知识。RAG的目的是通过引入额外知识库,检索其中的相关信息,并根据检索结果给予用户回答。这也可以显著减少大模型因为并不具备相关知识,而出现的“幻觉”现象。当然我们也可以直接把整个数据库作为LLM的prompt输入,但由于transformer架构O(N2)复杂度的限制,LLM支持的最长输入长度通常有限,多数支持到128k token已经是极限,使得在面临更长知识库输入时,RAG依然是当下唯一可行的解决方案。

如何实现RAG: 在实际应用时,我们常需要给定一系列文档,并使用RAG方法,让LLM针对这些文档进行检索与交互。RAG的实现主要包含以下几个步骤:

  • 数据准备阶段: 包括数据提取、分块(chunking)、向量化(embedding)、数据入库等环节。数据提取涉及将不同格式的数据(如PDF、Word、数据库等)处理为统一的格式。分块是将大文档分割成较小的、语义完整的单元,以便于后续处理和检索。
  • 检索阶段: 系统根据输入查询检索相关文档或信息。这个阶段依赖于搜索算法和索引方法来快速识别大量集合中最相关的数据。
  • 增强阶段: 将用户查询和检索到的额外上下文放入一个提示模板中,以增强提示。
  • 生成阶段: 使用大型语言模型来针对检索结果,生成对用户的回复。

2、走向多模态RAG

从RAG的应用可以看出,多数时候,我们需要把一些文档作为RAG的输入,用于检索和生成。而现实应用中,文档通常是以图文交错的形式存在的,比如网页、PDF、PPT文件等等。

通常的做法是,只保留文档中的文本信息。对于PDF文档,则进行OCR文字识别,读取其中的文本。但这样会导致大量图片中至关重要的信息被丢失,以及很多结构化内容的错乱,比如标题、表格、页眉页脚等格式错乱。

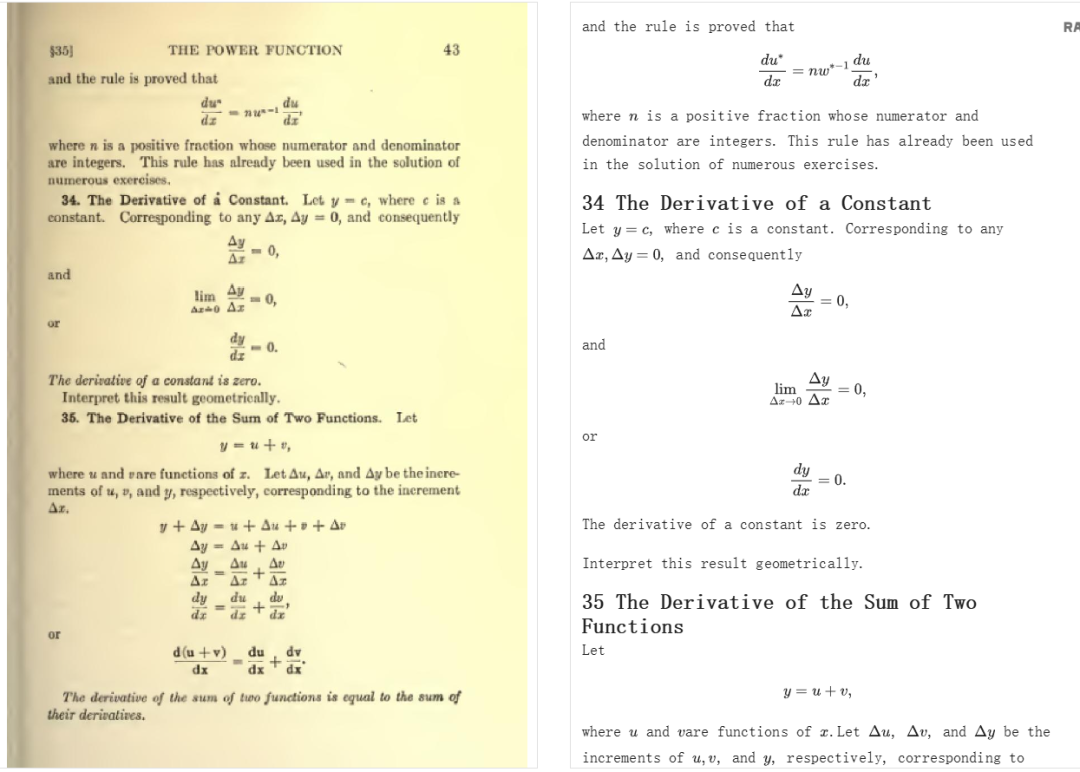
改进的做法是,把所有模态信息都转换为纯文本,再进行RAG。我们可以使用多种计算机视觉模型,比如检测模型对文档结构进行识别,然后对文档中不同的模块,使用不同的“广义OCR模型”进行解析。比如对于文本段落,使用OCR模型进行文本识别;对于表格,可以用表格模型进行识别转换为Markdown或LaTeX文本;对于公式,则套用公式识别转换为LaTeX;对于图片,则可使用多模态大模型如GPT-4o进行文本解读(caption),保存为文本描述。有很多开源的工具可以完成这些事情,比如MinerU等。通过解析算法,多模态数据就被完全转换为纯文本的格式了,也就可以照葫芦画瓢套用纯文本的RAG方法了。
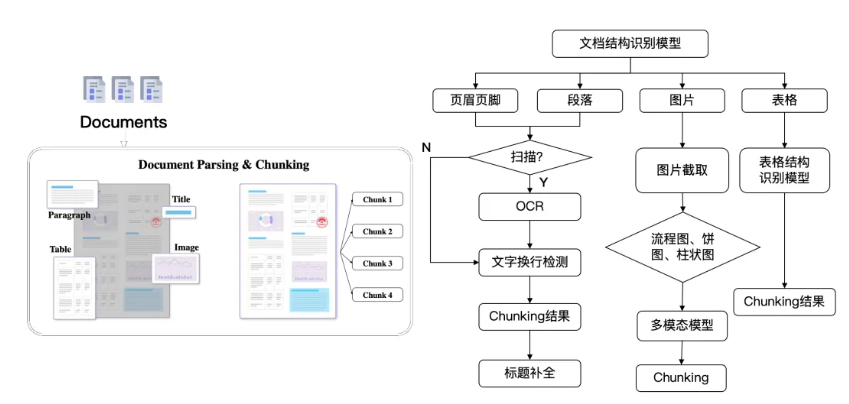
图像来源: 张颖峰 | 所见即所得:多模态RAG正在向我们走来

我们注意到,使用上述的方法,信息不可避免会存在丢失,而且依赖过多的解析模型。而时间来到2024年,多模态大模型实现了爆发式的技术突破,高分辨率的视觉输入已经取得了巨大突破,使用单一的多模态大模型做广义OCR也变得非常容易。比如QWen2-VL以及InternVL-2等开源多模态大模型,在文档的广义OCR上都有非常好的效果。
多模态大模型成功,让端到端(end-to-end)的算法已经成为了主流。原生多模态的RAG算法也成为了可能:既然多模态大模型有能力理解文本,那我们其实即无需再把图像转换为文本,而可以直接使用图像,提取embedding去做RAG。
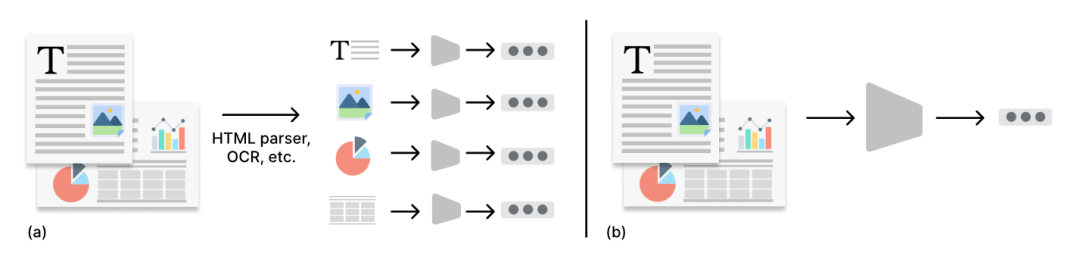
即从图(a)转变为图(b)的模式

DSE

https://arxiv.org/abs/2406.11251
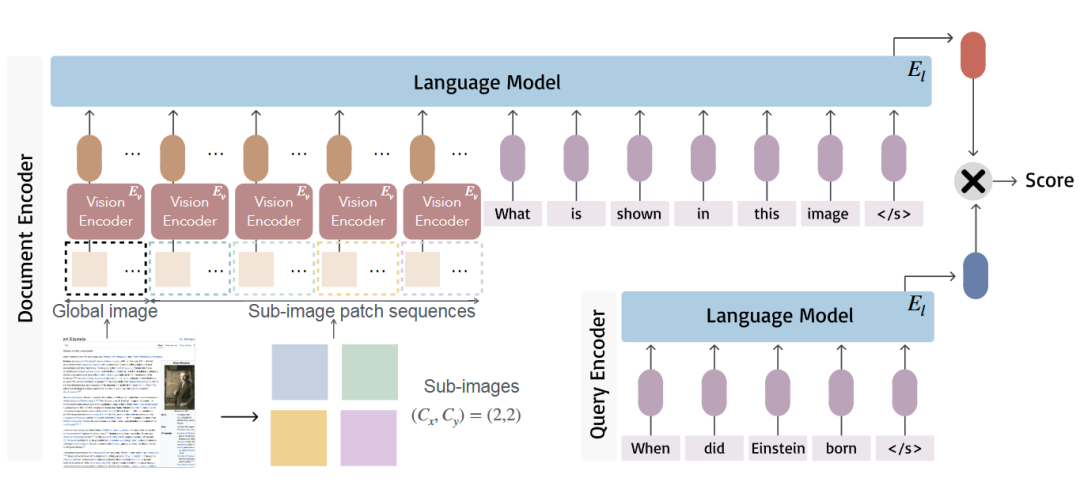
DSE,即Document Screenshot Embedding,是一个不使用广义OCR的多模态RAG方法,直接把原始文档的扫描图片,切片后,使用视觉语言模型的编码器编码。其对query和docunment使用了双编码的架构。验证了这一想法的可行性。

ColPali

https://arxiv.org/abs/2407.01449
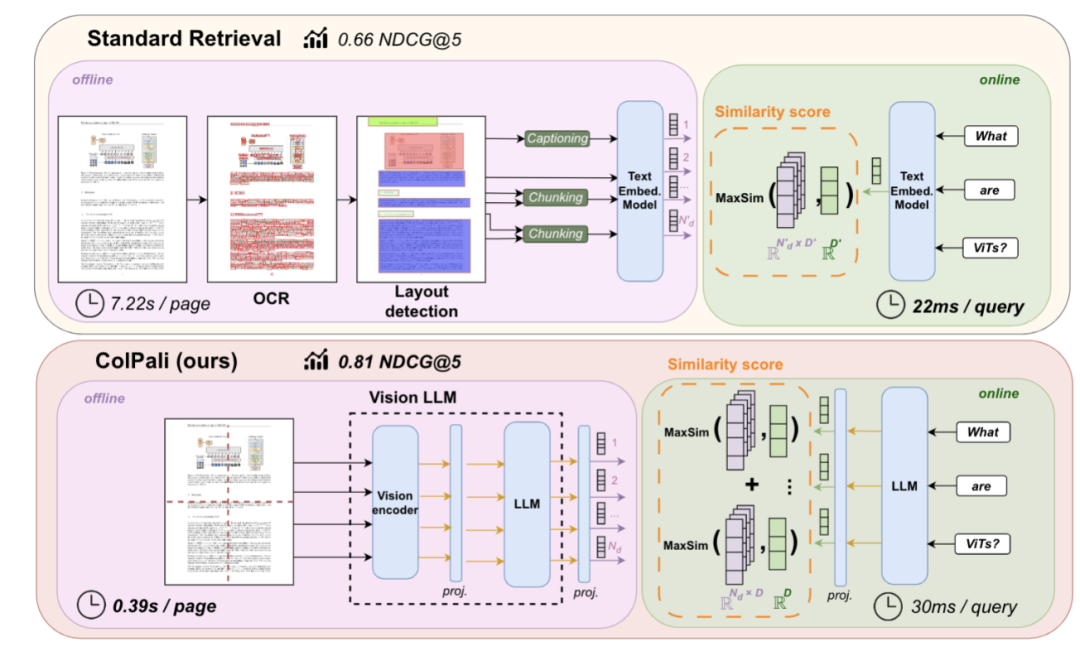
ColPali架构也是利用视觉语言模型来从文档页面的图像中产生高质量的上下文化嵌入。ColPali使用了延迟交互(late interaction)技术,大大提高了检索效率,同时在检索性能上超越了现有的文档检索系统,并且具有更快的处理速度和可端到端训练的特点。上图对比了传统的文档RAG与多模态RAG的区别。因为减少了广义OCR的解析过程,使得处理速度也有了质的提升。
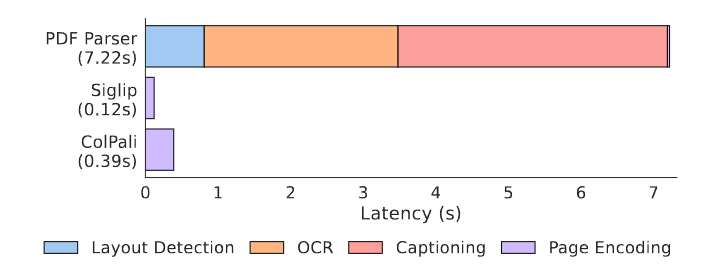
CoPali其实从名字上看,就知道灵感来源于两个工作,PaliGemma和CoBERT。PaliGemma 是 Google 开发的一款具有多模态功能的视觉语言模型,它结合了视觉模型 SigLIP 和大型语言模型 Gemma。“Col” 则来自于ColBERT 的延迟交互编码器。ColPali 算是延迟交互编码器在多模态 RAG 检索的应用,并且极大提高了检索召回的精度。

延迟交互编码结合了双编码器和交叉编码器的优点。在这种架构中,query和文档被分别编码成独立的embedding集合,然后通过一个高效的交互机制来计算它们之间的相似度。
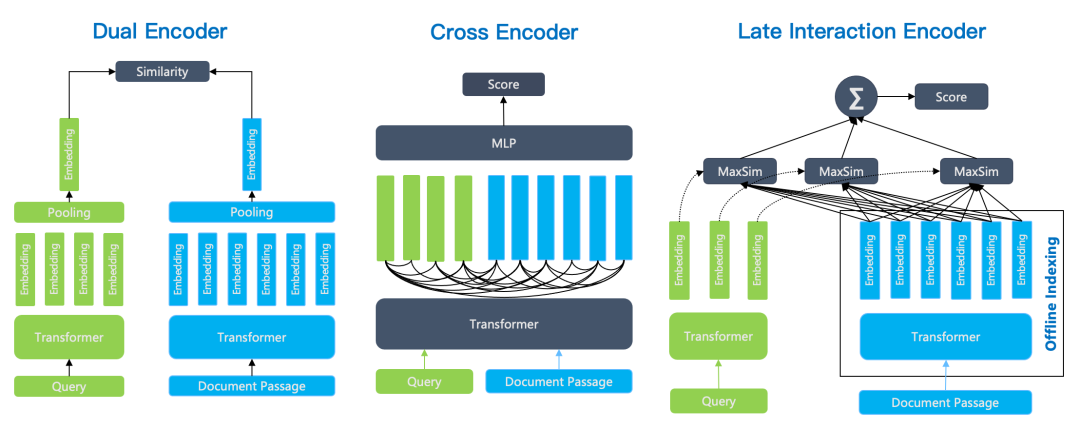
延迟交互编码的核心思想是将查询和文档的编码过程分开,这样文档的编码可以离线完成,而查询的编码则在在线阶段进行。这种方法的优点是可以在查询时仅对查询进行编码,从而大大提高了处理速度。此外,由于文档的编码是预先完成的,可以将其存储在数据库中,这样就可以对更多的文档进行排序,从而提高查询的精度。

在延迟交互编码中,一个关键的计算是最大相似性(MaxSim)函数,它计算每个查询Token向量与所有文档Token向量之间的相似度,并跟踪每个查询Token的最大得分。查询和文档的总相似度分数是这些最大余弦相似度分数的总和。这种方法允许模型在保持较高排序质量的同时,也具备较高的性能。

随着多模态大语言模型能力的增强,以它为基础的多模态RAG,也早已突破了传统的图像检索的应用方式,而是真正具备大规模非结构化多模态数据深度理解的能力,将会有更多toB的商业应用价值。

如何从零学会大模型?小白&程序员都能跟上的入门到进阶指南

当AI开始重构各行各业,你或许听过“岗位会被取代”的焦虑,但更关键的真相是:技术迭代中,“效率差”才是竞争力的核心——新岗位的生产效率远高于被替代岗位,整个社会的机会其实在增加。

但对个人而言,只有一句话算数:
“先掌握大模型的人,永远比后掌握的人,多一次职业跃迁的机会。”

回顾计算机、互联网、移动互联网的浪潮,每一次技术革命的初期,率先拥抱新技术的人,都提前拿到了“职场快车道”的门票。我在一线科技企业深耕12年,见过太多这样的案例:3年前主动学大模型的同事,如今要么成为团队技术负责人,要么薪资翻了2-3倍。

深知大模型学习中,“没人带、没方向、缺资源”是最大的拦路虎,我们联合行业专家整理出这套 《AI大模型突围资料包》,不管你是零基础小白,还是想转型的程序员,都能靠它少走90%的弯路:

  • ✅ 小白友好的「从零到一学习路径图」(避开晦涩理论,先学能用的技能)
  • ✅ 程序员必备的「大模型调优实战手册」(附医疗/金融大厂真实项目案例)
  • ✅ 百度/阿里专家闭门录播课(拆解一线企业如何落地大模型)
  • ✅ 2025最新大模型行业报告(看清各行业机会,避免盲目跟风)
  • ✅ 大厂大模型面试真题(含答案解析,针对性准备offer)
  • ✅ 2025大模型岗位需求图谱(明确不同岗位需要掌握的技能点)

所有资料已整理成包,想领《AI大模型入门+进阶学习资源包》的朋友,直接扫下方二维码获取~
在这里插入图片描述

① 全套AI大模型应用开发视频教程:从“听懂”到“会用”

不用啃复杂公式,直接学能落地的技术——不管你是想做AI应用,还是调优模型,这套视频都能覆盖:

  • 小白入门:提示工程(让AI精准输出你要的结果)、RAG检索增强(解决AI“失忆”问题)
  • 程序员进阶:LangChain框架实战(快速搭建AI应用)、Agent智能体开发(让AI自主完成复杂任务)
  • 工程落地:模型微调与部署(把模型用到实际业务中)、DeepSeek模型实战(热门开源模型实操)

每个技术点都配“案例+代码演示”,跟着做就能上手!

在这里插入图片描述

课程精彩瞬间

在这里插入图片描述

② 大模型系统化学习路线:避免“学了就忘、越学越乱”

很多人学大模型走弯路,不是因为不努力,而是方向错了——比如小白一上来就啃深度学习理论,程序员跳过基础直接学微调,最后都卡在“用不起来”。

我们整理的这份「学习路线图」,按“基础→进阶→实战”分3个阶段,每个阶段都明确:

  • 该学什么(比如基础阶段先学“AI基础概念+工具使用”)
  • 不用学什么(比如小白初期不用深入研究Transformer底层数学原理)
  • 学多久、用什么资料(精准匹配学习时间,避免拖延)

跟着路线走,零基础3个月能入门,有基础1个月能上手做项目!

img

③ 大模型学习书籍&文档:打好理论基础,走得更稳

想长期在大模型领域发展,理论基础不能少——但不用盲目买一堆书,我们精选了「小白能看懂、程序员能查漏」的核心资料:

  • 入门书籍:《大模型实战指南》《AI提示工程入门》(用通俗语言讲清核心概念)
  • 进阶文档:大模型调优技术白皮书、LangChain官方中文教程(附重点标注,节省阅读时间)
  • 权威资料:斯坦福CS224N大模型课程笔记(整理成中文,避免语言障碍)

所有资料都是电子版,手机、电脑随时看,还能直接搜索重点!

在这里插入图片描述

④ AI大模型最新行业报告:看清机会,再动手

学技术的核心是“用对地方”——2025年哪些行业需要大模型人才?哪些应用场景最有前景?这份报告帮你理清:

  • 行业趋势:医疗(AI辅助诊断)、金融(智能风控)、教育(个性化学习)等10大行业的大模型落地案例
  • 岗位需求:大模型开发工程师、AI产品经理、提示工程师的职责差异与技能要求
  • 风险提示:哪些领域目前落地难度大,避免浪费时间

不管你是想转行,还是想在现有岗位加技能,这份报告都能帮你精准定位!
在这里插入图片描述

⑤ 大模型大厂面试真题:针对性准备,拿offer更稳

学会技术后,如何把技能“变现”成offer?这份真题帮你避开面试坑:

  • 基础题:“大模型的上下文窗口是什么?”“RAG的核心原理是什么?”(附标准答案框架)
  • 实操题:“如何优化大模型的推理速度?”“用LangChain搭建一个多轮对话系统的步骤?”(含代码示例)
  • 场景题:“如果大模型输出错误信息,该怎么解决?”(教你从技术+业务角度回答)

覆盖百度、阿里、腾讯、字节等大厂的最新面试题,帮你提前准备,面试时不慌!
在这里插入图片描述

以上资料如何领取?

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

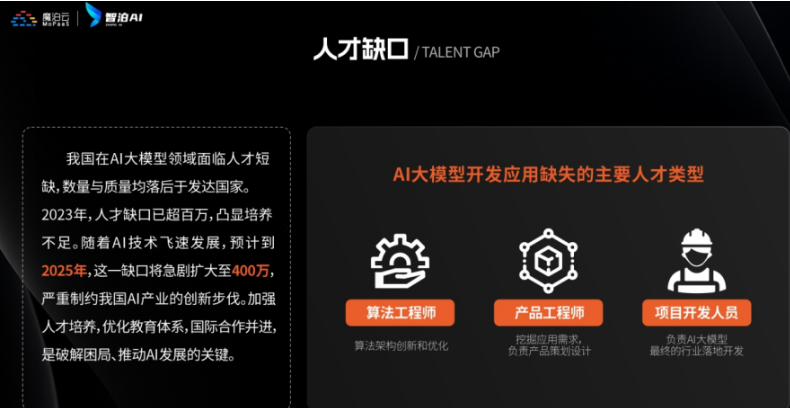
为什么现在必须学大模型?不是焦虑,是事实

最近英特尔、微软等企业宣布裁员,但大模型相关岗位却在疯狂扩招:

  • 大厂招聘:百度、阿里的大模型开发岗,3-5年经验薪资能到50K×20薪,比传统开发岗高40%;
  • 中小公司:甚至很多传统企业(比如制造业、医疗公司)都在招“会用大模型的人”,要求不高但薪资可观;
  • 门槛变化:不出1年,“有大模型项目经验”会成为很多技术岗、产品岗的简历门槛,现在学就是抢占先机。

风口不会等任何人——与其担心“被淘汰”,不如主动学技术,把“焦虑”变成“竞争力”!
在这里插入图片描述

在这里插入图片描述

最后:全套资料再领一次,别错过这次机会

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
加粗样式

探索检索增强生成(RAG)技术的无限可能:Vector+KG RAG、Self-RAG、多向量检索器多模态RAG集成 阅读详情

相关推荐

多模态RAG--能够应用于图片表格的RAG系统

多模态RAG(检索增强生成)技术突破传统文本限制,实现文本、图像、音频等多模态数据的检索与融合生成。其核心在于跨模态对齐与融合,通过多模态嵌入技术将异源数据映射到统一向量空间。关键技术包括:多模态编码器(CLIP等模型实现跨模态编码)、多模态检索器(支持跨模态匹配)和多模态生成器(输出复合内容)。针对PDF等复杂文档,需先进行多模态解析(文本/图像/表格提取),再通过统一嵌入或模态转换实现向量化。优化技巧包括文本补全、结构化QA生成、上下文增强和领域微调等。新兴的ColPali范式提出页级别联合编码,简化了

qq_52053775的博客 283

多模态RAG深度解析:揭秘AI新技术

多模态检索增强生成(Multimodal Retrieval Augmented Generation,简称RAG)是一种新兴的设计范式,允许AI模型与文本、图像、视频等多种信息存储接口进行交互。 在探讨这个主题时,我们首先会介绍什么是检索增强生成(RAG),多模态的概念,以及如何将两者结合以构建现代多模态RAG系统。在理解了多模态RAG的基本概念后,我们将使用Google Gemini和一种类似CLIP的编码模型来构建一个多模态RAG系统。

bugyinyin的博客 3147

300Kg载重履带式无人车底盘定制开发技术详解

通过精准的需求分析、科学的方案设计、严格的研发与测试以及完善的交付与培训流程,可以打造出符合客户需求的优质产品。300Kg载重履带式无人车底盘的定制开发,旨在打造一款承载能力强、行驶稳定、适应复杂地形的无人运输平台。根据应用场景选择合适的动力源,并进行性能优化,确保无人车在载重情况下仍能保持稳定的行驶速度和动力输出。根据需求分析结果,设计无人车底盘的总体方案,包括动力系统选择、结构设计、负载管理策略等。进行详细的研发工作,包括零部件的选型与采购、样机的制作与调试等。

专注多旋翼、复合翼无人机技术研究,从事低空经济行业。 958

从RAG到多模态RAG,收藏这一篇就够了!!!

什么是RAG:Retrieval Augmented Generation,检索增强生成。是一种结合了信息检索技术和大型语言模型提示功能的框架。它通过从数据源检索信息来辅助LLM生成答案,提高了模型在知识密集型任务中的准确性和可信度。

bugyinyin的博客 2066

Ollama-OCR实战:5分钟搞定PDF文档转Markdown(附qwen2.5vl模型配置)

本文详细介绍了如何利用Ollama本地部署多模态大模型qwen2.5vl,结合OCR技术,实现PDF文档到Markdown的端到端智能转换。通过解析传统OCR的局限与AI方案的优势,并提供从环境搭建、提示词工程到处理复杂表格的完整实战指南,帮助用户高效构建自动化文档处理流水线,彻底重塑文档处理工作流。

yog99的博客 606

UnicodeEncodeError: ‘ascii‘ codec can‘t encode characters in position 0-4: ordinal not in range(128)

python3报错处理:UnicodeEncodeError: ‘ascii’ codec can’t encode characters in position 0-4: ordinal not in range(128) 一、报错场景 // 报错代码 Traceback (most recent call last): File "test_autoo3_2.py", line 214, in <module> main() File "test_autoo3_2.py",

浪里小飞侠的博客 4201

多模态RAG架构:融合文本、图像与音频以提升AI生成能力

随着大模型在文本生成任务中取得显著成果,企业和研究者逐渐将目光转向更复杂的多模态任务场景,如图文问答、语音搜索、视频分析等,传统基于文本的检索增强生成(RAG)系统已经无法满足这些多样化需求,因此为了实现对图像、音频等非结构化数据的统一理解与利用,多模态RAG应运而生。RAG将检索器与生成器组合起来:在文本领域,RAG有效缓解了大模型的“幻觉”(Hallucination)问题,弥补了模型内部知识更新的不足,但在更复杂的实际业务中,用户提出的问题可能涉及图像内容、语音输入等,仅依赖文本检索已难以胜任,因此引

youmaob的博客 2831

AXI总线的Burst Type以及地址计算 | WRAP到底是怎么一回事?

AXI总线的transaction是burst-based的,因此有必要好好研究一下不同burst type的工作原理。此处略过burst的定义以及burst size、burst length等信号的介绍。

qiuzhongyu123的博客 2万+

收藏!一文读懂:从RAG到多模态RAG,AI产品经理技术落地避坑指南

文章详细介绍了RAG到多模态RAG的三阶段演进:"伪多模态"转文字、"真多模态"跨模态检索、"智能体化"主动规划。从AI产品经理视角出发,解析了技术选型、架构设计原则,分享了7个实践坑及解决方案。强调技术应服务于实际问题,建议根据用户需求和团队能力理性选择,不必盲目追新。

2401_84815887的博客 1143

ai获客系统功能代码

AI 获客系统是一个复杂的体系,以下为你提供一个简化的 Python 示例,聚焦于客户行为分析与销售线索筛选功能,模拟实现从多渠道收集数据后的初步处理流程。假设已有从官网、线上商城等渠道收集到的客户数据,以字典列表形式存储,每个字典包含客户基本信息及购买行为数据。通过分析客户购买频率与金额,筛选出高价值销售线索。python上述代码仅为基础示例,实际 AI 获客系统还涉及更复杂的数据采集、清洗、存储,以及运用机器学习算法进行深度客户洞察等功能。

weixin_ggwwsscc的博客 892

使用DrissionPage和自动化技术实现得物鞋子信息爬取

本文介绍了一个基于DrissionPage技术的得物鞋子信息采集系统,能自动化采集商品图片、价格等数据并保存为Excel。系统采用浏览器模拟技术处理动态加载内容,通过XPath定位元素,实现智能交互和完整数据采集。关键技术包括:图片URL提取与下载、Excel数据集成与图片嵌入、文件名安全处理等。项目适用于市场分析和学术研究,强调必须遵守法律法规和平台规则,仅用于非商业用途。与API爬虫相比,浏览器自动化能更好处理现代Web应用,但需注意知识产权保护。

那些看似不起波澜的日复一日,会在某天让你看到坚持的意义 1666

【值得收藏】一文掌握多模态大模型:RAG架构详解与PDF多模态处理实战

在现实世界中,信息从不以单一模态呈现。人类的日常感知依赖于多种模态的协同输入,包括视觉、听觉、语言、触觉等,这些感知共同构成了我们对世界的整体理解。当研究任务或数据涉及多种模态信息时,我们将其称为“多模态问题”(Multimodal Problem)。有效应对这类问题,是推动人工智能系统向类人认知迈进、实现“类人智能”的关键一步。正因如此,多模态大型语言模型(Multimodal Large Language Models,MLLM)应运而生。

weixin_59191169的博客 1093

前端使用二开Thingsboard一、二、三事(三)-规则链

以项目实战为基础,逐步介绍前端在thingsboard系统二次开发中的一些注意事项以及一些thingsboard一些页面功能讲解,为前端人员开发使用thingsboard提供一种可靠思路,打造一个完美的物联网系统。

weixin_43163457的博客 863

收藏必备!一文搞懂多模态RAG:让AI从“书呆子“变成“图文并茂解读专家“

多模态RAG技术结合了RAG检索增强生成和多模态AI处理能力,使AI不仅能"读书翻资料",还能看图、听音,边查边答。该技术通过视觉编码、向量检索、Prompt拼接和生成答案四步流程实现,已在医疗影像、电商客服、教育辅助等领域应用。未来将向感知能力升级、知识匹配更智能、边缘部署+行业落地方向发展,让AI成为真正的多感官、知识型、交互式超级助手。

2401_85375186的博客 798

9 硬件工程师笔面试高频知识考点真题解析——运算放大器

运算放大器(运放)摘要 运放是一种高增益、差分输入的模拟集成电路,具有虚短(线性区输入电压相等)和虚断(输入电流为零)特性,支持负反馈(线性放大)和开环/正反馈(饱和区比较)两种工作模式。关键特性包括高输入阻抗、低输出阻抗,理想运放参数(如无限增益)与实际参数(如有限带宽)的差异。 选型要点: 信号特性:直流/低频信号关注失调电压(Vos)、温漂;高频信号侧重带宽(GBW)和压摆率(SR)。 电源条件:单/双电源供电、电压范围及功耗需求(如电池设备需低静态电流)。 精度与噪声:微弱信号需低噪声运放,高精度场

XU157303764的博客 1675

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

收藏!腾讯云RAG落地全攻略:从文档解析到多模态,看这一篇就够了!

RAG(检索增强生成)技术被视为解决大模型幻觉和知识局限的关键路径,但其落地实践在文档处理、检索和理解等环节面临诸多挑战。

xx_nm98的博客 962

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

多模态 RAG vs 传统 RAG:核心差异 + Agent 角色,大模型学习收藏这篇!

多模态 RAG vs 传统 RAG:核心差异 + Agent 角色,大模型学习收藏这篇!

m0_48891301的博客 1217

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【建议收藏】多模态RAG核心三剑客:CLIP嵌入、多模态提示、工具调用,从理论到实践

多模态RAG技术解析与实践指南 本文系统介绍了构建多模态RAG系统的三大核心技术:CLIP嵌入实现跨模态检索、多模态提示支持混合输入、工具调用整合外部能力。通过对比学习将图像与文本映射到同一向量空间,结合结构化提示设计和外部工具调用机制,构建了完整的工程实现方案。 文章提供了详细的技术实现路径,包括: CLIP嵌入的对比学习原理与工程部署方法 多模态提示的结构化设计策略 工具调用的接口规范与容错机制 完整的系统架构设计模板 针对实际应用场景,给出了数据处理、微调优化、错误处理等工程实践建议,帮助开发者构建可

ytt0523_com的博客 1008

RAG-Anything:多模态RAG的全能王者,AI文档处理的终极形态!大模型入门到精通,收藏这篇就足够了!

在AI圈混久了,大家都知道RAG(Retrieval-Augmented Generation)是大模型落地的“黄金搭档”。但你有没有发现,现实世界的文档早已不是单纯的文本堆砌?

2301_81940605的博客 1140

AI大模型常见的8种RAG框架,你知道几种?建议收藏!!

朴素 RAG 仅基于查询向量与存储向量之间的相似度检索文档。 适用于简单、以事实为主的查询,只需直接语义匹配即可。

嘴巴吃糖了 1156

收藏必备!五大RAG框架全解析:从通用到多模态,助你快速掌握大模型应用

文章系统介绍五大类RAG框架:通用型(Haystack/RAGFlow/UltraRAG)、知识图谱增强型(KAG/NodeRAG/Fast GraphRAG)、多模态(RAG-Anything/VisRAG)、高性能优化(FlashRAG/HippoRAG 2)及自动化持续学习型(GoMate/LongRAG),针对不同场景提供选型建议,帮助开发者快速落地大模型应用,降低开发门槛并提升检索效率。

2401_84815887的博客 722

干货分享:RAG文档预处理与Embedding最佳实践,收藏学习提升大模型回答质量!

文章介绍了RAG系统中文档预处理的重要性和方法。详细阐述了三种文档处理形式及其优缺点,提供了关键处理技巧,并讨论了文档中图像的三种处理方式。正确的文档预处理能提高RAG系统的检索效率和准确性,避免大模型产生幻觉,是构建高效RAG系统的关键步骤。

嘴巴吃糖了 697

多模态RAG知识库构建:从文档解析到向量存储的完整预处理链路

检索增强生成(RAG)通过将外部知识注入大模型,成为缓解幻觉、提升专业问答准确性的核心方案。然而,多模态RAG知识库的落地效果,往往在数据预处理阶段就已决定——文档解析不彻底、表格结构被拍平、图表语义未理解,都会让检索与生成环节“巧妇难为无米之炊”。从PDF、Word到扫描件,从版面分析、表格归一化到图文关联,再到OCR与视觉模型对图表的深层理解,每一道工序都在降低信息损耗。配合合理的文本切分、清洗增强、向量化与存储优化,才能让知识库从“能搜到”跨越到“能答对”。本文以工程实践视角,拆解RAG多模态数据预处

weixin_28689193的博客 253

【必收藏】多模态RAG革命:测试工程师的自动化新利器,告别“看字不看图“的局限

文章详细介绍了多模态RAG(特别是RAG-Anything)如何解决传统RAG只能处理文本的局限性。多模态RAG能直接理解图片、表格、公式等非文本内容,无需依赖OCR,自动建立跨模态语义关联,显著提升测试覆盖率和准确性。通过金融报告核对、医疗影像测试等场景实战展示,多模态RAG实现了测试智能化、效率翻倍和准确率提升,为测试工程师提供了更全面、更精准的自动化测试解决方案。

2401_85375186的博客 694
上一篇: 2026年AI校招趋势深度解析:高薪赛道、行业需求与人才竞争新逻辑
下一篇: 程序员慌了?一边裁员一边抢 AI 人才!一文看懂 AI 如何重塑就业,小白学大模型必看
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值