DeepSeek+本地知识库:真的太香了(修订版)

告别云端API调用!手把手教你用Ollama+AnythingLLM在Windows/Mac上搭建个人DeepSeek知识库 本文详细介绍了如何在Windows/Mac上使用Ollama和AnythingLLM搭建本地DeepSeek知识库,实现高效、隐私安全的AI文档处理。通过环境配置、模型优化和知识库构建的实战指南,帮助用户摆脱云端API限制,打造个性化的专业AI助手。 阅读详情

把之前的deepseek +本地知识库的部署内容做了一版,

增加内容:

1, ollama 安装

2,cherry studio在线模型配置

3,anythingLLM的在线以及文本分割配置

先画个数据流程流程。

图片

Ollama安装(非必须)

14B及以上有推理能力,32b比较实用。显卡最低12GB。内存最好32GB.

相关的软件,我已经放入到网盘,网不好的同学,可以直接下载。

下载链接:https://pan.quark.cn/s/b69829720b68

电脑配置低:可以参考

服务器繁忙,电脑配置太低,别急deepseek满血版来了

下载ollama

https://ollama.com/download/

默认为当前电脑的对应的版本,直接下载即可。下载以后,一路点点点即可。

环境变量设置

安装完以后先不要使用,先设置下环境变量。默认模型下载到C盘。一个模型最小也得几个GB.

通过 我的电脑->右键-> 属性-> 高级系统设置-> 环境变量->新建用户变量即可。

图片

OLLAMA_HOST: 0.0.0.0 
OLLAMA_MODELS:E:\ai\ollama\models

OLLAMA_HOST:设置为0.0.0.0 会将ollama服务暴露到所有的网络,默认ollama只绑定到了127.0.0.1,只能通过localhost或127.0.0.1访问。

OLLAMA_MODELS:设置了模型的存放的地址。

https://ollama.com/library/deepseek-r1

安装DeepSeek模型(可选)

打开:https://ollama.com/library/deepseek-r1
选择适合自己的模型,12GB~16GB显存建议最大选择14B,24GB显存建议32B.

安装语言模型

# 下载模型
ollama pull deepseek-r1:14b
# 下载或运行模型,正常ollama不会运行模型的
ollama run deepseek-r1:14b

安装向量模型

基于本地的deepseek搭建个人知识库。使用本地服务,安装嵌入模型,用于将文本数据转换为向量标识的模型。

# 命令行窗口执行拉取下即可。
ollama pull bge-m3

基于Cherry Studio搭建(首选)

cherry Studio 文本分割不能选择文本长度和重叠度。

下载cherry studio

根据自己的环境下载cherry studio

图片

安装的时候,注意安装到其他磁盘,不要在c盘安装。

本地模型知识库

配置本地ollama

图片

图片

操作步骤:

  1. 找到左下角设置图标
  2. 选择模型服务
  3. 选择ollama
  4. 点击管理
  5. 点击模型后面的加号(会自动查找到本地安装的模型)
  6. 减号表示已经选择了

配置在线模型:

图片

1,在模型服务里,选择对应的模型服务商,比如硅基流动

2,注意开关

3,填写自己的密钥

图片

1,选择嵌入模型

2,选择要添加的模型

知识库配置

图片

  1. 选择知识库
  2. 选择添加
  3. 选择嵌入模型,这个时候有在线和本地的
  4. 填写知识库名称
添加知识文档

cherry可以添加文档,也可以添加目录(这个极其方便),添加完以后出现绿色的对号,表示向量化完成。

图片

搜索验证

图片

  1. 点击搜索知识库
  2. 输入搜索顺序
  3. 点击搜索 大家可以看下我搜索的内容和并没有完全匹配,不过已经和意境关联上了。
大模型处理

图片

  1. 点击左上角的聊天图标

  2. 点击助手

  3. 点击默认助手(你也可以添加助手)

  4. 选择大模型

  5. 选择本地deepseek,也可以选择自己已经开通的在线服务

  6. 设置知识库(不设置不会参考)

  7. 输入提问内容

  8. 发问图片

大家可以看到deepseek已经把结果整理了,并告诉了我们参考了哪些资料。

满血版

差别就是大模型的选择,在模型服务里配置下在线的deepseek服务即可。

如果你的知识库有隐私数据,不要联网!不要联网!不要联网!

方案二 基于AnythingLLM搭建

下载AnythingLLM Desktop

图片

下载以后,安装的时候,注意安装到其他磁盘,不要在c盘安装。

AnythingLLM 配置

图片

点击左下角的设置

Ollama配置

图片

\1. 点击 LLM首选项

\2. 选择ollama作为模型提供商

\3. 选择已安装的deepsek 模型

\4. 注意下地址,如果本地就127.0.0.1

\5. 保存

腾讯云配置(推荐,目前最稳定的)

图片

1,选择openAi通用接口

2,配置腾讯云的大模型BASE地址 : https://api.lkeap.cloud.tencent.com/v1

3,配置获取到的APIKEY

4,输入模型:deepseek-r1

5, 设置Token context window 模型单次能够处理的最大长度(输入+输出),如果你的使用知识库建议放大,想多关联上下文也调大;
6,max tokens 模型最大生成token

apiKey申请地址

https://console.cloud.tencent.com/lkeap/api

接口地址

https://cloud.tencent.com/document/product/1772/115969

ollama show deepseek-r1:14b
  Model
    architecture        qwen2    
    parameters          14.8B    
    context length      131072    
    embedding length    5120    
    quantization        Q4_K_M

14b的最大长度是131072,ollama 默认是不用设置的。

向量库模型配置

图片

切换使用本地ollama,也可以自带的。

1,选择ollama

2,选择对应的向量模型

3,设置分段最大长度

4,注意下url

文本分割配置

图片

1,设置文本块大小,根据自己的文本输入。

2,设置文本块重叠(建议重叠10%~25%)

配置工作区

图片

图片

  1. 在1里点击New Thread 新建一个聊天框
  2. 默认会话
  3. 上传知识库文档

图片

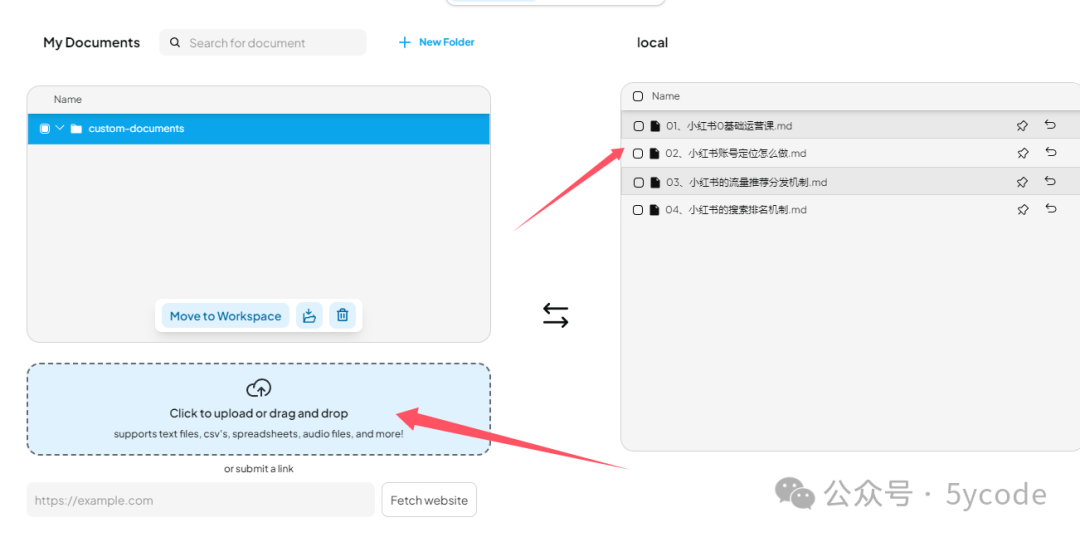
将文档拖拽到上传框。ps: 只需要拖拽一次就行了,它在聊天框能看到。不知道为什么,我这拖拽以后,没看到上传成功,然后又拖拽了几次。然后聊天框就好多份。
图片

图片

当然你可以配置远程文档,confluence、github都可以。

图片

ps: 需要注意的是文档在工作区间内是共用的。

api功能

AnythingLLM 可以提供api访问的功能,这个可以作为公共知识库使用。

图片

总结

整个操作下来,AnythingLLM 的体验没有cherry好。AnythingLLM就像一个包壳的web应用(后来查了下,确实是)。AnythingLLM 得具备一定的程序思维,给技术人员用的。非技术人员还是使用cherry吧。作为喜欢折腾的开发人员,我们可以结合dify使用。

最后

个人知识库+本地大模型的优点

  • 隐私性很好,不用担心自己的资料外泄、离线可用
  • 在工作和学习过程中对自己整理的文档,能快速找到,并自动关联
  • 在代码开发上,能参考你的开发习惯,快速生成代码

DeepSeek无疑是2025开年AI圈的一匹黑马,在一众AI大模型中,DeepSeek以低价高性能的优势脱颖而出。DeepSeek的上线实现了AI界的又一大突破,各大科技巨头都火速出手,争先抢占DeepSeek大模型的流量风口。

DeepSeek的爆火,远不止于此。它是一场属于每个人的科技革命,一次打破界限的机会,一次让普通人也能逆袭契机。

DeepSeek的优点

read-normal-img

掌握DeepSeek对于转行大模型领域的人来说是一个很大的优势,目前懂得大模型技术方面的人才很稀缺,而DeepSeek就是一个突破口。现在越来越多的人才都想往大模型方向转行,对于想要转行创业,提升自我的人来说是一个不可多得的机会。

那么应该如何学习大模型

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。

read-normal-img

掌握大模型技术你还能拥有更多可能性:

• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;

• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;

• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;

• 更优质的项目可以为未来创新创业提供基石。

可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。为了让大家少走弯路,少碰壁,这里我直接把都打包整理好,希望能够真正帮助到大家。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】在这里插入图片描述

👉AI大模型学习路线汇总👈

大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

read-normal-img

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;

第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;

第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

read-normal-img

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

read-normal-img

read-normal-img

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

read-normal-img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】在这里插入图片描述

从零到一:用Python+Ollama+AnythingLLM给你的DeepSeek模型“喂”专业资料,打造行业知识库AI 本文详细介绍了如何利用Python+Ollama+AnythingLLM技术栈,将通用DeepSeek模型转化为特定领域的专业知识库AI。通过本地部署和领域知识预处理,结合系统提示词工程化设计,实现企业级集成方案,并持续优化与效果评估,打造高效的行业知识库AI。 阅读详情

相关推荐

DeepSeek国产大模型工程实践:知识库构建与摩尔线程适配指南

大模型知识库系统是企业AI落地的核心基础设施,其本质是将非结构化知识转化为可检索、可验证、可演进的机器可执行规则。实现高可用需兼顾语义理解精度、长上下文稳定性与国产硬件适配能力。DeepSeek通过三阶语义切片、动态水印追溯、MoE稀疏调度等工程创新,在中文政策合规、金融风控等强规则场景中显著提升信息抽取准确率与推理确定性。结合摩尔线程MTT S4000显卡深度优化,达成FP16下92% A100吞吐效率,为信创环境提供从模型训练、推理部署到知识治理的全栈可控方案。

weixin_30666401的博客 352

DeepSeek + 本地知识库:真的太香了!保姆级教程,建议收藏!

大家好,我是玄姐。正文开始之前,先给我自己打个广告,大家开工大吉,为了回馈粉丝们的支持,原价199元的《基于 DeepSeek 打造的 AI Agent 智能体项目实战直播训练营》,直接降价到19元,今天再开放一天报名特权,仅限99名。回到正题。这个春节,DeepSeek 实在太火爆了。今天分享下 DeepSeek + 本地知识库的部署。先看个全局数据流程图,如下图所示。基于本地的 DeepS...

musicml的博客 2万+

我的读书笔记进化史:从摘抄本到AI知识库,用DeepSeek读透100本电子书

本文分享了作者如何利用DeepSeek从传统摘抄本进化到AI知识库的历程,详细介绍了DeepSeek在跨书智能关联、动态知识保鲜、对话式知识生产和个性化记忆强化等方面的突破,帮助读者高效管理并活用100+本电子书的知识。

weixin_27966471的博客 264

Deep Seek R1本地化部署

【说明】操作系统:win10。使用工具:ollama

晨曦之光Wing的博客 7073

DeepSeek-v4深度解析:长上下文稳定性与本地部署实战指南

大语言模型的长上下文处理能力是RAG、代码分析、金融文档理解等关键场景的基础技术前提。其核心原理在于KV缓存管理机制与注意力计算效率的协同优化,技术价值体现在推理稳定性提升、显存占用可控及量化友好性增强。典型应用场景包括本地化AI工具开发、边缘设备部署、生产级API服务构建。DeepSeek-v4通过分段式静态KV缓存池、FlashAttention-3深度适配与开箱即用的交付链路设计,在128K上下文实际可用率(99.3%)和Hugging Face镜像下载稳定性两大痛点上实现突破,为开发者提供高确定性的

weixin_31162247的博客 308

DeepSeek实用资料大礼包!持续更新,建议收藏~

百度网盘: 链接:https://pan.baidu.com/s/14VAPW-qTw6FsBg6_dIbCNQ?pwd=6666 提取码:6666 夸克网盘: 链接:https://pan.quark.cn/s/c39017297a38 最近好多朋友在问:DeepSeek更新太快了怎么跟?教程太分散哪里找?贴心的整理狂魔我来了!熬夜把最新使用攻略打包成了「从入门到高手」的全套资料,包含: 小白也能懂的三大入口: 网页版直接玩(打开就用) API密钥怎么拿(附详细步骤) 本地安装教程(连常见报错都整理了) 打工人效率秘籍: 让AI听懂人话的提问模板 处理文字/图片的隐藏技巧 写代码、做方案的真实案例(金融/教育场景都有) 特别提醒:官方每周都在更新!网盘里的资料也会同步升级,现在领了以后永远能看到最新版! (完整资料包获取方式:上面有网盘链接 ,失效了记得私信踢我补档) deepseek从入门到精通

deepseek本地部署,ragflow,docker

打开docker,不用sign in,直接continue,skip,到如下界面,可以看到已经启动,container memory usage 为9.23GB,就是前面ollama run deepseek-r1:14b,下载的模型大小。我个肺雾,我一直以为是网络不通,在调ip,环境变量,防火墙(还报错,可能防火墙拦截了,直接关掉)找到ollama,添加模型,deepseek是chat模型,选择chat,模型名称可以在cmd-ollama list查看。登录过后,点击1.右上角头像;

qin_shang_的博客 1388

实战解析:基于Python的APT攻击检测与ATT&CK框架应用

本文通过实战案例,详细解析了如何利用Python编程语言结合MITRE ATT&CK框架,构建一套针对高级持续性威胁(APT)的自动化检测与狩猎系统。文章涵盖了从环境搭建、核心检测逻辑编写、到模块化框架设计与主动威胁狩猎的全过程,为安全从业者提供了可落地的技术方案,以有效应对复杂的网络攻击。

weixin_29044157的博客 390

一分钟搭建本地私有AI大模型DeepSeek-R1

Ollama:可以理解为是docker,快速安装各种大模型,下载后一键安装。这里你可以搜索自己想安装的模型,获取不同的命令。好了,就这么简单,搭建私服AI完成。安装完成后,提示输入信息。

JEECG官方博客 5089

FPGA设计中的扇出约束实战:从XDC到代码优化的全流程解析

本文全面解析FPGA设计中扇出约束的重要性与应用,详细介绍了从XDC约束文件设置到HDL代码优化的全流程实战技巧。通过MAX_FANOUT约束控制信号负载,结合寄存器复制和物理优化策略,有效解决高扇出导致的时序违例和布线拥塞问题,提升设计性能和可靠性。

nept的博客 798

A股历史数据免费下载终极指南:4000+个股数据一键打包获取

本文提供了获取A股历史数据的完整免费方案,重点介绍了Tushare Pro、AkShare等开源金融数据API的使用方法。通过详细的Python脚本示例,指导读者如何自动化批量抓取、清洗、存储4000多只个股的历史行情数据,并分享数据质量校验与性能优化技巧,助力量化研究与市场分析。

ooo22的博客 2255

DeepSeek兼容性评估,企业DeepSeek部署配置选择

昨天压测完以后,今天群里的小伙伴讨论的很热烈,有个小伙伴推荐了一个工具。覆盖两个场景。

yxkong的专栏 1478

手把手教你用三菱PLC控制JET伺服原点:从硬件接线到GXWORKS3程序调试

本文详细介绍了如何使用三菱PLC控制JET伺服系统实现原点回归功能,涵盖硬件接线、参数配置到GX Works3程序调试的全流程。通过实战指南,帮助工程师快速掌握伺服控制技术,提升工业自动化项目的实施效率。

weixin_30642561的博客 536

dify外挂ragflow+千问QWQ,解决dify解析和检索短板

之前一直有粉丝留言说让我出一个dify+ragflow的教程,今天来实操下。

yxkong的专栏 2644

PCB布线避坑指南:为什么你的差分线等长总调不好?AD19蛇形等长技巧详解

本文详细解析了AD19环境下PCB差分线等长调整的核心技巧与常见问题。从差分信号等长的底层逻辑到AD19规则配置,再到蛇形等长高级技巧和信号完整性验证,帮助工程师解决差分线等长调整中的难题,提升高速PCB设计的信号质量。

weixin_28738397的博客 387

matlab锅炉 pid仿真,基于Matlab锅炉仿真.doc

基于Matlab锅炉仿真内蒙古科技大学MATLAB课程设计任务书2012题 目:锅炉汽包水位控制系统学生姓名:林三彪学 号:0967112127专 业:测控技术与仪器班 级:2009-1指导教师:梁 丽摘 要锅炉是化工、炼油、发电、造纸和制糖等工业生产过程中必不可少的重要动力设备。锅炉往往成了不少工厂不可缺少的一部分,因而,对锅炉设备中的自动控制系统进行分析研究是必要的...

weixin_29133981的博客 1096

Kalman滤波笔记整理(deepseek修订版)

XkΦk∣k−1Xk−1Γk−1Wk−1Xk​Φk∣k−1​Xk−1​Γk−1​Wk−1​Xk∈RnXk​∈Rn:系统状态向量Φk∣k−1∈Rn×nΦk∣k−1​∈Rn×n:状态转移矩阵Γk∈Rn×pΓk​∈Rn×p:过程噪声耦合矩阵Wk∼N0QkWk​∼N0Qk​:高斯白噪声过程,协方差Q。

2301_77111187的博客 703

7、布尔网络的基础定义

本文介绍了布尔网络的基础定义及其在系统生物学中的应用。布尔网络是一种描述复杂系统动态行为的数学模型,由布尔变量和布尔函数组成,能够模拟生物系统中基因调控、信号传导和细胞代谢等过程。文章详细阐述了布尔网络的基本结构、动力学特征(如状态转移图和吸引子),以及其在生物建模中的重要价值,并探讨了优化和简化技术(如Backward Boolean Equivalence)如何提升其计算效率。

yhn45678901的博客 268

DeepSeek高效指南:5个提示词技巧,让你的AI问答质量翻倍

*进阶技巧:**为DeepSeek添加 双重身份标签 ,例如:“你既是资深数据分析师,又是擅长科普写作的科技记者,请用投资人听得懂的语言 ,解读以下半导体行业财报中的毛利率变化原因”**防“幻觉”技巧:**添加限制条件:“请基于 2025年《网络安全法》最新修订版 ,分析人脸识别技术在社区安防中的应用风险,不要包含未被官方确认的推测内容”“我正在准备新能源汽车行业的投资报告,需要2025年全球TOP5厂商的 电池技术对比 ,请用表格呈现关键参数,并附200字的技术趋势分析”“帮我分析经济形势”

m0_71745258的博客 2065

终于找到了!Ubuntu 虚拟机卡死的终极解决方案(如何解决VMware安装Ubuntu24.04桌面进不去、黑屏、虚拟机卡死、显示不全、屏幕闪烁等问题)

终于找到了!Ubuntu 虚拟机卡死的终极解决方案(如何解决VMware安装Ubuntu24.04桌面进不去、黑屏、虚拟机卡死、显示不全、屏幕闪烁等问题)

XiaoqiangClub的博客 1万+

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

DeepSeek-R1-Distill-Qwen-1.5B与LangChain集成:构建企业级知识库问答系统

本文介绍了如何在星图GPU平台上自动化部署🐋 DeepSeek-R1-Distill-Qwen-1.5B 本地智能对话助手 (Streamlit 驱动)镜像,结合LangChain构建企业级知识库问答系统,典型应用于制造业技术文档的实时检索与精准问答,如设备维护手册查询、故障排除指导等场景。

weixin_31459297的博客 322

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: 转行AI大模型算法工程师,如何在人工智能领域实现职业跃迁
下一篇: 10分钟看明白爆火的本地知识库! 掌握本地知识库基本概念与RAG的完整架构
冻感糕人~
博客等级 码龄3年 8926粉丝 2393原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值