学会使用langchain+openai+qdrant建立第一个RAG应用

大模型应用开发框架 LangChain 学习笔记 一时间大模型如百花齐放,百鸟争鸣,并在向各个行业领域渗透,让人感觉通用人工智能仿佛就在眼前。基于大模型开发的应用和产品也如雨后春笋,让人目不暇接,每天都有很多新奇的应用和产品问世,有的可以充当你的朋友配你聊天解闷,有的可以充当你的老师帮你学习答疑,有的可以帮你写文章编故事,有的可以帮你写代码改 BUG,大模型的崛起正影响着我们生活中的方方面面。正是在这样的背景下,为了方便和统一基于大模型的应用开发,一批大模型应用开发框架横空出世,LangChain 就是其中最流行的一个。正如前文所述,LangChain 是 阅读详情

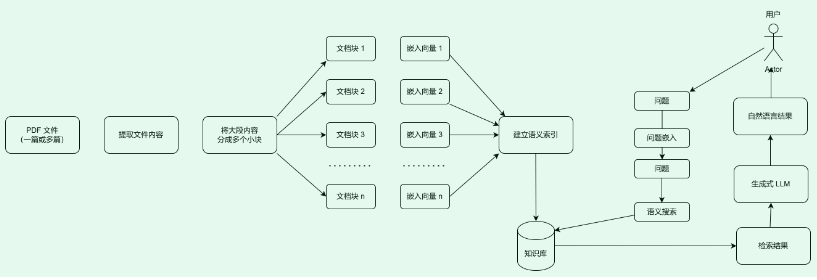
LLM 支持的最强大的应用程序之一是复杂的问答 (Q&A) 聊天机器人。这些应用程序可以回答有关特定源信息的问题。这些应用程序使用一种称为检索增强生成 (RAG) 的技术。
图片

什么是 RAG?

RAG 是一种通过附加数据增强 LLM 知识的技术。

LLM 可以推理广泛的主题,但它们的知识仅限于它们接受训练的特定时间点的公共数据。如果你想构建能够推理私有数据或模型截止日期后引入的数据的 AI 应用程序,则需要使用模型所需的特定信息来增强模型的知识。将适当的信息插入模型提示的过程称为检索增强生成 (RAG)。

典型的 RAG 应用程序有两个主要组件:

  • 索引:从源中提取数据并对其进行索引的管道。这通常是离线进行的。
  • 检索和生成:实际的 RAG 链,它在运行时接受用户查询并从索引中检索相关数据,然后将其传递给模型。

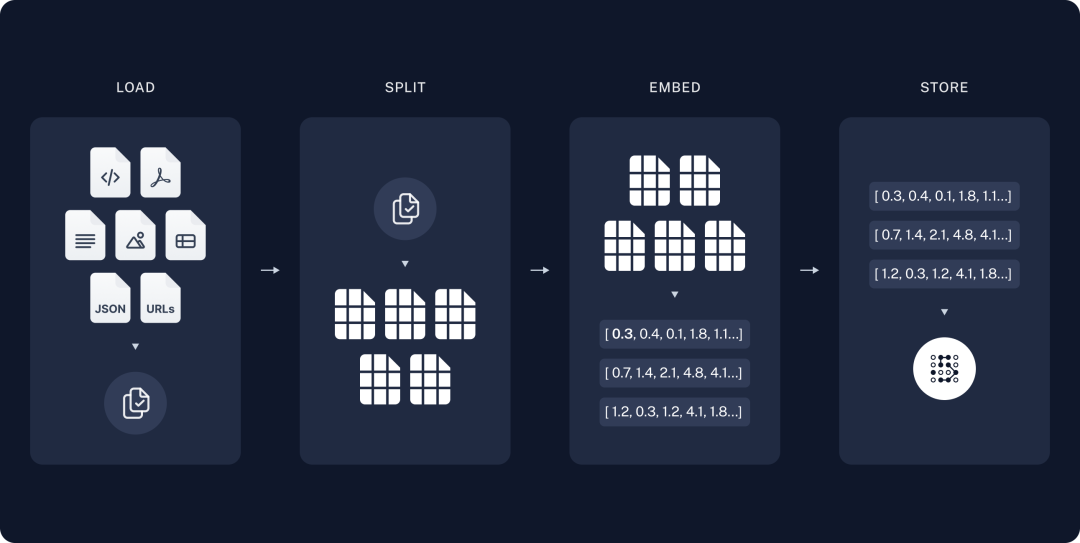
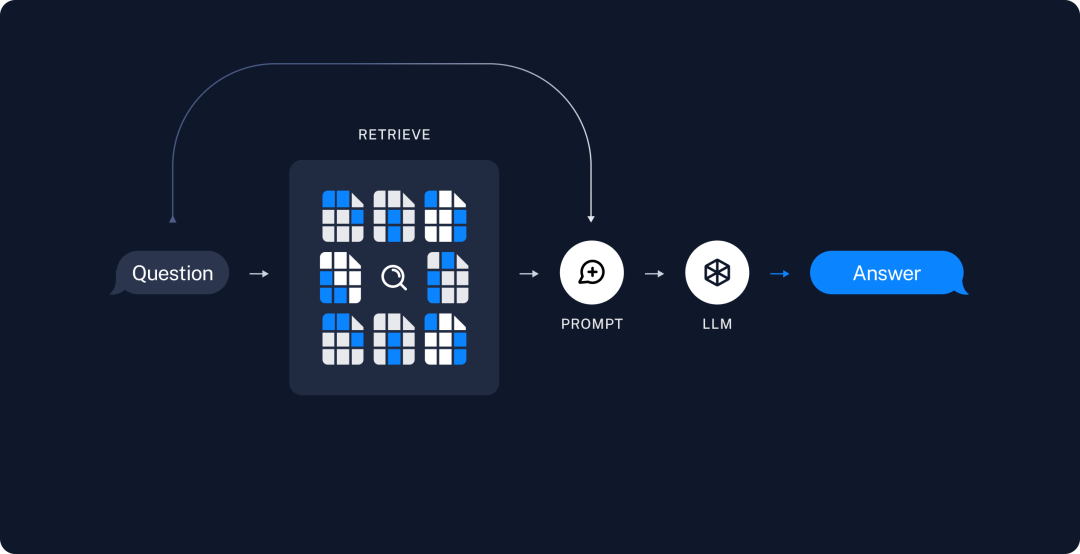
从原始数据到答案的最常见完整序列如下所示:

索引

  1. 加载:首先,我们需要加载数据。这是通过文档加载器完成的。
  2. 拆分:文本拆分器将大型文档拆分成较小的块。这对于索引数据和将其传递给模型都很有用,因为大块更难搜索,并且不适合模型的有限上下文窗口。
  3. 存储:我们需要一个地方来存储和索引我们的拆分,以便以后可以搜索它们。这通常使用 VectorStore 和 Embeddings 模型来完成。
图片

检索和生成

\4. 检索:给定用户输入,使用检索器从存储中检索相关文档块。

\5. 生成:ChatModel/LLM 使用包含问题和检索到的数据的提示生成答案。
图片

接下来我将按照上述步骤,使用 LangChain + OpenAI + Qdrant 实现一个简单的 RAG 应用。

Qdrant 是一种 VectorStore(向量数据库)。我们可以将文档块的嵌入表示存储在 VectorStore 中。

加载 & 拆分

我将使用 GPT4All 的技术报告来作为我们这个 RAG 应用的数据源,你可以在项目的 data 目录下看到名为《2023_GPT4All_Technical_Report》的 PDF 文件。

第一步是导入我在环境变量中设置的 OpenAI 的配置信息:
在这里插入图片描述

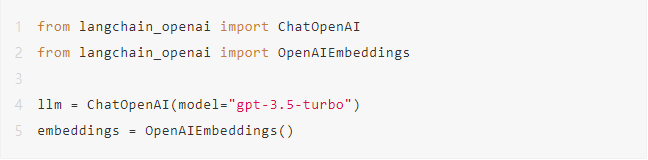
然后就可以配置 LLM 和 embedding 模型了:
在这里插入图片描述

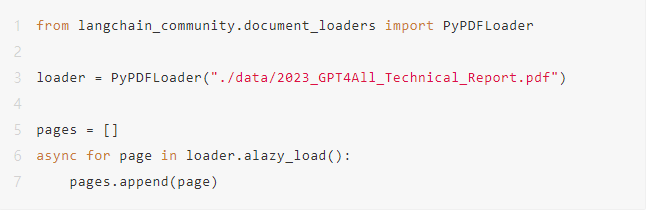
1. 加载 PDF 文件

在这里插入图片描述

2. 拆分

虽然我们加载的文档并不长,但是在你可能会加载更长的文档。当文档过长时,就无法放入许多模型的上下文窗口中(一般模型的上下文窗口只有 32k或者 64k)。

为了解决这个问题,我们将文档拆分成块以进行嵌入和向量存储。这应该有助于我们在运行时仅检索文档中最相关的部分。

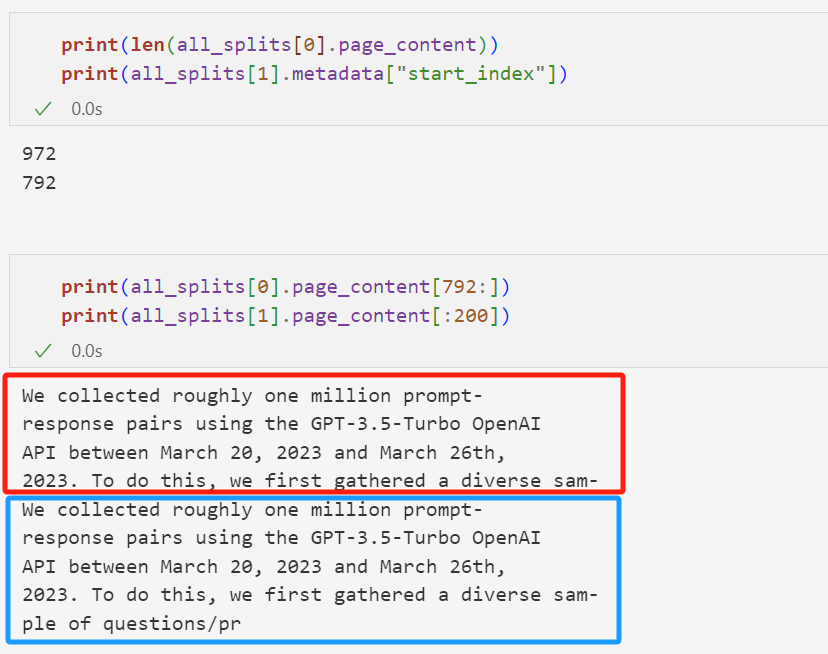
在这种情况下,我们将文档拆分成 1000 个字符的块,块之间有 200 个字符的重叠。重叠有助于减轻将语句与与其相关的重要上下文分离的可能性。我们使用 RecursiveCharacterTextSplitter,它将使用常用分隔符(如换行符)递归拆分文档,直到每个块的大小合适。这是针对一般文本用例的推荐文本拆分器。

我们设置 add_start_index=True,以便每个拆分文档在初始文档中开始的字符索引保留为元数据属性“start_index”。

可以看到是两个块之间是有重叠的:
图片

存储

3. 存储

我们将使用语义搜索实现检索功能,所以最常见的方法是嵌入每个文档拆分的内容,并将这些嵌入插入到 VectorStore 中。

当用户输入查询后,查询也会被转成嵌入向量,然后执行某种“相似性”搜索,以识别与我们的查询嵌入最相似的嵌入的文档块。最简单的相似性度量是余弦相似性:测量每对嵌入(高维向量)之间角度的余弦。

现在我们将使用 OpenAIEmbeddings 模型在单个命令中嵌入所有文档块。并使用 Qdrant 存储。

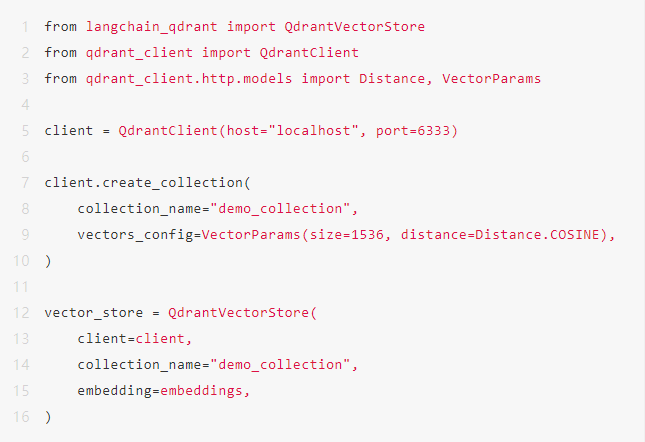
默认使用的 OpenAI 嵌入模型是 text-embedding-ada-002,它将文本转成 1536 维的向量。所以我们可以这样初始化 Qdrant:
在这里插入图片描述

我们创建了一个名为 demo_collection 的 VectorStore,现在我们将文档块加进去:
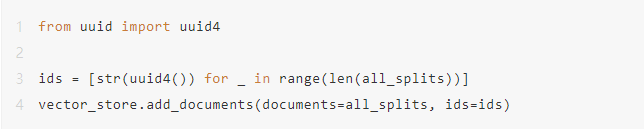
在这里插入图片描述

检索 & 生成

现在让我们编写实际的应用程序逻辑。我们想要创建一个简单的应用程序,它接受用户问题:

  1. 搜索与该问题相关的文档,
  2. 将检索到的文档和初始问题传递给模型,并返回答案。

4. 检索

首先,我们需要定义搜索文档的逻辑。LangChain 定义了一个 Retriever 接口,它包装了一个索引,可以根据字符串查询返回相关文档。

最常见的 Retriever 类型是 VectorStoreRetriever,它使用向量存储的相似性搜索功能来促进检索。任何 VectorStore 都可以通过 VectorStore.as_retriever() 轻松转换为 Retriever:

retriever = vector_store.as_retriever(search_type="similarity", search_kwargs={"k": 6})

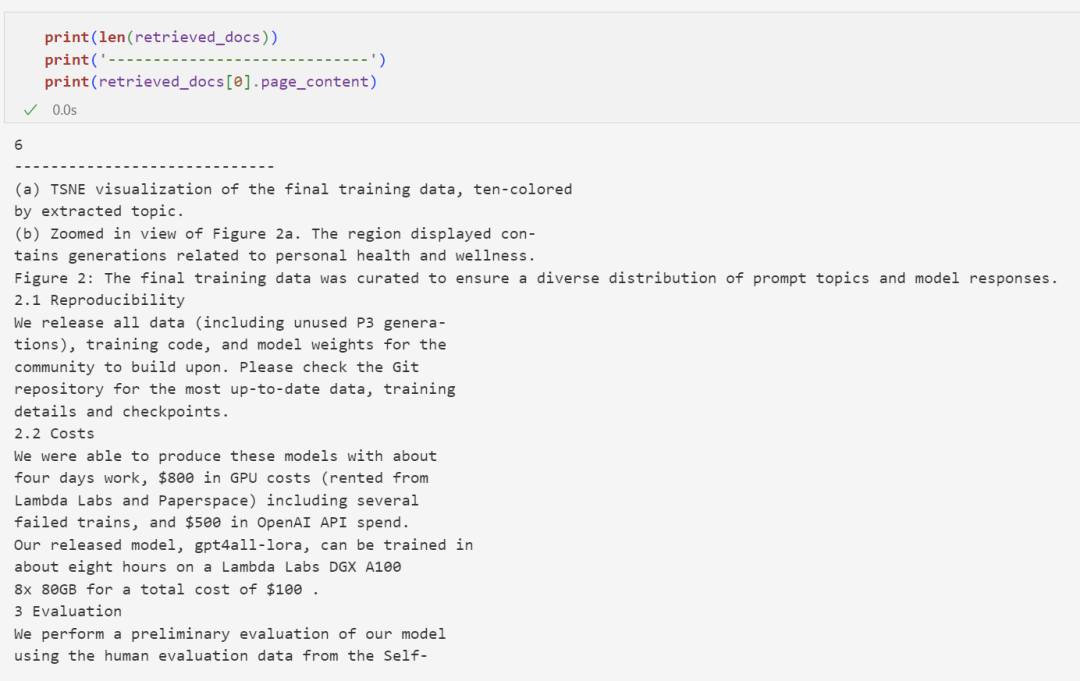
retrieved_docs = retriever.invoke("What was the cost of training the GPT4all-lora model?")

当我们检索训练 GPT4all-lora 模型花费了多少时,我们可以得到 6 段与这个问题在语义上相似的文档块:
图片

5. 生成

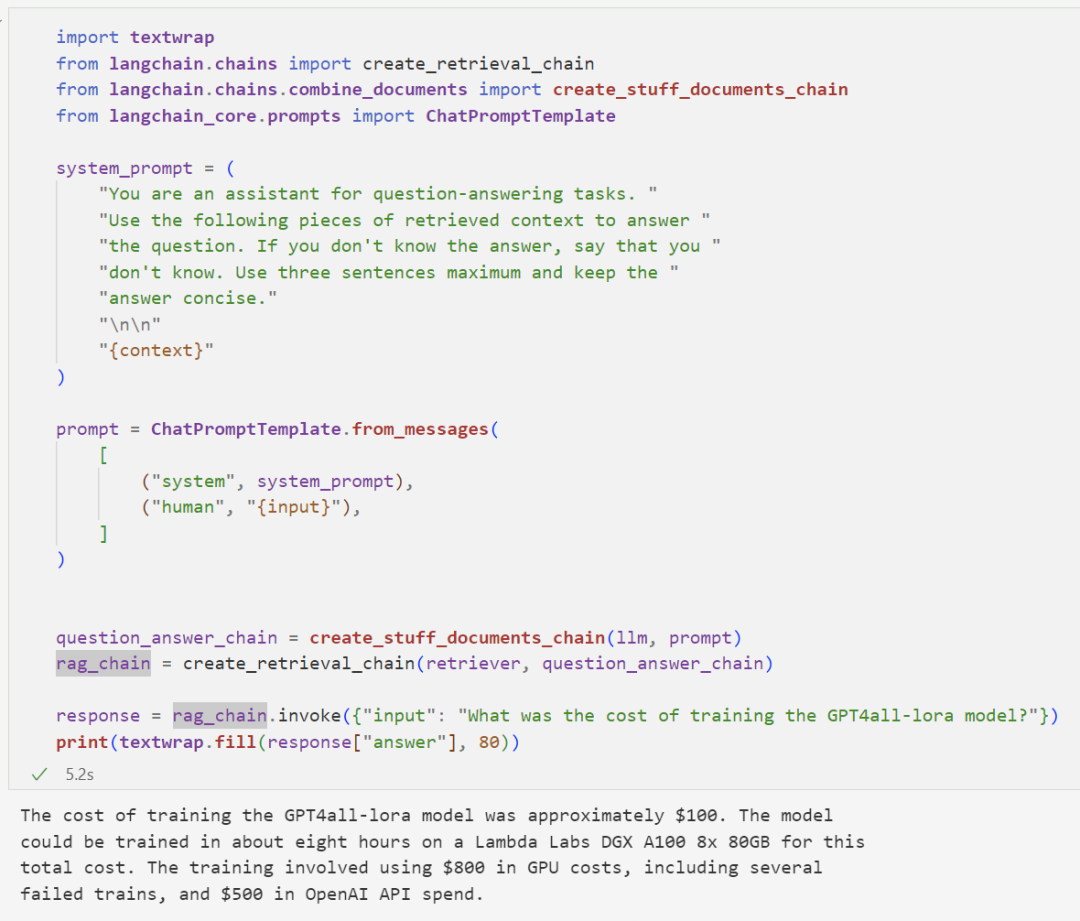
让我们将所有内容整合成一个链条,该链条接收问题、检索相关文档、构造提示、将其传递给模型并解析输出。

我们将使用 gpt-3.5-turbo OpenAI 聊天模型,但你可以替换成任何 LangChain LLM 或 ChatModel。

import textwrap
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate

system_prompt = (
    "You are an assistant for question-answering tasks. "    
    "Use the following pieces of retrieved context to answer "    
    "the question. If you don't know the answer, say that you "    
    "don't know. Use three sentences maximum and keep the "    
    "answer concise."    
    "\n\n"    
    "{context}"
)

prompt = ChatPromptTemplate.from_messages(
    [     
        ("system", system_prompt),        
        ("human", "{input}"),    
    ]
)


question_answer_chain = create_stuff_documents_chain(llm, prompt)
rag_chain = create_retrieval_chain(retriever, question_answer_chain)

response = rag_chain.invoke({"input": "What was the cost of training the GPT4all-lora model?"})
print(textwrap.fill(response["answer"], 80))
图片

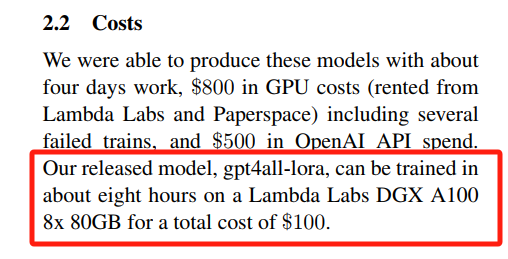
我们可以从原文看到答案其实应该只需要红框内的就行了:

图片

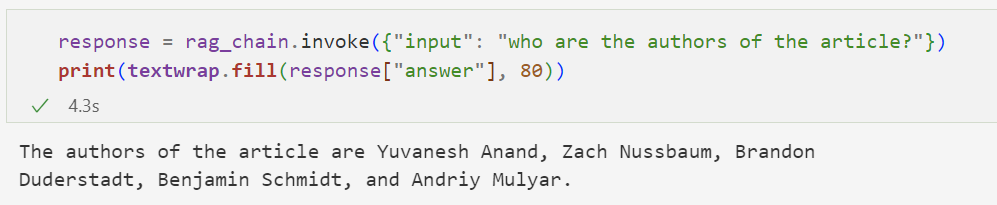
我们再问该技术报告的作者是谁?

图片

这次是完全正确的:

图片

那么我们再问一下从文档中查不到答案的问题:

图片

这个回复还算友好。

源码链接:

https://github.com/realyinchen/RAG/blob/main/ChatGPT%20for%20YOUR%20OWN%20PDF%20files%20with%20LangChain.ipynb

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

LangChain入门指南 LangChain是一个强大的框架,旨在帮助开发人员使用语言模型构建端到端的应用程序。它提供了一套工具、组件和接口,可简化创建由大型语言模型 (LLM) 和聊天模型提供支持的应用程序的过程。LangChain 可以轻松管理与语言模型的交互,将多个组件链接在一起,并集成额外的资源,例如 API 和数据库。官方文档:https://python.langchain.com/en/latest/ 阅读详情

相关推荐

LangChain+OpenAI构建企业级RAG问答系统实战

RAG(检索增强生成)是一种将大语言模型与私有知识库动态结合的关键技术,其核心在于通过语义检索精准定位相关文本片段,再驱动模型生成可信答案。相比传统关键词搜索或全文喂入,RAG解决了大模型知识滞后、幻觉严重、无法理解业务语境等工程痛点。依托向量数据库实现的语义检索能力,配合合理的文本切分、高质量嵌入(如text-embedding-3-small)和可调试的LangChain模块化链路,RAG已成为构建内部智能助手、技术文档问答、客户支持系统的事实标准。本文聚焦真实落地细节,覆盖PDF解析清洗、chunk策

keke1314520的博客 388

大模型入门实战:通过 HuggingFace 调用 Llama3

至此,我们成功演示了如何通过 Hugging Face 的 Transformers 调用 Llama 模型,并获取了模型的回答。但是如果你的需求只是简单地调用模型,而无需进行微调或复杂的部署,可以尝试使用 Ollama。它不仅操作更加便捷,还提供了开箱即用的 RESTful 接口,适合快速集成到生产环境中。下一篇,我将会讲解如何通过 Ollama 下载部署 Llama 模型并调用。

python12345_的博客 2602

LangChain生产级LLM应用工程实践:RAG与Agent落地指南

大语言模型(LLM)应用已从概念验证迈向真实业务系统,其核心范式RAG(检索增强生成)和Agent(智能体)正成为企业知识服务、智能客服与自动化决策的关键技术。理解RAG的底层原理——即如何将非结构化数据向量化、高效检索并精准注入提示词——是构建可靠系统的前提;而Agent的本质则是任务编排与工具调用的工程化闭环。技术价值在于突破传统搜索与规则引擎的语义瓶颈,实现动态上下文感知与多步推理。典型场景包括合同智能审查、设备维修知识助手、多语言产品描述生成等专业领域应用。本文聚焦LangChain在真实生产环境中

weixin_30443075的博客 445

Qdrant:在 Langchain 里的使用

Qdrant 在 Langchain 下的使用。

J.D.的博客 1280

从零构建RAG与Agent应用:LangChain实战指南

在人工智能应用开发领域,检索增强生成(RAG)和智能体(Agent)是解决大语言模型知识滞后与幻觉问题的关键技术。RAG通过将外部知识库与模型生成过程结合,为模型提供实时、准确的参考信息,从而提升回答的可靠性与时效性。其技术价值在于能够构建具备领域专长、可动态更新的智能问答系统。智能体则进一步赋予模型自主规划与工具调用的能力,使其从被动应答升级为主动执行复杂任务。这些技术广泛应用于企业知识库、智能客服、数据分析助手等场景。本文基于LangChain框架,通过实战项目手把手演示如何构建一个融合RAG与Agen

weixin_34268753的博客 331

LangChain实战:从零构建企业级RAG与Agent应用

检索增强生成(RAG)和智能体(Agent)是当前大模型应用开发中的核心技术范式。RAG通过将外部知识库向量化并与大模型结合,有效解决了模型幻觉和知识截止问题,使模型能够基于私有数据生成准确回答。其核心流程包括文档索引、向量检索和上下文增强生成。智能体则赋予大模型规划决策和工具调用的能力,通过ReAct等框架实现复杂任务的自动化执行。在工程实践中,LangChain作为标准化组件库,提供了构建这些系统的设计模式和通用接口,极大简化了开发流程。本文聚焦于企业级应用场景,深入探讨如何利用LangChain生态,

ithome 450

向量数据库 及 langchain 用法

当今科技领域的发展日新月异,向量数据库成为了热门的话题之一。这些数据库以其高效的向量检索和相似度搜索功能,为各种应用场景提供了强大的支持。在本篇博客中,我们将介绍六个备受关注的向量数据库:Milvus、Zilliz、Faiss、Qdrant、LlamaIndex和Chroma。基本介绍1. MilvusMilvus是一个开源的向量相似度搜索引擎,由Zilliz团队开发。它提供了高性能的向量检索和相似度搜索功能,支持海量数据的快速查询。

qq_40439142的博客 1449

LangChain工程实战:RAG系统落地的12个关键细节与避坑指南

RAG(检索增强生成)是当前大模型应用落地的核心技术路径,其本质是将外部知识库与LLM推理能力协同,解决幻觉与知识滞后问题。实现稳定RAG需深入理解文本分块、向量嵌入、检索匹配与输出解析四大技术环节,尤其关注chunk_size与LLM上下文窗口的匹配关系、Embedding模型与向量库的维度一致性、Retriever的filter语法兼容性等底层约束。在金融、法律等强合规场景中,文档结构化(如PDF表格提取)、溯源准确性与响应延迟控制更构成硬性指标。本文基于真实业务项目经验,聚焦LangChain在RAG

java2000.net 400

14. LangChain easy-rag

本文基于 langchain4j-15-rag-easy 模块实战代码,详解 LangChain4j Easy RAG 实现流程。涵盖:EmbeddingStoreIngestor 文档入库、Qdrant 向量库配置、Embedding 维度一致性关键要点(避免 384 维与 1024 维冲突)、DocumentSplitters 递归切分策略 (500/100)、ContentRetriever 参数调优 (minScore=0.8, maxResults=5)

qq_15720875的博客 641

三部对接 sora-2:OpenAI 最新视频模型快速接入指南

本文介绍OpenAI最新视频生成模型Sora-2的接入方案,重点解析其Chat格式调用功能。开发者可通过在提示词中嵌入"横屏/竖屏""时长""清晰度"等要求快速生成视频。文章分三部分:1)基础准备(环境配置与API密钥获取);2)核心调用(提供Python/Java示例代码);3)结果查询与优化建议。Sora-2支持多语言调用,简化了视频生成流程,适用于短视频、广告创意等场景。

2501_93565190的博客 3426

MQL5教程 01 MT5有关EA的操作、MetaEditor 工具栏主要功能

MQL5教程 01 MT5有关EA的操作、MetaEditor 工具栏主要功能

weixin_42830015的博客 3985

2、LangChain —— RAG基本架构

LLM 支持的最强大的应用程序之一是复杂的问答 (Q&A) 聊天机器人。这些应用程序可以回答有关特定源信息的问题。这些应用程序使用一种称为检索增强生成 (RAG)的技术。这里将展示如何基于文本数据源构建一个简单的问答应用程序。在此过程中,我们将介绍典型的问答架构,并重点介绍更多高级问答技术的资源。我们还将了解LangSmith如何帮助我们跟踪和理解我们的应用程序。随着我们的应用程序变得越来越复杂,LangSmith 将变得越来越有用。RAG 是一种利用附加数据增强 LLM 知识的技术。

cheese_burger_的博客 1444

从UE4到Unity:双叶高光技术在角色皮肤渲染中的移植全流程

本文详细解析了将UE4中的双叶高光技术移植到Unity引擎的全流程。该技术通过模拟皮肤油脂层和真皮层的不同反射特性,能显著提升角色皮肤渲染的真实感。文章从核心原理、贴图资产处理、Shader代码重构到参数调校,提供了完整的跨引擎移植实战指南,帮助开发者实现高质量的皮肤质感还原。

alice7model的博客 478

基于Llama 3 构建RAG语音助手:将本地 RAG 与 Qdrant、Whisper 和 LangChain 集成到 TaoToken

基于 Llama 3 构建 RAG 语音助手,用 Qdrant 存向量、Whisper 转写、LangChain 编排,模型调用统一走 TaoToken 兼容 OpenAI 接口。本文给出可复制配置与端到端验证,并排查 401、local proxy failed 等常见报错。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42591908的博客 176

YOLOv11改进:引入SSA序列打乱注意力模块与MSCSA二次创新模块,适配目标检测、图像分类与实例分割

YOLOv11改进:引入SSA与MSCSA模块提升CV任务性能 摘要: 本文提出在YOLOv11中集成SSA(序列打乱注意力)和MSCSA(多尺度上下文序列打乱注意力)模块,以解决计算机视觉任务中的关键挑战。SSA通过序列打乱和局部窗口注意力机制,在降低计算复杂度的同时增强长距离依赖建模能力;MSCSA进一步引入多尺度上下文融合和动态序列打乱策略,优化了多尺度目标检测和实例分割的边界特征处理。这些改进有效解决了传统注意力机制在全局上下文建模、局部细节保持和序列顺序敏感性方面的不足。实验表明,该方法在目标检测

走向CTO的路上... 858

【系统架构设计师】论文:论虚拟现实技术的应用与发展

虚拟现实技术是当前科学研究的热点,同时也是国家大力支持发展的核心技术之一。所谓虚拟现实,就是通过计算机等虚拟手段来构造一个非常接近真实世界的虚拟环境,它主要体现在视觉、触觉、嗅觉等方面的逼真模拟来达到高度的沉浸性,也就是如我们通常所说的“身临其境”。

数据知道的博客 1万+

agno 第三方 RAG 检索栈集成实战:Infinity 重排、LightRAG 与 LangChain + Qdrant 三套方案详解

> 导读:本文以 [cookbook/07_knowledge/05_integrations/rag/README.md](https://link.gitcode.com/i/f5bc165e9a2b1b367be3c3c825840aa1) 为主线,系统讲解 agno 中「第三方 RAG / 检索栈集成」的三个落地示例——基于 Infinity 重排器的 Agentic RAG、基于 Lig

gitblog_07009的博客 477

uniapp - 详解使用高德地图在地图上实现绘制边界/点聚合/行政区域高亮等功能,Uniapp高德地图点聚合标记及绘制点线面示例代码(全端兼容H5网页、小程序、安卓app、苹果app、nvue)

uni-app,h5移动端网页,微信小程序,支付宝小程序,Android安卓,苹果ios,app,nvue,高德地图,uniAPP高德地图实现点聚合,地图区域描边、点标记、点信息详情弹窗,实现绘制边界区域,uniapp H5使用高德地图实现点聚合、行政区域高亮,实现高德地图的marker聚合功能,高德地图进行marker标点,点信息展示,点击标记点弹出对话框,点击聚合点后显示信息模态框,打标点,【Uniapp】高德地图的接入自定义标点与信息窗体使用,绘制行政区域边界,绘制多边形,电子围栏,高德行政区划边界,

✅ 精选推荐文章 1万+

从OpenAI 400亿收入看AI应用工程化:RAG实战与LangChain开发指南

随着大语言模型(LLM)技术的成熟,AI应用开发正从模型训练转向工程化落地。检索增强生成(RAG)作为核心范式,通过结合向量数据库与提示工程,有效解决了模型知识截止与幻觉问题。其技术价值在于将通用模型能力与私有知识库深度融合,实现低成本、高准确性的智能问答、知识库构建等场景。本文以OpenAI收入突破为背景,聚焦AI应用工程化实战,详细拆解了基于LangChain框架和Chroma向量数据库的RAG系统构建全流程,涵盖文档处理、向量索引、提示工程等关键环节,为开发者提供从原型到生产的完整解决方案。

weixin_30319153的博客 412

1分钟吃透一篇文献,借助AI辅助各部分精读,效率提升10倍(附AI提示词)

你现在是一名【研究领域】的资深博士,非常擅长阅读与分析长篇论文,那么接下来我会给你上传一篇论文,请你按照我的要求辅助我阅读。

qq_64378896的博客 641

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

LangChain与LlamaIndex协同构建企业级本地RAG知识库

RAG(检索增强生成)是当前企业落地AI应用的核心范式,其本质是将外部知识精准注入大模型生成过程,解决幻觉与时效性问题。技术实现上需兼顾文档解析、语义分块、向量索引与流程编排四大能力——其中LangChain专注工作流调度与业务规则嵌入,LlamaIndex专精结构化数据清洗与智能分块。二者并非替代关系,而是分工协作的‘操作系统+SDK’组合,共同支撑PDF/Notion/数据库等多源异构数据的统一检索与可信问答。本文聚焦本地化部署场景,覆盖OCR处理、层级分块、元数据过滤、低延迟优化等工程细节,适用于医疗

cuanwei9356的博客 518

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Skill Seekers × Qdrant:一键把文档库打包成可过滤的 Qdrant 向量集合,构建生产级 RAG 知识检索系统

本篇技术指南讲解 Skill Seekers 与 Qdrant 的完整集成方案:从 `skill-seekers create/package` 一键生成结构化的 Qdrant 集合 JSON,到用 qdrant-client 完成集合创建、批量上传、payload 过滤查询、快照备份与多租户检索。读者学完后,可以用 10 分钟级别的投入,把任意文档站点、GitHub 仓库或本地代码库变成一套拥有

gitblog_00911的博客 460

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

把 LangChain 的 Llama 3 调用改到 TaoToken,Qdrant 检索留在本地

本地 RAG 语音助手用 LangChain 编排、Qdrant 做本地检索,但 Llama 3 8B 推理在 24GB 显卡上仍会 CUDA OOM。本文把文本生成切到 TaoToken:在 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 创建 API Key,将 LangChain 的 HuggingFacePipeline 换成 ChatOpenAI,Base URL 填 TaoToken 兼容通道,而 Whisper 转写与 Qdran

weixin_35755823的博客 10

基于CrewAI与Qdrant构建智能体化向量搜索系统:从RAG到主动问题解决

向量搜索作为现代信息检索的核心技术,通过将文本、图像等非结构化数据转化为高维向量,并计算其相似度,实现了超越关键词匹配的语义理解能力。其原理在于利用深度学习模型(如BERT、GPT的嵌入层)将数据映射到向量空间,使得语义相近的内容在空间中距离更近。这项技术的价值在于极大地提升了搜索的准确性和泛化能力,使其能够理解用户意图、处理复杂查询,广泛应用于智能客服、知识库问答、内容推荐和代码检索等场景。传统RAG(检索增强生成)流程虽能结合检索与大模型生成,但在处理需要多步推理、上下文关联的复杂问题时,仍显被动与机械

weixin_30631587的博客 491
上一篇: 大模型面经——以医疗领域为例,整理RAG基础与实际应用中的痛点
下一篇: 带你了解AI大模型的前世今生
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值