LLM模型 贪婪、温度、Top-k、核采样方式的区别---附代码与示例

大模型推理常见采样策略:Top-k, Top-p, Temperature, Beam Search 大模型推理采样策略,举例通俗易懂汇总介绍 阅读详情

LLM模型 贪婪、温度、Top-k、核采样方式的区别—附代码与示例

在自然语言生成任务中,不同的采样技术用于从语言模型的输出中选择下一个生成的单词或词语。这些技术包括贪婪采样、温度采样、Top-k采样和核(Nucleus)采样。它们在选择生成单词的过程中有不同的策略,本文将介绍这四种采样方式的区别。

1. 贪婪采样 (Greedy Sampling)

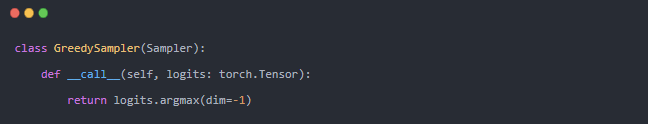
贪婪采样是一种直接选择最可能的下一个词的策略。具体步骤为:

  • 从模型输出的logits中,找到概率最大的那个词,直接选择它作为输出。

实现代码
在这里插入图片描述

优点

  • 简单且计算效率高。
  • 保证每一步选择最有可能的结果。

缺点

  • 可能会导致生成的文本非常重复和缺乏多样性。
  • 贪婪采样只关注当前概率最大的词,忽略了其他潜在的好选择,容易陷入局部最优解。

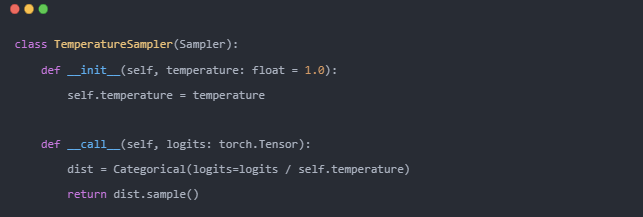
2. 带温度的采样 (Temperature Sampling)

温度采样通过引入一个温度参数来调整输出概率的分布,以控制生成文本的多样性。温度 T 的作用是平滑或锐化概率分布:

  • 当 T = 1 时,采样为标准随机采样。
  • 当 T < 1 时,概率分布变得更尖锐,模型更倾向于选择最可能的词。
  • 当 T > 1 时,概率分布变得更加平滑,模型会更多地探索低概率的词。

实现代码

在这里插入图片描述

优点

  • 提供了生成文本的多样性,尤其是在温度高时。
  • 通过调整温度参数,可以控制探索(随机性)与利用(选择高概率词)之间的平衡。

缺点

  • 温度的选择需要仔细调节,不同任务或场景下对温度的需求可能不同。
  • 温度过低时,生成的文本趋向于贪婪采样;温度过高时,生成的文本可能过于随机。

3. Top-k采样

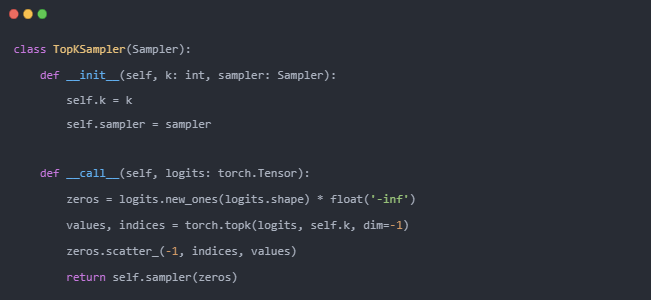
Top-k采样限制了每次生成时候的候选词数量,模型只会从概率前k个最高的词中进行采样,而忽略其他可能性较小的词。

实现代码
在这里插入图片描述

优点

  • 提供了对生成词汇的严格控制,避免生成概率非常低的词。
  • 通过限制候选词的数量,避免了一些罕见或不合逻辑的词被选中。

缺点

  • 需要设定一个合适的 k 值,如果 k 值太小,生成的文本可能会缺乏多样性;如果 k 值太大,则效果与标准采样相似。

4. 核采样 (Nucleus Sampling)

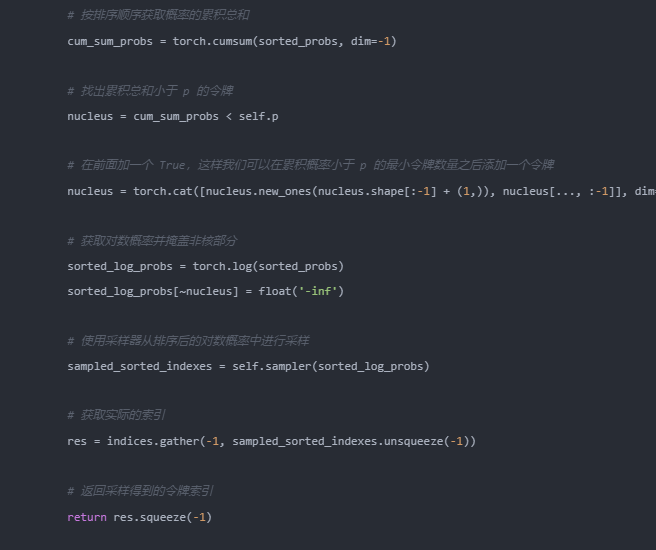
核采样是一种自适应的采样方法,它选择的候选词集合 V(p) 是满足累计概率和大于或等于给定阈值 p 的最小词汇子集。与Top-k采样不同,核采样的候选词数量不是固定的,而是基于累计概率动态确定的。

示例

假设同样的语境:“今天的天气很”,但这次我们将会有不同的词汇及其概率分布,我们也会使用不同的阈值 ( p ) 来展示如何动态确定选词数量。

模型预测的词汇概率
  • 好:0.4
  • 冷:0.3
  • 热:0.2
  • 潮湿:0.05
  • 多变:0.03
  • 干燥:0.02
排序与累积概率

按概率从高到低排序并计算累积概率:

  • 好:0.4
  • 冷:0.7 (0.4 + 0.3)
  • 热:0.9 (0.7 + 0.2)
  • 潮湿:0.95 (0.9 + 0.05)
  • 多变:0.98 (0.95 + 0.03)
  • 干燥:1.00 (0.98 + 0.02)
确定核集合

这次,我们将选择不同的阈值 ( p ) 来观察核集合如何变化:

  1. 当 ( p = 0.7 ):

    • 核集合包括:“好”和“冷”,因为它们的累积概率首次超过 0.7。
  2. 当 ( p = 0.9 ):

    • 核集合扩展到:“好”,“冷”,和“热”,因为它们的累积概率首次超过 0.9。
  3. 当 ( p = 0.95 ):

    • 核集合进一步扩展到:“好”,“冷”,“热”和“潮湿”,因为这是累积概率首次超过 0.95。
抽样

在每种情况下,我们从对应的核集合中随机选取一个词作为下一个词。选择的范围和多样性取决于 ( p ) 值的大小,而词的数量是根据这个阈值动态确定的,不是固定的。

实现代码
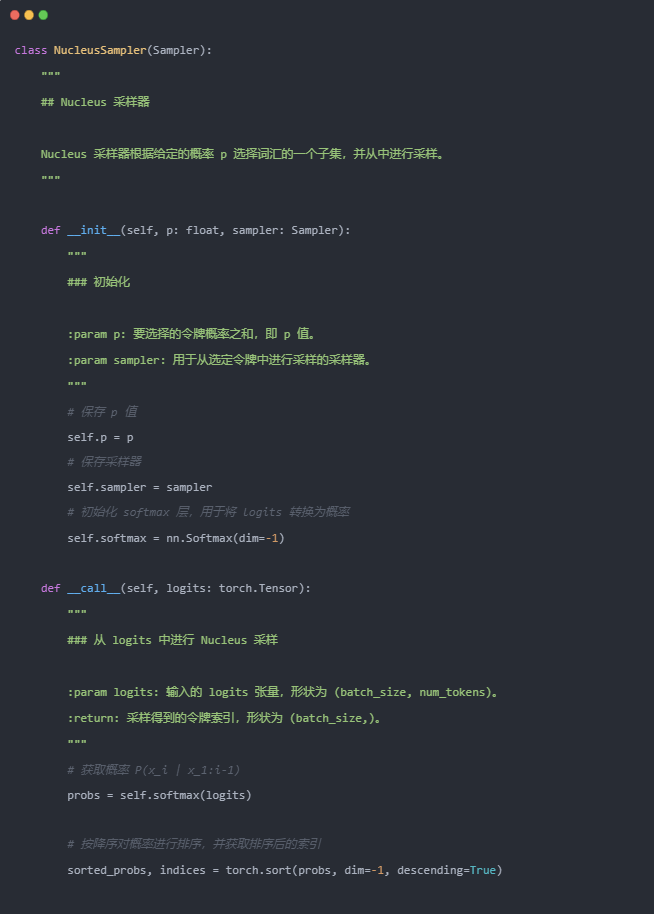
在这里插入图片描述
在这里插入图片描述

优点

  • 灵活性强,自动调整候选词集合,避免了固定的词数限制。
  • 在生成文本时能够更好地平衡多样性与高概率词的利用,表现优于Top-k采样。

缺点

  • 参数 p 的选择需要调节,不同任务可能需要不同的 p 值。
  • 计算复杂度较高,尤其是当处理较大的词汇表时。

总结

采样方法优点缺点
贪婪采样简单、高效,始终选择最有可能的词文本生成可能单一,缺乏多样性
温度采样通过调整温度控制多样性,适应性强温度的调节需要谨慎,过高或过低的温度可能产生不理想的结果
Top-k采样控制候选词数量,避免选择低概率词k 值选择需要调节,k 太小可能导致文本单一
核采样动态选择候选词集合,更灵活,生成文本质量较高参数 p 需要调节,计算复杂度较高

每种采样方式都有其适用的场景,根据具体的应用和对生成文本的要求,可以选择不同的采样策略。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

『大模型笔记』LLM秘密:温度、Top-K和Top-P抽样技术解析! 总结一下,使用温度、Top-K和Top-P技术的随机采样为大语言模型生成输出提供了不同的选择。在视频的最后部分,我将讨论每种技术的优缺点,以便您更好地了解何时使用每种方法以及可能的限制。温度参数的优点包括增加模型的创造力,较高温度引入更多随机性,促进创造性和多样性输出,还可以防止模型变得过于确定性。然而,缺点是过高温度可能导致输出不连贯,因为模型更可能选择不太可能的单词,增加随机性可能导致文本缺乏上下文或意义。 阅读详情

相关推荐

从IR Drop到EM分析:数字IC电源规划中那些没人明说的细节(以MTCMOS配置为例)

本文深入探讨数字IC后端设计中电源规划的关键细节,特别关注MTCMOS配置、电源网络电阻最小化和level shifter供电等实战技巧。通过分析IR Drop和EM问题,提供优化floorplan和powerplan的具体策略,帮助工程师避免常见陷阱,提升芯片设计的稳定性和可靠性。

q9w8e7r6t5的博客 511

贪心算法、贪心搜索/采样(greedy search/sampling)、集束搜索(beam search)、随机采样(random sample)

的结果也是最好/最优的解。{看着这个名字,贪心,贪婪这两字的内在含义最为关键。这就好像一个贪婪的人,他事事都想要眼前看到最好的那个,看不到长远的东西,也不为最终的结果和将来着想,贪图眼前局部的利益最大化,有点走一步看一步的感觉。

Drug discovery 5871

告别CNN局限:用Transformer+迁移学习搞定高光谱图像分类(附Pytorch代码)

本文探讨了如何利用Transformer的自注意力机制和迁移学习策略解决高光谱图像分类中的挑战。通过结合CNN的局部特征提取和Transformer的全局建模能力,提出的DenseTransformer架构在多个数据集上实现了显著的性能提升。文章还提供了详细的PyTorch实现代码和工程优化技巧,帮助开发者快速应用这一技术。

weixin_32771907的博客 607

流畅chatbot采样

流畅chatbot采样 1. introduction ​  这篇博客可以作为chatbot旅程的终点了,前面已经介绍了模型相关的工作,那么做完模型训练以后,剩下的就是生成了。要注意的是,模型生成的内容并不是和训练过程类似的,要想生成流畅且通顺的response还是需要一些额外的处理,这里会介绍一些生成相关的工作,以便让自己训练的模型有用武之地,毕竟,辛辛苦苦做出来的东西,能用且可用才是最让自己有成就感的。 2. 生成方法 2.1 greedy search  每次预测的时候选择概率最大的那个token,最

u013596454的博客 618

LLM大模型基础知识【一】

大语言模型(LLM):是指在自然语言处理(Natural Language Processing,NLP)领域中的一类大模型,通常用于处理文本数据和理解自然语言。这类大模型的主要特点是它们在大规模语料库上进行了训练,以学习自然语言的各种语法、语义和语境规则。例如:GPT系列(OpenAI)、Bard(Google)、文心一言(百度)。视觉大模型:是指在计算机视觉(Computer Vision,CV)领域中使用的大模型,通常用于图像处理和分析。

lin_xi_xi的博客 2878

贝塞尔曲线在机器人路径平滑中的实战应用与优化

本文深入探讨了贝塞尔曲线算法在机器人路径平滑中的核心应用。通过对比G1CBS与G2CBS两种方法,详细阐述了如何实现从切线连续到曲率连续的平滑优化,以满足不同机器人对运动平稳性和效率的需求,并提供了完整的Python代码实现与关键参数调优指南。

weixin_29051811的博客 307

LLM中的Top-K/Top-p/温度都是怎么发挥作用的?

有兴趣的同学可参阅模拟退火中的温度概念,下图引用了 Simulated annealing - Wikipedia 的图片(随着温度的降低,跳跃越来越不随机,最优解也越来越稳定)。如果是 T 趋近于 0,那么我们将处理极大的指数,因此具有最大值的\(x_i\)元素将占主导地位,即它的概率将接近 1,而所有其他元素的概率将接近 0。Softmax 函数接收一个由 n 个实数组成的向量,然后将其标准化为这 n 个元素的离散概率分布,且概率的总和为 1。操作后得到的 token 集,称为 LLM 的词汇表。

weixin_55010563的博客 980

华为AR6140E/S5735设备密码策略配置全攻略:从复杂度到锁定机制

本文详细介绍了华为AR6140E/S5735设备的密码策略配置方法,涵盖密码复杂度、时效性和防护性三大核心维度。通过具体的CLI命令示例,指导管理员如何设置密码长度、字符组合、有效期及登录失败锁定等安全机制,为企业网络提供全面的用户名密码防护策略。

weixin_30836759的博客 531

【Transformer】LLM中随机采样、top-K与top-P的原理

在transformer中,每次输出的并不是下一个词,而是一个softmax概率分布,用来预测下一个词在词表中的概率分布?那么每次都选择概率最高的词吗?nonono。其实是由随机采样以及其变体Top-K/Top-P决定的。这就是为什么调用某一LLM时候会让你设置超参数TopK TopP,那么随机采样是什么,又是如何决定下一个词的输入的。本文主要介绍这个随机采样不是“瞎选”,也不是“只选最大概率词”,而是根据模型输出的概率分布,有概率地随机选择下一个词。它让生成文本更具多样性和创造性。

2504_90578160的博客 830

Dynamics 365 F&O新手必看:Visual Studio 2019搭建项目框架全流程(含Model避坑指南)

本文详细介绍了如何在Visual Studio 2019中为Dynamics 365 Finance and Operations搭建企业级项目框架,包括Model分层策略、Solution管理及开发工作流优化。特别提供了Model避坑指南和实用配置建议,帮助新手快速上手并避免常见错误。

weixin_30505225的博客 381

【AUTOSAR-COM】Transmission Mode 和 Transfer Property

1.COM模块的基本概念 首先在描述Transmission Mode 和 Transfer Property之前,有必要对COM模块的基本处理有一个直观的理解,我所描述的和对概念理解的也不一定完全正确。 Signal:指的是通信协议中的,一条报文中所保存的若干信号。 I-PDU:至少在COM模块中,可以理解为一条报文。 上图是在CANdb软件中编辑一个报文的Layout的界面,可以很形象的将I-PDU对等为这里的一条Message,而Signal就是需要在Message中需要摆放的Signal

tim_hoven的博客 4635
上一篇: 转行在大模型公司做Prompter是种怎样的体验
下一篇: 小白转行算法,90%的人还没开始就错在了这1步
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值