本地运行LLama 3.2的三种方法

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs 这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner) 阅读详情

大型语言模型(LLMs)已经彻底改变了AI领域,小型模型也在崛起。因此,即使是在旧的PC和智能手机上运行先进的LLMs也成为了可能。为了给大家一个起点,我们将探索三种不同的方法来本地与LLama 3.2进行交互。

先决条件

在我们深入探讨之前,请确保你已经:

  • 安装并运行了Ollama

  • 已经拉取了LLama 3.2模型(在终端中使用 ollama pull llama3.2)

现在,让我们来探索这三种方法!

Ollama的Python包提供了一种简便的方法,可以在你的Python脚本或Jupyter笔记本中与LLama 3.2进行交互。
在这里插入图片描述

这种方法非常适合简单的同步交互。但如果你想要流式接收响应呢?Ollama为你提供了AsyncClient:

在这里插入图片描述

方法二:使用Ollama API

对于那些更喜欢直接使用API或想要将LLama 3.2集成到非Python应用程序中的人,Ollama提供了一个简单的HTTP API。

在这里插入图片描述

这种方法为你提供了从任何能够发出HTTP请求的语言或工具与LLama 3.2进行交互的灵活性。

方法三:使用Langchain构建高级应用程序

对于更复杂的应用程序,特别是涉及文档分析和检索的应用程序,Langchain与Ollama和LLama 3.2可以无缝集成。

以下代码片段展示了加载文档、创建嵌入和执行相似性搜索的过程:

from langchain_community.document_loaders import DirectoryLoader, UnstructuredWordDocumentLoader   
from langchain_text_splitters import RecursiveCharacterTextSplitter   
from langchain_community.embeddings import OllamaEmbeddings   
from langchain_community.llms import Ollama   
from langchain_community.vectorstores import Chroma         

# 加载文档   
loader = DirectoryLoader('/path/to/documents', glob="**/*.docx", loader_cls=UnstructuredWordDocumentLoader)   
documents = loader.load()         

# 将文档拆分为多个块   
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=0)   
splits = text_splitter.split_documents(documents)         

# 创建嵌入和向量存储   
embeddings = OllamaEmbeddings(model="nomic-embed-text")   
vectorstore = Chroma.from_documents(documents=splits, embedding=embeddings)         

# 初始化LLama 3.2   
llm = Ollama(model="llama3.2", base_url="http://localhost:11434")         

# 执行相似性搜索并生成回答   
query = "What was the main accomplishment of Thomas Jefferson?"   
similar_docs = vectorstore.similarity_search(query)   
context = "\n".join([doc.page_content for doc in similar_docs])   
response = llm(f"上下文: {context}\n问题: {query}\n回答:")   
print(response)               

这种方法允许你构建能够使用LLama 3.2强大的语言理解能力来理解和推理大量文本数据的应用程序。

开始生成提示了!

下载成功后,你可以在终端中使用以下命令运行模型:

$ ollama run llama3.2:3b-instruct-q8_0   

现在你已经可以生成一些图片提示了。假设我想为我的博客文章创建一个缩略图,于是我运行了下面的提示词:

Generate a random image prompt that I can use as a thumbnail for my article.   

这是生成的结果:

Here's a random image prompt for you:         


"A misty, moonlit forest with an old, gnarled tree in the center, its branches twisted and tangled like a giant's fingers. In the background, a subtle glow   
emanates from a faint, ethereal light that seems to be seeping from the very earth itself."         


Feel free to use this prompt as is or modify it to fit your article's theme and style!   
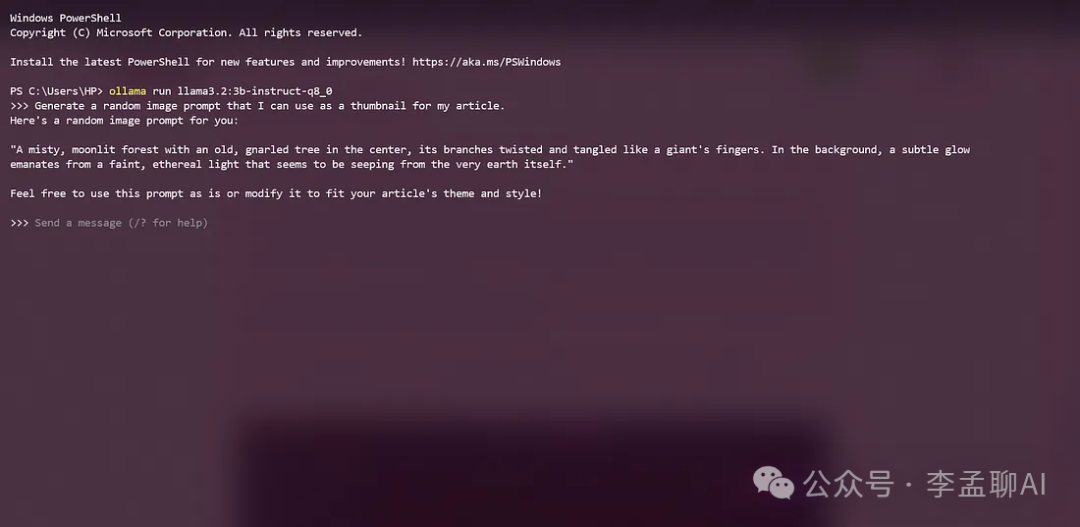
现在我准备在leonardo.ai网站上使用这个图片提示。这个网站非常适合从文本生成图片。你可以通过创建账户轻松开始制作图片。

该网站每天为你提供150个可用积分。如果合理使用这些积分,它非常适合个人使用。

图片

如果你是这个平台的新手,可以使用我的图片生成设置,以下是具体的设置:

  • 预设:Cinematic Kino

  • 预设风格:Cinematic

  • 对比度:Medium

  • 图片尺寸:16:9, Medium

  • 模型:Leonardo Lightning XL

结论

在本地运行LLama 3.2为AI驱动的应用程序打开了新的可能性。无论你是寻找简单的聊天交互、基于API的集成,还是复杂的文档分析系统,这三种方法都提供了适应各种使用场景的灵活性。

记住要负责任地、道德地使用这些强大的工具。编码愉快!

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

用ollama本地部署Lamma3.1 ollama create 自定义模型名字 -f Modelfile。让lamma3.1写一个贪吃蛇小游戏,一次run成功。例如:ollama run llama3.1。例如:ollama run llama3.1。 阅读详情

相关推荐

Windows 中 利用 ollama 来搭建 deepseek R1

近年来,大模型凭借其强大的语言理解和生成能力,在自然语言处理、计算机视觉等领域取得了突破性进展。从GPT系列到国内的,文心一言、[Qwen]、,大模型已成为推动人工智能发展的核心力量。ollama作为新兴的大模型搭建工具,以其开源、高效、易于部署的特点,在人工智能开发者社区中崭露头角,为大模型的搭建和应用提供了新的解决方案。在当今数字化浪潮中,人工智能的发展可谓日新月异,而大模型作为其核心驱动力,正重塑着各个行业的格局。

一个专注于机器学习基础与实战的技术博客,内容涵盖算法推导、模型实现、数学原理与代码实践。用通俗的语言解析复杂概念,记录学习过程中的思考与总结,适合机器学习爱好者和从业者参考。 2554

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1734

【AI大模型】LLaMa羊驼大模型详解

LLaMa模型结构:前面的词预测后面的词,经典的解码结构。位置编码用的是旋转自编码。大语言模型为什么取名为LLaMa(美洲鸵)?LLM发音困难。两个LL跟绕口令一样挑战舌头。大家想给它加点原音,帮助发音。有人加了A,就是LLaMa。3.模型的训练和数据:65B的模型使用2048块A100 80G的GPU,训练21天左右。(训练成本还是比较高的,训练的数据集同GPT一样)LLaMa模型训练的数据集。

weixin_53880910的博客 2808

AI大模型探索之路-基础篇5:GLM-4解锁国产大模型的全能智慧与创新应用

随着人工智能技术的飞速发展,大型预训练语言模型已成为推动行业进步的重要力量。它们在理解自然语言、生成文本、执行复杂任务等方面展现出惊人的能力。在此背景下,国产大模型GLM-4的问世,不仅展现了中国在AI领域的实力,也为国内外研究者和开发者提供了新的研究与应用平台。

寻道AI,探索AI无限可能! 8679

本地部署中文LLaMA模型实战教程,民间羊驼模型

LLaMA大部分是英文语料训练的,讲中文能力很弱。如果我们想微调训练自己的LLM模型,基于一个大规模中文语料预训练的模型比较好。目前开源项目很多,理想的项目要有以下特点:模型开源、训练代码开源、代码结构简单、环境容易安装、文档清晰。经过寻找与试验,我找到了一个比较好的项目。本博文要点如下:1 实战部分:模型下载与参数合并、模型命令行加载测试、模型部署为web网页(解决了一些报错问题)2 代码走读:模型参数合并、词表扩充3 原理分析:预训练与指令精调。

artistkeepmonkey的博客 8171

《iOS之一起进大厂》系列-秒杀面试官的RunLoop底层原理面试题

Runloop是iOS面试中的必考题,不管大厂小厂都会问到。 这里包括了Runloop几乎所有的面试题,还有中肯完整的答案解释。

空杯子 1153

与本地Lllama 3.2交互的3种方法

大型语言模型 (LLM) 彻底改变了 AI 领域,小型模型也正在兴起。因此,即使在较旧的 PC 和智能手机上也有可能运行高级 LLM。为了给出一个起点,我们将探索三种不同的本地与 LLama 3.2 交互的方法。现在,让我们探索这三种方法!

新缸中之脑 968

MATLAB2022b安装

图文并茂,手把手教会你怎么安装MATLAB2022b

1万+

Llama-2-7B-Chat-GGUF完全解析:Meta革命性对话模型本地部署终极指南

Llama-2-7B-Chat-GGUF是Meta推出的革命性对话模型Llama 2系列中的轻量级版本,通过GGUF格式实现了高效的本地部署能力。本文将为新手和普通用户提供完整的本地部署指南,帮助你轻松体验这款由Meta开发的强大AI对话模型。 ## 什么是Llama-2-7B-Chat-GGUF? 🤔 Llama-2-7B-Chat-GGUF是Meta Llama 2 7B Chat模型的

gitblog_00802的博客 594

基于Python的携程景点评价爬虫与情感评分分析

摘要: 本项目通过Python技术栈实现携程景点评论的情感分析系统,包含数据爬取、文本预处理、情感评分和可视化分析全流程。使用requests抓取评论接口,jieba进行中文分词,SnowNLP计算情感得分(0-1),并通过词云、情感分布图呈现结果。典型分析显示72%评论为正面,负面反馈多涉及"排队久""票价贵"等问题。系统可辅助景点口碑管理,扩展方向包括多景点对比、BERT模型优化等。项目强调需遵守爬虫伦理,控制请求频率,适用于非商业用途的旅游数据分析。(150字)

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 977

AM驱动架构—优质Mini-LED显示技术解决方案

(VR)和增强现实(AR)设备:MiniLED背光驱动方案适用于虚拟现实和增强现实设备中的显示技术,通过高亮度和高对比度的显示效果,创造更逼真的虚拟体验此外,MiniLED背光还能够实现更快的响应速度,减少图像残影,使得用户的动作在虚拟环境中更加流畅自然。以其出色的性能和广泛的应用前景备受关注是实现MiniLED显示效果的重要环节。1)更高的亮度和对比度:尺寸更小,可以在同样面积的显示屏上配置更多的LED,并且通过独立控制每一个MiniLED,可以实现更高的亮度和更细致的对比度,使得显示画面更加鲜明清晰。

isweekDN的博客 2763

3分钟上手BTL-4 Compact:llama.cpp/Ollama/LM Studio全平台启动教程

BTL-4 Compact是一款基于llama.cpp架构的高效AI模型工具包,支持Ollama和LM Studio全平台部署,让普通用户也能轻松玩转大语言模型。本文将带你快速掌握从环境准备到模型启动的完整流程,即使是AI新手也能在3分钟内完成部署。 ## 📋 准备工作:模型与环境要求 BTL-4 Compact的核心模型文件为`BTL-4-IQ2_XXS.gguf`,文件大小9.96 GB

gitblog_00984的博客 1120

实现单芯片2400bps 音频编解码方案

终于按照朋友的需求,帮他开发了一款单芯片集音频采集编码传送并接收解码播放功能的方案,交给快递公司邮寄给远在郑州的他.整个项目从开始定型到现在一个样机送出,整整花了1个月时间,感觉挺有成就感,挺有意思,工作是辛苦的,结果却是快乐的.现在将这中快乐的的心情与大家分享一下.    真个项目用一颗主控搞定,ARM9的,200KBytes 片内RAM,主频可以跑到300MHz,64pin LQFP封装

nyxsec的专栏 3684

开源GPT-4小羊驼(Vicuna)快速上手指南

Vicuna: 一个开源的GPT,宣称实现了GPT-4 90%的功能。UC伯克利学者联手CMU、斯坦福等,再次推出一个全新模型70亿/130亿参数的Vicuna,俗称「小羊驼」(骆马)。并且和其他以往不同的是你可以在自己的设备上跑起来!比如Mac,再比如你的主力机!

weixin_34382392的博客 9412

U盘 未知USB设备 设定地址失败 由于该设备有问题Windows 已将其停止(代码 43) 终极解决方案(做过系统装机盘而无法解决的必看)

U盘由于该设备有问题Windows 已将其停止(代码 43) 终极解决方案 我们在使用U盘的时候偶尔会碰到下列情况 一般是因为传输数据的过程中,死机或未响应直接断点或拔掉设备导致的,U盘再次插上之后出现设定地址失败。无法再次读取设备的数据。 解决方案: 首先请确认出现该情况不是因为你摔了U盘或接口处产生断裂这种物理损伤导致的!!! 首先请确认出现该情况不是因为你摔了U盘或接口处产生断裂这种物理损...

qq_39123987的博客 13万+

利用autojs制作抢购支付宝消费劵的手机脚本

前期准备工作 1.打开支付宝,点击中间的抢消费券的广告 2.点击左上角,将抢购页面添加到首页 3.查看支付宝首页是否出现消费劵 . autojs代码 "auto"; functiontaskstart(){ sleep(1000); launchApp('支付宝'); toast("正在打开支付宝应用"); sleep(1000); varxf=textContains("消费").findOne().bounds(); ...

洛阳泰山的博客 1万+

第六十五回 时迁火烧翠云楼 吴用智取大名府-羊驼大模型的部署应用:llama.cpp和llama.c纯c编译安装部署 以及Ollama一键部署

LLaMA羊驼模型是元宇宙平台公司(Meta)公开发布的一款大型语言模型。该模型建立在Transformer基础架构上,采用了多层神经网络结构,有助于捕捉和学习数据中的复杂模式。这种设计使得LLaMA模型在自然语言处理方面表现突出,能够进行语义分析、情感识别和文本生成,广泛应用于人工智能各种场景。羊驼模型最显著的特点之一是它的开源性,这意味着任何研究人员或开发者都可以访问和使用该模型的源代码。此外,羊驼模型是在公开预训练数据上进行训练的,这保证了其通用性和可复现性。

skywalk8163的专栏 1844

小白也能轻松部署 OpenClaw:OpenClaw可视化部署工具+OpenClaw可视化管理工具分享

分享一个OpenClaw可视化一键部署工具,帮你快速打造属于自己的AI助手 🚀

XiaoqiangClub的博客 6711

【AI大模型】羊驼大模型详解_大模型 羊驼

可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。AI大模型应用所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。网上虽然也有很多的学习资源,但基本上都残缺不全的,这是我自己整理的大模型视频教程,上面路线图的每一个知识点,我都有配套的视频讲解。模型的提升一般模型本身没有多大的进化, 主要的提升是。

二狗的博客 905

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

部署运行Vicuna(小羊驼)

根据GitHub上简介可以知道:运行Vicuna-7B需要RAM>30GB或者14GB的显存运行Vicuna-13B需要RAM>60GB或者28GB的显存由于本地我没有足够的硬件设备,所以本次部署采用的是网上租用设备来部署我使用的是矩池云提供的服务。可使用CPU数可使用内存硬盘840 GB硬盘带宽可用空间CPU型号100 GB。

wstc2689784536的博客 4779

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

【AI大模型】羊驼大模型详解_大模型 羊驼,零基础入门到精通,收藏这一篇就够了

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;国内很多大模型都是学Alpaca模型的玩法,套壳LLaMA模型低成本训练出自己的模型。

heaven522的博客 2112

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

Llama2通过llama.cpp模型量化 Windows&Linux本地部署

本地部署和使用llama.cpp进行量化Llama2,linux和Windows平台方案,支持CPU和GPU多版本。

早安不安的博客 9879
上一篇: 只需5步,就可以使用大语言模型(LLM)打造高效的应用
下一篇: 基于大模型的临床试验情报平台:智能赋能医疗决策
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值