快速上手 Hugging Face Transformers:完整模型微调训练步骤全攻略

Ollama与Hugging Face:AI大模型本地部署与集成实战指南 在人工智能领域,大语言模型已成为推动技术创新的核心引擎。其背后的Transformer架构通过自注意力机制实现了对序列数据的强大建模能力,为自然语言处理、代码生成等任务带来了革命性突破。从技术价值看,大模型不仅提升了AI任务的性能上限,更通过标准化接口降低了开发门槛,使得模型即服务(MaaS)成为可能。在实际应用场景中,开发者常面临模型部署复杂、环境配置繁琐等工程挑战,而开源模型社区与本地化工具的结合正是解决这些痛点的关键。本文聚焦于Hugging Face这一全球最大的AI模型生态平台,以及Ollama这 阅读详情

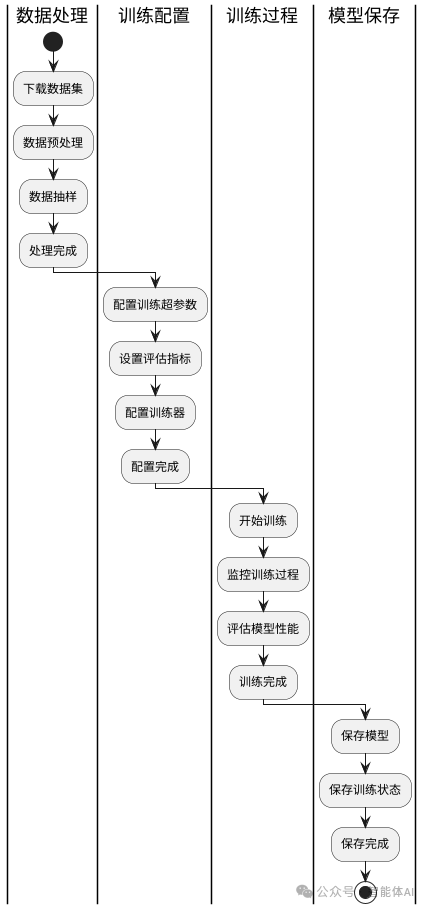
在自然语言处理(NLP)领域,模型微调(Fine-Tuning)是提升预训练模型在特定任务上表现的关键步骤。本文将详细介绍如何使用 Hugging Face Transformers 库进行模型微调训练,涵盖数据集下载、数据预处理、训练配置、评估、训练过程以及模型保存。我们将以 YelpReviewFull 数据集为例,逐步带您完成模型微调训练的整个过程。
图片

一、数据集下载

1.1 获取 YelpReviewFull 数据集

YelpReviewFull 数据集是一个经典的情感分析数据集,包含了大量来自 Yelp 的评论。数据集从 Yelp Dataset Challenge 2015 数据中提取,主要用于文本分类任务,目标是预测评论的情感分数。数据集的评论主要用英语编写,适合进行情感分类研究。

1.2 数据集结构与实例

数据集包含两个主要字段:

  • text: 评论的文本内容。
  • label: 评论的情感标签,范围从 1 到 5。

例如,一个典型的数据点如下:

{
    'label': 0,    
    'text': 'I got \'new\' tires from them and within two weeks got a flat...'
}

** **

1.3 数据拆分

数据集的总量为 700,000 条记录,其中包括 650,000 个训练样本和 50,000 个测试样本。在实际操作中,我们通常会将数据集随机拆分为训练集和测试集。例如,我们可以选择 130,000 个训练样本和 10,000 个测试样本用于模型训练和评估。

1.4 下载数据集代码

可以使用 Hugging Face 的 datasets 库来下载数据集:

在这里插入图片描述

二、数据预处理

2.1 数据预处理步骤

下载数据集后,我们需要对文本数据进行预处理,以便于模型的训练。预处理包括将文本转换为模型可以接受的输入格式。通常,我们使用 Tokenizer 对文本进行编码,并进行填充(padding)和截断(truncation)。

以下代码展示了如何使用 BERT Tokenizer 对数据集进行预处理:

在这里插入图片描述

在这里插入图片描述

2.2 数据抽样

在训练过程中,为了更好地控制训练过程,我们可以从数据集中抽样出一部分数据进行测试。例如,选择 1000 个样本进行小规模训练:

# 从数据集中抽样 1000 个训练样本
small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))

# 从数据集中抽样 1000 个测试样本
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))

三、训练评估指标设置

3.1 微调训练配置

在微调模型之前,我们需要配置训练参数,包括加载模型和设置训练超参数。以下代码展示了如何加载 BERT 模型,并为情感分类任务配置输出标签数量:

from transformers import AutoModelForSequenceClassification

# 加载 BERT 模型,并设置标签数量为 5(情感评分从 1 到 5)
model = AutoModelForSequenceClassification.from_pretrained("bert-base-cased", num_labels=5)

3.2 训练超参数配置(TrainingArguments)

我们使用 TrainingArguments 来配置训练超参数。这些参数包括训练批次大小、训练轮数、日志记录频率等。以下是一个示例配置:

在这里插入图片描述

四、训练器基本介绍

4.1 训练指标评估

Hugging Face 提供了 evaluate 库来计算模型的评估指标。例如,我们可以使用准确率(accuracy)作为评估指标。以下代码展示了如何使用 evaluate 库计算模型的准确率:
在这里插入图片描述

4.2 训练器(Trainer)

Trainer 类是 Hugging Face 提供的用于训练和评估模型的工具。我们需要将模型、训练参数、数据集以及计算指标的函数传递给 Trainer:

在这里插入图片描述

五、实战训练

5.1 训练过程中的指标监控

为了监控训练过程中的评估指标,我们可以配置 TrainingArguments 中的 evaluation_strategy 参数,以便在每个 epoch 结束时报告评估指标:
在这里插入图片描述

5.2 开始训练

使用 Trainer 类的 train 方法开始训练模型:

# 开始训练
trainer.train()

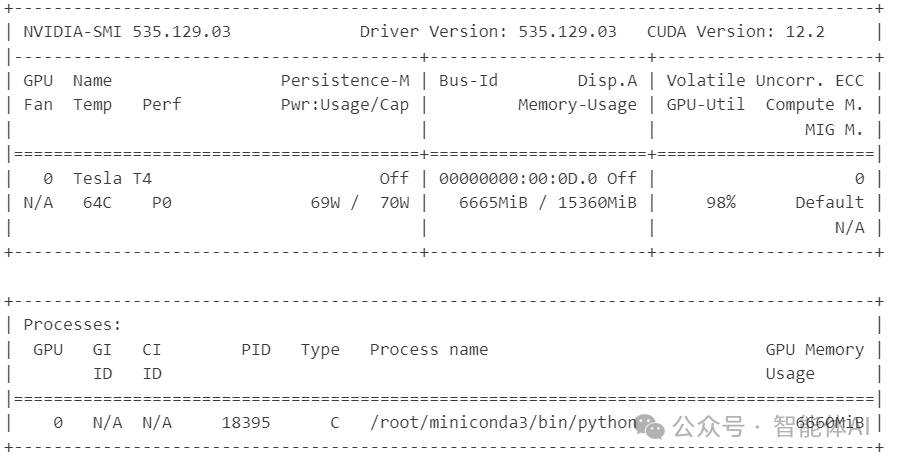
5.3 使用 nvidia-smi 监控 GPU 使用

在训练过程中,使用 nvidia-smi 命令监控 GPU 的使用情况,以确保训练过程的高效进行:

watch -n 1 nvidia-smi
图片

六、模型保存

6.1 保存模型和训练状态

训练完成后,我们需要保存模型及其训练状态,以便后续加载和使用:

在这里插入图片描述

通过 trainer.save_model 方法保存模型,您可以使用 from_pretrained() 方法重新加载模型。trainer.save_state() 方法保存训练状态,便于后续继续训练或评估。

七、完整代码汇总

下面是包含所有步骤的完整代码示例:

# 导入必要的库
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForSequenceClassification, TrainingArguments, Trainer
import numpy as np
import evaluate

# 数据集下载
dataset = load_dataset("yelp_review_full")

# 数据预处理t
okenizer = AutoTokenizer.from_pretrained("bert-base-cased")

def tokenize_function(examples):
    """    
    使用 Tokenizer 对文本进行编码,并进行填充和截断    
    """    
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)

# 数据抽样
small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))

# 模型加载与训练配置
model = AutoModelForSequenceClassification.from_pretrained("bert-base-cased", num_labels=5)

model_dir = "models/bert-base-cased-finetune-yelp"

training_args = TrainingArguments(
    output_dir=model_dir,    
    per_device_train_batch_size=16,    
    num_train_epochs=5,    
    logging_steps=100
)

# 指标评估
metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    """    
    计算准确率    
    """    
    logits, labels = eval_pred    
    predictions = np.argmax(logits, axis=-1)    
    return metric.compute(predictions=predictions, references=labels)

# 实例化 Trainer
trainer = Trainer(
    model=model,    
    args=training_args,    
    train_dataset=small_train_dataset,    
    eval_dataset=small_eval_dataset,    
    compute_metrics=compute_metrics
)

# 开始训练
trainer.train()

# 监控 GPU 使用
# 使用命令行工具: watch -n 1 nvidia-smi

# 保存模型和训练状态
trainer.save_model(model_dir)
trainer.save_state()

八、总结

本文详细介绍了使用 Hugging Face Transformers 库进行模型微调训练的完整流程,包括数据集下载、数据预处理、训练配置、评估、训练过程和模型保存等步骤。希望这些信息能帮助您更好地进行模型微调,提高模型在特定任务上的表现。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

Hugging Face 收入破1.5亿:模型下载、量化与镜像全攻略 大语言模型应用落地的核心,不止于算法调优,更在于模型获取、部署与推理效率。开发者日常需要面对从 Hugging Face 拉取权重、管理本地缓存、选择量化格式到国内网络访问等一系列工程问题。GGUF 等量化技术通过降低权重精度,让 7B 级模型在消费级硬件上流畅运行,显著降低推理资源门槛。而 hf-mirror 镜像、离线分发、缓存目录规划则成为国内开发者保障下载稳定性的实用手段。理解这些基础设施的运作原理,能够帮助团队在模型版本管理、部署选型和成本控制上做出更合理决策。本文从 Hugging Face 生 阅读详情

相关推荐

Yelp reviews - Full-数据集

来自 2015 年 Yelp Dataset Challenge 数据集的 1,569,264 个样本。每个评级分别包含 130,000 个训练样本和 10,000 个 测试样本。 This article offers an empirical exploration on the use of character-level convolutional networks (ConvNets) for text classification. We constructed several large-s

不务正业的猿 1719

大模型 | 快速上手 Hugging Face Transformers:完整模型微调训练步骤全攻略

Hugging Face 提供了 evaluate 库来计算模型的评估指标。例如,我们可以使用准确率(accuracy)作为评估指标。

老皮的博客 1988

AI大模型入门指南:学习路径、代码实战与微调部署全攻略

大模型并非遥不可及的魔法,本质上是海量参数堆叠的概率模型。理解其预测下一个词的核心原理,再借助Transformer架构与Attention机制,即可构建基础认知。当前开源工具链已高度成熟,Hugging Face、LLaMA-Factory等框架极大降低了技术门槛,让普通开发者仅凭Python基础就能跑通推理、微调与部署的全流程。从业务价值看,通过LoRA等高效微调技术,企业可用少量数据快速打造垂直领域专属模型,同时借助vLLM实现高并发生产级服务。这一整套路径不仅适用于AI初学者,也为传统开发者转型提供

weixin_29051811的博客 247

Hugging Face教程 - 1、transformers模型库

hugging face学习教程- 1、transformers模型库

m0_46850835的博客 1596

如何利用Arcgis进行地统计学分析(三):空间插值方法选择与优化

本文深入探讨了在Arcgis中进行地统计学分析时,如何根据探索性数据分析(EDA)结果科学选择与优化空间插值方法。文章对比了IDW、RBF、克里金等主流方法的适用场景与核心参数,并通过实战案例详解了从数据诊断到模型调优的完整流程,强调结合半变异函数与趋势分析进行“对症下药”,以提升插值结果的精度与可靠性。

weixin_29281915的博客 120

Flink实战项目——城市交通实时监控平台

本项目是与公安交通管理综合应用平台、机动车缉查布控系统等对接的,并且基于交通部门现有的数据平台上,进行的数据实时分析项目。

yangwei2048的博客 837

一起学Hugging Face Transformers(9) - 微调(Fine-tuning)简介

在大模型学习的过程中,我们经常听到“微调”这个词。也有很多的微调框架。很多人几乎达到了什么模型都要拿来微调下才能用的程度。那到底什么是微调,我想用通俗易懂的方式讲解一下大模型里常说的“微调”(Fine-tuning)。想象一下,你买了一本非常厚的百科全书,里面包含了世界上各种各样的知识。这本百科全书就像是一个预训练的大模型,里面已经包含了大量的信息和知识。然而,当你需要在考试中回答特定学科的问题时,比如历史或生物学,单靠这本通用的百科全书可能还不够。

一起来研究langchain和langchain-chatchat 1795

Amesim与Simulink联合仿真:S-Function接口配置与实战避坑指南

本文详细介绍了Amesim与Simulink联合仿真中S-Function接口的配置方法与实战避坑指南。从环境搭建、编译器配置到S-Function接口实战,逐步解析关键步骤与常见问题解决方案,帮助工程师高效实现多领域系统仿真,特别适合汽车、航空航天等复杂系统建模场景。

weixin_29173777的博客 344

Hugging Face Transformers库实战:预训练模型与分词器加载全攻略

预训练模型作为深度学习领域的核心技术,通过在超大规模数据集上进行通用特征学习,为下游任务提供了强大的基础。其核心原理是利用迁移学习,将通用知识迁移到特定任务,从而显著降低数据需求、缩短训练周期并提升模型性能。在自然语言处理(NLP)和计算机视觉(CV)等场景中,预训练模型已成为项目开发的基石。分词器作为连接原始文本与模型数字世界的桥梁,负责将文本序列转化为模型可处理的词元ID,并构建注意力掩码等关键输入。Hugging Face Transformers库通过统一的AutoClass API,极大地简化了B

weixin_34037515的博客 605

数字IC设计避坑指南:为什么477条net的DRV问题无法修复?解析don‘t touch hierarchy的影响

本文深入解析了数字IC后端实现中,因“don't touch hierarchy”约束导致大量DRV违规(如477条net)无法自动修复的根本原因。文章以Cadence Innovus工具为例,详细阐述了DRV修复机制与设计保护约束的冲突原理,并提供了从日志定位、风险评估到分级解除约束的完整实战策略,帮助工程师有效解决此类设计收敛难题。

hope8的博客 290

学术规范与论文写作(雨课堂)研究生 全部答案

1:如何造就优秀的学术论文 论文语法判断题 :全部是错的 2:如何撰写学术论文 3: SCI论文写作经验分享 4:论文写作与投稿技巧 5:学术伦理道德 答案仅供参考,研究生生活不易,大家如果有时间的话,还是可以学习学习的,毕竟老师讲的不错。加油,希望读研的每一个人都能顺利毕业! ...

Always-Learning 13万+

深度学习神器 Hugging Face Transformers 深度解析:从核心功能到设计哲学全攻略

当我们提到 “全场景 AI 开发” 时,Hugging Face Transformers 绝对是绕不开的存在。这个库究竟有多强大?简单来说,它是一个覆盖自然语言处理(NLP)、计算机视觉(CV)、音频处理、多模态任务的全能型选手。无论你是想做文本生成、图像分割,还是语音识别、文档问答,它都能提供成熟的预训练模型和工具链。Hugging Face Transformers 库的出现,彻底改变了机器学习开发的模式 —— 它让顶级模型触手可及,让复杂任务简化为几行代码,让资源浪费大幅减少。

佑瞻的博客 1147

SAP Parallel Accounting(平行分类账业务)配置及操作手册(超详细的说明和测试)

非常详细的介绍了SAP 的平行分类账配置以及测试效果哦

nopicture的博客 4345

AI开发实战:从GPU环境搭建到Hugging Face模型微调全攻略

GPU作为AI计算的并行引擎,其大规模矩阵运算能力是深度学习模型训练与推理的核心基础。在PyTorch等主流框架中,CUDA架构使得GPU能够高效处理张量计算,显著加速模型迭代过程。这种算力支撑对于实现模型从理论到落地的技术价值至关重要,尤其在自然语言处理、计算机视觉等应用场景中。面对当前普遍存在的算力焦虑问题,开发者需要掌握从本地环境配置到云端资源调度的完整解决方案。本文聚焦于GPU算力获取与优化,详细解析如何搭建稳定的PyTorch GPU开发环境,并利用Hugging Face生态系统进行模型微调实践

weixin_30482181的博客 441

Wi-Fi QoS中AIFSN/CWmin/CWmax/TxOP参数是怎样计算的?

802.11e/WMM的EDCA机制通过AIFS、CWmin/CWmax和TxOP三组参数实现业务优先级控制。AIFS决定最短等待时间(AIFS=SIFS+AIFSN×SlotTime),CWmin/CWmax定义退避范围(2^ECW-1),TxOP设置最大占用时长(32µs单位)。默认配置中,语音业务(VO)优先级最高,其AIFSN最小(2)、CW范围最小(3-7)、TxOP适中(1.504ms);视频(VI)次之;普通数据(BE)和后台(BK)优先级最低。调优需根据网络特性调整参数:VoIP可降低AIF

1042484520@qq.com(邮箱) 1746

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

还在自己写大模型训练代码?快住手!Hugging Face生态全攻略,让你效率提升10倍

Hugging Face 是一家提供开源 AI 工具和平台的公司,致力于简化预训练模型的使用,加速机器学习项目的开发与落地。

m0_59164520的博客 1203

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Hugging Face预训练模型加载全攻略:从标识符到验证的实践指南

在自然语言处理领域,预训练模型已成为核心技术范式,其通过大规模数据预训练获得通用语言表示能力。其工作原理基于Transformer架构,通过自注意力机制捕捉文本长距离依赖关系。这一技术的核心价值在于显著降低下游任务开发门槛,实现模型能力的快速迁移。在实际工程应用中,开发者常面临模型加载、分词器配置等基础但关键的挑战。例如,针对中文预训练模型,需特别注意其字级别分词特性,避免额外分词工具引入的不匹配;同时,利用Hugging Face镜像可有效解决网络访问问题,提升模型下载效率。掌握这些基础实践,是确保后续微

weixin_30448603的博客 319

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

153_开源贡献:Hugging Face PR全攻略 - 从新手到核心贡献者的社区参与最佳实践指

在当今大语言模型(LLM)快速发展的时代,Hugging Face已成为开源AI领域的核心平台。作为一个汇聚了数千个预训练模型、数据集和工具的生态系统,Hugging Face为AI研究者、开发者和企业提供了丰富的资源。对于任何希望深入了解和参与LLM技术发展的人来说,为Hugging Face项目贡献代码不仅是提升个人技能的绝佳途径,也是在AI社区建立影响力的重要方式。

欢迎来到智能安全前线!这里是AI与信息安全交汇之地。我们以代码为武器,深入大模型攻防实战,破解系统漏洞。追踪OpenAI、Meta前沿动态,用红蓝对抗思维,锻造智能时代的坚盾与利矛。 1144

中文bert模型快速入门:bert-base-chinese预训练模型部署与使用全攻略

本文介绍了如何在星图GPU平台上自动化部署bert-base-chinese预训练模型,快速搭建中文NLP开发环境。该平台简化了环境配置,用户可立即体验模型的三大核心功能:完型填空、语义相似度计算与文本特征提取,为智能客服、文本分类等应用提供强大的语义理解基础。

weixin_36197669的博客 97

Open-AutoGLM模型获取全攻略(Hugging Face下载避坑指南)

快速掌握Open-AutoGLM Hugging Face 下载方法,解决模型获取难题。适用于自动化代码生成与自然语言处理任务,提供详细步骤与常见问题避坑指南,确保高效稳定部署。操作简单、资源可靠,值得收藏。

BytePulse的博客 633

从理论到实践:Gemma 3-27B-IT模型训练与微调全攻略

Gemma 3-27B-IT是Google推出的新一代多模态开源大模型,基于与Gemini相同的技术架构构建,支持文本和图像输入,具备128K上下文窗口和多语言处理能力。本文将从模型原理、环境搭建到微调实践,全方位解析如何高效使用这一强大的AI工具。 ## 🧠 模型核心特性解析 Gemma 3-27B-IT作为Gemma系列的旗舰型号,在保持轻量化特性的同时实现了性能突破。从[config.

gitblog_01266的博客 655

L-MChat-7b环境配置全攻略:从PyTorch到transformers依赖安装

想要快速上手L-MChat-7b大语言模型吗?这篇完整的环境配置指南将带你一步步完成从零开始的安装过程,让你在最短时间内成功运行这个强大的7B参数模型!😊 L-MChat-7b是一个基于Apache 2.0许可证的开源大语言模型,支持中文对话和多种自然语言处理任务。无论你是AI初学者还是有经验的开发者,这份详细的配置教程都能帮助你顺利搭建运行环境。 ## 📋 环境配置前置准备 在开始安装L

gitblog_00157的博客 679

从零上手MiniCPM 2.0:端侧大模型本地部署全攻略

在大语言模型参数竞赛愈演愈烈的当下,面壁智能与清华大学自然语言处理实验室联合研发的MiniCPM系列,正以"小而美"的技术路径开辟全新赛道。作为端侧部署的标杆产品,MiniCPM-2B模型仅包含24亿非词嵌入参数(总参数量2.7B),却在经过监督微调(SFT)后展现出惊人性能:在公开综合性评测集上与70亿参数的Mistral-7B旗鼓相当,尤其在中文处理、数学推理和代码生成领域实现反超,整体性能更

gitblog_00042的博客 1159
上一篇: Prompt输出限制怎么写?用CCoT限制输出长度的推理,大幅提高LLM准确性
下一篇: 爆了爆了!清华大学出版《自然语言处理:原理、方法与应用》自然语言处理直通车!
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值