《开源大模型食用指南》,一杯奶茶速通大模型!新增Examples最佳实践!

AI提示工程本质:从NLP原理到链式提示的工业级实践 大语言模型并非真正理解语言,而是基于统计规律的概率接龙系统;其响应质量根本取决于人类能否将模糊意图转化为可计算、可验证、可结构化的指令。这背后涉及自然语言处理(NLP)的token机制、提示工程(Prompting)的约束设计,以及链式提示(Chain Prompting)的任务流水线构建。掌握这些底层逻辑,才能摆脱‘调参碰运气’,实现稳定、可控、可复用的AI协作。本文聚焦真实业务场景中的提示失效归因与工程化解法,覆盖system message操作系统化、user message工单化、温度参数确定性调控 阅读详情

01

「Example系列的前世今生」

我们希望成为 LLM 与普罗大众的阶梯,以自由、平等的开源精神,拥抱更恢弘而辽阔的 LLM 世界。
Self-llm 开源项目是一个围绕开源大模型、针对国内初学者、适合中国宝宝的专属大模型教程,针对各类开源大模型提供包括环境配置、本地部署、高效微调等技能在内的全流程指导,简化开源大模型的部署、使用和应用流程,让更多的普通学生、研究者更好地使用开源大模型,帮助开源、自由的大模型更快融入到普通学习者的生活中。
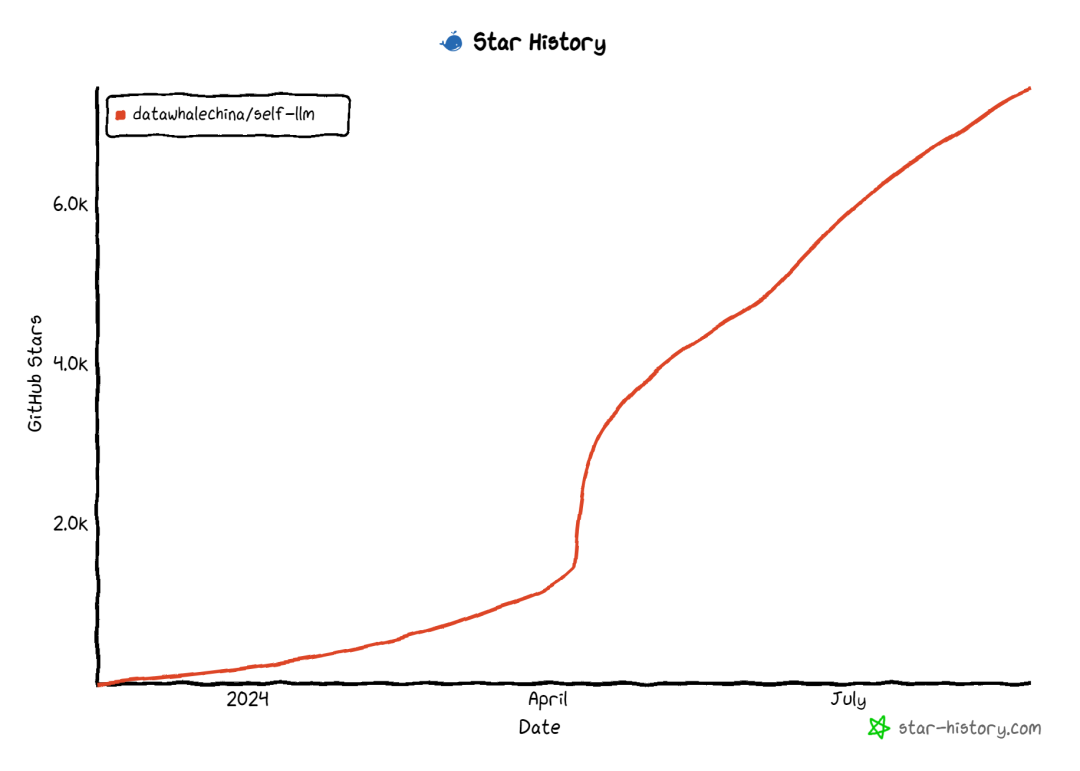
为了进一步深化学习者对大模型应用的理解,self-llm项目特别增加了大模型最佳实践应用集合。应用将不断更新,以反映最新的技术进展和应用趋势。筹备已久 self-llm examples 系列第一期现已更新,这标志着我们self-llm项目的进一步拓展。

Examples 系列的目标是帮助学习者在完成基础知识学习后,通过精选的实际案例,深入理解和掌握大模型应用开发的核心技术。这些案例将涵盖不同的实际应用类型,引导学习者探讨和实践如何有效利用大模型解决实际问题。我们期望,通过这些精心设计的大模型应用项目示范(Demo),学习者能够在完成我们的示例后,不仅全面掌握大模型应用开发的技术要点,还能具备独立进行大模型应用的二次开发或自主开发的能力。项目以教程及blog形式展示。

项目地址↓ 欢迎 Star ⭐️

https://github.com/datawhalechina/self-llm/tree/master/examples

02

Examples系列第一期

「Chat嬛嬛 是如何炼成的」
Chat-甄嬛是利用《甄嬛传》剧本中所有关于甄嬛的台词和语句,基于大模型进行LoRA微调得到的模仿甄嬛语气的聊天语言模型。

甄嬛,小说《后宫·甄嬛传》及同名电视剧女主角,原为汉人甄远道之女,后被雍正帝赐姓钮祜禄氏,成为满洲上三旗成员。因容貌酷似已故纯元皇后而入宫,历经宫斗,从青涩少女成长为宫斗高手。在皇帝发现年氏一族野心后,甄嬛协助皇帝剪除政敌,深得宠爱。经历被皇后陷害、出宫为尼、与果郡王相爱等波折后,设计回宫并生下双生子。最终在一系列阴谋中斗垮皇后,毒杀雍正,成为乾隆帝的圣母皇太后,权倾朝野。

Chat-甄嬛,实现了以《甄嬛传》为切入点,打造一套基于小说、剧本的个性化 AI 微调大模型完整流程,通过提供任一小说、剧本,指定人物角色,运行本项目完整流程,让每一位用户都基于心仪的小说、剧本打造一个属于自己的、契合角色人设、具备高度智能的个性化 AI。

Chat-嬛嬛模型累计下载量 15.6k

Modelscope 地址:

https://www.modelscope.cn/models/kmno4zx/huanhuan-chat-internlm2

Chat-嬛嬛累计获得 500 star

huahuan-chat 项目地址:

https://github.com/KMnO4-zx/huanhuan-chat.git

xlab-huanhuan-chat 项目地址:

https://github.com/KMnO4-zx/xlab-huanhuan.git

OK,那接下来我将会带领大家亲自动手,一步步实现 Chat-甄嬛 的训练过程,让我们一起来体验一下吧~

Step 1: 环境准备

本文基础环境如下:


\----------------  
ubuntu 22.04  
python 3.12  
cuda 12.1  
pytorch 2.3.0  
\----------------


本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。

首先 pip 换源加速下载并安装依赖包


# 升级pip  
python -m pip install --upgrade pip  
# 更换 pypi 源加速库的安装  
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple  
  
pip install modelscope==1.16.1  
pip install transformers==4.43.1  
pip install accelerate==0.32.1  
pip install peft==0.11.1  
pip install datasets==2.20.0  


Step 2: 数据准备

首先,我们需要准备《甄嬛传》剧本数据,这里我们使用了《甄嬛传》剧本数据,我们可以查看一下原始数据的格式。


第2幕  
(退朝,百官散去)  
官员甲:咱们皇上可真是器重年将军和隆科多大人。  
官员乙:隆科多大人,恭喜恭喜啊!您可是国家的大功臣啊!  
官员丙:年大将军,皇上对你可是垂青有加呀!  
官员丁:年大人,您可是皇上的股肱之臣哪!  
苏培盛(追上年羹尧):年大将军请留步。大将军——  
年羹尧:苏公公,有何指教?  
苏培盛:不敢。皇上惦记大将军您的臂伤,特让奴才将这秘制的金创药膏交给大人,叫您使用。  
年羹尧(遥向金銮殿拱手):臣年羹尧恭谢皇上圣恩!敢问苏公公,小妹今日在宫中可好啊?  
苏培盛:华妃娘娘凤仪万千、宠冠六宫啊,大将军您放心好了。  
年羹尧:那就有劳苏公公了。(转身离去)  
苏培盛:应该的。  


每一句都有人物及对应的台词,所以就可以很简单的将这些数据处理成对话的形式,如下:


\[  
    {"rloe":"官员甲", "content":"咱们皇上可真是器重年将军和隆科多大人。"},  
    {"rloe":"官员乙", "content":"隆科多大人,恭喜恭喜啊!您可是国家的大功臣啊!"},  
    {"rloe":"官员丙", "content":"年大将军,皇上对你可是垂青有加呀!"},  
    {"rloe":"官员丁", "content":"年大人,您可是皇上的股肱之臣哪!"},  
    {"rloe":"苏培盛", "content":"年大将军请留步。大将军——"},  
    ...  
\]  


然后再将我们关注的角色的对话提取出来,形成 QA 问答对。对于这样的数据,我们可以使用正则表达式或者其他方法进行快速的提取,并抽取出我们关注的角色的对话。

然后很多情况下,我们并没有这样优秀的台词格式数据。所以我们可能就需要从一大段文本中抽取角色的对话数据,然后将其转换成我们需要的格式。

比如《西游记白话文》,我们可以看到他的文本是这样的。对于这样的文本,那我们就需要借助大模型的能力,从文本中提取出角色和角色对应的对话。然后再筛选出我们需要的橘角色对话。

可以借助一个小工具:extract-dialogue 从文本中提取对话。


......  
原来孙悟空走了以后,有一个混世魔王独占了水帘洞,并且抢走了许多猴子猴孙。孙悟空听到这些以后,气得咬牙跺脚。他问清了混世魔王的住处,决定找混世魔王报仇,便驾着筋斗云,朝北方飞去。  
  
不一会儿,孙悟空就来到混世魔王的水脏洞前,对门前的小妖喊到∶“你家那个狗屁魔王,多次欺负我们猴子。我今天来,要和那魔王比比高低!  
  
”小妖跑进洞里,报告魔王。魔王急忙穿上铁甲,提着大刀,在小妖们的簇拥下走出洞门。  
  
孙悟空赤手空拳,夺过了混世魔王的大刀,把他劈成了两半。然后,拔下一把毫毛咬碎喷了出去,毫毛变成许多小猴子,直杀进洞里,把所有的妖精全杀死,然后救出被抢走的小猴子,放了一把火烧了水脏洞。  
......


chat-甄嬛 的原始数据:

https://github.com/KMnO4-zx/huanhuan-chat/tree/master/dataset/input/huanhuan

西游记白话文原始数据:

https://github.com/KMnO4-zx/huanhuan-chat/blob/master/dataset/input/wukong/%E8%A5%BF%E6%B8%B8%E8%AE%B0%E7%99%BD%E8%AF%9D%E6%96%87.txt

最后再将其整理成 json 格式的数据,如下:


\[  
    {  
        "instruction": "小姐,别的秀女都在求中选,唯有咱们小姐想被撂牌子,菩萨一定记得真真儿的——",  
        "input": "",  
        "output": "嘘——都说许愿说破是不灵的。"  
    },  
    {  
        "instruction": "这个温太医啊,也是古怪,谁不知太医不得皇命不能为皇族以外的人请脉诊病,他倒好,十天半月便往咱们府里跑。",  
        "input": "",  
        "output": "你们俩话太多了,我该和温太医要一剂药,好好治治你们。"  
    },  
    {  
        "instruction": "嬛妹妹,刚刚我去府上请脉,听甄伯母说你来这里进香了。",  
        "input": "",  
        "output": "出来走走,也是散心。"  
    }  
\]


Chat-嬛嬛 的数据:

https://github.com/datawhalechina/self-llm/blob/master/dataset/huanhuan.json

所以,在这一步处理数据的大致思路就是:

1. 从原始数据中提取出角色和对话

2. 筛选出我们关注的角色的对话

3. 将对话转换成我们需要的格式

这一步也可以增加数据增强的环节,比如利用两到三条数据作为 example 丢给LLM,让其生成风格类似的数据。再或者也可以找一部分日常对话的数据集,使用 RAG 生成一些固定角色风格的对话数据。这里大家可以完全放开的大胆去尝试!

Step 3: 模型训练

那这一步,大家可能再熟悉不过了。在self-llm的每一个模型中,都会有一个 Lora 微调模块,我们只需要将数据处理成我们需要的格式,然后再调用我们的训练脚本即可。

此处选择我们选择 LLaMA3_1-8B-Instruct 模型进行微调,首先还是要下载模型,创建一个model_download.py文件,输入以下内容:


import torch  
from modelscope import snapshot\_download, AutoModel, AutoTokenizer  
import os  
  
model\_dir = snapshot\_download('LLM-Research/Meta-Llama-3.1-8B-Instruct', cache\_dir='/root/autodl-tmp', revision='master')


注意:记得修改 cache_dir 为你的模型下载路径哦~

其次,准备训练代码。对于熟悉 self-llm 的同学来说,这一步可能再简单不过了,在此处我会在当前目录下放置train.py,大家修改其中的数据集路径和模型路径即可。

当然也可以使用 self-llm 中的 lora 微调教程。

教程地址:

https://github.com/datawhalechina/self-llm/blob/master/models/LLaMA3/04-LLaMA3-8B-Instruct%20Lora%20%E5%BE%AE%E8%B0%83.md

在命令行运行以下指令:


python train.py


注意:记得修改 train.py 中的数据集路径和模型路径哦~

训练大概会需要 20 ~ 30 分钟的时间,训练完成之后会在output目录下生成lora模型。可以使用以下代码进行测试:


from transformers import AutoModelForCausalLM, AutoTokenizer  
import torch  
from peft import PeftModel  
  
mode\_path = './LLM-Research/Meta-Llama-3\_\_\_1-8B-Instruct'  
lora\_path = './output/llama3\_1\_instruct\_lora/checkpoint-699' # 这里改称你的 lora 输出对应 checkpoint 地址  
  
# 加载tokenizer  
tokenizer = AutoTokenizer.from\_pretrained(mode\_path, trust\_remote\_code=True)  
  
# 加载模型  
model = AutoModelForCausalLM.from\_pretrained(mode\_path, device\_map="auto",torch\_dtype=torch.bfloat16, trust\_remote\_code=True).eval()  
  
# 加载lora权重  
model = PeftModel.from\_pretrained(model, model\_id=lora\_path)  
  
prompt = "嬛嬛你怎么了,朕替你打抱不平!"  
  
messages = \[  
        {"role": "system", "content": "假设你是皇帝身边的女人--甄嬛。"},  
        {"role": "user", "content": prompt}  
\]  
  
input\_ids = tokenizer.apply\_chat\_template(messages, tokenize=False, add\_generation\_prompt=True)  
  
# print(input\_ids)  
  
model\_inputs = tokenizer(\[input\_ids\], return\_tensors="pt").to('cuda')  
generated\_ids = model.generate(model\_inputs.input\_ids,max\_new\_tokens=512)  
  
generated\_ids = \[  
    output\_ids\[len(input\_ids):\] for input\_ids, output\_ids in zip(model\_inputs.input\_ids, generated\_ids)  
\]  
response = tokenizer.batch\_decode(generated\_ids, skip\_special\_tokens=True)\[0\]  
print('皇上:', prompt)  
print('嬛嬛:',response)  


皇上: 嬛嬛你怎么了,朕替你打抱不平!  
嬛嬛: 皇上,臣妾不是故意的。  


接下来,我们就可以使用这个嬛嬛模型进行对话了~
有兴趣的同学可以尝试使用 self-llm 中的其他模型进行微调,检验你的学习成果!
​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

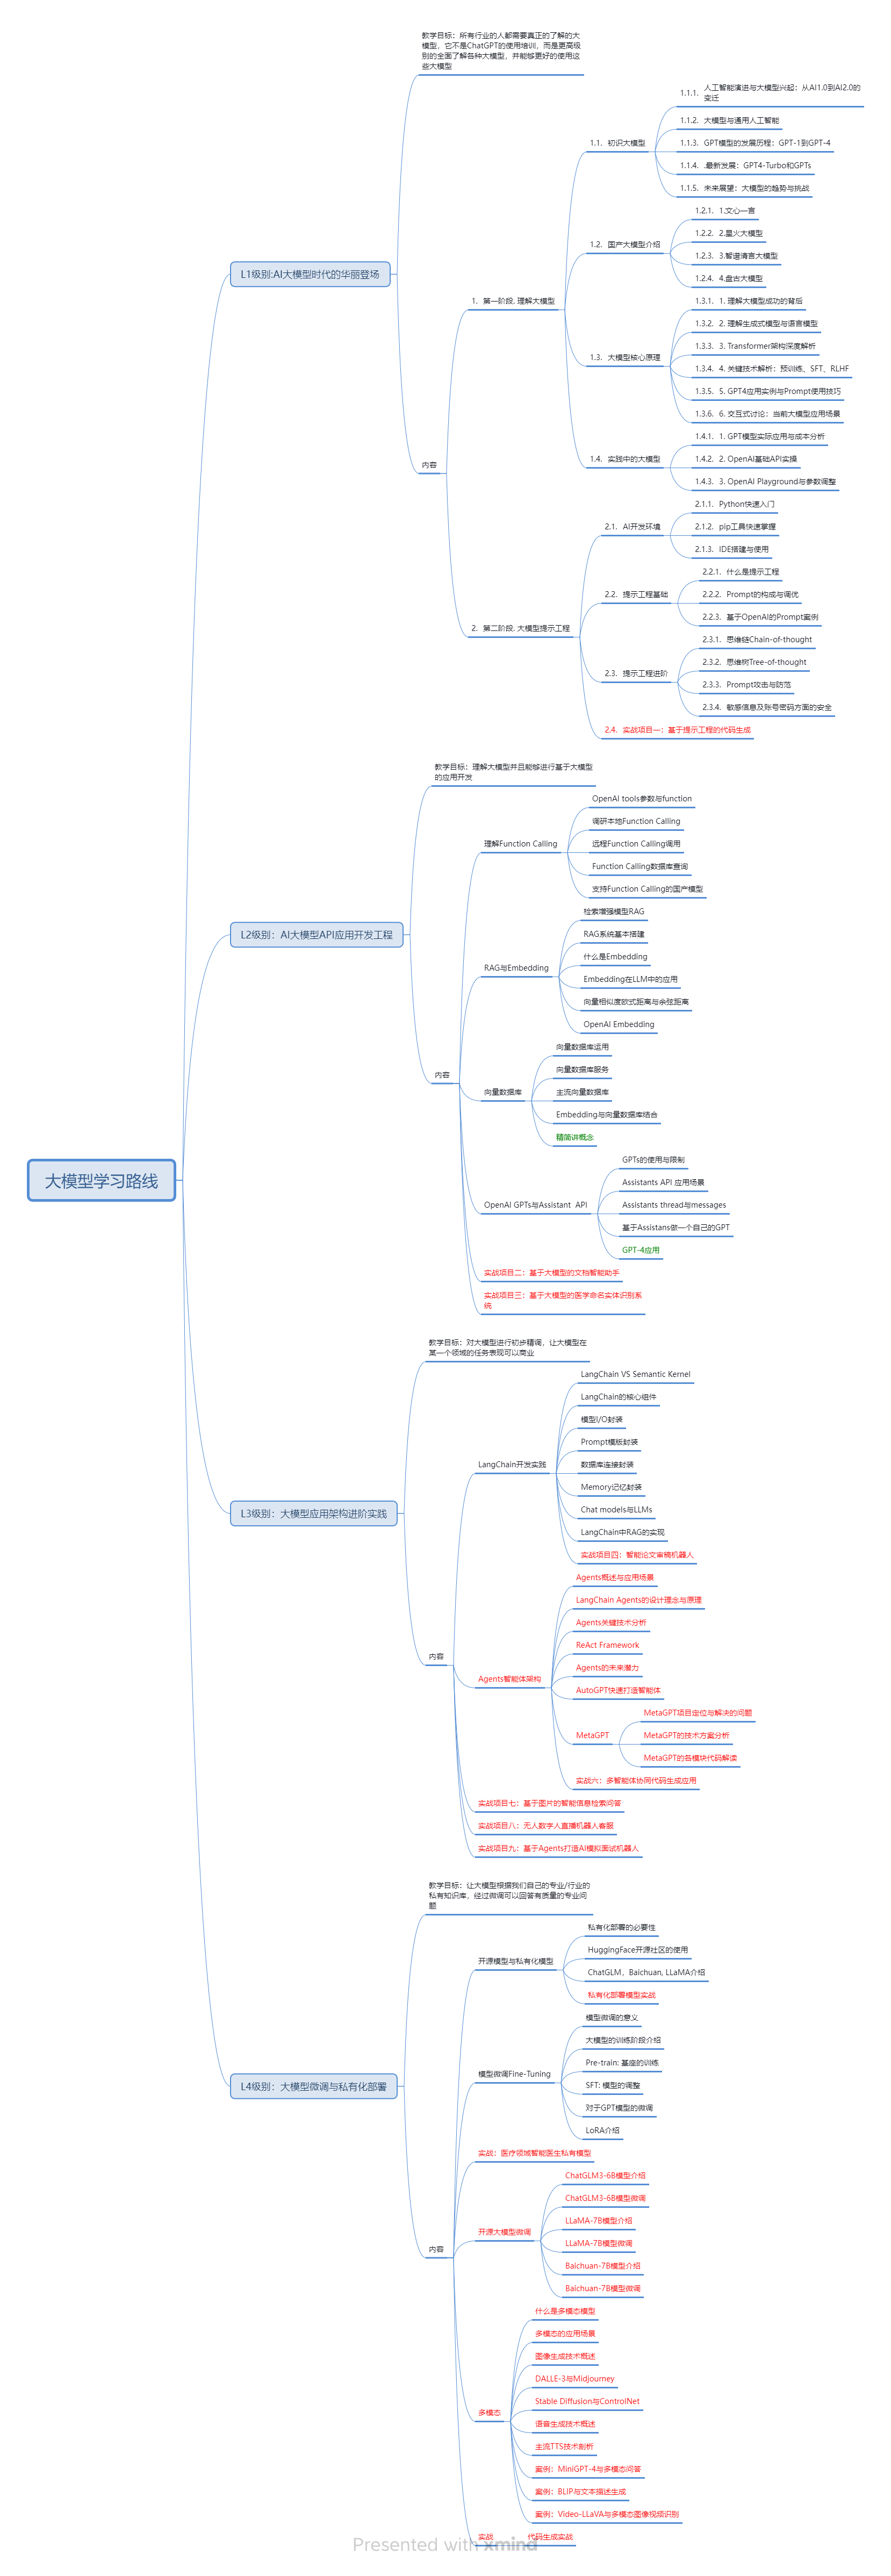
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Android Telephony主要模块及功能 Telephony的代码主要由五个模块组成 1.Telephony Frameworks 代码区域: frameworks/opt/telephony/ 其中主要的文件在如下目录 /frameworks/opt/telephony/src/java/com/android/internal/telephony/ 其中比较常见的有以下几类文件 1.BaseCommands、RIL构成R 阅读详情

相关推荐

OpenClaw安装方式那么多,但建议大家还是用云厂商吧

OpenCloud的安装方式多样,包括One-liner、npm、pnpm和Hackable等。One-liner提供高效的单行命令安装;npm和pnpm作为Node.js包管理工具,分别提供常规和高性能的安装选项;Hackable则支持定制化安装。不同系统(macOS、Windows)和终端(PowerShell、CMD)的操作步骤各有特点,用户需根据自身技术背景选择合适的安装方式。官方推荐使用闲置计算资源或云部署方案以获得更佳体验。

涛涛讲AI 1401

使用 modelscope产生的问题和解决方案

flyfish

二分掌柜的 6274

LPC2124定时器实现跑马灯

文章目录一、keil 4新建工程 一、keil 4新建工程 1、Create New Project,注意,最好添加进一个新建好的文件夹里,keil不会帮你新建。 2、添加设备类型:NXP目录下的LPC2124 3、选择启动文件Startu.s 4、new 一个file,保存命名为.c文件 5、添加进project里,右击,add 选中,添加 6、设置编译输出.hex文件 ...

qq_37937830的博客 5753

【大模型】通义千问safetensors_rust.SafetensorError: Error while deserializing header: HeaderTooLarge解决方法

通义千问safetensors_rust.SafetensorError

Zack的博客 1万+

J204B接口数据链路的建立

介绍J204B数据链路层的建立方式

QUACK_G的博客 6556

[kriging](一)网上下载的kriging克里金的C++程序的初步调试

笔者在网上下载了一份克里金的C++程序,水平有限,正在逐步地调试中。 初步 克里金法现在在许多软件都已经有集成了,据笔者所知: arcgis : 看过有的arcgis培训视频里面简略介绍了里面的插值方法,有克里金。 surfer :笔者用过这个,效果很好。 gocad :听说有 landmark &jason :研究生时候用的专业的石油物探软件,里面有克里金法,万恶的开始。 pykrig...

FOREST优快云 5613

从 `from modelscope import AutoModelForCausalLM` 说起:一行代码背后的人工智能生态

你是否曾对着 `from modelscope import AutoModelForCausalLM, AutoTokenizer` 这样一行看似简单的 Python 代码,好奇过它背后究竟隐藏了多少复杂的技术?一行代码,连接了庞大的人工智能模型生态。本文将带你层层深入,揭开这行代码背后的完整技术栈和工具链。

Vantastic999的博客 1948

【报错解决】彻底解决 CondaHTTPError: HTTP 000 CONNECTION FAILED for url 报错

CondaHTTPError: HTTP 000 CONNECTION FAILED for url 错误本质上是由于 Conda 无法访问远程仓库引起的,常见原因包括网络不通、防火墙或安全软件阻拦、SSL 证书异常以及默认仓库不可达。解决该问题的关键在于:确保网络畅通、配置国内稳定镜像源、调整防火墙和安全设置、处理 SSL 证书问题,并保持 Conda 版本更新。通过这些方法,几乎可以彻底消除连接失败问题,保证 Conda 环境的正常使用和包管理的稳定性。

博客 1164

【笔记】AutoModelForCausalLM

初学者肯定有很多不对头的地方,麻烦大家多多指点!!!

weixin_50862344的博客 2万+

Windows版TASSEL5的下载及安装

TASSEL5是一款用于研究表型和基因型关系的软件,由美国康奈尔大学Buckler实验室所研发。,选择Windows环境安装包下载并安装。1.安装成功后TASSEL5界面。

沉香best的博客 8190

基于 Google Colab 的 mask rcnn 训练自己的数据集(以实例分割为例)

详细步骤1 数据集的制作1.1 数据标注1.2 生成数据集2 环境的搭建2.1 搭建流程2.2 注意事项(报错)3 开始训练4 可视化4.1 修改webcam.py文件4.2 进行可视化5 参考文章 1 数据集的制作 1.1 数据标注 使用 labelme=4.5.6 版本进行标注,标注文件指定到保存图片的路径下,也就是json文件和jpg文件放在同一个文件夹里 1.2 生成数据集 先手动划分训练集和测试集(包括图像和标注文件),然后分别整合它们的标注信息,参考代码:1_ships_to_coco.py

G果的博客 8002

通义千问本地部署

*通义千问-14B(Qwen-14B)**是阿里云研发的通义千问大模型系列的140亿参数规模的模型。Qwen-14B是基于Transformer的大语言模型, 在超大规模的预训练数据上进行训练得到。预训练数据类型多样,覆盖广泛,包括大量网络文本、专业书籍、代码等。同时,在Qwen-14B的基础上,我们使用对齐机制打造了基于大语言模型的AI助手Qwen-14B-Chat。本仓库为Qwen-14B-Chat的Int4量化模型的仓库。如果您想了解更多关于通义千问-14B开源模型的细节,我们建议您参阅。

Python,数据分析,机器学习,深度学习 1万+

ANSYS——“There is at least 1 small equation solver pivot term”问题的解决办法

ANSYS——“There is at least 1 small equation solver pivot term”问题的解决办法

python_AI_fans的博客 1万+

【奶茶Beta专项】【LVGL9.4源码分析】01-目录结构

本文档系统梳理了LVGL v9.4的源码目录结构与功能模块。核心内容包括: 源码结构:核心代码位于src/目录,涵盖对象系统、渲染驱动等组件;第三方库集成在src/libs/;平台适配层包括drivers/、osal/等。 示例资源:demos/提供完整场景测试样例(如音乐播放器、性能压测),examples/按功能细分(动画、布局、组件等),并支持多种编解码器和字体引擎。 开发指引:文档明确移植入口(显示/输入驱动)、硬件加速选择(如DMA2D/OpenGL ES)、测试方法(tests/和demos/s

Bigan(安)的博客 1069

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

cocos-java实例_cocos-creator-examples

cocos-creator-examplescocos creator 一些使用实例 (刚体挖洞/流体效果/shader/纹理处理)欢迎关注微信公众号 白玉无冰一个简单的广告播放器小游戏(可以点两下支持一下~)cocos creator 2.4.x demodemo01brightness/saturation/constrast(亮度/饱和度/对比度 两种实现方式)demo02多边形裁剪图片与g...

weixin_30061949的博客 374

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大模型微调简单了解

大模型微调简单了解

zhk 57

ModelScope 本地部署终极指南:被云端账单劝退后,我用 3 行代码在本地跑起了第一个模型

如果你在深夜改过第七版 AI 接口调用代码,大概率也经历过这样的场景:文档里明明写着"传参即返回",可真跑起来,不是网络超时,就是配额耗尽,最扎心的是月底账单上那串数字——按次计费、按 token 计费、按调用量阶梯计费,眼花缭乱。 我后来换了一条路:把 ModelScope 整个搬到本地跑。这个开源项目解决的核心问题,就是让"模型即服务"(MaaS)真正落到你的机器上——不用上传数据、不用依赖

gitblog_00817的博客 335

大模型量化实战:从对称/非对称原理到PTQ工程落地

量化是将高精度浮点模型转换为低比特整数表示的核心技术,本质是一场带约束的仿射变换(缩放+零点偏移),旨在平衡精度、体积与推理效率。其数学基础在于scale因子与zero_point的协同设计:对称量化适用于以零为中心的权重分布,硬件友好;非对称量化则通过动态零点适配单侧激活值,显著提升实际任务精度。作为后训练量化(PTQ)的关键实践路径,它已成大模型端侧部署的刚需能力,广泛应用于边缘AI、工业嵌入式及移动端场景。本文聚焦INT4/INT8量化在真实项目中的原理验证、校准策略与避坑方法。

vanadiumlin 400

数据科学自学者生存指南:避开资源过载,构建可闭环学习路径

数据科学入门常被误认为是数学或编程能力的比拼,实则首要挑战在于信息过载与学习路径断裂。从‘概念理解’出发,需掌握统计建模、Python数据分析等基础原理;其技术价值在于将抽象算法转化为可执行、可验证的分析动作;典型应用场景包括业务指标归因、用户行为建模、结构化数据预测等真实工作流。本文聚焦‘可闭环学习资源’与‘任务驱动型路径’两大核心,结合Kaggle Learn沙盒环境、StatQuest视觉化讲解、Real Python生产级代码实践等高落地性工具,帮助零基础者在90分钟内跑通首个项目,并持续进阶至端到

weixin_38168786的博客 439

ML工程师进阶路线图:从学术代码到生产落地的实战指南

机器学习工程师的核心能力并非模型调参,而是构建稳定、可解释、可运维的端到端AI系统。其本质是数据工程、模型工程与MLOps实践的深度协同:需理解特征漂移对业务指标的影响机制,掌握Delta Lake等可信数据链路技术,熟悉ONNX Runtime部署、Kubeflow流水线编排及Prometheus可观测性基建。技术价值在于弥合学术代码与生产服务之间的断层,支撑风控、推荐、边缘智能等关键场景。本文聚焦本科生转型、ML工程化、模型落地瓶颈三大热词,提供带错误日志、参数依据与协作记录的工业级实操路径。

weixin_33947521的博客 324

GPT-4o+微信Canvas实现中文海报零错字渲染

中文AIGC海报长期受困于‘AI会写但不会正确渲染’的顽疾——本质是文本语义理解、字体引擎调用与图像级OCR校验三者脱节。GPT-4o凭借多模态感知与流式token响应能力,不再直接生成像素,而是作为智能排版中枢,实时完成字形合规校验、语义防歧识别与排版安全预判;结合微信原生Canvas API对TrueType字体的系统级支持,将文字渲染交由iOS CoreText/Android Skia底层引擎执行,实现亚像素级精度。该方案绕开Stable Diffusion等文生图模型的文本嵌入缺陷,使‘钜惠’不写

A08110123的博客 372

LLM的“跳跃”能力:从提示词到多任务泛化的技术解析

在自然语言处理领域,传统模型往往受限于单一任务训练,而大语言模型(LLM)展现出独特的“跳跃”能力——无需微调,仅通过提示词即可灵活切换文本分类、代码生成、数学推理等多种任务。这种能力源于预训练阶段对海量语料的统计规律建模,并体现在上下文学习、涌现能力与思维链等机制中。理解LLM的泛化原理,有助于开发者借助LangChain等框架构建稳定的多任务应用,同时规避输出不可控、格式不稳定等工程风险。从云端API调用到本地部署,再到Agent工具调用,LLM正逐渐成为通用的能力引擎。本文通过代码演示与问题排查,系统

weixin_30315435的博客 390

虚拟角色人设工程化:让‘JK小雾’稳定呈现天使气质的完整方案

大语言模型赋予了机器强大的生成能力,但要让虚拟角色真正具备稳定的人设,‘像人’并非模型问题,而是工程问题。基于TTS语音合成、对话人格配置、多轮上下文管理和内容安全过滤等核心机制,可以将“温柔天使”这样抽象的人设标签,拆解为可验证的功能模块。该方案适用于聊天机器人、虚拟主播、NPC等场景,通过身份配置、风格示例、禁止清单与安全兜底,使角色在连续对话中保持一致的表达与边界。本文以‘JK小雾’为例,完整展示从系统概念、环境搭建到代码实现的人设工程化落地路径,帮助开发者构建出有温度、可信赖的角色交互系统。

weixin_29056781的博客 356

报错:cannot import name ‘AutoModelForCausalLM‘ from ‘modelscope‘

由此可发现调用AutoModelForCausalLM的路径应为。

tq040626的博客 4810
上一篇: AI | 如何使用知识图谱和矢量数据库实现 Graph RAG
下一篇: 实测OpenAI最强模型o1:会做大学数理化,但弱智吧依然难解
冻感糕人~
博客等级 码龄3年 8926粉丝 2402原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值