


文章介绍了"context engineering"(上下文工程)这一Agent开发核心概念,解决了海量工具调用和长上下文导致的性能瓶颈问题。文章系统梳理了五大解决方案:转移、压缩、检索、隔离和缓存。结合"The Bitter Lesson"启示,指出随着模型能力提升,应构建更灵活、少结构化的系统,让机器通过大量数据和计算自主学习思考,而非人工教机器如何思考。


最近这段时间,context engineering(上下文工程)是 agent 开发者中的 buzzword。这个概念由 Andrej Karpathy 提出,引起了很多开发者的共鸣,直指当下 agent 开发的核心痛点:搭建流程看似简单,但在实际运行中,由海量工具调用和 long horizon reasoning 产生的冗长上下文,正成为 agent 性能和成本的巨大瓶颈,甚至会导致模型能力的下降。
Context engineering 指的就是在正确时间为 agent 提供正确信息的方法论,这个概念覆盖并超越了 prompt engineering 和 RAG,成为了 agent 开发的核心胜负手。如果把 LLM 类比为计算机的 CPU,那么 context window 就是计算机的 RAM,它处理信息的信噪比直接决定了产品的效果,因为在构建 agent 的过程中,输入的 context 不仅来自人类指令,还来自 agent 运行中的工具调用和思维链,把内存空间压缩到最关键的信息上就至关重要。
为了深入探讨这一挑战,我们系统梳理了 LangChain 工程师 Lance Martin、Chroma 的联合创始人 Jeff Huber、Manus、Anthropic、Cognition 等一线团队的实践经验,将他们的解决方案归纳为五大策略:转移(Offload)、压缩(Reduce)、检索(Retrieve)、隔离(Isolate)和缓存(Cache)。本文将详解这些方法论,并结合 The Bitter Lesson 的启示,探讨在模型能力持续迭代的今天,我们应该如何构建真正面向未来的 AI agent。
01.
Context Engineering 是什么?
很多人认为 2025 年是 agent 元年,但在实践中,开发者普遍发现虽然 agent 的搭建流程看起来简单,但要让整个系统高效运行却非常困难,context 管理是其中的关键瓶颈。
今年 6 月,Karpathy 发布一条篇推文,正式提出了 context engineering:“filling an LLM’s context window with just the right information for the next step(在大语言模型的上下文窗口中放入正好适合它执行下一步所需的信息)”,这个概念迅速引起了众多开发者的共鸣。

Karpathy 发布的推文
Chroma 的联合创始人 Jeff Huber 认为, context engineering 本质上是 AI engineering 的一个子集,核心在于每次调用 LLM 时,都要明确哪些信息需要放入 context window,这其实包含了两个循环:
**•**内循环(inner loop):即时筛选,明确当前结果生成所需的 context;
• 外循环(outer loop):长期优化,通过迭代确保 context window 始终只包含相关信息。
Chroma 是一家 AI 初创公司,核心产品是开源向量数据库 ChromaDB,可以为 AI 应用提供高效的数据检索和存储解决方案。
为什么需要 context engineering?
Prompt engineering 是 context engineering 概念的子集和早期形式。
ChatGPT 这样的 Chatbot 主要依赖人类输入,因此优化 prompt 非常重要。但在构建 agent 的过程中,输入的 context 不仅来自人类指令,还来自 agent 运行中的工具调用和检索的多元信息,这时 context engineering 就变得格外重要。
随着工具调用的次数越来越多,agent 会动态生成大量新的需要管理的 context。Manus 团队在技术博客中指出一个典型任务通常需要约 50 次工具调用。Anthropic 的一个 multi-agent 研究也表明,生产级 agent 在运行时甚至可能需要多达数百次工具调用;Lance Martin 在开发开源 AI 研究助手 Open Deep Research 这个项目时发现,agent 每次工具调用都会消耗大量 token,如果不对此进行优化,单次运行可能就要消耗 50 万个 token,成本会达到 1-2 美元。
Manus 在官方发布的《AI 代理的 context 工程:构建 Manus 的经验教训》中表示:
Manus 中的一个典型任务平均需要大约 50 次工具调用。这是一个很长的循环——由于 Manus 依赖 LLM 进行决策,它很容易偏离主题或忘记早期目标,尤其是在长上下文或复杂任务中。
通过不断重写待办事项列表,Manus 将其目标复述到上下文的末尾。这将全局计划推入模型的近期注意力范围内,避免了"丢失在中间"的问题,并减少了目标不一致。实际上,它使用自然语言来使自己的注意力偏向任务目标——而不需要特殊的架构变更。
而且如果每次工具调用产生的 context 都直接传入模型,很快就会触及 LLM 的 context window 上限。Chroma 在 7 月发布的报告 Context Rot: How Increasing Input Tokens Impacts LLM Performance 显示,随着 context 长度增加,模型的注意力会分散,推理能力也会随之下降。Jeff Huber 把这种现象称为 context 衰减(context decay),他甚至认为当前大多数出色的 AI 初创公司或 AI native 应用的核心能力实际上就是 context engineering。

Source: Chroma, Context Rot: How Increasing Input Tokens Impacts LLM Performance

Claude Sonnet 4, GPT-4.1, Qwen3-32B, and Gemini 2.5 Flash on Repeated Words Task
总而言之,简单 agent(naive agent)在实际运行时往往陷入双重困境:
-
它必须要处理几十到上百次工具调用累积出来的大量 context;
-
它在面对过长 context 时不仅可能因超出 context window 而无法继续运行,还可能容易发生 context decay 让模型能力下降。
正是这些痛点,催生了“context engineering”这一新方向,目标就是在 agent 的构建过程中,通过精心设计和选择传递给模型的 context 来提升模型的效率和效果。围绕这一目标,学界和业界提出了多种方法,其中比较具有代表性的做法可以归纳为五类:Offload(转移)、Reduce(简化)、Retrieve(检索)、Isolate(隔离)和 Cache(缓存)。


context engineering 的五种方法
02.
方法一:Offload 转移
Lance Martin 在 Latent Space 的分享中提到 offload context 有以下用法:
使用文件系统来记录笔记;
使用文件系统(如 todo.md)来规划/跟踪进度;
使用文件系统读写 token 占用很大的 context;
使用文件来存储长期记忆。

Offload 方式
如前文所述,基础版 agent 在执行过程中会进行多次工具调用,每一次调用的结果都会直接传回给 LLM,这导致所有 context 也会被完整传入 LLM,context window 会迅速膨胀,token 消耗过高,效率也会下降。为了解决这个问题,Manus 认为 offload context 是非常重要且有用的。
Offload context 的核心思想在于 agent 不必在每次工具调用时都把完整的 context 原封不动地传回模型,而是可以将这些信息转移到其他形式。最常见的方式是把文件系统当作一种外部 memory。在这种模式下,agent 仅会给模型返回一个摘要或 URL 作为标识,模型只在需要时才会调用这些外部存储的内容,而不是一直持有全部原始 context,因此这种方式能够显著优化资源利用率,使得 agent 运行更高效、更具扩展性。


offload context 运行原理
有一个值得关注的问题是应该如何在 context 中保留足够的摘要或元数据,让模型能够理解被 offload 的内容到底包含什么。尤其是在 deep research 时,agent 往往需要 offload 整页的内容,因此必须要生成一个有效的摘要来描述文件中的信息,prompt engineering 在其中起到了非常重要的作用:用户可以通过反复打磨 prompt,让摘要在能够覆盖文档核心信息的同时,实现显著的内容压缩。
• 以 Open Deep Research 为例,Lance Martin 表示在实践中,Open Deep Research 生成摘要的方式是通过精心设计的 prompt 来引导模型产出一份详尽的要点,将文档的核心信息逐条列出。这样不仅能在信息压缩的过程中尽量保持内容的准确还原,还能让 LLM 在必要时判断是否要调取完整的 context。
**•**Cognition 在 Don’t Build Multi-Agents 这篇博客中强调,摘要生成是一个值得投入大量精力的环节,不能被简单对待。他们甚至提出可以用微调模型(fine-tuned model)专门来做摘要工作。虽然 Cognition 当时的语境主要是讨论 agent 边界和历史消息摘要,但 Lance Martin 认为这个逻辑同样适用于由工具调用产生的大量 context,核心目标始终是让模型清楚 context 里有什么。

Source: Cognition, Don’t Build Multi-Agents
03.
方法二:Reduce 压缩
Lance Martin 在 Latent Space 的分享中提到,reduce context 有以下几种用法和注意事项:
总结 agent 的消息历史;
剪裁消息历史中不相关的部分;
对工具调用的输出进行总结或剪裁;
在 agent 之间交接时进行总结或剪裁;
但要小心信息丢失!

Reduce 用法和注意事项
Context reduce 指的是通过摘要(summarization)、剪裁(pruning)等方法来减少 context 所包含的内容。一个典型场景是当 Claude Code 里 95% 的 context window 都被占满时,系统会自动触发 reduce 机制。

context reduce 运行原理
但 context reduce 也存在风险。Manus 认为如果 reduce 是不可逆的,将可能会导致严重的信息丢失,这也是 Manus 选择使用 context offload 的原因:先将工具调用的完整结果 offload 到磁盘保存,确保原始数据不丢失,然后再进行 reduce,即使 reduce 后的信息是有损的,仍然可以随时回溯原始 context。Cognition 也强调摘要生成必须非常谨慎,如前文所述,他们甚至认为可以用微调模型(fine-tuned model)专门来做摘要来确保关键信息不会遗漏。
Manus 在官方发布的《AI 代理的 context 工程:构建 Manus 的经验教训》中表示:
许多代理系统实现了上下文截断或压缩策略。但过度激进的压缩不可避免地导致信息丢失。这个问题是根本性的:代理本质上必须根据所有先前状态预测下一个动作——而你无法可靠地预测哪个观察结果可能在十步之后变得至关重要。从逻辑角度看,任何不可逆的压缩都带有风险。
这就是为什么我们在 Manus 中将文件系统视为终极上下文:大小不受限制,天然持久化,并且代理可以直接操作。模型学会按需写入和读取文件——不仅将文件系统用作存储,还用作结构化的外部记忆。
我们的压缩策略始终设计为可恢复的。例如,只要保留 URL,网页内容就可以从上下文中移除;如果沙盒中仍然保留文档路径,则可以省略文档内容。这使得 Manus 能够缩短上下文长度,而不会永久丢失信息。
在开发这个功能时,我发现自己在想象**状态空间模型(State Space Model, SSM)**在智能体环境中有效工作需要什么条件。与 Transformer 不同,SSM 缺乏完整的注意力机制,并且在处理长距离的后向依赖关系时表现不佳。但如果它们能够掌握基于文件的记忆——将长期状态外部化而不是保存在上下文中——那么它们的速度和效率可能会开启一类新型智能体。基于 SSM 的智能体可能是神经图灵机真正的继任者。

Manus 官方发布的《AI 代理的 context 工程:构建 Manus 的经验教训》
考虑到不同任务场景对 context reduce 的要求可能并不相同,有一个值得讨论的问题是 context reduce 是否应该保留 agent 之前的错误路径(wrong paths)。
有观点认为如果错误路径被保留下来,agent 可能会不断重复相同的错误操作,因此必须去掉错误信息,明确告诉 agent 不要再沿着错误方向继续下去,而是需要去尝试新的方法。
**•**Drew Breunig 在文章 How to Fix Your Context 中表示模型产生的幻觉如果被写入 context,就会持续污染 agent 的后续决策;
**•**Gemini 在技术报告中也记录了相关案例,比如 Gemini 在玩宝可梦游戏时出现了幻觉,这会导致 Gemini 在后续的步骤中不断偏离正确方向。

Source: Drew Breunig, How Long Contexts Fail
但从工程角度看,判断应该什么时候在消息历史中移除错误记录往往是非常复杂的,这会加大 agent 框架(agent scaffolding/harness)的逻辑负担和维护成本。因此有人认为,与其增加这种复杂性,不如直接保留错误信息。
此外,还有观点认为保留错误信息可以让 agent 在下次行动时根据错误调整自己的行为,比如在 coding 场景中,agent 需要持续构建和修改代码,保留较完整的历史信息通常能提升模型表现,即便是在代码修改任务里,模型如果能理解早期的决策依据,整体效果会更好:
• Manus 认为保留错误能让 agent 从失败中学习;
• Claude Code 会打印错误日志,并在后续过程中利用这些日志进行调整。
04.
方法三:Retrieve 检索 & Memory 记忆
Lance Martin 在 Latent Space 的分享中提到,retrieve context 有以下几种用法:
结合多种检索方法并进行重排序;
构建系统,将检索结果组装进提示词中;
基于工具描述检索相关工具。

Retrieve 用法
Retrieve context 指的是从外部资源(比如知识库、历史对话、文档、工具输出等)检索与当前任务相关的信息,然后把这些检索到的内容加入到模型的 context 中,来辅助模型生成更准确、可靠的输出。Retrieval 的出现时间虽然早于 context engineering,但已经成为 context engineering 的重要组成部分。
其中,RAG 就是一种传统检索方法,用经典的向量检索或语义检索。比如 Windsurf 从引擎设计的角度切入,先根据精心设计的语义边界,把代码拆分成独立的代码块,并为这些代码块生成向量嵌入(embedding),然后利用语义相似性向量搜索来完成检索。但 Windsurf 并不只依赖这一手段,还会结合传统的 grep 搜索,甚至构建知识图谱,最后将所有检索结果统一排序和整合,形成了一个典型的复杂、多步骤 RAG 流程。
grep 搜索全称为 global regular expression print,是一种基于字符串匹配的文本搜索方法,能逐行扫描文件内容,查找与给定正则表达式或关键字匹配的结果。
还有一种方法是通过调用简单的工具(例如 grep)在文件中进行探索式搜索(poke around files),完全绕过了传统机制,方式非常简洁,效果却很好,有些团队甚至公开表示他们只做抓取(scrap),不做索引(indexing),比如在 Anthropic 负责 Claude code 的 Boris Cherny 就表示 Claude Code 完全没有做任何索引,只依靠生成式检索。
为了系统比较不同方法的效果,Lance Martin 在今年 4 月设计了一次基准测试,核心问题是如何在多语言文档中实现有效检索。测试内容包括 20 个与 LangGraph 相关的编码任务,不同的 coding agent 需要依靠文档检索来生成 LangGraph 代码。对比对象为 Claude Code 和 Cursor,采用的检索方法分为三类:
-
经典向量检索:将有约 300 万 token 的文档导入向量数据库,再通过标准向量搜索完成检索;
-
文件工具检索:基于文本文件和简单文件加载工具的检索,更接近生成式搜索,做法是提供一个包含所有文档 URL 和简要描述的 Markdown 文件,让 agent 可以借助工具调取所需文档;
-
context 填充(context stuffing):直接将全部约 300 万 token 的文档一次性输入到 coding agent 的 context 中。
结果表明,在特定测试场景下,第二种方法效果最佳。在第二种方法下,agent 会先根据 Markdown 文件的描述判断需要调用哪些文档,再逐步调取并阅读,最终生成正确代码。这个结果也印证了 Anthropic 的 Boris 的观点:为 LLM 提供基础文件工具的访问能力,并通过文本描述让它能够理解文件内容,往往就能取得良好效果。同时,这种做法还避免了复杂索引所带来的高成本和高维护负担。
Lance Martin 后来长期采用这一方法,他认为仅依靠文本和简单搜索工具,并结合 Claude Code,就能满足大部分检索需求。Latent Space 主持人 Shawn Wang 认为简单的方法往往已经能够解决 80% 的问题,而复杂的索引和多步骤检索可能只在少数追求极高精度的场景下才是真正必要的。
特别的是,在代码仓库的文档管理与检索中,“文本”形式展现出了独特优势,它不仅简洁,而且可读性极高:
**•**Cognition 的 DeepWiki 用的就是类似“文本”的思路,它可以将任意公开 GitHub 仓库自动转换成类似 wiki 的文档形式,并附带架构图、源代码链接、摘要等,以便让开发者快速理解仓库结构与内容;
**•**Shawn Wang 开发了一个浏览器插件,能在任意代码仓库中直接打开 Wiki;
**•**Lance Martin 开发了一个小项目,可以将代码仓库整理成易读的文本格式,并借助 LLM 生成高质量描述,具体流程是这个工具会先自动遍历仓库内的所有文档页面,再将每个页面传递给 GPT 或其他 LLM,然后生成详尽摘要,最后将这些摘要汇总成一份文本文件。Claude Code 得到这个文本文件后,就能准确判断该调用哪个文档页面,例如依据问题快速定位到对应 URL。
记忆检索是特定 Context 下的检索
Agent 的记忆可分为四类:情景记忆(episodic memory)、语义记忆(semantic memory)、程序记忆(procedural memory)和背景记忆(background memory)。对于长期运行的 agent 来说,区分这些记忆类型尤为关键。但在传统的 context engineering 讨论中,这种细分的记忆分类还没有得到充分重视。

Source: LangChain, Context Engineering
在记忆与 context engineering的关系上,Lance 认为可以从写入记忆(writing memories)和读取记忆(reading memories)这两个维度来理解,同时还要考虑自动化程度(degree of automation)。在实际应用中,agent 依据自动化程度,可以分成两种模式:
-
类似 Claude Code 的极简模式:Claude Code 的设计非常直观,在读取记忆时,它会在启动时自动加载用户的 GitHub 仓库,而在写入记忆时,则需要用户手动指定,将内容保存到 GitHub 的某个文件。
-
全自动记忆:在这种模式下,agent 会在后台自动决定何时写入或读取记忆。但这种方式存在明显风险,尤其是记忆检索的不可控性。比如曾有用户希望生成某个场景的图片,模型却自动检索到用户的地理位置,并把这个位置信息意外融入生成内容中,而这并非用户的真实意图。从实际发展来看,OpenAI 在 ChatGPT 的记忆功能上投入了大量精力,但效果依然有限,这也表明了全自动记忆仍是一个极具挑战性的方向。
Lance 认为写入记忆的难点在于如何判断何时写入,而读取记忆在大规模场景下则可以直接理解为 retrieval。换句话说,大规模的记忆读取本质上就是在做检索操作。因此,记忆的读取部分应当被视为检索的一种特定应用场景。只是这种检索的特殊性在于,它并不是检索外部知识库或公开网页,而是检索过去的对话内容。例如,当系统需要回顾用户的历史对话时,本质上就是一种带有 context 约束的检索。
进一步来说,复杂的记忆系统往往就是复杂的 RAG 系统。虽然外界并不清楚 OpenAI 记忆工具的具体实现细节,但很可能是通过对用户过往对话做索引,并结合向量搜索或类似方法来实现检索功能。这与 Windsurf 提出的多步骤 RAG 流程在逻辑上类似。相比之下,Claude Code 的做法则非常简单,它在每次启动时自动加载用户的代码仓库,虽然方式朴素,但在实际使用中效果出奇地好。这些案例表明,记忆的读取与检索在很多情况下可以视为同一类问题,只是场景和语境有所不同。
05.
方法四:Isolate 隔离
Lance Martin 在 Latent Space 的分享中提到,isolate context 有以下几种用法和注意事项:
将 context 拆分给多个 agent;
但要谨慎!
Multi-agent 可能会做出相互冲突的决策;
如果能让 sub-agent 避免参与决策,则能降低风险。

Isolate 用法和注意事项
Isolate context 指的是将 context 拆分开来,从而避免不同类型信息相互干扰,这与 multi-agent 架构密切相关。在 Isolate context 的背景下,不同角色的 agent 能够各自压缩并管理不同的内容,从而避免单一 agent 承担全部 context 的负担,这种分工被认为是更高效的。

isolate context 运行原理
但 Cognition 认为在 multi-agent 架构下,sub-agent 要获得足够的 context 是极其困难的。为此,Cognition 投入了大量精力在 context 的摘要与压缩上。
特别的是,在 coding 场景中,如何在 sub-agent 之间分配和传递 context 是一个非常棘手的问题。在 coding 任务中,sub-agent 之间往往存在状态依赖(state dependency),这意味着不同 sub-agent 的决策可能会相互影响甚至产生冲突。例如,一个 sub-agent 负责写测试,另一个负责修改逻辑,如果它们各自独立决策,最后在整合时可能会出现不一致的问题。因此,Cognition 认为不要依赖 sub-agent 来处理此类任务。
此外,Cognition 的 Walden Yan 还提到过“反向书写任务(reverse write tasks)”,比如 coding 这类任务需要不同 sub-agent 分别负责最终系统的不同组件,这会导致 agent 之间必须频繁沟通,而当前 agent 间的通信机制仍处于早期阶段,这使得 coding 类场景的问题更加突出和复杂。
这也反映了 Cognition 与 Anthropic 的核心分歧:Cognition 认为不要使用 multi-agent,而 Anthropic 则认为 multi-agent 非常有用。Lance Martin 认为这取决于 multi-agent 要解决的具体问题:应用场景和使用方式会极大影响 multi-agent 的运行效果,应该将 multi-agent 用于易并行、只读(read-only) 的场景。
比如在 deep research 场中,agent 的工作主要是读取信息,也就是收集 context,当所有并行的读取任务完成后,最后才会统一进行书写,比如撰写最终的研究报告。Anthropic 的报告中提到,他们的 deep research agent 就是采用了这种架构:sub-agent 并行收集信息,最后统一产出结果。
相比之下,coding agent 的情况更加复杂,虽然现在 Anthropic 的 Claude Code 已经支持 sub-agent 模式,表明 Anthropic 认为这种架构在 coding 任务中至少是值得尝试的,但 Lance Martin 还是认为,如果 sub-agent 的任务需要高度协同,coding 场景就会非常棘手。

Cognition 与 Anthropic 的观点分歧
06.
方法五:Cache 缓存
Lance Martin 在 Latent Space 的分享中提到,cache context 有以下几种用法:
缓存输入的 tokens,在 Claude-sonnet 上成本可降低 10 倍!
将 agent 的指令、工具描述缓存到前缀中。
将可变 context / 最近的观测结果添加到后缀中。

Cache 用法
开发者在初次搭建 agent 时常遇到高昂的循环成本问题,因为 agent 每一次循环都需要重复传递之前的工具调用结果,从而要消耗大量 token。为了降低延迟和成本,将消息历史进行缓存被视为一种有效策略。2025 年 7 月,Manus 提出了缓存(caching)概念,利用键值(KV)缓存机制来提高 AI agent 在处理多步骤任务时的效率和成本效益。
Manus 在官方发布的《AI 代理的 context 工程:构建 Manus 的经验教训》中表示:
如果我必须选择一个指标,我认为 KV-cache 命中率是生产阶段 AI 代理最重要的单一指标。它直接影响延迟和成本。为了理解原因,让我们看看典型代理是如何运作的:
在接收用户输入后,代理通过一系列工具使用链来完成任务。在每次迭代中,模型根据当前上下文从预定义的动作空间中选择一个动作。然后在环境中执行该动作(例如,Manus 的虚拟机沙盒)以产生观察结果。动作和观察结果被附加到上下文中,形成下一次迭代的输入。这个循环持续进行,直到任务完成。
正如你所想象的,随着每一步的推进,上下文不断增长,而输出——通常是结构化的函数调用——保持相对简短。这使得代理(agents)相比聊天机器人的预填充和解码比例高度倾斜。例如在 Manus 中,平均输入与输出的 token 比例约为 100:1。
幸运的是,具有相同前缀的上下文可以利用 KV 缓存,这大大减少了首个 token 的生成时间(TTFT)和推理成本——无论你是使用自托管模型还是调用推理 API。我们说的不是小幅度的节省:例如使用 Claude Sonnet 时,缓存的输入 token 成本为 0.30 美元/百万 token,而未缓存的成本为 3 美元/百万 token——相差 10 倍。
但不同的 API 在实际应用中存在差异,比如 OpenAI 会自动缓存,从而避免重复传输;而早期的 Anthropic 需要用户自己显式设置缓存请求头(caching header)。
需要注意的是,缓存只能优化延迟和成本问题,但无法解决 long context 的根本问题,也就是说即使缓存生效,当 context 达到十万 token 时,模型仍然需要完整处理这么长的 context,无论是否有缓存,模型的性能衰减(context decay)问题依然会存在。
更进一步,缓存策略往往与服务商绑定。如果用户非常依赖厂商提供的缓存机制,那用户可能面临“厂商锁定”,难以自由切换服务,但如果是运行自有开源模型,那能完全掌控缓存策略,实现更高灵活性。
07.
the Bitter Lesson 的启发
OpenAI 的 Hyung Won Chung 在 the Bitter Lesson in AI Research 的演讲中指出,在相同成本下,计算能力每五年大约增长十倍,这种 scaling 的趋势是推动 AI 进步的关键因素。历史经验表明,那些归纳偏置较少、更通用、更依赖大量数据和计算的算法,往往比依赖手工特征设计或内置归纳偏置的算法表现更好。简单来说,the Bitter Lesson 指出了让机器通过大量数据和计算自主学习如何思考,比人工教机器如何思考更有效。
Hyung Won Chung 曾是 OpenAI 的 Research Scientist,主要研究推理(reasoning)与 agents,他是 o1-preview、o1、Deep Research 等项目的核心贡献者,并领导过 Codex mini 的模型训练。
“归纳偏置”(Inductive bias)指的是系统在面对有限数据时,为了能够进行合理的泛化而内在带有的一套假设或偏好。换句话说,它是一种先验约束,让模型在无限可能的解释中,更倾向于选择某些解释,从而提高学习效率。

Source:the Bitter Lesson in AI Research
Hyung Won Chung 还提出,在任何研究阶段,为了在当时的计算条件下获得理想性能,通常需要为算法添加一些结构(structure),例如更多的建模假设或归纳偏置。这在计算资源有限时确实是有帮助的,但随着计算能力增加,这些人为添加的结构反而会成为进一步发展的瓶颈。

Source:the Bitter Lesson in AI Research
只要框架透明,就有实用价值
Lance 表示,当人们讨论架构框架(frameworks)时,往往包含两类不同的东西:agent 抽象(agent abstractions)和底层编排框架(low-level orchestration frameworks)。很多开发者反对的其实是前者,而不是后者。


Source: LangChain, How to think about agent frameworks
以 Shopify 的 Roast 框架为例,这是一个开源的 AI 工作流编排(workflow orchestration)工具,提供了可组合的底层构建块,没有预设状态判断(no judges state),允许用户自由搭建 agent 和工作流。Lance 并不反对这种架构,他认为这种方式可以充分利用底层构建块的灵活性,他在搭建 Open Deep Research 时也是先搭工作流,再拆解重构成 agent。相比之下,agent 抽象(agent abstractions)则容易隐藏逻辑,使系统在模型能力提升时难以拆解和重构。
Lance 认为开发者需要警惕 agent 抽象(agent abstractions),但这并不意味着要排斥底层编排框架,只要框架提供的是透明、可自由组合的节点,而非黑箱,就具有实用价值。
企业客户在内部尝试搭建 agent 和工作流时,往往一开始都选择自行搭建,但随着代码难以管理、协作和评审问题逐渐出现,标准化框架和可组合组件就显得尤为必要。比如,在 2024 年年中,随着 Anthropic 模型的工具调用能力提升,许多企业纷纷开始集成,但由此带来了很多混乱。于是 MCP 出现,为工具访问制定标准协议,降低协同成本与认知负担。这表明,大型组织推动标准化框架的根本动因是为了解决实际的协作问题,而不是为了框架本身。
实践经验
Lance Martin 在过去一年搭建 Open Deep Research 的过程中,最初采用的是高度结构化的流程,几乎不依赖工具调用,因为当时业界普遍认为工具调用并不可靠,所以他在系统中预先嵌入了大量假设,将研究问题拆解为多个部分并行处理,最后再整合成完整报告。这个流程在当时确实更稳定,但随着模型能力的快速提升,这种繁复的结构反而限制了模型对 MCP 和工具调用能力的使用。
因此 Lance 转向使用 agent 架构,去掉过多结构,允许 agent 自主决定研究路径,实现工具调用。这验证了 Hyung Won Chung 的观点:researcher 需要不断重新评估“基于当前模型能力,我的假设是否还成立”。Lance 甚至用 GPT-5 进行了测试,结果表明,随着模型能力不断提升,Open Deep Research 这个开源系统也能够同步跟进并适应这些进展。
此外,Anthropic 的 Boris 在设计 Claude Code 的时候也遵循了 the Bitter Lesson:让 Claude Code 的系统保持尽可能地简单、通用,为用户提供广泛的模型访问权限。
值得注意的是,传统企业采用 AI 的常见做法是将 AI 嵌入已有工作流,因为这些企业已经拥有成熟的流程和结构,AI 的作用主要是优化和增强这些流程。但 AI-native 产品则往往不会受限于现有流程,而是在模型能力达到足够水平后,从零开始构建产品:
**•**相比 VSCode,Cursor 和 Windsurf 更适合 AI coding,因为它们无需改造旧流程;
**•**Cognition 也是从一开始就以 agent 为核心进行原生设计,而不是把 agent 当作现有工具的补充。
过去两年半,企业常常在纠结应该是将 AI 嵌入现有流程还是重构流程,产生这种纠结的原因在于早期模型能力不足,重构效果不好,因此结构化方法往往表现更好,因此容易让人误以为这些结构是长久有效的解决方案。但现在模型能力已超过临界点,最佳策略是用更少结构化来搭建系统。
Anthropic 创始人 Jared Kaplan 表示构建“目前尚不完美的产品”或许是合理策略,因为随着模型指数级进步,产品价值会被逐步释放。这也正是 the Bitter Lesson 在企业应用中的具体体现:早期依赖结构获得短期优势,但长期来看,灵活、少结构、通用的方法才能在模型能力增长的浪潮中取得最终胜利。
**•**Cursor 早期并不完美,但随着 Claude 3.5 发布,正好匹配了模型能力追上产品需求的节点。
• Windsurf 的产品曲线表现出一个平台期(ceiling),随后快速爆发(boom),增长最终放缓。

Source: Lance Martin 在Latent Space 演示的 PPT
零基础如何高效学习大模型?
你是否懂 AI,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和鲁为民博士系统梳理大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!
【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
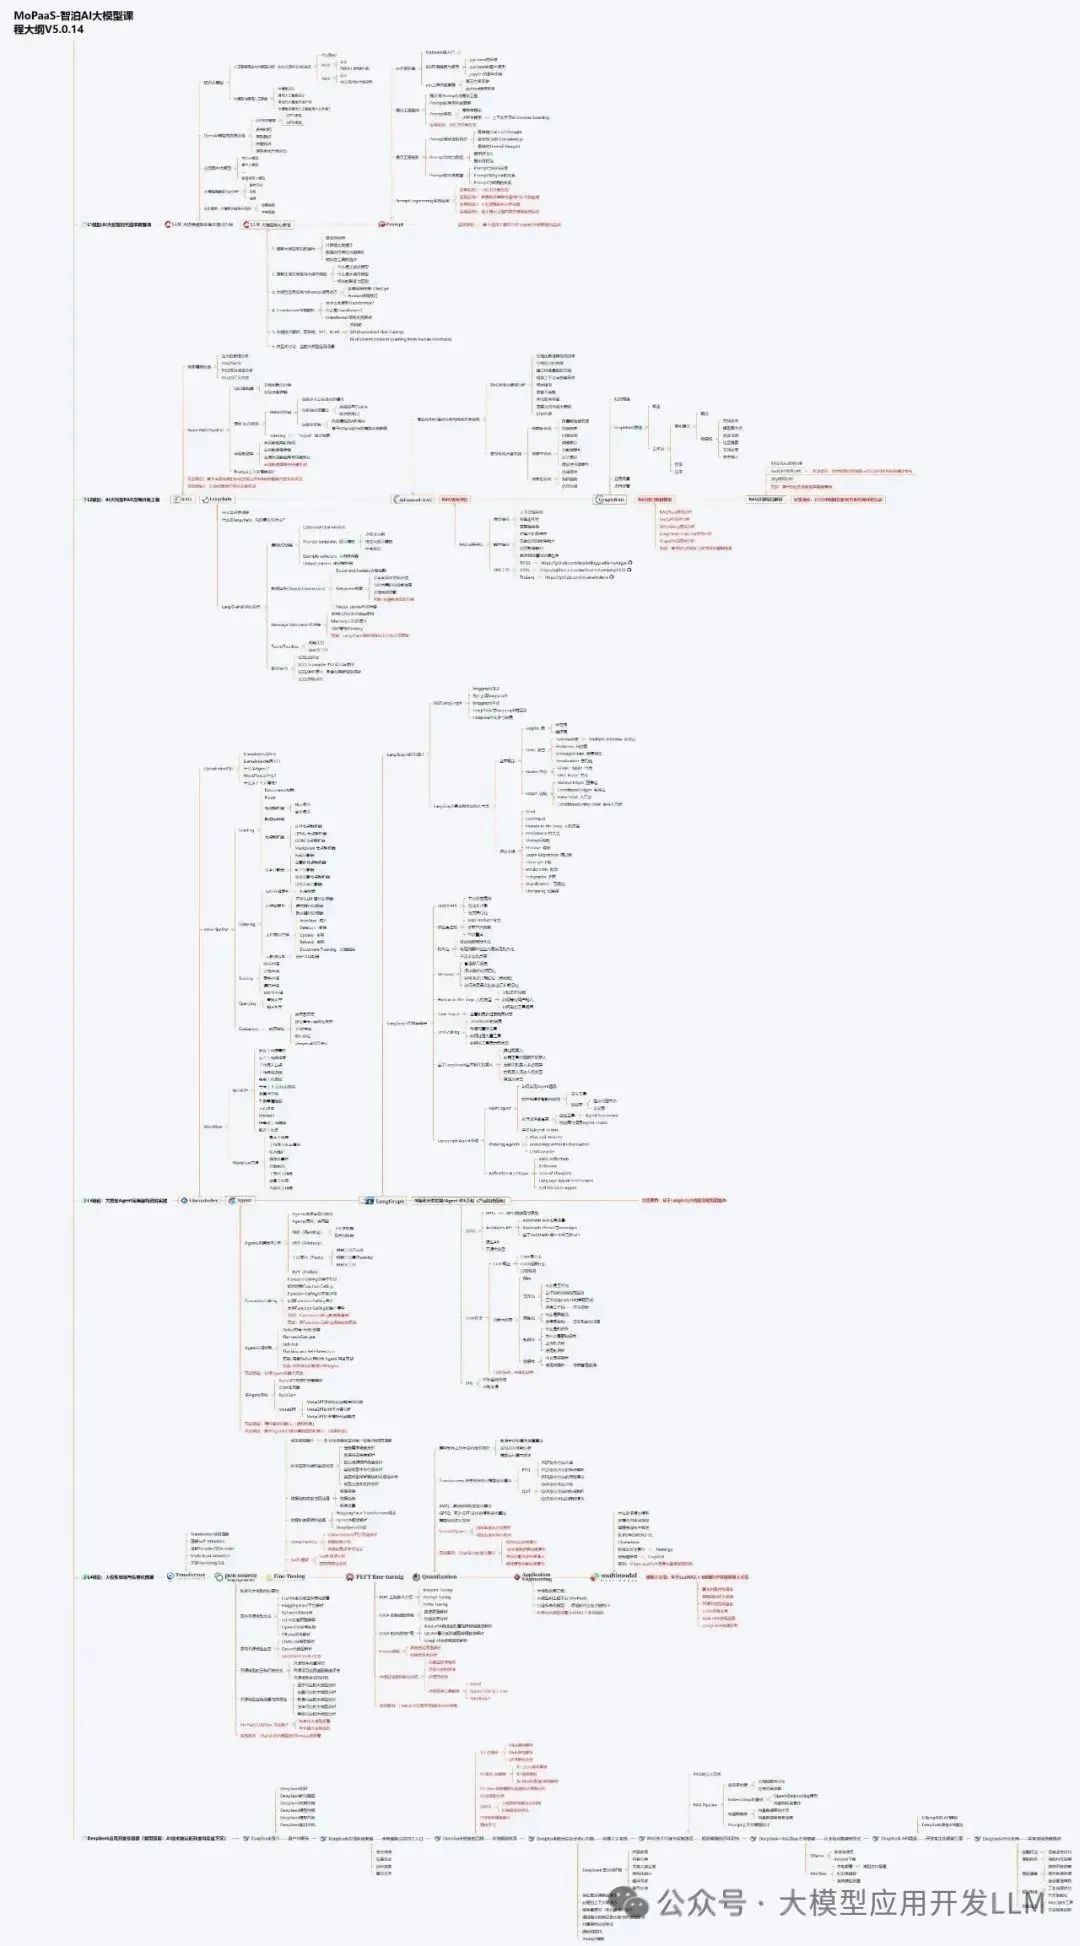
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
本资料由我与鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
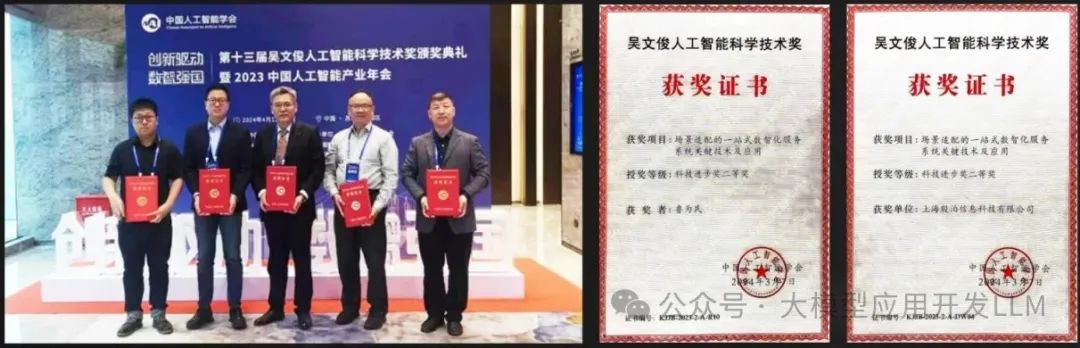
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!
 314


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


