仅一行代码,使LLaMA3在知识编辑任务上表现暴涨35%!您确定不来试试嘛?

上海交通大学《动手学大模型》编程实战课;提示工程大赛冠军经验分享;AI Agent最新行业地图(3份);人类与ChatGPT恋爱行为指南;提升AI产品留存率的7个技巧 | ShowMeAI日报 日报关键词:OpenAI下周一更新;🉑与ChatGPT谈恋爱指南;🉑AI Agent行业地图;2024年职业趋势发展报告;🉑提升AI产品留存率的技巧;🉑提示词经验分享;上海交大《动手学大模型》课程……点击阅读原文 阅读详情

引言

LLMs常因错误/过时知识产生幻觉,而基于新知识微调耗时且易过拟合、引入额外的知识库或参数模块又会带来不断增加的存储空间压力。因此,基于“Locate-then-Edit”的知识编辑(如ROME)被提出,用“少时间成本、零空间成本”来精准更新特定知识。在此基础上,中科大LDS Lab提出AlphaEdit,仅需在主流编辑方法中加入一行代码,便可暴涨LLaMA3在序列知识编辑任务上的表现,如下图。
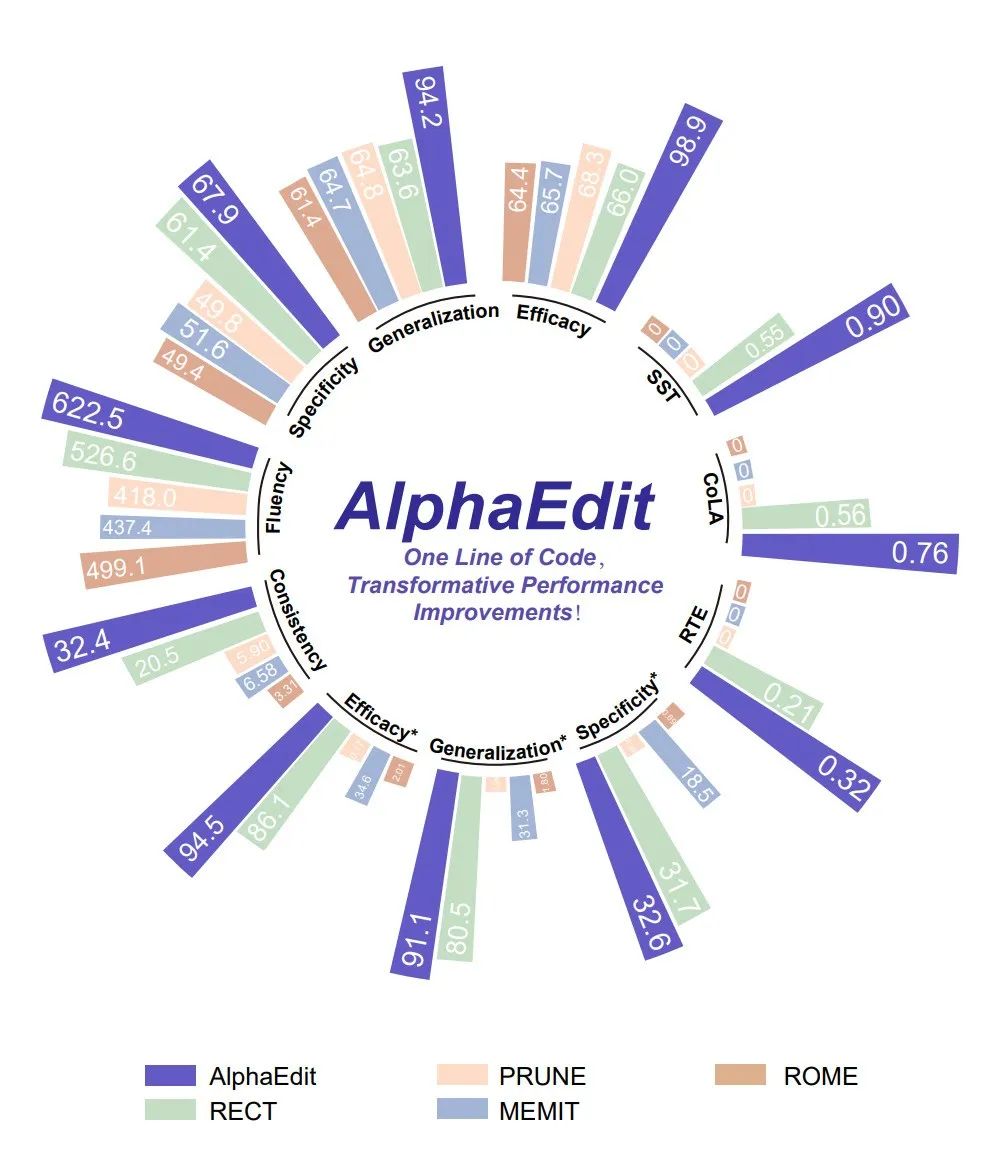
图1:各类模型编辑方法在 LLaMA3(8B)上的表现。星号上标用于区别Counterfact数据集和 ZsRE 数据集。SST、RTE 和 CoLA 评估了编辑后模型的通用能力。

相关论文:

AlphaEdit: Null-Space Constrained Knowledge Editing for Language Models

论文链接:https://arxiv.org/abs/2410.02355

代码链接:https://github.com/jianghoucheng/AlphaEdit

Neuron-Level Sequential Editing for Large Language Models

论文链接:https://arxiv.org/pdf/2410.04045

代码链接:https://github.com/jianghoucheng/NSE

目录:1. 背景介绍 2. AlphaEdit 3. NSE

1.背景介绍

图2:当前方法与AlphaEdit的对比

2. AlphaEdit

图3:AlphaEdit是如何通过一行代码实现效果激增的。
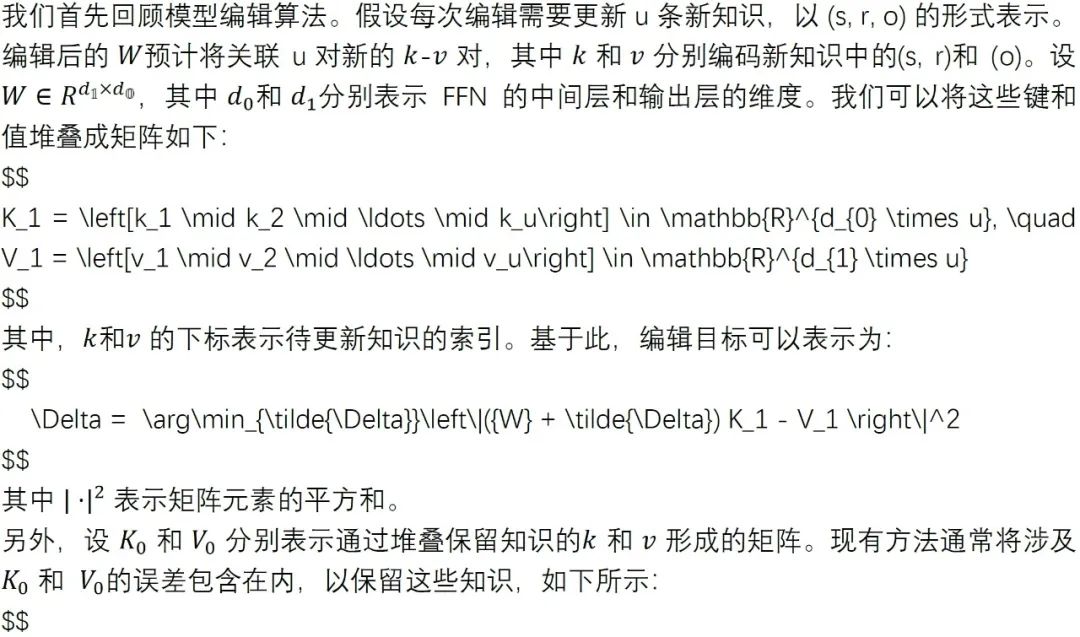
表1:各方法在编辑效果上的对比。

图4:各方法在模型通用能力上的对比。

3.NSE

此外,该团队提出的NSE从另一个角度:权重更新方式的角度尝试对序列编辑的效果进行优化。具体而言, NSE通过排序关键层中的神经元激活,选择性地收集“有影响力的神经元”来更新权重,而不是像以往的方法那样更新所有关键层的权重。这种选择性修改最大限度地保护了模型功能不被削弱。另外,对于包含大量神经元的大规模LLM,NSE引入了多层迭代编辑,以简化神经元选择过程,使其能够在单次编辑中有效地完成大规模知识更新。NSE从权重更新方式的角度,通过每次更新部分神经元来缓解持续知识编辑过程中的参数更新冲突和累计变化异常问题,其包括三个步骤:

步骤1:基于权重回溯的值向量计算

步骤2:神经元级别权重更新

步骤3:迭代多层编辑

非常推荐对序列编辑感兴趣的读者去阅读NSE的原文:https://arxiv.org/pdf/2410.04045。再次感谢大家的关注!

图 5:NSE流程图。(a)权重回溯, (b)神经元粒度权重更新,© 迭代编辑。

[1] Model editing harms general abilities of large language models: Regularization to the rescue.

[2] Perturbation-restrained sequential model editing.

[3] Training networks in null space of feature covariance for continual learning. CVPR 2021

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

上海交大2026版《动手学大模型》:零基础掌握LLM、Agent与RAG实战 大语言模型(LLM)作为人工智能领域的核心技术,基于Transformer架构实现了突破性的自然语言理解能力。其核心原理通过自注意力机制捕捉长距离依赖关系,在预训练-微调范式下展现出强大的泛化性能。这一技术价值在于降低了AI应用门槛,使开发者能够快速构建智能对话、内容生成等应用。在实际工程实践中,智能体(Agent)技术让模型具备了工具调用和任务规划能力,而RAG(检索增强生成)系统则通过结合外部知识库显著提升了回答的准确性和时效性。上海交大2026版教程正是围绕LLM基础、Agent开发和RAG系统构建这 阅读详情

相关推荐

qwen3-0.6B:面向边缘AI与工业场景的轻量级大模型实战指南

轻量级大模型是当前AI工程落地的关键路径,其核心在于平衡参数规模、推理延迟、功耗成本与任务确定性。相比通用大模型,小模型需在词表压缩、架构重设计、领域数据精炼和推理栈协同等维度深度优化,才能实现毫秒级响应、低功耗部署与高精度垂直任务完成率。qwen3-0.6B作为典型代表,聚焦中文工业语义理解、边缘AI部署与低成本推理三大刚性需求,在PLC故障归因、教育代码解释、离线多轮对话等真实场景中验证了‘单位瓦特确定性任务完成率’的技术价值,为硬件受限、成本敏感、强实时性要求的AI应用提供了可复用的轻量级大模型应用范

chuanao8829的博客 465

我怎么使用AI大语言模型学英语

今天已经是我开始英语拉练任务的第39天了,一直在笃定的、雷打不动的、机械笨拙的重复做一件事,那就是使用AI工具,将我想要说的话翻译成英文,生成语音文件,每天朗读三小时,最终整个背下来。我也在思考,我应该要怎么用好用足现在AI带给我的便利,进而通过我自己的实践摸索,可以总结出了学习英语的有效使用路径,让工具来把我的句子进行拆解和分析,我是这么做的,在这里记录下来,供你参考。首先,我找到一个合适的AI工具,用什么不重要,重要的是你要去用,用着用着你还要学会怎么用,我以kimi举例。

python122_的博客 1920

Qwen3-Coder-Next:80B MoE编程模型的3B激活实战解析

大型语言模型在代码生成场景中正面临算力与能力的结构性矛盾——当参数规模突破40B,稠密Transformer架构遭遇显存爆炸、通信瓶颈与边际效益锐减。稀疏专家混合(MoE)由此成为关键破局点,其核心在于动态路由与计算卸载,而非简单参数切分。Qwen3-Coder-Next以80B总参数+3B激活的硬指标,验证了MoE在真实开发环境中的工程可行性:它依托Hybrid Attention优化结构感知,通过Token-Level Gating实现细粒度专家调度,并深度适配GPU硬件并行单元。该技术不仅降低本地部署

weixin_30628077的博客 441

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3934

Qwen 3.6 Plus生产实测:上下文、多语言与工具调用的真实边界

大语言模型的上下文窗口、多语言支持和工具调用能力,是企业AI落地的核心技术支点。200K上下文并非性能万能解,其实际价值取决于语义切片与动态加载策略;多语言能力呈现显著分层——英语与中文表现稳健,而东南亚小语种需依赖prompt强制校验与轻量词典补丁;工具调用本质是格式驱动而非语义理解,必须叠加参数标准化中间件与静态代码检查。这些能力共同决定模型在客服工单处理、跨境售后翻译、合同风险识别等真实业务场景中的可用性与可控性。本文基于72小时生产环境压测,揭示Qwen 3.6 Plus在上下文管理、多语言理解和工

weixin_34195142的博客 363

AI资讯简报设计方法论:信息降噪与实操导向的工程化实践

AI资讯简报是一种面向非技术从业者的轻量级认知基础设施,其核心在于通过结构化信息降噪、场景化动作设计和可验证内容交付,将海量AI动态转化为可执行决策依据。它不替代深度技术文档,而是填补‘知道’与‘用好’之间的关键鸿沟——原理上依赖三层过滤机制(信源响应时效、实操复现率、术语解释密度),技术价值体现在降低跨职能团队的认知摩擦与试错成本;典型应用场景包括产品需求评估、运营工具选型、教学案例准备及自由职业者提示词维护。本文以#60期为样本,系统解析其模块设计、验证逻辑与工作流整合方法。

anwenzhao0749的博客 382

基于STC8G1K08A与XL4015的60W LED调光控制器硬件设计与PCB布局实战

LED调光控制器是融合模拟调光、PWM调光与混合调光策略的典型嵌入式硬件系统。其原理在于通过MCU采样输入信号并计算调光曲线,再驱动恒流电路实现精准亮度控制。技术价值体现在调光深度、色温稳定性与抗干扰能力的综合优化。在工业照明、智能家居及摄影补光等场景中,对0-10V接口、高频PWM及多路同步的需求日益普遍。本文围绕STC8G1K08A与XL4015的选型、恒流驱动参数计算及PCB分区布局,完整呈现了一款60W LED调光控制器的硬件设计过程,并给出调光闪烁排查与避坑经验。

weixin_33802505的博客 434

RAG原理与实战:用向量数据库和嵌入模型解决大模型幻觉

RAG(检索增强生成)是一种将外部知识动态注入大语言模型的关键技术,其核心在于解耦‘知识存储’与‘语言生成’——通过嵌入模型将文本语义向量化,在向量数据库中实现高精度语义检索,再将检索结果作为上下文增强提示词,从而显著抑制大模型幻觉、提升事实准确性。该技术不依赖模型重训,具备低门槛、高可控、强可解释等工程优势,广泛应用于智能客服、金融研报分析、法律条文检索、企业知识库等需精准引用私有文档的场景。关键词 RAG、向量数据库、嵌入模型、检索增强、大模型幻觉,共同构成当前AI落地最务实的技术基座。

weixin_30897079的博客 365

MCP Server:将代码补全从本地卸载到边缘服务的实践

Model-Centric Processing(MCP)是一种面向开发智能辅助的新型服务架构,其核心原理是将原本由IDE插件在本地执行的模型推理、上下文检索与语义补全等高负载任务,通过低延迟RPC协议迁移至轻量边缘服务器。相比传统本地大模型+插件方案,MCP显著降低CPU占用、消除I/O阻塞与内存碎片,释放开发者认知带宽;技术价值在于以确定性通信替代无状态HTTP调用,实现毫秒级首帧响应与上下文感知补全;典型应用场景包括中高级工程师提效、资源受限设备(如MacBook Pro)持续开发、以及企业内网零公网

weixin_30732487的博客 443

如何使用 GPT4All 和 Langchain 来处理您的文档

很高兴分享我关于利用 GPT4All 和 Langchain 的力量来增强基于文档的对话的最新文章!在这篇文章中,我将引导您完成设置环境的步骤,并演示如何使用高级语言模型与您自己的文档无缝聊天。准备好释放新的可能性并简化您的文档交互。让我们深入了解一下吧!

iCloudEnd的博客 952

LLM大模型-vLLM本地部署全流程:Windows WSL2环境安装、HuggingFace与Modelscope模型加载与本地运行、Docker化部署与镜像分发

vLLM本地部署大模型方案 vLLM是一款高性能大模型推理引擎,通过PagedAttention技术显著提升吞吐量和内存效率,支持低成本、高并发的本地部署。 核心优势: 性能卓越:吞吐量远超同类方案,支持连续批处理等高级功能 成本优化:减少GPU服务器需求 兼容性强:提供类OpenAI的简洁API 部署步骤: 硬件准备:需NVIDIA GPU(如A100/3090),显存≥模型参数量×2(7B模型需14GB) 软件环境: Linux系统或Windows WSL2 安装CUDA 12.1+和Python 3.

2202_75674969的博客 4567

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2317

Unipush2.0 App消息推送(在线+离线推送)

使用unipush2.0进行消息推送,包含在线跟离线

weixin_50251467的博客 3699

RAG语义鸿沟破解:HyDE+动态切分+AB测试实战指南

RAG系统在真实业务中频繁‘答非所问’,核心症结在于短查询、指代模糊、口语化等导致的语义鸿沟——检索器无法从稀疏输入中准确理解用户真实意图。其本质是传统向量检索依赖字面匹配,缺乏上下文感知与意图补全能力。HyDE(假设文档嵌入)通过大模型生成富含实体锚点的假文档,显著提升语义对齐精度;结合按文档类型动态切分、元数据增强与轻量级线上AB测试,可系统性提升召回相关性与业务转化率。本文聚焦金融、法律等企业知识场景,提供可落地的工程化方案,解决‘审计委员会’‘报销流程’等高频超短查询的鲁棒检索问题。

weixin_33725270的博客 493

Cadence Allegro通过手工绘制板框的方法

Cadence Allegro通过手工绘制板框的方法 Cadence Allegro绘制板框有三个方法: 1、通过手工绘制板框; 2、通过向导绘制板框; 3、通过导入DXF文件导绘制板框; 本章将教会大家如何通过手工的方法绘制100mm的矩形板框。 方法步骤如下: 一、通过放置绘图工具2D线绘制; 1、运行Cadence Allegro软件,打开File菜单栏,选择New。 2、这时软件会弹出Ne...

LGCPCB的博客 2万+

家长必看!用RouterOS轻松屏蔽不良网站,保护孩子上网安全

本文为家长提供了一份详细的RouterOS路由器配置指南,旨在通过技术手段保护儿童上网安全。文章核心介绍了如何利用RouterOS的DNS静态条目功能,轻松实现禁止访问特定不良网站,并结合防火墙时间规则,为孩子构建一个纯净、可控的家庭网络环境,操作简单,无需专业背景。

weixin_28363123的博客 1266

一文带你了解HuggingFace Transformer 理论基础,Transformer 实战,十万字精读

在 Hugging Face 的库中,Pipeline(流水线)是最高层、最易用的推理 API。如果把直接调用 PyTorch 底层代码比作“驾驶手动挡赛车”(需要精细控制离合、油门和换挡),那么 Pipeline 就是一辆开箱即用的“全自动无人驾驶汽车”。你只需要输入目的地(文本),它就能直接把你送到终点(预测结果)。你不需要知道到底该用 BERT 还是 T5。你只需要告诉 Pipeline 你的任务目标文本生成、翻译、问答、图像分类),它就会自动为你匹配一套默认的最佳预训练模型和分词器。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 553

2024最新实战:用1Panel面板+Docker快速部署Frps服务端(含Nginx配置模板)

本文详细介绍了2024年企业级内网穿透方案,通过1Panel面板和Docker技术快速部署Frps服务端,包含Nginx反向代理配置模板。从服务器选型、系统准备到安全加固,提供全栈实战指南,帮助企业和开发者高效实现内网穿透需求。

weixin_27966471的博客 419

写作者的AI协作为何不是替代而是增效?六个断点与人类不可替代的10分

大语言模型(LLM)正深度融入内容生产流程,但其本质并非写作主体,而是认知协作者。理解AI写作的关键,在于厘清‘生成’与‘校准’的边界:AI擅长信息整合、结构优化与多平台适配,而人类独有的痛苦翻译力、语境嗅探力、在场性感知和意义校准力,构成内容价值的核心锚点。本文聚焦写作全流程中的六大典型断点——选题枯竭、初稿臃肿、术语失重、平台失焦、风险盲区与价值悬空,结合医疗科普、法律文书、口述史整理等真实场景,揭示如何将AI转化为可验证、可回溯、可干预的思维杠杆。尤其强调‘90分稿子之后的10分’,实为人类对真实语境

weixin_30947043的博客 353

【SWAT】SWAT中预定义河网及流域

平原圩区没有明显的海拔差异。DEM中包含的地形信息无法定义河段的位置和水文连接,SWAT模型Watershed Delineator中提供两种方法,帮助用户输入流域拓扑信息。第一种方法,“Burn-in”和手动绘制河段和子流域边界。首先,使用“Burn-in”功能导入数字河道网络(DCN),并根据DEM和DCN绘制河流和子流域。然后在ArcGIS中编辑“流域”和“河段”层,可以调整位置、范围和水文连接。第二种方法,可以手动绘制或重新编辑河流和子流域,预定义河网及流域。

```On Earth, Be Water, By Coding``` 3273

Coze智能体开发:扣子智能体设置多Agent模式

在扣子中创建智能体后,智能体默认使用单 Agent 模式。在单 Agent 模式下处理复杂任务时,你必须编写非常详细和冗长的提示词,而且你可能需要添加各种插件和工作流等,这增加了调试智能体的复杂性。调试时任何一处细节改动,都有可能影响到智能体的整体功能,实际处理用户任务时,处理结果可能与预期效果有较大出入。

王国平的博客 3712
上一篇: Prompt提示词设计:如何让你的AI对话更智能?
下一篇: AI时代新机遇:为什么你应该学习大型模型应用开发?
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


