TrafficFormer 针对流量数据的高效预训练模型

工程复现——TrafficLLM 通过本地访问Network URL,长时间无响应后请求失败。2、启动streamlit服务时,设置端口为127.0.0.1,端口为6006。租用Autodl服务器进行模型测试、模型微调环境配置等工作。运行测试代码,使用evaluation.py模块。1、打开自定义服务,根据对应操作系统进行配置。3、打开链接成功请求到streamlit服务。是测试集数据标签存储位置;4.累计训练时间70h左右。是训练的模型存储的位置。2.调整sh文件中的内容。1.安装训练需要的环境。是基座模型存储位置;是测试用数据集位置; 阅读详情
AI摘要

本文介绍了清华大学团队的预训练模型TrafficFormer,该模型针对网络流量数据特点设计,在预训练阶段提出细粒度任务增强表示能力,微调阶段提出数据增强方法。实验表明,它在流量分类和协议理解任务上优于最新工作,还分享了AI大模型学习资料。

今天为大家介绍一篇清华大学徐恪教授和李琦老师团队针对流量数据的预训练模型工作《TrafficFormer: An Efficient Pre-trained Model for Traffic Data》,第一作者是周广猛博士。该工作已经被国际网络安全四大顶级会议之一的 IEEE Symposium on Security and Privacy 2025 录用。

网络流量数据具有较强的领域知识,这使得流量数据的标记非常困难,而缺乏带标注流量数据制约了智能流量分析的准确性。作为解决带标注数据稀缺问题的一种方式,预训练模型技术已经在视觉和语言领域证明了其有效性。但是在网络领域,预训练模型的探索才刚刚开始。本文提出了针对网络流量的预训练模型TrafficFormer以提升流量检测和协议理解的准确率。具体地,在预训练阶段提出了更细粒度的预训练任务增强对流量数据的表示能力,在微调阶段提出利用字段随机初始化特性实现流量数据增强的方法。此外,除了评估流量预训练模型对网络主体的行为识别外,本文还提出了多个协议理解任务来评估预训练模型对协议交互逻辑的理解。TrafficFormer在六个流量分类任务上取得了最优的表现,并且在协议理解任务上显著优于最新的预训练流量模型。

01

研究背景

流量数据是网络协议交互产生的数据,其一方面包含了相应协议的交互逻辑信息,另一方面也蕴含了交互主体的行为信息,比如使用不同的APP、浏览不同的网页表现出的流量行为是不同的。对于流量的分析和识别对于网络安全以及网络管理是非常重要的。流量分析识别工作早期主要依赖于专家知识,通过特征工程构建专家特征,然后输入机器学习模型进行学习。这些方法取得了比较好的效果,但无论是机器学习方法还是深度学习方法,大量的带标注数据是模型取得优越效果的关键。不同于传统的文本、图片、声音数据,流量数据标注的门槛和难度更高。标注流量数据需要标注人员具备网络协议知识,同时对具体场景(比如某种网络攻击的原理)比较熟悉。此外,流量产生的速度非常快,数据量非常庞大,而且行为模式随时间也在不断变化,依赖人工标注是不现实的。预训练模型技术是一种解决带标注数据稀缺问题的方式,其包括预训练和微调两个阶段。预训练阶段基于无标注数据采用自监督的方式学习一般知识,微调阶段基于带标注数据采用监督学习方式学习特定任务知识。相比于文本、图片数据,流量数据的体量更加庞大,而且行为模式复杂,因此将预训练模型技术应用到流量分析识别任务中是非常适合的。

02

研究动机
img

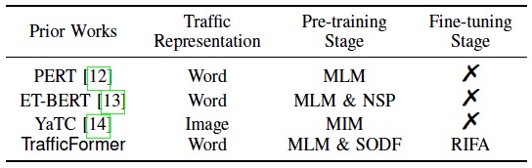
之前的研究工作多关注流量数据表示上,将流量数据转化为视觉领域或自然语言领域的输入形式,进而直接应用相关领域预训练技术。PERT通过bigram方式将16进制数据包内容转化为字;ET-BERT将连续相同方向的数据包看作一个句子,从而沿用自然语言领域预训练技术;YaTC将每条流处理为一张图片,从而沿用视觉领域预训练技术。这些工作忽视了对流量数据的特点分析及针对性设计。

流量数据的三个特点为:

  1. 流量数据是一种序列数据。 流量中的数据包具有显著的先后关系。

  2. 数据包的方向和顺序是流量数据的重要语义。 流量是通信双方执行网络协议产生的,输入单元具有方向性。而且数据包的顺序需要满足协议交互逻辑,不符合顺序的数据包会被认为是无效的。

  3. 流量数据的数据包头部是结构化的,而且具有很强的信息冗余。

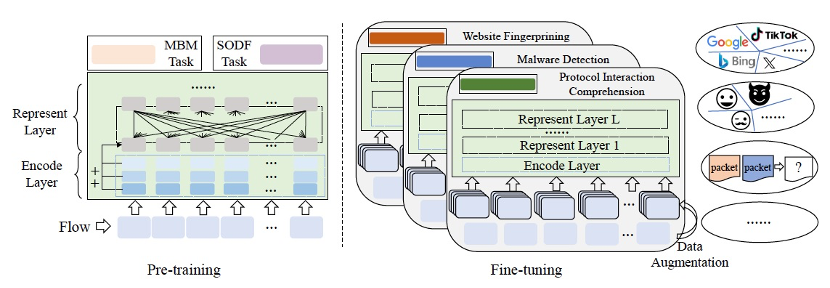
针对上述难点,TrafficFormer在预训练阶段保留了自然语言领域中的遮蔽建模预训练任务MLM学习输入单元的序列关系,设计了同源-同向-同流多分类预训练任务SODF挖掘输入单元的方向和顺序信息;在微调阶段设计了保持流量语义的流量数据增强方法RIFA使模型减少对不相关信息的依赖,快速定位到有价值信息。

03

论文工作:TrafficFormer
img

TrafficFormer整体框架如图所示,总体上包含预训练和微调两个阶段。预训练阶段的任务为遮蔽burst建模和同源-同向-同流多分类任务,训练完的模型主体可以迁移到下游的各个任务,比如恶意软件识别、网站指纹识别以及新提出的协议交互理解任务等。

3.1 预训练阶段

遮蔽burst建模任务和传统的遮蔽语言建模类似,都是遮蔽输入中的某些token,让模型进行预测,根据实际token和预测token计算损失。
img

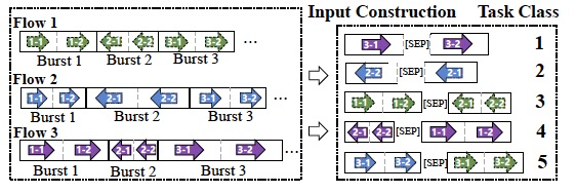
ET-BERT中第二个预训练任务为同源burst预测任务,该任务本身比较简单,模型可以通过简单的一些字段,比如五元组就可以判断两个burst是否同源。此外该任务不能学习到数据包的方向和顺序信息。考虑到SBP任务存在的这些问题,我们提出了同源-同向-同流多分类任务。首先将流划分为多个burst,再将每个burst切分为两段,最后组合切分的burst构建不同的类别。上图展示了三条流的前三个burst的示意图,这些burst共组合形成5种类别。

  1. 类别1:一个正常的burst,切分后的两段burst中间添加[SEP]符号进行分隔。第一段burst中的段标识为1,第二段burst中的段标识为2。
  2. 类别2:同类别1类似,不同之处是将一个burst切分后的两段交换位置。
  3. 类别3:连续的两个burst,第一个burst之后添加[SEP]符号进行分隔。第一个burst中每个词的段标识为1,第二个burst中每个词段标识为2。
  4. 类别4:同类别3类似,不同之处是交换两个burst的位置。
  5. 类别5:随意组合两条流中的burst,burst之间添加[SEP]符号进行分隔。

类别1和类别2的目的是让模型学习到同一方向上数据包的顺序(同源),类别3和类别4的目的是让模型学习到数据包的方向信息(同向),类别5的目的是让模型学习到流的概念(同流)。

3.2 微调阶段

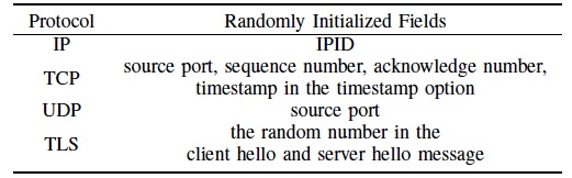
考虑到下游微调任务的数据量较少的问题,我们提出一种流量数据增强方法。网络协议中一些字段本身是随机初始化的,字段值本身没有任何含义,因此也对分类不造成任何影响。下表列举了常见协议中的随机初始化字段。
img

数据增强的具体方法是随机变化数据包中随机初始化的字段。同时考虑到字段的变化规律相比于字段值往往是更重要的,我们改变字段初始值后在后续数据包中保持其变化规律。数据增强后,模型可以不依赖于这些字段的值,更关注于值的变化或者其他字段,从而从大量的数据中快速提取有价值的信息,有助于模型快速发现分类边界。相比于基于深度学习的方法,TrafficFormer的方法直接修改原始数据,增强后的数据不改变原有语义。

04

实验结果

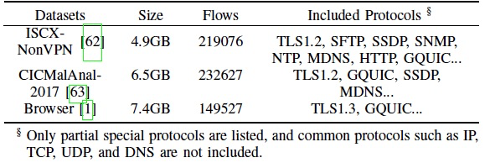
我们选择了三个不同来源的数据集进行预训练,包括ISCX-NonVPN(2016年)、CICMalAnal2017(2017年)、Browser数据集(2020年),总数据量在20GB左右。
img

4.1 流量分类任务

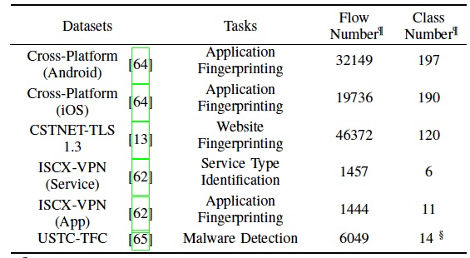
我们选择了六个数据集作为微调数据集,包括Cross-Platform(Android)、Cross-Platform(iOS)、ISCX-VPN(Service)、ISCX-VPN(App)、CSTNET-TLS 1.3、USTC-TFC,其中包括了应用指纹识别、服务类型识别、网站指纹识别、恶意软件识别四种具体微调任务。
img

TrafficFormer选择每条流的前5个数据包,每个数据包选取以太网数据层往后的64字节作为模型的输入。在RIFA的应用上,我们对IP标识号、TCP序列号、确认号随机变换。此外我们也通过随机变换的方式处理IP、端口号、TCP协议中的时间戳、TLS协议中的时间戳和SNI字段,避免产生分类的捷径。
img

img

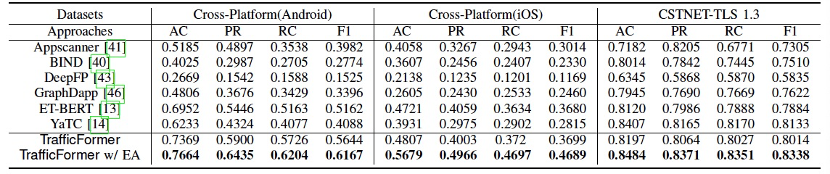
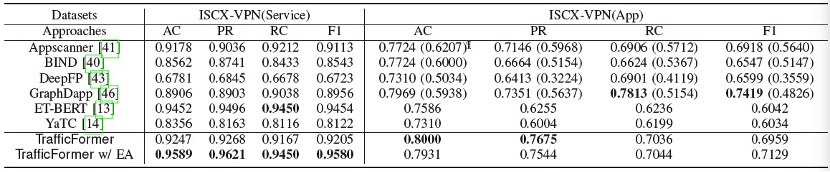
从上表中可以看到,TrafficFormer在多个流量分类任务上都取得了最优的效果,这证明TrafficFormer能够更好地识别流量背后网络主体的不同行为。我们提出的RIFA数据增强方式在大多数的任务中都进一步提高了效果,F1值最多提升了10%。

4.2 协议理解任务

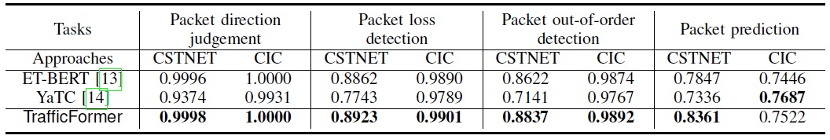
流量本身不仅体现了网络主体的行为信息,更基础的是蕴含了协议的交互信息。我们提出四种评估协议交互理解能力的任务,包括数据包方向判断、丢包检测、乱序检测、数据包预测。这些任务有助于更全面评估一个流量预训练模型的能力。
img

从上表结果可以看到,TrafficFormer在四个任务上都取得了综合最优的效果,这证明TrafficFormer能够更好地理解协议交互逻辑。

05

总结展望

TrafficFormer基于流量数据特点设计了预训练模型,并在流量分类和协议理解任务上优于最新的工作。未来,随着对流量数据特点的深入认识,可以从模型结构上设计更适合流量数据的结构,进一步提升对流量的建模能力。同时扩大模型规模,在更多更丰富的流量数据集上进行学习,实现模型能力的scale 提升。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

清华大学-TrafficFormer 清华大学 | TrafficFormer: 针对流量数据的有效预训练模型。 阅读详情

相关推荐

【技术解析】TrafficLLM:如何通过参数高效微调与领域分词,让大语言模型“读懂”网络流量?

本文深入解析了TrafficLLM框架如何通过参数高效微调与领域分词两大核心技术,解决大语言模型理解网络流量的难题。通过定制流量分词器与双阶段调优策略,TrafficLLM显著提升了模型在恶意软件检测、流量分类等任务上的准确率与泛化能力,并实现了低成本、插件化的模型更新,为LLM赋能网络安全分析提供了高效实践路径。

weixin_29041195的博客 212

TrafficLLM入门到精通(非常详细),通用流量表示增强LLM,一篇搞定!

当前机器学习(ML)方法因其对多样化流量模式具有强大的表征学习能力而被提出。尽管ML有着巨大的潜力,但仍存在一些局限性导致现有的ML模型的泛化能力较低。 (i)跨任务泛化能力不足,在流量分析的各个细分领域中,现有方法通常通过人工设计特征和监督标签来构建复杂的机器学习模型。

m0_59235945的博客 1866

告别特征工程:用TrafficLLM和LoRA微调,让大模型直接“读懂”网络流量包

本文介绍了TrafficLLM与LoRA微调技术如何革新网络流量分析,使大语言模型直接解析原始pcap数据,告别传统特征工程。通过专用流量分词器和双阶段调优管道,TrafficLLM显著提升检测效率与准确率,结合LoRA技术实现低成本、高效的模型微调,适用于实时威胁检测、攻击溯源等多种网络安全场景。

weixin_33712987的博客 594

【翻译】TrafficFormer:面向网络流量数据的高效预训练模型

本文提出高效预训练模型TrafficFormer,针对流量数据标注难问题,通过细粒度多分类任务(SODF)增强表征能力,并在微调阶段引入随机初始化域增强(RIFA)方法,提升模型对关键信息的聚焦能力。实验表明,TrafficFormer在六项流量分类任务中F1分数最高提升10%,且在协议理解任务中显著优于现有模型,有效提升了流量分析的精度与泛化能力。

阿文(alvin)的专栏 11

LARGE LANGUAGE MODELS AS TRAFFIC SIGNAL CONTROL AGENTS: CAPACITY AND OPPORTUNITY

交通信号控制对于通过调节红绿灯相位来优化道路网络的效率至关重要。现有的研究主要集中在基于启发式或强化学习(RL)的方法上,这些方法往往缺乏在不同交通场景中的可转移性,并且具有较差的可解释性。本文介绍了一种利用大型语言模型(LLM)执行交通信号控制任务的新方法LLMLight。通过利用LLM令人印象深刻的泛化和零样本推理能力,LLMLight执行了一个人性化的决策过程,以实现高效的交通管理。具体来说,该框架首先将任务描述、当前交通状况和先验知识组合到提示中。

c_cpp_csharp的专栏 754

CIC-IDS-2017加拿大入侵检测数据集(.CSV)第一部分

加拿大入侵检测数据集第一部分,因为数据太大,所以就分两部分上传,这是第一部分。

TrafficFormer模型在昇腾平台上迁移适配实践

网络流量分析是网络安全与运维的关键技术,但传统方法依赖大量人工标注数据,泛化能力差。自监督预训练模型的出现为解决标注数据稀缺问题提供了新思路。本文基于昇腾 AI 平台,介绍 TrafficFormer 的模型架构、环境部署与预训练实践。

weixin_43885443的博客 258

从零到飞:在Ubuntu 22.04上为你的无人机搭建PX4-Autopilot开发环境

本文详细指导在Ubuntu 22.04上搭建PX4-Autopilot开发环境,涵盖系统依赖安装、源码获取、编译目标选择及Gazebo仿真测试。通过优化构建过程和调试技巧,帮助开发者快速为无人机部署稳定的飞控系统,实现从仿真到实机的平滑过渡。

weixin_26878995的博客 489

Paper Reading《TrafficFormer: An Efficient Pre-trained Model for Traffic Data》

论文链接: http://www.thucsnet.com/wp-content/papers/guangmeng_sp2025.pdf IEEE SP 2025该部分主要阐述了研究背景、现有方法的不足、预训练技术的应用潜力以及TrafficFormer模型的提出。研究背景与意义:网络流量数据蕴含网络实体的交互逻辑和行为信息,对其进行分析和分类在网络安全和管理方面至关重要,如识别恶意软件、区分服务类型等。现有方法的问题 - 传统机器学习方法:依赖专家知识选择特征,如FlowPrint、CUMUL和Appsc

yuansiming0920的博客 1159

RseQC实战指南:从安装到RNA-Seq数据质控全流程解析

本文提供了一份详尽的RseQC实战指南,涵盖从安装配置到RNA-Seq数据质控的全流程。文章重点解析了RseQC作为专业质控工具的核心价值,手把手指导如何通过Conda或pip完成安装,并深入讲解了bam_stat.py、geneBody_coverage.py等关键模块的使用方法与结果解读技巧,帮助用户有效评估RNA完整性、文库构建质量及链特异性,确保下游分析的可靠性。

weixin_29200741的博客 201

STM32G0实战:手把手教你用国产GD25Q16 Flash存储传感器数据(附完整驱动)

本文详细介绍了如何使用国产GD25Q16 Flash芯片与STM32G0系列MCU实现传感器数据存储的完整方案。从SPI接口配置、驱动层实现到存储系统架构设计,提供了实战代码和优化策略,帮助开发者快速构建高性价比的物联网数据存储系统。

weixin_30733003的博客 106

TrafficLLM:用通用流量表示增强网络流量分析的大型语言模型

摘要:基于机器学习的网络流量分析已被广泛用于威胁检测。不幸的是,它们在不同任务和未见数据之间的泛化非常有限。大型语言模型(llm)以其强大的泛化能力而闻名,在各个领域都显示出良好的性能。然而,由于网络流量的特征差异很大,它们在流量分析领域的应用受到限制。为了解决这个问题,本文提出了TrafficLLM,它引入了一个双阶段微调框架,从异构原始流量数据中学习通用流量表示。该框架利用流量域标记化、双阶段调优管道和可扩展自适应。

qq_61879501的博客 1258

多摄像头同步技术:帧同步信号在Sensor与解串器间的传递机制

本文深入探讨了多摄像头系统中帧同步信号的两种核心传递机制:由解串器统一发号施令或由主Sensor作为“带头大哥”。文章对比了两种方案在同步精度、硬件复杂度、成本及适用场景上的差异,并提供了实战配置要点与调试心法,为车载环视、ADAS及工业检测等应用提供关键的技术选型与实施指导。

weixin_29193359的博客 435

【文献阅读】TrafficLLM: Enhancing Large Language Models for Network Traffic Analysis with Generic Traffic

【原文翻译】基于机器学习(ML)的网络流量分析已被广泛用于威胁检测。然而,此类方法在不同任务和未见数据上的泛化能力非常有限。大语言模型(LLMs)以其强大的泛化能力著称,并在多个领域展现出优异的性能。但由于网络流量具有显著不同的特性,其在流量分析领域的应用受到限制。为解决这一问题,本文提出TrafficLLM,它引入了一个双阶段微调框架,旨在从异构的原始流量数据中学习通用的流量表示。该框架采用流量领域分词双阶段调优流程和可扩展适配。

qq_39991776的博客 1309

假期搞定!2026国社科申报AI全攻略指南:从选题到创新,7大核心要点手把手教你!

最后给大家推荐的400多所高校教师都在用的AI平台——高级学术版专业应用平台,集成了国际主流学术应用,以及ChatGPT、Claude、Gemini、Grok等Al大模型的高级版本平台,还有,可以辅助大家高效完成科研和学术写作任务,当然撰写硕博论文,课题、职称论文、国社科、国自然基金本子也是手拿把掐。你的任务是:用高度凝练的方式说明在(某一明确国家战略 / 政策方向,如:中国式现代化、共同富裕、基层治理现代化、数字中国、文化强国、国家安全等)背景下,我究竟要研究一个什么“具体而可操作的问题”。

智能AI让学术科研更容易 624

华为OD机试真题2025双机位A卷 Python&JavaScript 实现【采购订单】

在一个采购系统中,采购申请(PR)需要经过审批后才能生成采购订单(PO)。每个PR包含商品的单价(假设相同商品的单价一定是一样的)及数量信息。系统要求对商品进行分类处理:单价高于100元的商品需要单独处理,单价低于或等于100元的相同商品可以合并到同一采购订单PO中。针对单价低于100的小额订单,如果量大可以打折购买。

MISAYAONE的博客 1459

使用Transformer学习动态多层次的交通时空特征

文章信息本周阅读的论文是一篇2021年发表在《Transactions on Intelligent Transportation Systems》上利用Transformer进行交通流预测的文章,题目为《Learning Dynamic and Hierarchical Traffic Spatiotemporal Features With Transformer》。...

zuiyishihefang的博客 3727

视觉Transformer实战 | Token-to-Token Vision Transformer(T2T-ViT)详解与实现

Vision Transformer (ViT) 在计算机视觉领域取得了巨大成功,但标准的 ViT 存在一些局限性,如需要大规模预训练数据、对局部结构建模不足等。Token-to-Token ViT (T2T-ViT) 通过引入渐进式分词过程改进了原始 ViT,使其能够在中小型数据集上取得更好的性能。本节将详细介绍 T2T-ViT 的技术原理,并使用 PyTorch 从零开始实现 T2T-ViT。

盼小辉丶的博客 4万+

网络流量领域公开数据集及工具库

流量分类领域数据集 本博客持续更新,收集平常读论文时提高的公开数据集和工具库。 数据集详情 http://traces.cs.umass.edu/index.php/Network/Network 系列: 这个网站提供了该学院很多数据集,这些数据集是他们发表论文时提取的,然后公开出来。 WebIdent 2 Traces 数据集描述: A collection of traces of web reque...

jmhIcoding 6万+

VCAST创建单元测试工程

选择工作目录,后面创建胡UT工程将会生成到这个目录。

qq_42851449的博客 2483

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

构建LLM应用:构建LLM服务(第九部分)

点击上方“AI公园”,关注公众号,选择加“星标“或“置顶”作者:Vipra Singh编译:ronghuaiyang导读LLM Serving指的是部署和运行大型语言模型(LLMs)以处理用户请求的过程。它涉及到将通常离线训练的LLM设置为实时响应查询。LLM Serving指的是部署和运行大型语言模型(LLMs)以处理用户请求的过程。它涉及到将通常离线训练的LLM设置为实时响应查询。以下是LLM...

AI公园 1179

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

MalRAG:一种基于检索增强大语言模型的开集恶意流量识别框架

MalRAG:首个基于大型语言模型的开放集恶意流量识别框架 本文提出MalRAG,一个创新性的检索增强框架,用于解决开放集恶意流量识别问题。该框架通过以下核心创新实现突破: 多视角流量知识库:构建包含内容、结构和时间特征的流量数据库,为检索提供全面基础 自适应检索机制: 覆盖增强检索跨多维度搜索相关样本 流量感知剪枝过滤低质量证据 引导式提示工程:结合任务指令、证据引用和决策指导,优化LLM推理 实验表明,MalRAG在CTU-13等真实数据集上: 已知恶意流量识别F1达0.93-0.99 新型恶意流量发现

hao_wujing的专栏 285

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大模型日报|8 篇必读的大模型论文

大模型日报|8 篇必读的大模型论文

AMiner2006的博客 908

【论文阅读】《Large Language Models for Networking: Applications, Enabling Techniques, and Challenges》

文章探讨了大型语言模型(LLMs)在网络领域的应用,并提出了一些使能技术和面临的挑战。

bylander的博客 2229

1227论文速读1

MFR框架主要包括三个部分:数据预处理、半监督建模和集成预测。数据预处理:将原始网络流量转换为多通道的流量图像,并应用低通滤波提取多尺度低频特征。半监督建模:使用重构模型计算输入流量与重构流量之间的差异,以此作为异常评分。集成预测:通过加权融合来自不同频率分支的异常评分,生成最终的异常检测结果。MFR通过结合多频重构和半监督学习,成功地提高了网络流量异常检测的性能,尤其是在面对动态和不可预测的异常流量时。

qq_27789905的博客 1998
上一篇: 当一个律师决定在本地运行大模型
下一篇: 【AI新手指南】零代码搭建个人知识库,大模型助力秒搜秒答!
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值