还没搞懂嵌入(Embedding)、微调(Fine-tuning)和提示工程(Prompt Engineering)?

【自然语言处理】微调 Fine-Tuning 各种经典方法的概念汇总 (1)一些概念源自LLM(Chatgpt)和网络(百度/知乎等),笔者进行了初步检查。(2)由于其中的各种知识比较琐碎,为了形成较为结构化的知识体系,且使用最简单的、几乎无公式的介绍,故作此博客。(3)着重为自然语言处理领域NLP的,CV领域的不是很详细讲述了【机器学习与自然语言处理】预训练 Pre-Training 各种经典方法的概念汇总(4)比较简单或者过于的概念就不介绍了,默认大家都学会了。不然要写的太多了。比如损失,损失函数,神经网络几个概念,不认识的话单独先去学一下。 阅读详情

嵌入(Embedding)、微调(Fine-tuning)和提示工程(Prompt Engineering) 是AIGC 模型的核心功能,合理运行这些功能,能实现一些复杂和意向不到的应用。

前言

Prompt和Embedding是AIGC模型的核心功能,语言处理应用。例如,它们可以用于聊天机器人、语言翻译、摘要生成、文本分类等。Fine-tuning技术可以用于优化预训练模型,以提高其在特定任务中的性能,例如问答、文本摘要、语言理解等。

image.png

一、嵌入(Embedding)

嵌入是浮点数的向量(列表)。两个向量之间的距离衡量它们的相关性。小距离表示高相关性,大距离表示低相关性。
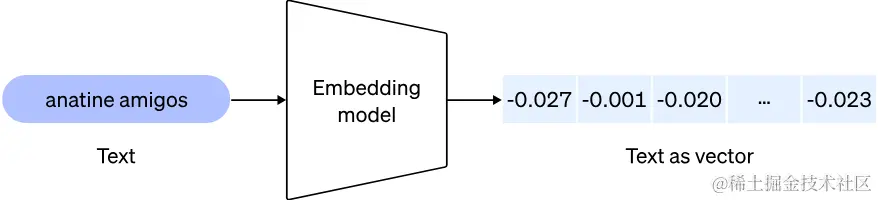
image.png

嵌入通常用于:

  1. Search 搜索(结果按与查询字符串的相关性排序)
  2. Clustering 聚类(文本字符串按相似性分组)
  3. Recommendations 推荐(推荐具有相关文本字符串的条目)
  4. Anomaly detection 异常检测(识别出相关性很小的异常值)
  5. Diversity measurement 多样性测量(分析相似性分布)
  6. Classification 分类(其中文本字符串按其最相似的标签分类)

二、微调 (Fine-tuning)

微调通过训练比提示(prompt)中更多的示例来改进小样本学习,让您在大量任务中取得更好的结果。对模型进行微调后,您将不再需要在提示(prompt)中提供示例。这样可以节省成本并实现更低延迟的请求。

image.png

image.png

三、提示工程(Prompt Engineering)

如果没有良好的提示设计和基础技术,模型很可能产生幻觉或编造答案,其危险在于,模型往往会产生非常有说服力和看似合理的答案,因此必须非常小心地设计安全缓解措施和地面模型的事实答案,所以提示工程应运而生。

提示工程(Prompt Engineering)是一门较新的学科,关注提示词开发和优化,帮助用户将大语言模型(Large Language Model, LLM)用于各场景和研究领域。 掌握了提示工程相关技能将有助于用户更好地了解大型语言模型的能力和局限性。

研究人员可利用提示工程来提升大语言模型处理复杂任务场景的能力,如问答和算术推理能力。开发人员可通过提示工程设计、研发强大的工程技术,实现和大语言模型或其他生态工具的高效接轨。

提示工程不仅仅是关于设计和研发提示词。它包含了与大语言模型交互和研发的各种技能和技术。提示工程在实现和大语言模型交互、对接,以及理解大语言模型能力方面都起着重要作用。用户可以通过提示工程来提高大语言模型的安全性,也可以赋能大语言模型,比如借助专业领域知识和外部工具来增强大语言模型能力。

3.1 大语言模型设置

image.png

Temperature:简单来说,temperature 的参数值越小,模型就会返回越确定的一个结果。如果调高该参数值,大语言模型可能会返回更随机的结果,也就是说这可能会带来更多样化或更具创造性的产出。我们目前也在增加其他可能 token 的权重。在实际应用方面,对于质量保障(QA)等任务,我们可以设置更低的 temperature 值,以促使模型基于事实返回更真实和简洁的结果。 对于诗歌生成或其他创造性任务,你可以适当调高 temperature 参数值。

Top_p:同样,使用 top_p(与 temperature 一起称为核采样的技术),可以用来控制模型返回结果的真实性。如果你需要准确和事实的答案,就把参数值调低。如果你想要更多样化的答案,就把参数值调高一些。

3.2 提示词的技巧

提示词的技巧包括但不限于:

  • 使用最新的模型以获得最佳效果
  • 将指令放在提示符的开头,并使用###或”""来分隔指令和上下文
  • 对于所需的上下文、结果、长度、格式、风格等,要尽可能具体、描述和详细
  • 通过示例清晰地表达所需的输出格式
  • 从零样本开始,然后是少样本,当它们都不起作用,再进行微调减少“蓬松”和不精确的描述
  • 不要只是说什么不要做,而是说什么要做
  • 特定的代码生成一一使用“引导词”将模型推向特定的模式

3.3 零样本提示(Zero Shot)

零样本提示即用户不提供任务结果相关的示范,直接提示语言模型给出任务相关的回答。

隐私过滤

企业内容个人信息过滤。

system_message

请根据用户的输入,审查个人信息,将涉及个人隐私信息的内容,用【隐私内容】替代,其他内容不做任何更改。


input

彭磊是新裤子乐队的主唱,常驻于北京八大胡同xx四合院,电话是【隐私内容】,其乐队成员有庞宽,赵梦,代表作有《生活因你而火热》、《没有理想的人不伤心》等。

output

image.png

数据结构化 大语言模型具备惊人的的零样本能力。 system_message

根据用户输入的创建AWS EC2的实例请求,生成JSON文件。
提取用户对话中提到的实例的区域,实例类型,磁盘大小。

input

创建一台us-east-1区域,实例类型为t2.micro的,磁盘大小为50G的AWS EC2 实例。

output

image.png

image.png 更多提示 system_message

根据用户输入的创建AWS EC2的实例请求,生成JSON文件。提取用户对话中提到的实例的区域,实例类型,磁盘大小。
如果用户输入不足以创建AWS EC2 实例,不要生成Json,进行追问,直到可以生成为止。

input

创建一台us-east-1区域,实例类型为t2.micro的AWS EC2 实例。

output

image.png

3.4 少样本提示(Few Shot)

当零样本不起作用时,建议在提示中提供演示或示例,这就引出了少样本提示。

用户举例。

创建一台us-east-1区域,实例类型为t2.micro的,磁盘大小为50G的AWS EC2 实例。

{
"region": "us-east-1",
"InstanceType": "t2.micro",
"diskSize": "50G"
}


image.png

output

image.png

3.5 链式思考提示(CoT)

**链式思考(CoT)**提示通过中间推理步骤实现了复杂的推理能力,可以将其与少样本提示相结合,以获得更好的结果,以便在回答之前进行推理的更复杂的任务。

image.png

image.png

最近提出来的有零样本CoT,它基本上涉及将“让我们逐步思考”添加到原始提示中。让我们尝试一个简单的问题,看看模型的表现如何:

image.png

这个简单的提示在这个任务中非常有效。这在您没有太多示例可用于提示时特别有用。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
分享Embedding 模型微调的实现 1. 当前比较主流的Embedding开源模型有哪些?答:1. m3e(Moka Massive Mixed Embedding) 2. BAAI/bge-large-zh-v1.5。更多的开源模型评测榜单可见:\2. 模型的作用?答:通过词,句子或者上下文的向量生成,从而来实现更高效的语义检索,语言理解的相关任务。\3. 模型是如何捕获语义信息的?答:在训练的过程中,模型学习用来反映语义相似性的方式将向量分配给单词或序列。简言之,通过分析数据中的词共现模式来实现。 阅读详情

相关推荐

关于Embedding模型微调

通过以上步骤,可显著提升Embedding模型在特定任务中的表现。实际操作中,建议结合业务需求灵活调整策略。1.什么是Embedding模型微调?2.模型选择与初始化。

charles666666的博客 1005

还没搞懂嵌入(Embedding)、微调(Fine-tuning)和提示工程(Prompt Engineering)?...

theme: orange 嵌入(Embedding)、微调(Fine-tuning)和提示工程(Prompt Engineering) 是AIGC 模型的核心功能,合理运行这些功能,能实现一些复杂和意向不到的应用。 前言 Prompt和Embedding是AIGC模型的核心功能,语言处理应用。例如,它们可以用于聊天机器人、语言翻译、摘要生成、文本分类等。Fine-tuning技...

DynmicResource的博客 3060

LLM落地四大策略:Prompt、Function Calling、RAG与Fine-Tuning决策指南

大语言模型(LLM)落地不是单纯的技术实现,而是面向业务目标的工程化决策过程。其核心在于理解不同技术路径的本质原理与适用边界:Prompt Engineering通过结构化输入引导模型激活已有知识;Function Calling将生成式输出降级为确定性API调度,保障结果可追溯;RAG解耦知识检索与生成,实现私有数据的实时注入;Fine-Tuning则通过参数微调重塑模型的领域认知分布。四者在成本、可控性、实时性与专业深度上构成三维权衡空间。本文聚焦真实生产环境中的策略选型逻辑、避坑实践与混搭协同机制,尤

weixin_30412167的博客 442

手工微调embedding模型RAG检索能力

本文是一篇关于如何微调embedding的文章,原作者是Wenqi Glantz。 主要内容: 微调big-large-en开源embedding模型; 具体实现代码细节; 评测最终的提升效果。

asd8705的专栏 3706

LLM生产落地三支柱:Prompt工程、RAG与微调的工程化权衡

大语言模型(LLM)在真实业务中面临知识滞后、响应不可控、领域适配弱三大核心挑战,其本质是模型能力与生产约束之间的根本矛盾。Prompt Engineering通过结构化信息编排实现快速行为锚定;RAG以向量检索+上下文注入保障知识新鲜度与可追溯性;Fine-tuning则在数据充分时深度对齐专业逻辑。三者并非并列技术选项,而是按成本、可控性与实施门槛严格分层的工程策略——90%问题靠Prompt解决,剩余10%中80%依赖RAG优化,仅2%需启动微调。本书基于金融、医疗、政务等高要求场景的400+实战笔记

weixin_34357887的博客 329

从Prompt到微调:AI大模型优化三阶段实战指南

大语言模型(LLM)作为当前人工智能的核心技术,其原理是通过海量数据预训练,学习语言的统计规律和世界知识。然而,通用模型在特定业务场景下常面临知识过时、输出不稳定或无法访问私有数据等挑战,这限制了其技术价值的充分发挥。为解决这些问题,业界形成了从快速适配到深度定制的渐进式优化路径。其中,检索增强生成(RAG)通过为模型引入外部知识库,有效解决了知识实时性和事实性幻觉问题,是连接大模型与私有数据的关键桥梁。而大模型微调则通过对模型参数进行针对性训练,实现对输出风格和领域能力的深度定制,是打造专业化AI应用的终

bk_lin的专栏 498

小白必看:一文搞清楚嵌入(Embedding)、微调(Fine-tuning)和提示工程(Prompt Engineering)

小白必看:一文搞清楚嵌入(Embedding)、微调(Fine-tuning)和提示工程(Prompt Engineering)

youmaob的博客 1306

大模型学习路线图:从Prompt工程到RAG与微调的实战指南

大模型作为当前人工智能领域的核心技术,其应用开发正从简单的对话交互向复杂系统集成演进。理解其工作原理,关键在于掌握Transformer架构、注意力机制等基础概念,这些技术通过海量数据预训练,赋予了模型强大的语言理解和生成能力。在工程实践中,RAG(检索增强生成)技术通过结合外部知识库,有效缓解了模型的幻觉问题,提升了回答的准确性和时效性。同时,针对特定场景的模型微调,尤其是采用LoRA等参数高效方法,能让通用模型快速适配专业领域需求。这些技术的核心价值在于将大模型的通用能力转化为解决实际业务问题的生产力,

dianzongfan5428的博客 530

LLM生产级落地:Prompt、RAG与微调的工程化铁律

大语言模型(LLM)在真实业务场景中失效,往往并非模型能力不足,而是工程链路断裂所致。理解Prompt工程的本质是设计人机协作协议,掌握RAG的关键在于语义感知的分块与混合检索,而Fine-tuning的价值则聚焦于低延迟、强结构化或隐性知识内化等不可替代场景。三者构成从快速响应(Prompt)→动态增强(RAG)→深度适配(Fine-tuning)的递进式加固体系。本书以制造业设备诊断、金融合规问答、医疗病历摘要等典型生产案例为锚点,直击非结构化数据清洗、向量库选型调参、LoRA四维调优、幻觉防控机制等2

weixin_30301449的博客 444

LLM开发实战:从RAG到微调的生产级工程方法论

大语言模型(LLM)已从概念验证迈入生产落地阶段,其核心挑战不再是‘能否回答’,而是‘如何可靠交付’。理解RAG(检索增强生成)与Fine-tuning(微调)的技术原理,是构建可审计、可回滚、可计费AI系统的基础;前者通过外部知识注入缓解幻觉,后者在领域适配中提升指令遵循与结构化输出能力。二者并非替代关系,而是分层防御体系:Prompting处理通用逻辑,RAG兜底专业知识,Fine-tuning固化关键行为。当前技术代际窗口期正快速收敛于工程稳定性标准——如上下文相关性阈值、chunk语义切分策略、QL

weixin_34396902的博客 399

大模型微调决策指南:什么场景必须微调,什么场景只需Prompt优化

大模型微调(LLM Fine-tuning)是面向垂直领域提升模型性能的关键技术,其本质是在通用基座上注入领域知识与任务约束。原理上依赖参数高效适配(如LoRA、QLoRA)实现低开销领域适配,技术价值在于解决prompt工程无法覆盖的强术语排他性、隐式物理逻辑推理、强制风格一致性及高并发下的确定性响应等瓶颈。典型应用场景包括金融客服意图归因、医疗术语精准解析、工业质检因果推断和政务公文合规生成。本文聚焦实战决策逻辑,结合数据质量、推理延迟、成本阈值等核心指标,系统梳理微调启动红灯与弃用信号,帮助工程师跳出

weixin_30425949的博客 312

Prompt Tuning实战:用软提示低成本适配大模型

Prompt tuning是一种轻量级大模型适配技术,通过在输入层注入可学习的虚拟token(soft prompt),在冻结全部原始参数的前提下实现任务定向优化。其核心原理是绕过自然语言理解的不确定性,直接干预Transformer的embedding空间与注意力偏置,从而兼顾推理稳定性与任务泛化性。相比全量微调,它将可训练参数压缩至百级,显存占用降低90%以上,特别适合GPU资源有限、需快速迭代的中小团队。技术价值体现在部署敏捷性(毫秒级prompt热切换)、知识保全性(不污染预训练语义)和工程可控性(

dilv4062的博客 491

提示词学习:轻量级大模型适配的工程化新范式

提示词学习(Prompt Learning)是一种将自然语言提示转化为可训练连续向量的技术范式,其核心在于不修改大模型主干参数,仅通过新增少量可学习嵌入(如Prefix、Prompt Tuning向量)实现任务适配。它融合了传统提示工程的低开销优势与微调方法的效果上限,在小样本、低算力、强合规约束等现实场景中展现出独特技术价值。相比全参数微调,它规避灾难性遗忘,保障模型通用能力;相比纯提示工程,它支持自动化迭代与跨任务复用。当前已在金融风控、智能客服、政务问答等需快速交付、高语义鲁棒性的垂直领域规模化落地,

weixin_33805992的博客 439

快速理解最近爆火的 AI 名词:从 LLM 到 Loop Engineering,一篇搞定不懵圈

满屏 AI 专业缩写看不懂?一篇扫盲!按普及顺序通俗解读 LLM、RAG、Agent、Tool、Skill、Harness、MCP、Loop Engineering 等热门名词,全程避开晦涩推导,理清大模型应用技术发展阶段,新手快速看懂 AI 圈黑话。

sjsi13的博客 383

信息学奥赛一本通高手训练1680:序列

题目 代码 #include<cstdio> #include<iostream> #include<cmath> #define LL long long using namespace std; const LL N = 1400000+7; const LL mod = 1e9+7; int n, t; LL pos[N], sum[N], ans[N]; struct node{ LL ll, rr; }a[N]; int main(){ p

qingfeixueyue的博客 470

吉林大学软件工程章节测验 第九章 答案+解析

4.【判断题】估算软件规模有代码行技术和功能点技术两种方法,其中代码行方法估计实现一个功能所需要的源程序行数,其不依赖项目所使用的开发语言,并且具有较好的直观性。3.【单选题】软件项目估算时,若计划人员对每个功能分别按最佳的、可能的、悲观的三种情况给出功能点估计值,记作a, m, b,则估算的期望值E的公式为( )。8.【判断题】在工程网络图中,如果在由起始事件至终止事件所构成的一条路径上,所有事件的最早时刻都和最迟时刻都相同,那么这条路径就是关键路径。4.【单选题】配置管理贯穿软件开发的整个过程。

m0_51459931的博客 1433

【AI应用开发框架】大模型入门指南:从基础概念到提示词大师

大模型入门指南:从基础概念到提示词大师 本文系统介绍了大模型的核心概念和使用技巧,帮助读者快速掌握AI技术。内容涵盖三大板块:基础模型类(LLM、开源/闭源模型)、核心技术类(Transformer架构、RAG、微调等)和交互应用类(提示词工程、智能体)。通过通俗易懂的类比和示例,解释了30+个AI专业术语,并提供了实用的提示词书写规范。文章特别强调提示词工程的重要性,指导读者如何通过优化提问方式获得更精准的AI回答。适合零基础用户入门学习,也包含进阶内容供有经验的读者参考。

分享 AI 时代程序员的进阶之路:大模型应用、AI 编程工具实战,同时沉淀 C / Linux 底层技术笔记。与君共赴,万里征途。 4504

Rust 编译工具链配置指南:从 link.exe 缺失到完美解决

本文详细解析了Windows下Rust编译时常见的'link.exe not found'错误,提供了MSVC和MinGW-w64两种工具链的完整配置指南。从Visual Studio组件安装到环境变量设置,再到疑难排查技巧,帮助开发者彻底解决Rust编译工具链配置问题,提升开发效率。

earth的博客 321

开会听不懂Embedding、Fine-tuning、RAG?AI产品经理必懂的10大技术概念!

本文针对产品经理在AI技术讨论中的困惑,系统介绍了10个必须掌握的技术概念,包括Transformer架构、Token、Prompt工程、RAG、微调等核心知识。通过产品经理视角的解释和实战应用场景分析,帮助非技术背景的产品经理建立技术认知地图,无需代码基础即可理解大模型原理,从而在技术决策中更有话语权,设计出更符合用户需求的AI产品。

weixin_55154866的博客 766

昇腾910安装驱动出错,降低Centos7.6的内核版本

Centos7.6 启动内核修改,解决昇腾910安装驱动错误的问题。

深蓝 3302

VM与欧姆龙PLC通讯设置:Fins TCP/UDP协议实战避坑指南

本文详细解析了VM视觉平台与欧姆龙PLC通过Fins TCP/UDP协议进行通讯的实战配置与避坑要点。文章对比了Fins TCP与Fins UDP的差异,推荐在多数工业控制场景下优先选用Fins TCP以保证可靠性,并深入讲解了网络设置、寄存器地址映射、轮询优化等核心配置步骤。同时,针对常见的多次触发拍照、数据解析错误等问题提供了具体的解决方案和调试技巧,旨在帮助工程师快速建立稳定高效的通讯连接。

e4f5g6h7的博客 597
上一篇: 从零开始了解AI大模型 - 技术篇:万字深度好文人话说大模型技术
下一篇: 2024 年过半,AI 大模型在各行业的落地实践走到哪了?
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值