CodePMP:提升LLM推理能力的可扩展偏好模型预训练

损失函数与优化器:从「梯度是怎么被造出来的」到「梯度是怎么被用掉的」 本文揭示损失函数与优化器本质一体:优化器仅依赖损失产生的梯度,而损失决定梯度的方向、尺度与噪声特性。错误的损失选择(如分类用MSE)会导致梯度失衡,使优化器失效;不同损失(如Huber、Focal)通过调控梯度分布影响优化过程。实测表明,归约方式、标签结构与损失配对直接决定梯度行为,进而影响收敛性与泛化。核心观点:选对损失,才是让优化器“看得懂”的前提。 阅读详情

在LLM(大语言模型)的对齐训练中,尽管RLHF(基于人类反馈的强化学习)方法被证明是有效的,但它的效果依赖于RM(奖励模型)的能力。然而,训练RM需要高质量的偏好数据,在复杂推理领域(如数学和逻辑推理),这些数据的获取成本高昂且标注困难。此类偏好数据不仅需要多样化的prompt和响应,还需要准确的人类反馈。因此,提高复杂推理领域偏好数据的利用效率,即有限标注数据的情况下训练出更强大的RM,具有重要意义。

幸运的是,GitHub上有大量公开的源代码数据,经过筛选后可以获得高质量且规模庞大的代码片段。这些高质量代码片段不仅数量可观,而且具有丰富的多样性,可以用来反向生成多样化的code prompt(代码描述)。此外,CodeLLM(代码语言模型)已经得到了广泛关注和发展,最先进的CodeLLM可以根据code prompt生成对应的代码片段。基于此,提出了CodePMP方法——通过利用源代码数据,合成大量、多样的代码偏好数据,实现可扩展的偏好模型预训练,从而提高推理RM的微调样本效率,并最终提升LLM在推理任务上的表现。

方法
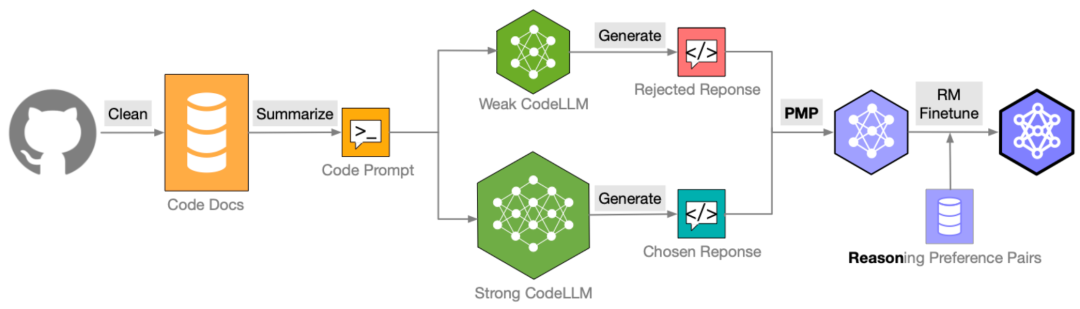
图片CodePMP方法图

CodePMP方法的实现包括以下几个步骤:

  1. 查询生成:从GitHub中获取高质量代码片段,并生成相应的code prompt。
  2. 利用模型能力差异生成偏好数据:根据code prompt,分别使用强CodeLLM和弱CodeLLM生成对应的代码片段,并将两者组成 偏好对。
  3. 损失函数设计:损失函数由两部分组成:基于 偏好对计算的偏好损失(Pairwise Ranking Loss)和基于chosen响应计算的语言建模损失(LM Loss)。
  4. 偏好预训练:在此基础上,利用大量代码偏好数据对模型进行偏好预训练,从而提升模型在下游推理RM微调的样本效率。

伪代码如下图所示:
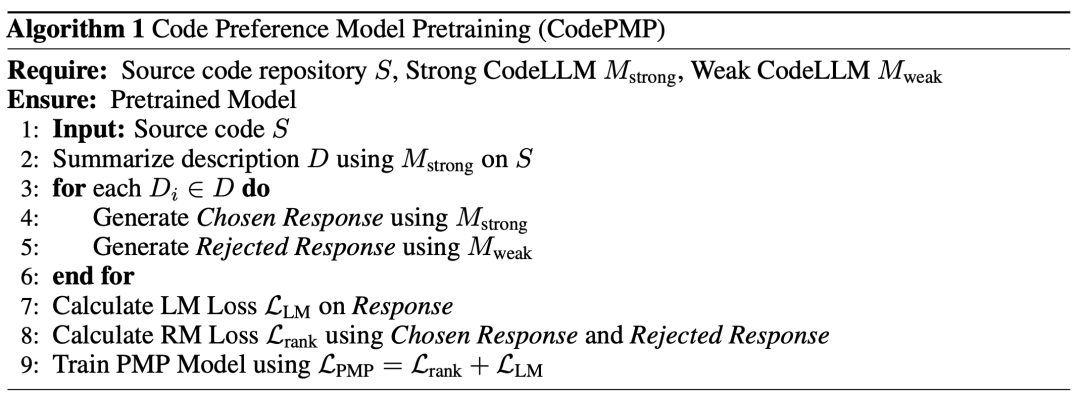
图片

实验结果

设计了一系列实验来验证CodePMP的效果,同时涵盖了数学推理(GSM8K MATH)和逻辑推理(ReClor LogiQA2.0)任务:

RM准确率评测:

在数学推理和逻辑推理任务中,通过衡量奖励模型在区分测试集中chosen响应和rejected响应时的准确性,对比分别 经过CodePMP再微调RM 和 直接微调RM 的效果差别。实验结果显示,CodePMP给数学推理和逻辑推理的RM准确率带来了显著提升。
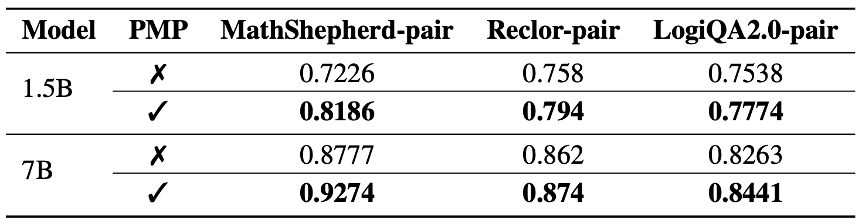
图片RM准确率对比

Best-of-N(BoN)准确率评测:

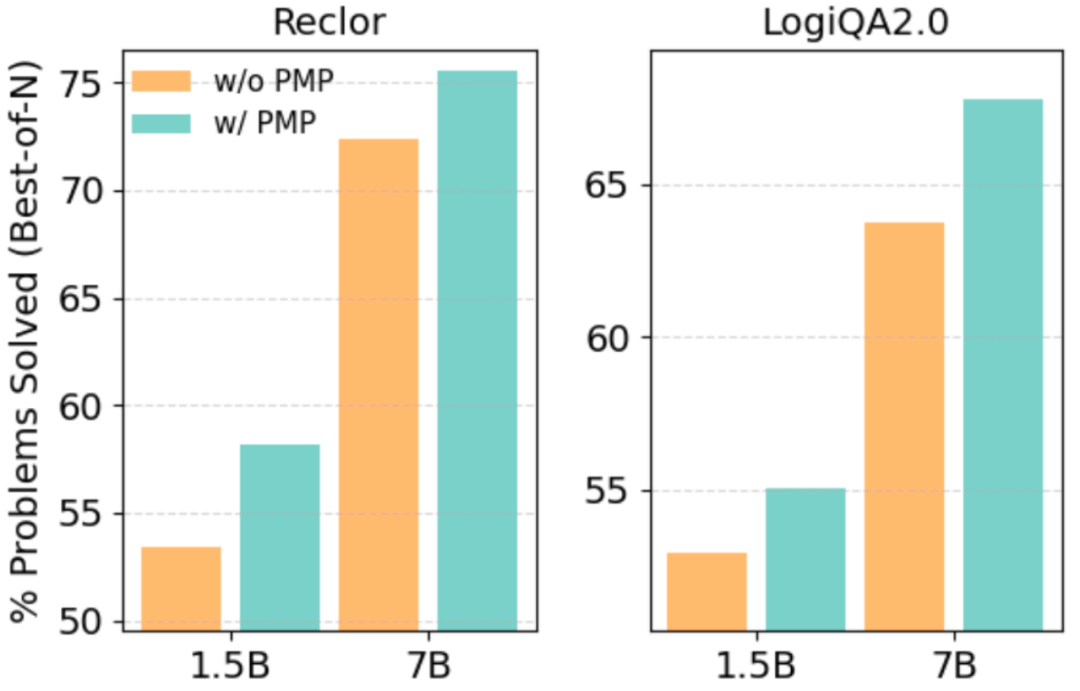
通过为每个问题生成多个候选答案,并让RM选择最佳答案。在数学推理上,在候选答案数量增加到256的情况下,经过CodePMP再微调的RM仍然保持高的BoN准确率,而不使用CodePMP而直接微调的RM的BoN准确率则显著下降。在逻辑推理上,经过CodePMP再微调的RM也有着明显的优势。
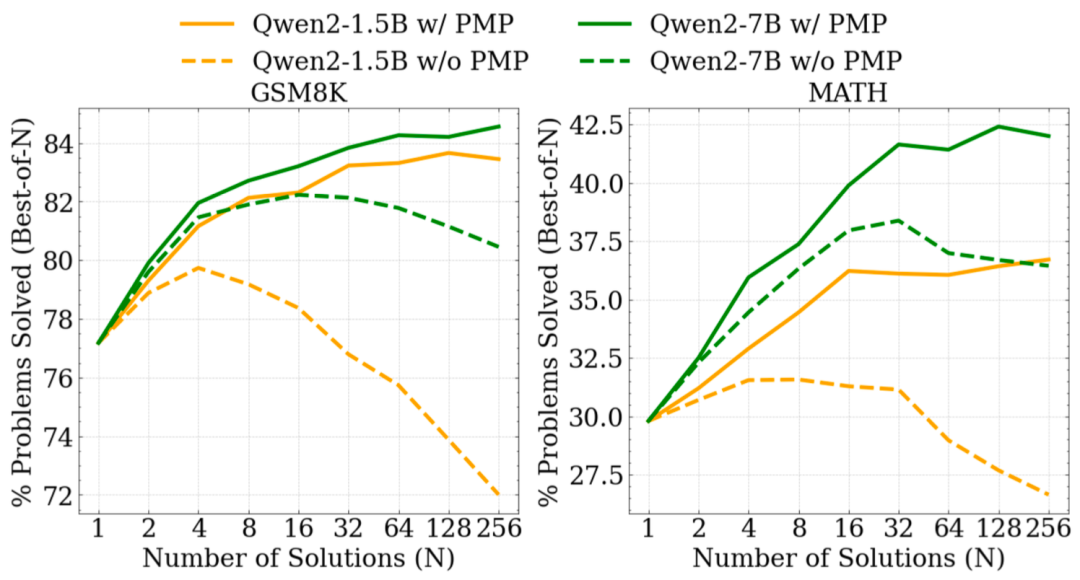
图片数学领域Best-of-N(N逐步增大到256)准确率对比

图片推理领域Best-of-N(N=4)准确率对比

样本效率实验:

在不同微调样本量下的模型效果对比。结果显示,使用CodePMP预训练的模型即使在微调样本量较少的情况下,也能达到或超过不使用CodePMP模型在大样本量下的表现,显著提高了推理RM微调的的样本效率。
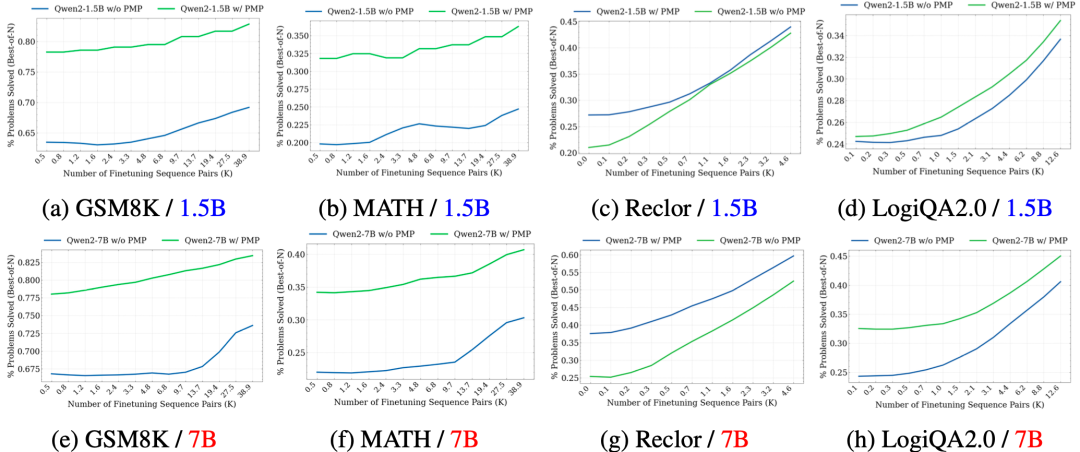
图片不同微调样本量下的模型Best-of-N准确率对比

扩展性测试:

分析了随着合成数据的增多,CodePMP方法带来的增益的变化趋势。实验表明,随着合成偏好对数量的增加,模型在推理偏好任务中的表现持续提升,且未出现效果减弱的迹象,展示了CodePMP方法的高度扩展性。
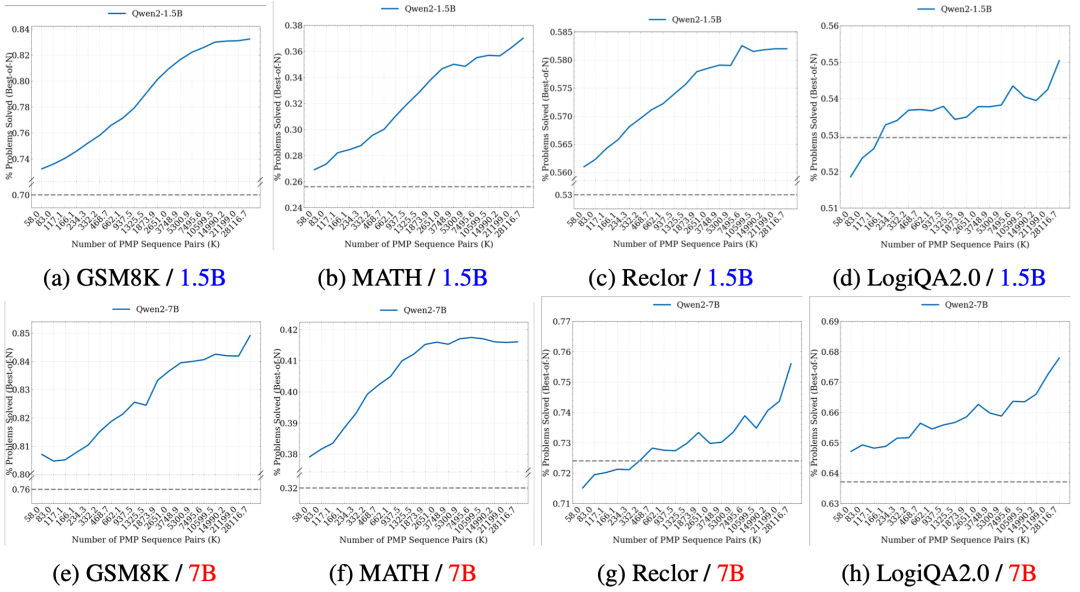
图片经过不同规模数据的CodePMP后的模型Best-of-N准确率变化趋势。虚线是不经过CodePMP直接进行RM微调的表现。

通用性测试:

进一步在Gemma2-2B模型上应用了CodePMP方法。实现效果表明,CodePMP在Gemma2-2B上带来的增益依旧明显,充分说明了CodePMP的通用性,可以给不同的模型带来推理RM样本效率的增加和最终的推理表现的提升。
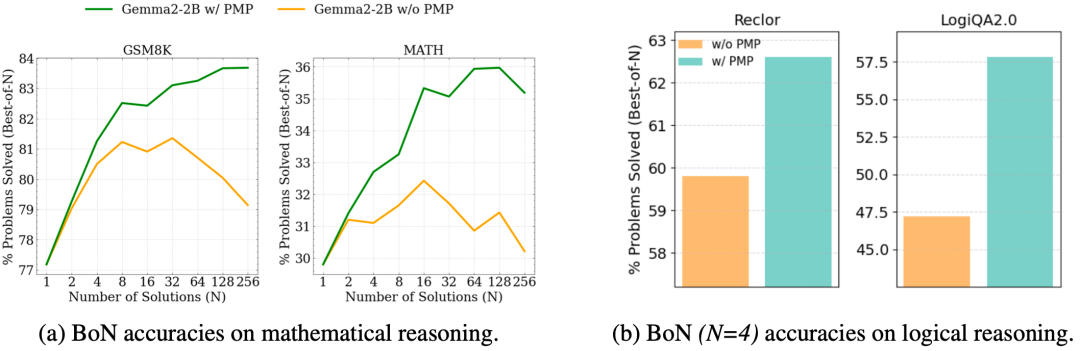
图片CodePMP 提高了 Gemma-2B 奖励模型在推理任务中的样本效率和 Best-of-N 性能

写在最后

本文介绍了一种可扩展的偏好模型预训练方法(CodePMP),通过合成大规模代码偏好对进行预训练,从而提高面向推理任务的奖励模型的微调样本效率,减少对大量高质量人工标注数据的依赖,显著降低数据获取和标注成本。此外,使用CodePMP初始化的奖励模型在多种推理任务中表现出更强的鲁棒性和泛化能力,能够在不同任务类型和数据规模下保持优异表现。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Code Llama: Open Foundation Models for Code 我们发布了Code Llama,这是一个基于Llama 2的大型代码语言模型系列,提供了开放模型中最先进的性能、填充功能、对大型输入上下文的支持,以及编程任务的零样本指令跟随能力。我们提供多种风格以涵盖广泛的应用程序:基础模型(Code-Lama)、Python专业化(Code-LAMA-Python),以及分别具有7B、13B和34B参数的指令遵循模型(CodeLlama-Directive)。所有模型都是在16k个token的序列上训练的,并在高达10万个token的输入上显示出改进。 阅读详情

相关推荐

基于Android13的系统启动流程分析(三)之FirstStageMain阶段

init进程是Android系统中用户空间的第一个进程,作为第一个进程,它被赋予了很多极其重要的工作职责,比如创建zygote(孵化器)和属性服务等。init进程是由多个源文件共同组成的,这些文件位于源码目录system/core/init1. Bootloader 引导当按下设备电源键时,最先运行的就是 bootloader(固化在ROM的程序),bootloader 的主要作用就是硬件设备(如 CPU、flash、内存)的初始化并加载到RAM,通过建立内存空间映射,为装载 Linux 内核做好准备,。

q1210249579的博客 5496

中科院:偏好模型预训练优化LLM推理

在大语言模型(LLMs)中,通过奖励模型(RM)微调来增强推理能力时,依赖成本高昂的高质量偏好数据。论文提出了CodePMP,一种利用代码派生的偏好对进行预训练的方法,以提高下游奖励模型微调的样本效率和鲁棒性。

大模型任我行的博客 2246

基于DBSCAN聚类算法的超像素实时分割

Real-Time Superpixel Segmentation by DBSCAN Clustering Algorithm 摘要 在本文中,我们提出了一种基于密度的带噪声应用空间聚类(DBSCAN)算法的50帧/秒实时图像超像素分割方法。为了降低超像素算法的计算量,我们采用了一种快速的两步框架。在第一个聚类阶段,使用具有颜色相似性和几何约束的DBSCAN算法对像素进行快速聚类,然后在第二个合并阶段,通过颜色和空间特征定义的距离度量,将小簇按其邻域合并为超像素。为了在这两个步骤中获得更好的超像素,定义了

yttt的博客 3493

2024年6月118篇代码大模型论文最全整理

引言本文整理了2024年6月全球各大高校与科研机构发布的118篇代码大模型相关论文。根据论文内容,我们将其整理为基座模型与训练数据、代码微调、测试基准、代码Agent、低资源语言处理、AI代码安全与分析、人机交互、软件工程下游任务应用(包括代码生成、代码总结、代码表征、SQL生成、软件测试、漏洞检测、日志分析、软件建模)等主题的论文专辑。全文篇幅较长,建议电脑端阅读。若您想了解其他时期的代码大模型...

zenRRan的博客 3794

别再傻傻分不清了!Anaconda和Miniconda到底选哪个?附保姆级安装与镜像源配置(Windows/Mac)

本文详细解析了Anaconda和Miniconda的核心差异,包括体积、预装内容、系统资源占用等关键维度,并提供了针对不同需求的决策框架。附有Windows和Mac双平台的详细安装与配置指南,帮助用户根据实际需求选择最适合的conda工具,提升开发效率。

weixin_30315723的博客 426

【论文笔记】Beyond Low-frequency Information in Graph Convolutional Networks

文章目录1. Abstract2. Introduction低频和高频信号作用FAGCN怎么设计3. An Experimental Investigation4. Model4.1 filter定义4.2 Aggregation4.3 Problems of signal combination4.4 Spatial vision of FAGCN4.5 系数αijG\alpha_{i j}^{G}αijG​4.6 模型整体框架FAGCN的表达能力实验 本文发表在AAAI-21上 论文地址:https:

Running Snail 5602

2024年7月117篇代码大模型论文最全整理

干货满满~

CodeFuse的博客 4464

发那科机器人编程软件fanuc roboguide授权补丁_工业机器人离线编程与应用:ROBOGUIDE V8.3版本的工程文件创建...

欢迎关注我们ROBOGUIDE是发那科机器人公司提供的一个离线编程工具,可模拟现实中的机器人和周边设备的布局,通过虚拟TP示教来模拟机器人的运动轨迹,同时可以验证方案的可行性和准确的周期时间。ROBOGUIDE是一款核心应用软件,具体的还包括搬运、弧焊、喷涂等其他模块。以最新的8.3版本为例进行讲解,对于未注册的版本将有30天的免费使用期限。开始菜单击开始菜单中的HandingPRO启动程序,第一...

weixin_39791446的博客 2925

【论文浅尝】CODEIE: Large Code Generation Models are Better Few-ShotInformation Extractors

在本文提出将结构化输出转换为代码而不是自然语言的形式,并利用代码的生成法学硕士(code -LLMs),如Codex来执行IE任。与nl - llm相比,我们展示了代码- llm可以通过设计代码样式提示并将这些IE任务制定为代码生成任务来与这些IE任务很好地对齐。以下图中的示例输入“Steve在1998年成为Apple的CEO”为例,我们将其包装成一段Python代码,并将结构化实体输出制定为带有键“text”和“type”的Python字典。

qq_47982709的博客 1484

告别倍福开发板:手把手教你用SSC工具为STM32生成EtherCAT从站代码

本文详细介绍了如何使用SSC工具为STM32生成EtherCAT从站代码,帮助开发者在不依赖倍福开发板的情况下实现高效的工业以太网通信。通过SSC工具的配置、XML文件设计、代码移植与硬件适配等步骤,开发者可以轻松构建自定义的EtherCAT通信系统,提升工业自动化项目的灵活性和效率。

weixin_33925615的博客 410

(持续更新中!)详解【计算机类&面试真题】军队文职考试 ——第二期(真题+解析)| 网络协议的三个核心要素;交互式系统中的非剥夺策略;中断和陷入的区别;可变分区管理中的硬件机制;数据库系统的优点

本篇博客将讨论军队文职面试(计算机类)的几个关键问题。我们将介绍网络协议的核心要素(帮助你理解网络通信的基本原理)、交互式系统中的非剥夺策略(解释为何这是一个优秀的策略以及其对用户体验、系统稳定性和可预测性的影响)、中断和陷入的区别(从引起原因、处理机制、权限级别和应用等方面进行阐述)、可变分区管理的硬件机制以及数据库系统与文件系统的优点比较。通过阅读本文,您将深入了解这些话题,为面试准备和实际应用提供有价值的知识。

追光者♂:记录、分享、总结、提升,现象级专栏《Python从入门到人工智能》作者,无惧黑暗,坚信曙光 1707

代码如何赋能大语言模型成为智能代理

大语言模型(LLM)通过代码数据的训练与微调,正从文本生成工具进化为能执行复杂任务的智能代理。代码作为结构化训练数据具有独特价值:其精确的语法结构、显式的逻辑流和可验证的执行结果,为模型提供了明确的学习框架和强化信号。代码微调技术如全参数微调、适配器微调和提示微调,能有效提升模型在代码生成和逻辑推理任务上的表现。多语言代码训练还能带来协同效应,增强模型的跨语言迁移能力。这些技术进步使得代码增强的智能代理能在算法优化、数据处理等场景中发挥更大作用,推动AI应用向更复杂的实际问题解决方向发展。

weixin_30776545的博客 313

如何在 SAP BTP 上使用 Integration Suite 消费 S/4HANA Cloud API

SAP Integration Suite是一个集成平台即服务(iPaaS),允许开发人员顺利地将内部部署和基于云的应用程序和流程与SAP管理的工具和预构建内容进行集成。登录 SAP Business Technology Platform Cockpit,进入 integration suite:再点击 API management 进入 API Portal:或者直接从收藏夹里打开链接:https://304a49cetrial.integrationsuitetrial-apiportal.cfapp

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1698

EvalPlus:提升LLM4Code评估的严格性与准确性

EvalPlus是一个专为LLM4Code设计的严格评估框架,旨在通过提供比原始HumanEval和MBPP多出数十倍的测试用例,来精确评估和排名大型语言模型在代码生成方面的性能。该项目不仅提供了丰富的测试数据,还通过开源预生成的LLM样本,加速了LLM4Code的研究进程。 ## 项目技术分析 EvalPlus的核心技术优势在于其扩展的测试集——HumanEval+和MBPP+,它们分别提供...

gitblog_00721的博客 806

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【亲测免费】 深度评估(DeepEval):LLM评估框架安装与配置完全指南

深度评估(DeepEval)是一个易于使用的、开源的大型语言模型(LLM)评价框架,它类似于Pytest,但专门用于单元测试LLM的输出结果。此项目旨在简化对语言模型输出的验证过程,提供多种评估指标,如G-Eval、hallucination检测、答案相关性等,并支持通过任意选择的LLM或本地运行的NLP模型进行评估。DeepEval采用Python作为主要开发语言。 ## 关键技术和框架 - ...

gitblog_07610的博客 1479

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

【机器学习300问】139、Post-LN 和 Pre-LN 的区别?

Post-LN与Pre-LN的核心区别在于LayerNorm的位置:Post-LN在残差连接后,导致梯度需经LayerNorm变换,深层易出现梯度衰减或震荡;Pre-LN先做归一化,使输入稳定,残差路径梯度可无损回传,显著提升深层训练稳定性。尽管Pre-LN支持更深层次模型(如LLaMA、Qwen),但存在“深度诅咒”——深层贡献不足。相比之下,Post-LN浅层表现尚可,深层数易发散。因此,现代大模型普遍采用Pre-LN以保障训练可靠性。

qq_39780701的博客 396

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

机器学习基础|监督学习、标签、回归

网约车预估等待时长依赖监督学习中的回归任务。平台利用历史订单数据,以司机实际到达耗时为标签,通过上车点、时间、运力、路况等特征训练模型。模型不断优化预测值与真实耗时的误差,最终对新订单输出连续的预估等待时间,实现精准预测。

weixin_43971465的博客 240

Hugging Face:成为机器学习界的“Github”

以下文章来源于OneFlow,作者OneFlow社区五年前,AI领域的知名研究者Andrej Karpathy发文称,传统人工编程属于“软件1.0”,“软件2

2601_96798011的博客 126

这7个小众Python库,才是机器学习工程化的降效神器

别再只盯着TensorFlow了:这7个小众Python库,才是机器学习工程化的降效神器在很多人的印象里,机器学习似乎就是高深莫测的数学公式、成千上万的GPU集群

2601_96797912的博客 160

机器学习——混淆矩阵(待更新)

二元: true表示真实==预测,positive表示预测值=1.

m0_61175448的博客 133

【机器学习300问】138、LayerNorm和BatchNorm的区别?

本文阐述了归一化与标准化在深度学习中的核心作用。输入层标准化可统一初始输入,但深层网络仍面临激活分布漂移。为此,提出BatchNorm与LayerNorm两种主流方法。

qq_39780701的博客 183

为什么生成对抗网络训练常不稳定,模式崩溃与判别器过强之间是什么关系?

当支持集不重叠时(即 $D$ 能完美区分真假),JS 散度为常数 $\log 2$,其梯度为 0。这意味着一旦 $D$ 训练得稍好,$G$ 就失去了学习方向,导致训练停滞。生成对抗网络(GAN)的训练本质上是生成器($G$)与判别器($D$)之间的非合作零和博弈。以下代码展示了如何通过梯度惩罚(Gradient Penalty)来约束判别器,避免其过强导致生成器梯度失效。判别器过强是导致模式崩溃的直接诱因之一,二者之间存在明确的**“梯度误导”**因果关系。

2402_84593233的博客 204

Spark06_MLlib机器学习

本文是《PySpark 从入门到实战》系列收官篇,带你用 Spark MLlib 走通机器学习全流程:从三要素与 7 步标准流程讲起,剖析 KNN、朴素贝叶斯、决策树三大算法原理,再以 KNN 手写、垃圾短信分类、决策树分类、逻辑回归鸢尾花(准确率 96.67%)、K-Means 聚类(轮廓系数 0.7345)五个案例落地,最后详解 TF-IDF 文本特征与余弦相似度。全文代码可直接运行,适合有 RDD 与 Spark SQL 基础的开发者快速上手。

2301_80420058的博客 451

AI 是怎样从数据中学习的?训练、验证、测试与推理

泛化能力(Generalization)指模型面对训练过程中没有见过的新数据时,仍然能够做出合理预测的能力。这是判断模型是否具有实际应用价值的重要标准。例如:一个用户流失预测模型,在历史数据上表现很好,但面对新上线的用户群体时,预测准确率明显下降。这可能说明模型学到的规律无法适应新的用户群体。泛化能力不仅取决于模型本身,也与训练数据是否具有代表性有关。训练数据只包含老用户,没有新用户。训练数据主要来自某个地区,实际业务却覆盖不同地区。过去的用户行为与当前用户行为已经发生变化。

dshizixu的博客 312
上一篇: 大模型在股市真的能帮我们赚钱吗?
下一篇: 说了很久的建筑转大模型,也不过是想在职场完成赎身
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值