大模型产品化,不过是三支舞

教育科技公司如何构建AI技术主权:从采购依赖到垂直自研 教育AI不是通用大模型的简单移植,而是以教学法为内核、过程性数据为燃料、轻量化部署为路径的技术重构。当课堂专注度识别需区分‘走神’与‘演算低头’,当作文批改必须理解‘立意新颖性’的教学语义,通用API便暴露出场景耦合不足、数据闭环断裂、技术债复利增长三大瓶颈。教育科技企业正从‘功能集成’转向‘教学逻辑建模’,通过自研垂直模型(如MathGPT)、教育专用算力集群、L1级过程数据治理及原子化教学组件封装,将技术决策锚点从供应商能力边界迁移至自身教研资产价值。这种转型本质是建立可解释、可迭代、可嵌入真实教学节奏 阅读详情

今天,摆在全球数百个AI大模型面前的,是一个共同的问题:如何赚钱。

无论模型诞生地在中国还是美国,无论属于通用大模型还是垂直大模型,商业化可以说是这项技术在全球范围内共同面对的问题。

在大模型最初所带来的震惊与喜悦过后,是大量AIGC平台走向免费开放,大模型toB服务大打价格战。花样繁多的大模型,似乎始终无法激活用户的付费欲望。

而大家都知道,商业化的前提是产品化。虽然大模型带来的AIGC能力本身就有着非常强烈的产品化属性,但以一种软件应用来说,它还是过于粗陋和黑箱了。用户需要自己去探索AIGC究竟能带来什么,可能性有哪些,从而很难获得确定性的产品满足。另一方面,大模型在技术上的潜力也没有被充分挖掘。一些需要在产品设计层面放大的基础能力,还静静地躺在平台那一长串功能简介里。
图片

于是,在全球共享的商业化压力下,大模型产品化开始提速。不分中美,无论是传统科技巨头还是新型AI公司,都开始在大模型产品化上发力,推出了五花八门,千姿百态的大模型产品化策略。

这种情况导致很多朋友会有点迷茫。放眼望去,感觉每家厂商都在做不一样的AI产品,提出全新的AI概念。但仔细想象,好像又说不出究竟哪里不同。

为了帮大家克服这种乱花渐欲迷人眼的“AI眩晕感”,我们盘点了目前大模型产品化的三种主要思路。

看不懂大模型产品化的诸多套路不要紧。我们只需要记住,今天的大模型,其实就是在跳三支舞。
图片

通往全模态的胡旋舞

那些国际AI巨头眼里的AI产品大概长什么样,这个问题已经渐渐有了答案:他们可能希望AI跟真人差不太多。

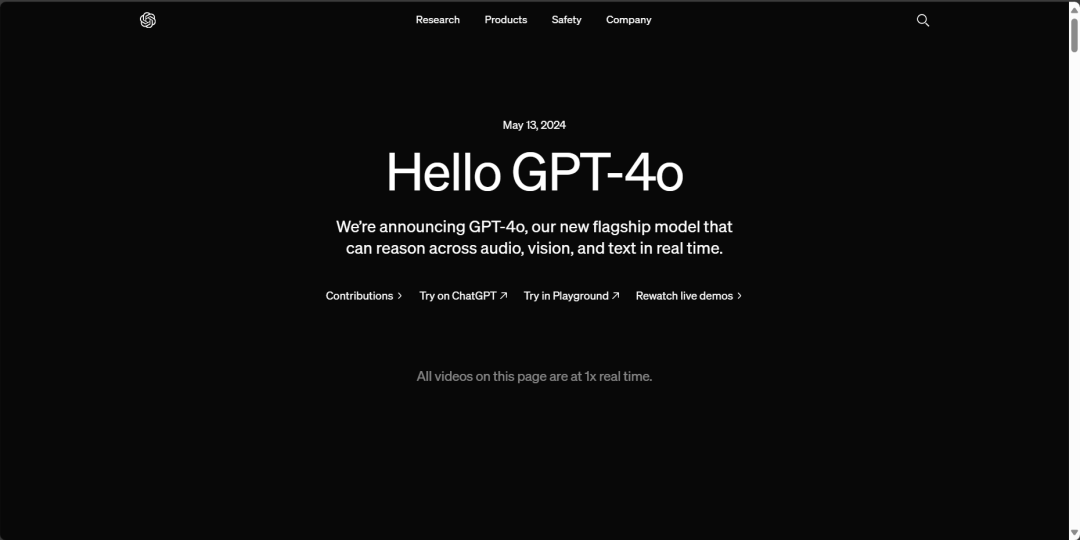
不久之前,OpenAI和谷歌接连发布了新的AI产品,也就是OpenAI最新的旗舰大模型GPT-4o,和谷歌的Project Astra。**它们的共同点,是都加入了跨文本、音频与视觉的信息收集能力。**换言之,大模型正在从只能听、读、写,变成同时也能看和说。用户与大模型之间的交互模式,也在越来越像与真人之间的交互模式,而且大模型可以在200到300毫秒的区间内响应音频输入,这已经与人类之间的交流速度大体相同。
图片

GPT-4o被称作OpenAI有史以来最为产品化的一款应用,就是因为它更加重视与用户之间的互动体验,打磨了诸如响应速度、具体使用功能等被定义在产品侧的细节。更重要的是,GPT-4o开创了一种新的产品模式:它比语音助手的交互形态更多,作用更广,同时比传统的AI对话框模式降低了使用门槛,增加了使用场景。

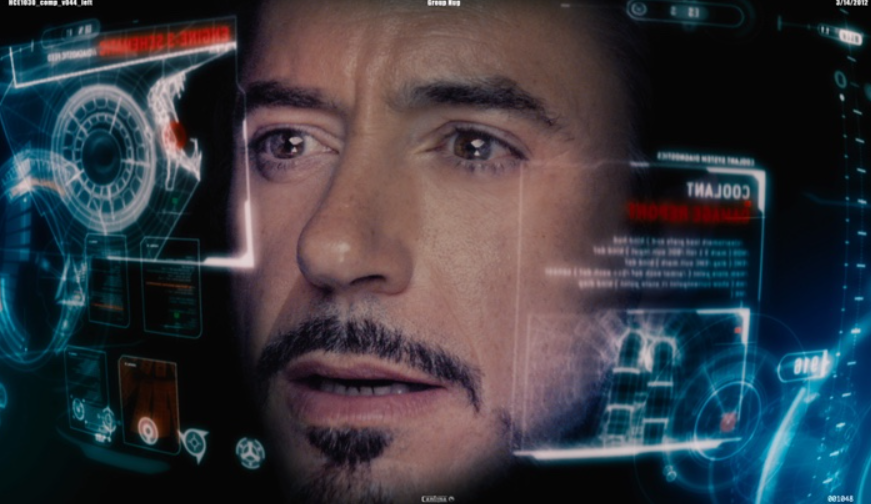
这种AI产品的使用体验,非常接近于跟真人打视频电话。很难不让人想到电影《Her》或者《钢铁侠》中的贾维斯,虽然在使用体验上肯定不如它们,但产品逻辑已经与科幻电影里对AI的使用想象一般无二。
图片

我们有理由猜想,OpenAI在AI产品化上的思路,就是比对着科幻作品来进行设计的,只不过他们恰好有机会把科幻变成现实。

这种“类视频电话”的大模型产品模式,本质上是将不同的AI感知、理解、生成能力进行融合,就像胡旋舞会越转越快,随着大模型的不断发展,AI技术也在越转越快,把不同模态下的信息收集能力与内容生成能力都卷进来。

沿着这条路走下去,有理由相信接下来的主流AI产品会发生这样的变化:

1.类似Sora的视频生成能力,将很快融合到主流通用模型中。让AI应用能够同时听、看、读,并且能够生成包括文字、代码、音频、图片、视频在内的种种内容。

2.垂直类的AI模型生存空间会越来越小,通用模型集成的能力不断增多。就像GPT-4o里的“o”是Omni全能的意思。全能,将是AI产品主要的发展方式。

3.AI的记忆能力会越来越强,从而导致“全能+定制化”成为AI应用的主要发展思路。

虽然在目前阶段,大模型在很多时候还是为了与搜索、绘图、语音助手等能力结合。但随着全模态感知,全模态理解,全模态生成的“三全大模型产品”不断发展,大模型将不再是一种赋能技术,而是更倾向成为独立且全新的产品形态。

这个产品方向虽然还不成熟,但方向的确定却意义重大。

类“视频电话”的AI应用,可能是除了机器人管家之外,人类对AI的最根本想象。它的出现和发展,意味着AI时代最大的一座海底金矿正浮出水面。

类ChatGPT应用的集体舞
图片

如果大模型是一支足球队,OpenAI这样的公司在前场进行突破,那么更多的AI公司、科技公司则需要在中场进行竞争。在ChatGPT爆火之后,OpenAI开始在智能体、文生视频模型、全模态模型等领域发展,但大量借着这个机会入局大模型的公司,则更多是在打磨自己的类ChatGPT应用。经历了漫长的内测之后,如今大量聊天对话框模式的AIGC应用走向公众。这时候问题来了,投入了这么多,也终于可以面向C端用户开放了,如此费劲,最后要怎么赚钱呢?

**于是我们正在目睹非常奇特的一幕:以国产大模型阵营为代表的大量AI项目,都集中在了类ChatGPT模式这个环节上。**向前走的文生视频等应用还没有完成研发,而环顾左右则会发现大家的能力大同小异,动作整齐划一,只有概念口号是个喊个的。
图片

无论是叫AI助手、智能平台、智能对话还是智能搜索,本质上这些大模型产品都是类ChatGPT应用。从最早的文心一言,到通义千问、豆包、Kimi、腾讯元宝、讯飞星火、天工,市场已经充斥了太多的类似产品,大模型变成了一场货真价实的集体舞。

有一个囚徒困境正在困扰着所有这类产品:想要收费来回收研发成本,但又怕收费引起用户不满,把用户推向竞品;想要通过技术能力来实现差异化,但又拿不出真正具有说服力的技术方案,于是只能在概念、名称、噱头上下一番功夫。

为了摆脱这个困境,类ChatGPT应用们也找到了一些产品化方案,我们可以做个总结:

1.开始强调类GPTs模式,以智能体撬动市场升级。

俗话说得好,大模型+对话就是开个场,真正卖票还得看智能体。可定制化,具有专业能力的智能体,被认为是大模型商业化的真正归宿。面向这个可能性,各家厂商也开始了自己的探索,包括OpenAI打造了GPTs模式也是如此。
图片

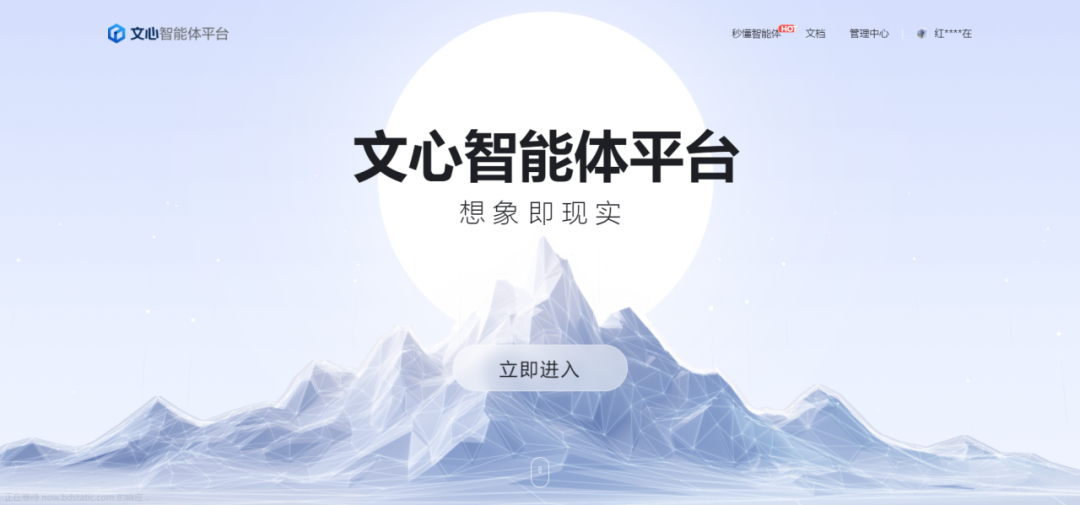
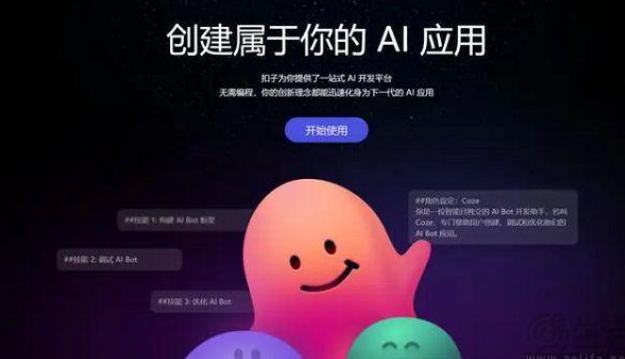
比如说,文心大模型已经正式落地了智能体能力,推出了文心智能体平台;火山引擎也公布了一站式AI应用开发平台扣子。基础的AIGC对话免费+高阶智能体收费的产品模式,是接下来大模型商业化的主要考虑方向。
图片

2.把类ChatGPT产品作为流量入口。

另一种类似应用的产品化建设思路,是大入口+小收费窗口的互联网模式,即整体产品免费,但一些特定的功能可能需要开通会员或者使用代币。收费功能可能相对比较专业,瞄准特定需求人群,或者比较新奇好玩,调动用户的猎奇尝鲜心理。

这种模式的问题在于,会把整个产品变得越来越复杂。用户会有一种在玩免费手游一样的“被套路感”。而且整个入口的生态建设也需要更清晰的交互思路,以免用户刚刚接触大模型就面对非常复杂,到处都是收费入口的交互逻辑。

3.把类ChatGPT应用与自身优势结合。

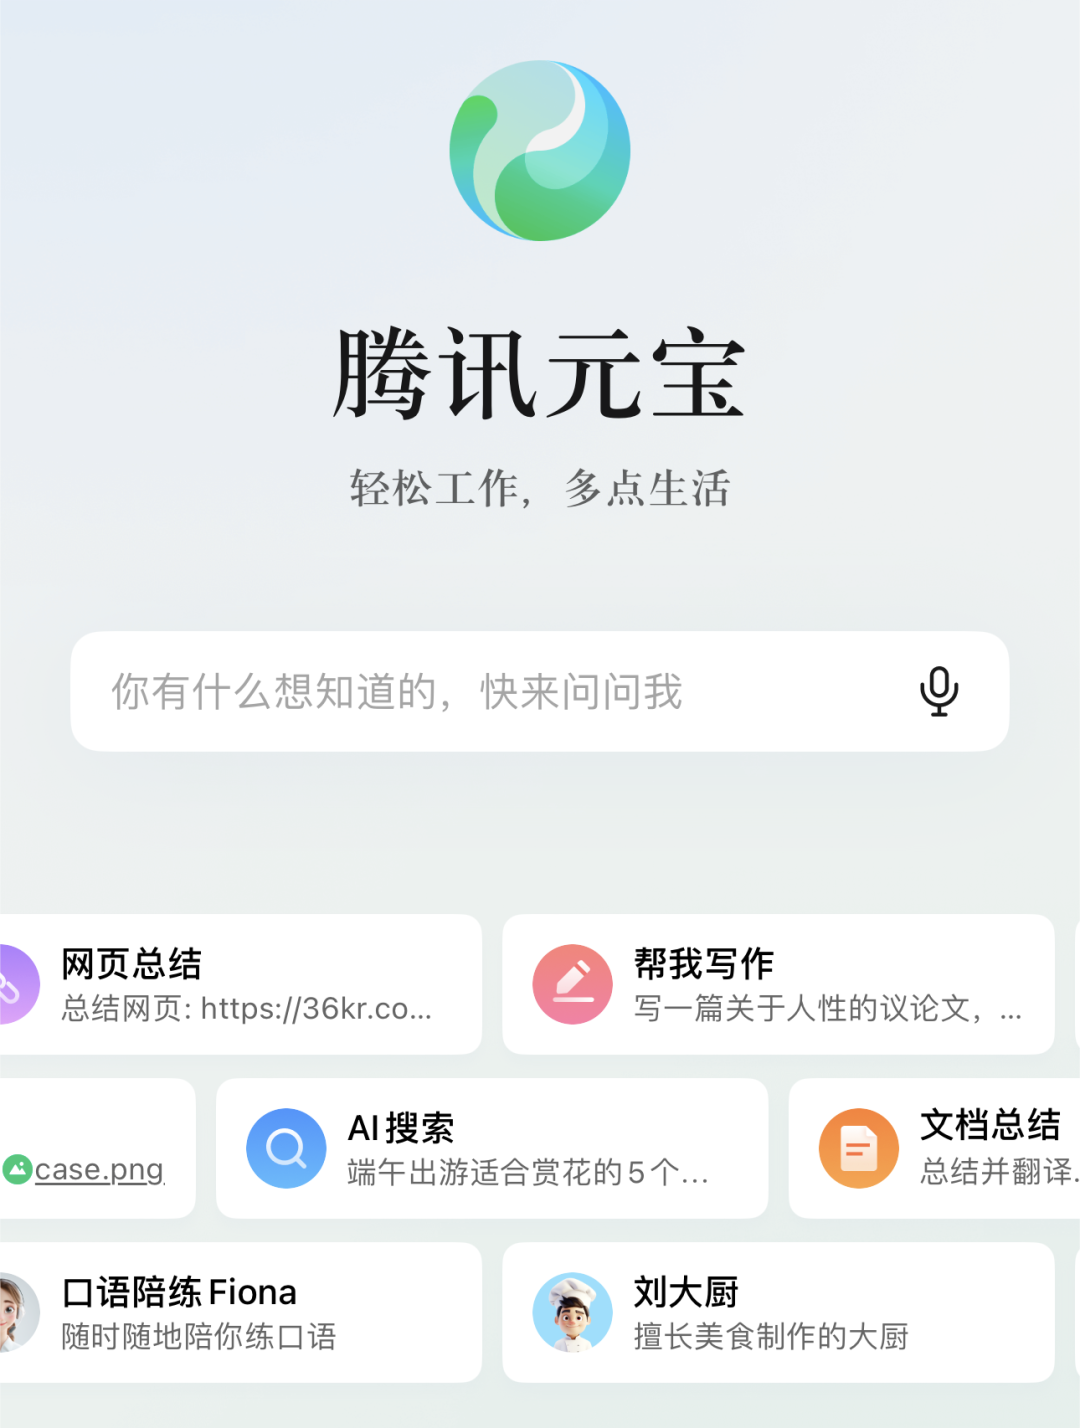
第三种相关产品的建设方案,是结合这些平台类企业其他的优势项目,从而期望达到1+1>2的效果,至少要将一部分原有平台的用户绑定到大模型应用上。比如百度就强调将搜索、文库、网盘等应用与大模型结合,以各种方式调用文心大模型。腾讯元宝则宣布将与公众号创作生态进行结合,成为创作助手。
图片

这种生态矩阵玩法,是互联网产品的一贯思路,但用户是否能够由此产生与大模型应用的粘性,是一件需要长期考量的事情。

我们必须尴尬地承认,曾经风头无两的ChatGPT,也已经在尝鲜期过去之后渐渐淡出了用户热情追捧的区间。用户更希望看到的是非常生动、好玩,能够引发流行趋势的AI应用,而不仅仅是生硬的对话框。

类ChatGPT应用真正的产品化春天,或许在于打破固化的AIGC对话聊天框架。把其能力抽取出来,变成更具有美感与传播力的软件产品。

毕竟集体舞里能被记住的,很有可能是不按规定动作的那一个。

图片

拟人化的贴面舞

在这些大模型产品化的思路之外,还有一种思路应该得到重视,那就是将AI产品进行拟人。

不久之前,如何让ChatGPT“越狱”搞一些奇怪事情的教程四处流窜,一些网友掀起了跟AI“谈恋爱”的新时尚。无论我们怎么评价这些行为,必须意识到的是,**人类对AI的基础想象必须是拟人化、类人化的。**也就是说,我们需要AI有名字,有个性,跟人类有共同记忆,而不是冷冰冰且万能的对话机器。

从这个思路看,**AI带来的最大价值是情绪与情感价值。**我们需要与人对话,与人分享,和他人建立联系,但这个人可能也未必需要是真人。这种需求是客观存在,且具有商业化潜力的。GPT-4o被指责侵权采用了明星的声音等行为,其行为动机都是希望AI更加拟人,能够让用户产生与真人进行对话的想象。

让大模型拟人化,与用户跳贴面舞,在接下来商业化压力越来越大的局面下,很可能成为很多AI项目的重点选择。
图片

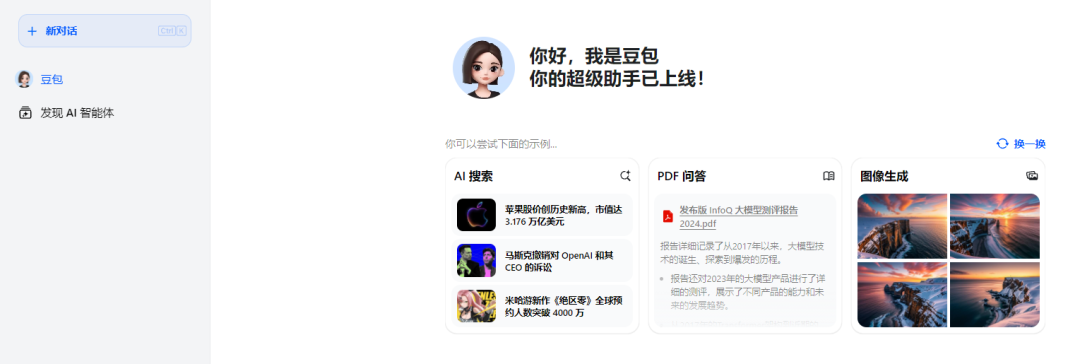
比如说,豆包大模型当中就推出了角色扮演模型,AI会模仿不同人设、不同性格的人来与用户进行对话,并且可以通过智能体来自己设定聊天角色。

有人设的聊天,重点是多轮对话的记忆能力。这一点上,也有越来越多的大模型产品强调记忆能力,比如文心一言就强调多轮对话能力带给用户的沉浸体验角色感。

技术难度小,价值可能很大,但容易触碰法律法规与公序良俗的边缘地带。大模型拟人的产品化空间,应该会在未来得到越来越大的重视。由此可能辐射到的数字人主播、专属AI助手等产品化形式,有着非常充裕的讨论和想象空间。

大模型的产品化,目前整体处在一个高不成低不就的尴尬情况里。向上突破,技术代差依旧明显,技术的未知领域情形不明;横向竞争,同类大模型产品过多,已经产生了让人窒息的挤压感;向下覆盖,大多数互联网用户其实还对大模型应用没有感觉,找不到使用与付费的必要性;弯道超车,搞一些拟人项目,还容易触到各种雷区。
图片

这种情况下,大模型的产品化必须戴着枷锁跳舞,既要让观众看到,又要小心舞台上的荆棘。

或许在不远的未来,一个或者几个天才般的产品化创意,将解决一切大模型的苦厄。但在今天,做大模型产品的主旋律依旧是赔钱赚吆喝,打肿脸充胖子。
图片

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
Agent Runtime 正在成为AI时代的操作系统底座 Agent runtime 是支撑大模型智能体稳定运行的底层执行环境,其核心原理在于将状态管理、工具调用与权限控制从模型上下文解耦,转向事件日志驱动、凭证隔离和无状态执行器架构。这一技术演进显著提升了AI应用的可审计性、可恢复性与生产安全性,为金融、医疗、客服等高合规要求场景提供工程化保障。随着 Anthropic Managed Agents、AWS AgentCore 等主流平台推动 runtime 标准化与托管化,开发者正从重复造轮转向聚焦 Trace Store、Policy Governance 阅读详情

相关推荐

LangGraph构建可追溯的Python组合分析工作流

组合分析是量化投研的核心环节,其本质是多源异构数据融合下的动态风险归因与决策支持。传统基于Pandas/NumPy的脚本模式面临数据脆弱、逻辑耦合、结果不可溯三大瓶颈,难以满足晨会级实时响应与监管审计要求。LangGraph通过显式状态管理(State)和条件化边路由(Conditional Edge),将组合分析升维为可调试、可降级、可灰度发布的决策流引擎。它天然适配持仓加载、GICS映射、Brinson归因、敏感性分析等关键场景,支撑Python组合分析从手工作业迈向工程化流水线。本文聚焦金融实操中的动

weixin_34279246的博客 354

GPT-4产品化实战:长上下文与多模态的企业落地指南

大语言模型(LLM)已从技术验证阶段迈入企业级产品落地深水区。理解其核心能力如长上下文处理与多模态交互,关键在于把握底层原理如何转化为实际可用性——例如128K上下文并非单纯扩容,而是通过注意力机制优化降低用户认知负荷;多模态也不等于通用图像理解,而是在财务票据、UI评审等具体业务场景中实现‘视觉语义协同’。这类能力直接决定知识管理、内容合规、教育辅导与开发者工具四类产品的竞争力重构。本文聚焦GPT-4产品化路径中的推理成本控制、企业级可靠性指标与真实场景压力测试方法,为B端产品经理与技术创业者提供可复用的

stevenbill的博客 144

电脑卸载神器Revo Uninstaller Pro,彻底清残留,终身无限制使用

打开软件后,它会自动扫描并列出电脑里所有已安装的程序,小到各种插件、大到专业设计软件和驱动程序,哪怕是隐藏的系统组件,都能给你扒出来,还会自动分类整理,加上搜索功能能快速定位目标软件,就算是电脑小白,也能轻松上手。卸载彻底无残留:能直接代替系统自带的 “添加 / 删除程序”,不光能正常卸载软件,还会通过内置卸载程序配合残留扫描,把软件留下的残留文件、垃圾还有注册表项都扫得明明白白,扫描强度有三档可以选,想清理得多干净都能自己定,删除之后电脑立马清爽不少。电脑用久了是不是越来越慢?

qq_75153390的博客 1747

顶流集结,分享出海实战真经!出海大会终极剧透!

则会带着独家数据与头部企业案例双线输出——先是在「全球拓展新视野」环节,深入剖析塑造中企出海战略格局的最新趋势,审视新的全球竞争格局,解读中企出海的持续「升级」逻辑;“免费计划”账户类型,确保零花费,安心试用。——熟读政策的、吃透流量的、懂海外文化的、踩遍海外坑的全能大神都在这,干货远不止AI和云技术,别光逛,大胆聊,带着你的出海难题,直接来这场大会就对了!从亚马逊全球电商、物流、营销、广告,再到云计算等核心板块,全球资源的系统性支持和自上而下深度协同,为中国企业出海提供一体化、强有力的支持。

亚马逊云科技专栏 92

UFS 功能描述:UFS boot

UFS 启动过程介绍:启动配置,启动代码下载过程和安全性

m0_51720747的博客 1601

3、流程引擎下载安装与部署

camunda有多种使用方式,此处先使用独立平台的方式部署引擎,这种用法适合分布式,微服务化,多语言异构系统的使用方式。

leyoliu的博客 5520

AI工程师四大进阶路线:小白也能找准方向,快速入行

本文详细解析了“AI工程师”这一职位的多样性,包括AI应用、平台与基础设施、传统机器学习、前线交付等不同方向。文章强调,零经验者应先确定目标岗位,而非盲目学习。通过分析GitHub上的AI工程岗位数据,揭示了企业对能整合模型、数据、代码及业务流程的人才需求。文章进一步为不同背景和兴趣的人提供了四条实用职业发展路线,并指出评估能力是所有方向的关键。“AI 工程师”这个职位名称,已经装下了几种完全不同的工作。

xzp740813的博客 587

【异常】Claude CLI / Claude Code 命令行工具 “claude 不是内部或外部命令“ 报错完整解决方案

摘要:Windows系统执行Claude命令报错"'claude'不是内部或外部命令",主要原因是环境变量配置问题。解决方案包括:1)通过npm全局安装时需加-g参数并重启终端;2)检查Node.js环境及npm全局路径是否加入系统PATH;3)对于Claude Code独立安装版,需手动添加.local/bin路径到环境变量。常见错误包括安装不完整、权限不足或路径未自动配置,按照对应场景排查即可解决。

奶爸的编程之路,也就一周冷个三天 7815

基于Dify构建个性化推荐AI应用的可行性分析

本文探讨了利用Dify平台构建个性化推荐AI应用的可行性,重点分析其可视化编排、RAG支持与Agent架构在语义理解与动态推荐中的优势,展示如何通过低代码方式实现高效、可维护的智能推荐系统。

weixin_42263617的博客 750

基于扩散模型的图像去噪与修复:原理、实现与性能分析【附核心代码】

扩散模型(Diffusion Models)在图像修复、去噪、风格化、超分辨率等领域的应用,展示了其强大的生成能力和灵活性。通过模拟图像逐步加噪声再去噪的过程,扩散模型不仅能够恢复图像的细节,还能生成高质量的图像。本文详细探讨了扩散模型在图像修复和增强中的应用,并通过具体代码示例展示了如何使用扩散模型进行去噪、风格化、图像超分辨率等任务。扩散模型在图像修复中通过逐步去噪修复损坏的区域,在图像去噪中则能够去除图像中的噪声并保留细节;在图像风格化中,扩散模型通过结合目标风格和内容生成富有艺术性的图像;

一键难忘的博客 2929

计算机视觉卷积神经网络(CNN)基础:从LeNet到ResNet

计算机视觉卷积神经网络(CNN)基础:从LeNet到ResNet,在计算机视觉领域,卷积神经网络(Convolutional Neural Network,CNN)已然成为推动众多任务发展的核心力量。从早期简单的图像识别,到如今复杂的目标检测、语义分割、图像生成等任务,CNN 都展现出了卓越的性能。CNN 的发展历程见证了一系列经典模型的诞生,其中 LeNet 作为开山之作,为 CNN 的发展奠定了基础,而 ResNet 则通过创新性的设计,突破了传统神经网络的限制,使得网络能够构建得更深、性能更优。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 14万+

机器学习模型生产化:从Notebook到K8s的工程实践

机器学习模型部署不是简单运行predict(),而是涉及可观察性、可追溯性与可治理性的系统工程。其核心原理在于将模型从开发态的黑盒函数,重构为具备健康检查、指标暴露、版本控制和自动扩缩容能力的服务实体。技术价值体现在降低线上事故率、压缩交付周期、实现故障快速归因。典型应用场景包括电商实时风控、工业预测性维护及金融反欺诈等高可靠性要求领域。本文聚焦中级ML工程师真实落地痛点,深入解析Triton推理服务、Flask网关混合架构、四维模型版本管理及基于Prometheus+Grafana的三层监控体系。

weixin_34252686的博客 319

system_server_lowmem真的是内存不足吗?

Android系统中的system_server_lowmem真的表示系统的内存遇到瓶颈了吗?以及遇到这类日志该如何分析系统的内存,本文会回答这个问题。

jidapenglin28的专栏 513

具身导航中的不确定性建模与成本敏感决策实战

具身导航不仅是路径规划问题,更是面向真实物理世界的风险权衡过程。其核心在于对感知、运动、交互和环境四类不确定性进行可计算建模,并将安全、时间、社会信任等多维成本统一量化为可优化的决策依据。成本敏感评估并非简单加权,而是通过风险条件价值(CVaR)、帕累托前沿压缩与联合可行性约束等方法,实现‘在可承受代价下选择最可靠行为’的工程目标。该技术已广泛应用于服务机器人、医疗巡检与智能仓储等高可靠性场景,是当前具身智能从实验室走向复杂开放环境的关键突破。

weixin_30660027的博客 332

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 393

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 221

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 246

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 197

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 199
上一篇: LLM 推理框架之上:10 中常见 LLM 推理系统总结
下一篇: LLM的7种推理框架
普通网友
博客等级 码龄3年 4493粉丝 309原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值