


这箱装满待邮寄信件的盒子是我的问题,而右上角的清单则是解决方案。作为一名热情的 Vote Forward 志愿者,我无法跟踪哪些捆绑包由我的团队中的哪些助手完成。我需要一段 JavaScript 代码来制作一个清单,以便我可以跟踪我们的进度。以下是如何我的 AI 助手 帮助我编写它的。
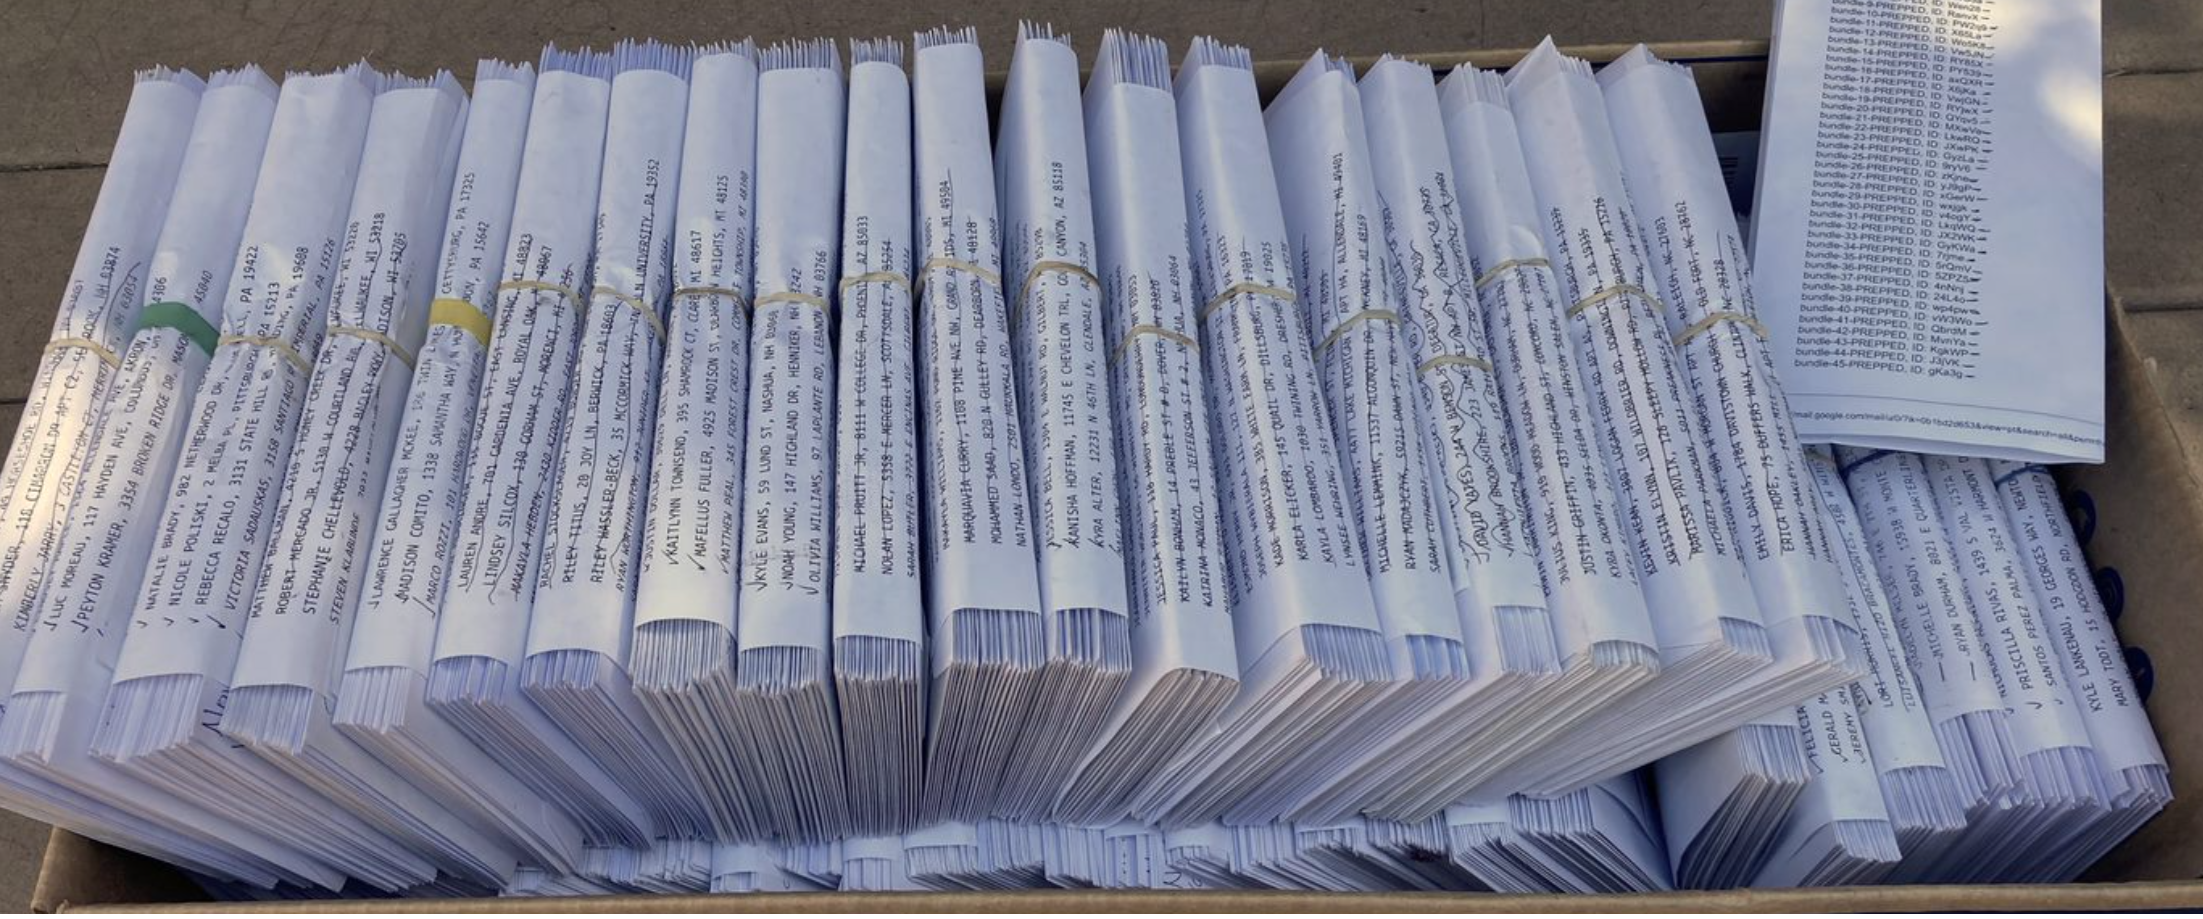
Vote Forward 仪表盘上提供了所有制作清单所需的信息,该仪表盘为未完成和已完成的捆绑包提供信息卡列。
当我有可以用来推动交互的知识和经验,以及当我将问题分解成易于测试的小块时,我才能获得最佳结果。
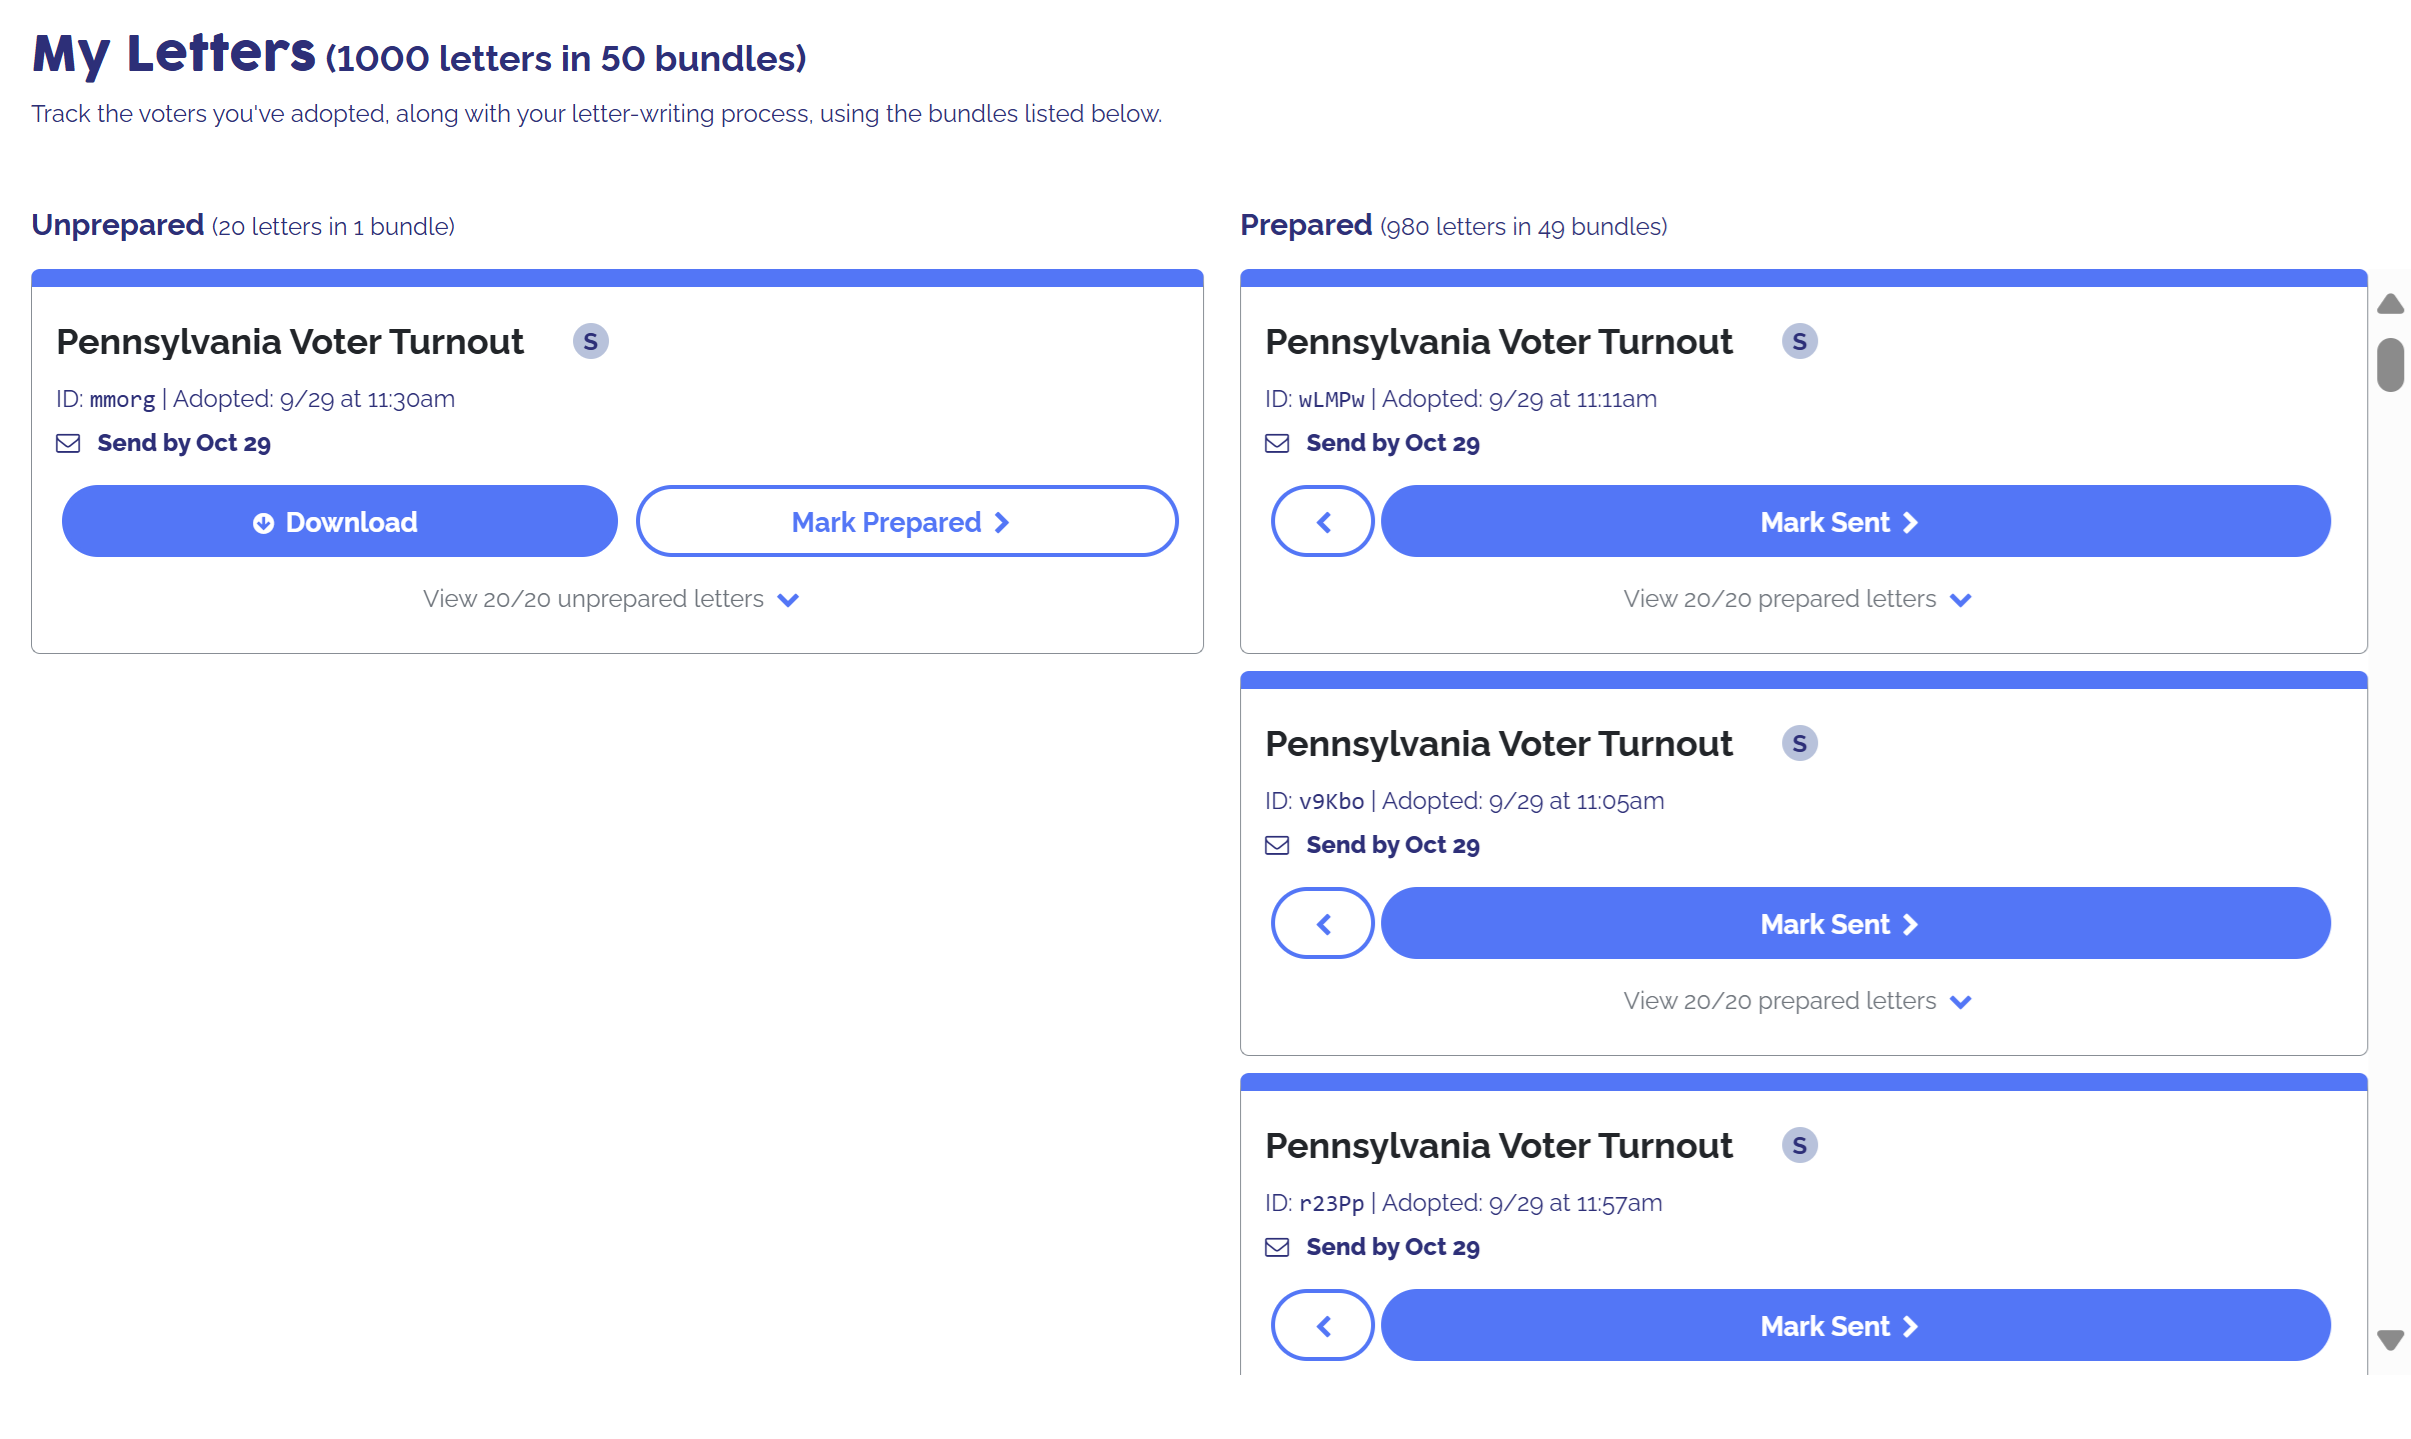
但是,没有简单的方法可以将这些数字信息卡上的捆绑包 ID 与我准备邮寄的信件箱中累积的捆绑包封面上的相同 ID 相匹配。我的 LLM 助手帮助我制作了一个清单来弥合这一信息差距。这项任务不可否认是枯燥的,但许多信息处理工作也是如此。浪费在它们身上的周期越少越好。
以下是仪表盘在网站上的外观。
如果您不熟悉 LLM 辅助编码,您可能会想象这样的提示。
阅读此 HTML 页面并制作一个已准备和未准备捆绑包 ID 的排序列表。ID 是五个字符的字母数字字符串。
但事实并非如此——至少对我来说,现在还没有。当我有可以用来推动交互的知识和经验,以及当我将问题分解成易于测试的小块时,我才能获得最佳结果。首要任务是在页面上找到信息卡,并从中提取两项内容:捆绑包 ID 和状态(未准备或已准备)。这并不难,但这是一项繁琐的任务,我很乐意委托他人完成。
让我们看看 ChatGPT 和 Claude 如何处理此提示。
查找捆绑包 ID 和状态
我们在页面中寻找这些元素。
代码语言:javascript
复制
<li class=”bundle-list-item individual” data-testid=”bundle-0-UNPREPPED”><div class=”row”><div class=”fill-auto campaign-labels-1″><h4 class=”fill-row”>Pennsylvania Voter Turnout</h4></div><div class=”col-auto”><div class=”campaign-labels”><figure class=”campaign-bubble social” title=”social”><span>S</span><div class=”campaign-label fs-8 fw-bold me-2 px-2 text-uppercase rounded-pill social campaign-bubble-label”>Social</div></figure></div></div></div><div class=”row”><div class=”col fill-row”><span class=”adopted-on”>ID: <span class=”font-monospace”> mmorg</span> | Adopted: 9/29 at 11:30am</span></div></div><div class=”row”><div class=”col fill-row fw-bold mail-by-message”><div class=”mail-by-bubble”><span><i class=”fa fa-envelope-o”></i><strong> Send by Oct 29</strong></span></div><div class=”mail-by-label rounded-pill mail-by-bubble-label text-gray”><p><span class=”text-danger”> <span class=”fw-bold”>Send</span> as soon as Sat, Oct 5 but no later than Tue, Oct 29</span></p></div></div></div><div><div class=”row flex-nowrap unprepared”><div class=”col”><div class=”row px-2″><button class=”btn-bundle-status btn-primary-v2 rounded-pill”><i class=”fa fa-arrow-circle-down”></i><span class=”download-message “>Download</span></button></div></div><div class=”col”><button class=”btn-bundle-status btn-secondary-v2 rounded-pill w-100 status-secondary” title=”Mark Prepared from Unprepared”><span class=”bundle-status-message “>Mark Prepared</span><i class=”fa fa-chevron-right”></i></button></div></div><div class=”row”><input class=”slide-out-toggle” id=”toggle-mmorg-UNPREPPED” type=”checkbox”><label class=”letter-info” for=”toggle-mmorg-UNPREPPED”><span class=”text-gray”>View 20/20 unprepared letters</span><i class=”fa fa-chevron-down slide-out-arrow”></i><i class=”fa fa-chevron-up slide-out-arrow”></i></label><div class=”slide-out-list”></div></div></div></li>
输出类似下面的样子。
代码语言:javascript
复制
mmorg UNPREPPED
wLMPw PREPPEDGive me JavaScript code to produce that output.
这种事情对这两个 LLM 来说都是微不足道的。
代码语言:javascript
复制
// claude
function parseHTML() {
    const items = document.querySelectorAll('li.bundle-list-item');
    const results = [];
    items.forEach(item => {
        const idSpan = item.querySelector('span.font-monospace');
        if (idSpan) {
            const id = idSpan.textContent.trim();
            const status = item.getAttribute('data-testid').split('-').pop();
            results.push(`${id} ${status}`);
        }
    });
    return results;
}
function displayResults(results) {
console.log(results.join('\n'));
}


const parsedResults = parseHTML();
displayResults(parsedResults);
此外,在浏览器的控制台中测试这些代码片段也很容易。
查找所有捆绑包 ID 和状态
不过,我们还没有完成。这两个代码片段都返回了相同的不完整结果集。这是因为该网站将两个列表打包在仅部分显示它们的元素中;您必须滚动才能看到超过几个信息卡。以下是一种几乎肯定会失败的方法。
这些列表是不完整的,因为它们出现在滚动元素中。我的展示了整个 HTML 页面,我们如何收集已准备就绪的和还没有准备好的捆绑软件的完整列表?
代码语言:javascript
复制
// claude
async function gatherBundles() {
    // Function to scroll the page to the bottom to trigger loading of new content
    function scrollPage() {
        return new Promise((resolve) => {
            let lastScrollTop = window.scrollY;
            const interval = setInterval(() => {
                window.scrollBy(0, 1000); // Scroll down by 1000px
                if (window.scrollY === lastScrollTop) {
                    clearInterval(interval);
                    resolve(); // Resolving the promise when no further scrolling happens
                }
                lastScrollTop = window.scrollY;
            }, 500); // Adjust scrolling speed if necessary
        });
    }
// Scroll the page to load all bundles
await scrollPage();

// After scrolling, collect the bundles
const bundles = document.querySelectorAll('li.bundle-list-item');
const results = [];

bundles.forEach(bundle => {
    // Extract user ID
    const userId = bundle.querySelector('span.font-monospace').textContent.trim();

    // Extract status from "data-testid" attribute
    const dataTestId = bundle.getAttribute('data-testid');
    const status = dataTestId.split('-').pop();

    // Push the result in the desired format
    results.push(`${userId} ${status}`);
});

// Output the gathered results
console.log(results.join('\n'));

}


// Run the function to gather and log the bundles
gatherBundles();
果然,这两个解决方案都失败了。当我要求两个 LLM 采用不同的方法时,它们就偏离了轨道。回想起来,我可以看到我的语言是如何误导它们的。最初,我也想象了一个需要滚动的解决方案。
幸运的是,我带来了知识和经验。经过反思,我意识到,通过增加列的高度,我可以将所有信息卡暴露给我的脚本。检查页面后,我发现两列捆绑包被包装在使用相对位置和动态计算高度的 div 元素中。这些就是我一直在寻找的东西。为了验证我是否可以找到它们并调整它们的高度以消除滚动条,我要求助手提供另一个我不愿意编写的代码片段。
代码语言:javascript
复制
document.querySelectorAll('div[style]').forEach(div => {
  let inlineStyle = div.getAttribute('style');
  if (inlineStyle.includes('position: relative')) {
    div.style.height = '20000px';
  }
});
对输出进行排序
现在我可以找到所有捆绑包了,我想要对输出进行两级排序:首先按状态(降序),然后按 ID(升序)。以下是我再也不会从头开始编写的代码。
代码语言:javascript
复制
dataList.sort((a, b) => {
    if (a.dataTestId.includes("PREPPED") && b.dataTestId.includes("UNPREPPED")) {
        return 1;  // UNPREPPED comes before PREPPED
    } else if (a.dataTestId.includes("UNPREPPED") && b.dataTestId.includes("PREPPED")) {
        return -1;
    }
    // Sort by ID if they belong to the same category
    return a.id.localeCompare(b.id);
});
我已经无数次使用过这种习惯用法,在 JavaScript、Python 和其他语言中,但这不是我经常做的事情——所以每次重新获取这种方法都会减慢我的速度。我很乐意将这种琐事委托给助手,它会给我一个解决方案,同样,这个解决方案很容易验证。
打包结果以方便使用
当我问 ChatGPT 和 Claude 如何将这段代码提供给其他 Vote Forward 网站用户时,他们都建议将其制作成书签。虽然这种古老的技术仍然可以工作,简直是奇迹,但我自己的知识和经验告诉我,这不是正确的答案。在各种浏览器中解释如何“安装”书签变得越来越困难。而浏览器扩展则过于复杂。遗憾的是,我的结论是,对于像这样的小事,现在你可能只能教人们如何打开浏览器控制台并粘贴代码。
这仍然需要说明,而编写说明又是另一项需要外包的任务。你可以在 这篇博文 中看到 Claude 编写的说明。完全公开:我只在 Chromium 和 Firefox 上测试过,因为我没有 Safari,但这里风险很低,我认为节省时间和精力是值得的。
调整时间
还有一个最后的问题。脚本仍然没有找到页面上的所有信息卡。这又是一个我的知识和经验胜出的案例。当被问及这个问题时,ChatGPT 和 Claude 开始喷出越来越复杂的脚本变体,这些变体无法解决核心问题:时间。我需要另一种古老的技术来克服 JavaScript 的异步性:延迟,让高度调整完成后再处理项目。一旦我意识到这一点,我就可以将脚本交给助手来实现该方法,因为,同样,像 setTimeout 这样的习惯用法是我不常使用的东西,因此我总是需要重新熟悉。
新的成本效益比
当遇到像这样平凡的信息处理工作时,我总是要权衡自动化带来的好处与实现自动化的成本。在这种情况下,我们谈论的是在仪表板上手动搜索捆绑 ID 并将其与盒子中的字母捆绑匹配所需的时间。
如果我完全坦诚地说,我不确定制作清单所需的时间加上使用清单所需的时间是否少于手动完成这项工作所需的时间。但毫无疑问,自动化比以前更快地实现了。此外,它还可以供其他人使用,因此这是一个无法量化的额外好处。无论在这种情况下计算结果如何,很明显,以前不具有成本效益的许多自动化都可以借助这些助手变得具有成本效益。
但这并非必然。有很多方法可以无效地使用 LLM。为了获得最佳效果,请依靠你自己的智慧、经验和创造力。将无聊和例行的工作委托给受严格监督的助手,你可以轻松检查他们的工作。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 320


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


