Llama 3 + LangChain + HuggingFace 实现本地部署RAG(检索增强生成)

基于LLama3、Langchain,Chroma 构建RAG 使用Llama3 Langchain和ChromaDB创建一个检索增强生成(RAG)系统。这将允许我们询问有关我们的文档(未包含在训练数据中)的问题,而无需对大型语言模型(LLM)进行微调。在使用RAG时,首先要做一个检索步骤,从一个特殊的数据库中提取任何相关的文档,本文使用的是《欧盟人工智能法案》文本。 阅读详情

本文介绍如何基于Llama 3大模型、以及使用本地的PDF文件作为知识库,实现RAG(检索增强生成)。

RAG,是三个单词的缩写:Retrieval、Augmented、Generation,代表了这个方案的三个步骤:检索、增强、生成。

基本的步骤是这样的:

  1. \1. 先用本地的各种文件,构建一个向量数据库,做为本地的知识库。
  2. \2. 然后当用户对大模型提问时,先在本地的向量数据库里面查找跟问题相关的内容。这一步叫做Retrieval检索。
  3. \3. 再把从向量数据库中查找到的内容,和用户的原始问题合到一起,作为Prompt发给大模型。这一步叫做Augmented增强。
  4. \4. 最后,大模型会根据prompt返回内容。这一步叫做Generation生成。

道理很简单,但实际用起来,里面会有很多地方需要去仔细的研究、调参。

1. 准备工作

在开始写代码之前,需要先从HuggingFace下载模型文件。我选用的是Meta-Llama-3-8B-Instruct。国内用户可以从hf-mirror.com下载,网络比HuggingFace.co稳定得多。

另外,还需要下载Embeddings模型,用于将文本转为embeddings,然后才能保存到向量数据库,并进行后续的相似性查找。我选用的是微软的multilingual-e5-large-instruct模型。也可以用北大的bge-m3模型。但这两个Embeddings模型的参数和相关度数值会有比较大的差异,需要去试验、调整代码里面的参数。

模型下载之后,需要在本地安装所需的Python库:

$ pip install PyPDF2 transformers langchain langchain_community langchain_huggingface faiss-
cpu

目前,我安装的langchain是0.2.1版本。随着版本的不同,这个库大概率会发生较大的改变,从而导致运行失败。

吐槽一下,langchain这玩意的版本兼容性真是无语的很,然后还拆成一堆的库需要分别安装,莫非他们的KPI是按照PIP所需要安装的数量考核的……

2. 加载/创建向量数据库

现在,可以开始写代码了。

首先,我们需要看看本地的向量数据库是否已经存在。如果存在的话,直接加载、使用;否则的话,则去读取本地的PDF文件、切分文本、然后用切分好的文本和指定的embeddings模型来创建向量数据库:

# Load pdf file and return the text
def load_single_pdf(file_path):
    pdf_reader = PdfReader(file_path)
    if not pdf_reader:
        return None
    
    ret = ''
    for i, page in enumerate(pdf_reader.pages):
        txt = page.extract_text()
        if txt:
            ret += txt

    return ret

# Split the text into docs
def split_text(txt, chunk_size=256, overlap=32):
    if not txt:
        return None
    
    splitter = RecursiveCharacterTextSplitter(chunk_size=chunk_size, chunk_overlap=overlap)
    docs = splitter.split_text(txt)
    return docs

# Save docs to vector store with embeddings
def create_vector_store(docs, embeddings, store_path):
    vector_store = FAISS.from_texts(docs, embeddings)
    vector_store.save_local(store_path)
    return vector_store

# Load vector store from file
def load_vector_store(store_path, embeddings):
    if os.path.exists(store_path):
        vector_store = FAISS.load_local(store_path, embeddings, 
            allow_dangerous_deserialization=True)
        return vector_store
    else:
        return None
    
def load_or_create_vector_store(store_path, pdf_file_path):
    embeddings = create_embeddings()
    vector_store = load_vector_store(store_path, embeddings)
    if not vector_store:
        # Not found, build the vector store
        txt = load_single_pdf(pdf_file_path)
        docs = split_text(txt)
        vector_store = create_vector_store(docs, embeddings, store_path)

    return vector_store
3. 检索

得到向量数据库之后,就可以根据用户的问题,在数据库内进行相关性查找(检索)。

# Query the context from vector store
def query_vector_store(vector_store, query, k=4, relevance_threshold=0.8):
    similar_docs = vector_store.similarity_search_with_relevance_scores(query, k=k)
    related_docs = list(filter(lambda x: x[1] > relevance_threshold, similar_docs))
    context = [doc[0].page_content for doc in related_docs]
    return context

这里,设置了一个relevance_threshold,当查找到的内容的相关度小于这个数值时,则认为无关,即无法从向量数据库里查找到与问题相关的信息。

4. 增强与生成

根据从向量数据库查找到的信息/上下文,可以把这些信息跟用户的输入的问题合到一起(增强),然后一起发给已经加载的大模型(生成)。

def ask(model, tokenizer, prompt, max_tokens=512):
    terminators = [
        tokenizer.eos_token_id,
        tokenizer.convert_tokens_to_ids('<|eot_id|>')
    ]
    input_ids = tokenizer([prompt],
        return_tensors='pt', 
        add_special_tokens=False).input_ids.to(CUDA_Device)
    generated_input = {
        'input_ids': input_ids,
        'max_new_tokens': max_tokens,
        'do_sample': True,
        'top_p': 0.95,
        'temperature': 0.9,
        'repetition_penalty': 1.1,
        'eos_token_id': terminators,
        'bos_token_id': tokenizer.bos_token_id,
        'pad_token_id': tokenizer.pad_token_id
    }

    generated_ids = model.generate(**generated_input)
    ans = tokenizer.decode(generated_ids[0], skip_special_token=True)
    return ans

def main():
    pdf_file_path = './Data/Aquila.pdf'
    store_path = './Data/Aquila.faiss'

    vector_store = load_or_create_vector_store(store_path, pdf_file_path)
    model, tokenizer = load_llm(LLM_Model)

    while True:
        qiz = input('Please input question: ')
        if qiz == 'bye' or qiz == 'exit':
            print('Bye~')
            break

        # Query context from vector store based on question, and compose prompt
        context = query_vector_store(vector_store, qiz, 6, 0.75)
        if len(context) == 0:
            # No satisfying context is found inside vector store
            print('Cannot find qualified context from the saved vector store. Talking to LLM without context.')
            prompt = f'Please answer the question: \n{qiz}\n'
        else: 
            context = '\n'.join(context)
            prompt = f'Based on the following context: \n{context}\nPlease answer the question: \n{qiz}\n'

        ans = ask(model, tokenizer, prompt)[len(prompt):]
        print(ans)

代码里面,事先加载了向量数据库、加载了大模型;然后在while循环里面,不停的让用户输入问题。根据输入的问题,去向量数据库查找相关的上下文。如果查找到了,则合到一起,发给大模型;否则将原始问题发给大模型。

完整的代码请查看:DeepLearning/Llama3_RAG.py at main · yuchuanwang/DeepLearning · GitHub

5. 问题

正如一开始所说的,RAG的道理很简单,但实际用起来,会发现里面有很多的地方需要去调参、研究。

比如说:

切分文本的时候,chunk_size和chunk_overlap取多少合适?

文本转向量时,使用哪个Embeddings模型最佳?

查找问题的相关上下文时,用欧式距离还是别的距离,比如余弦距离还是?

每个Embeddings模型,以多大的的相关度数值做为阈值合适?

如何评估RAG的整体效果?

等等等等……

真的是路漫漫其修远兮!

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
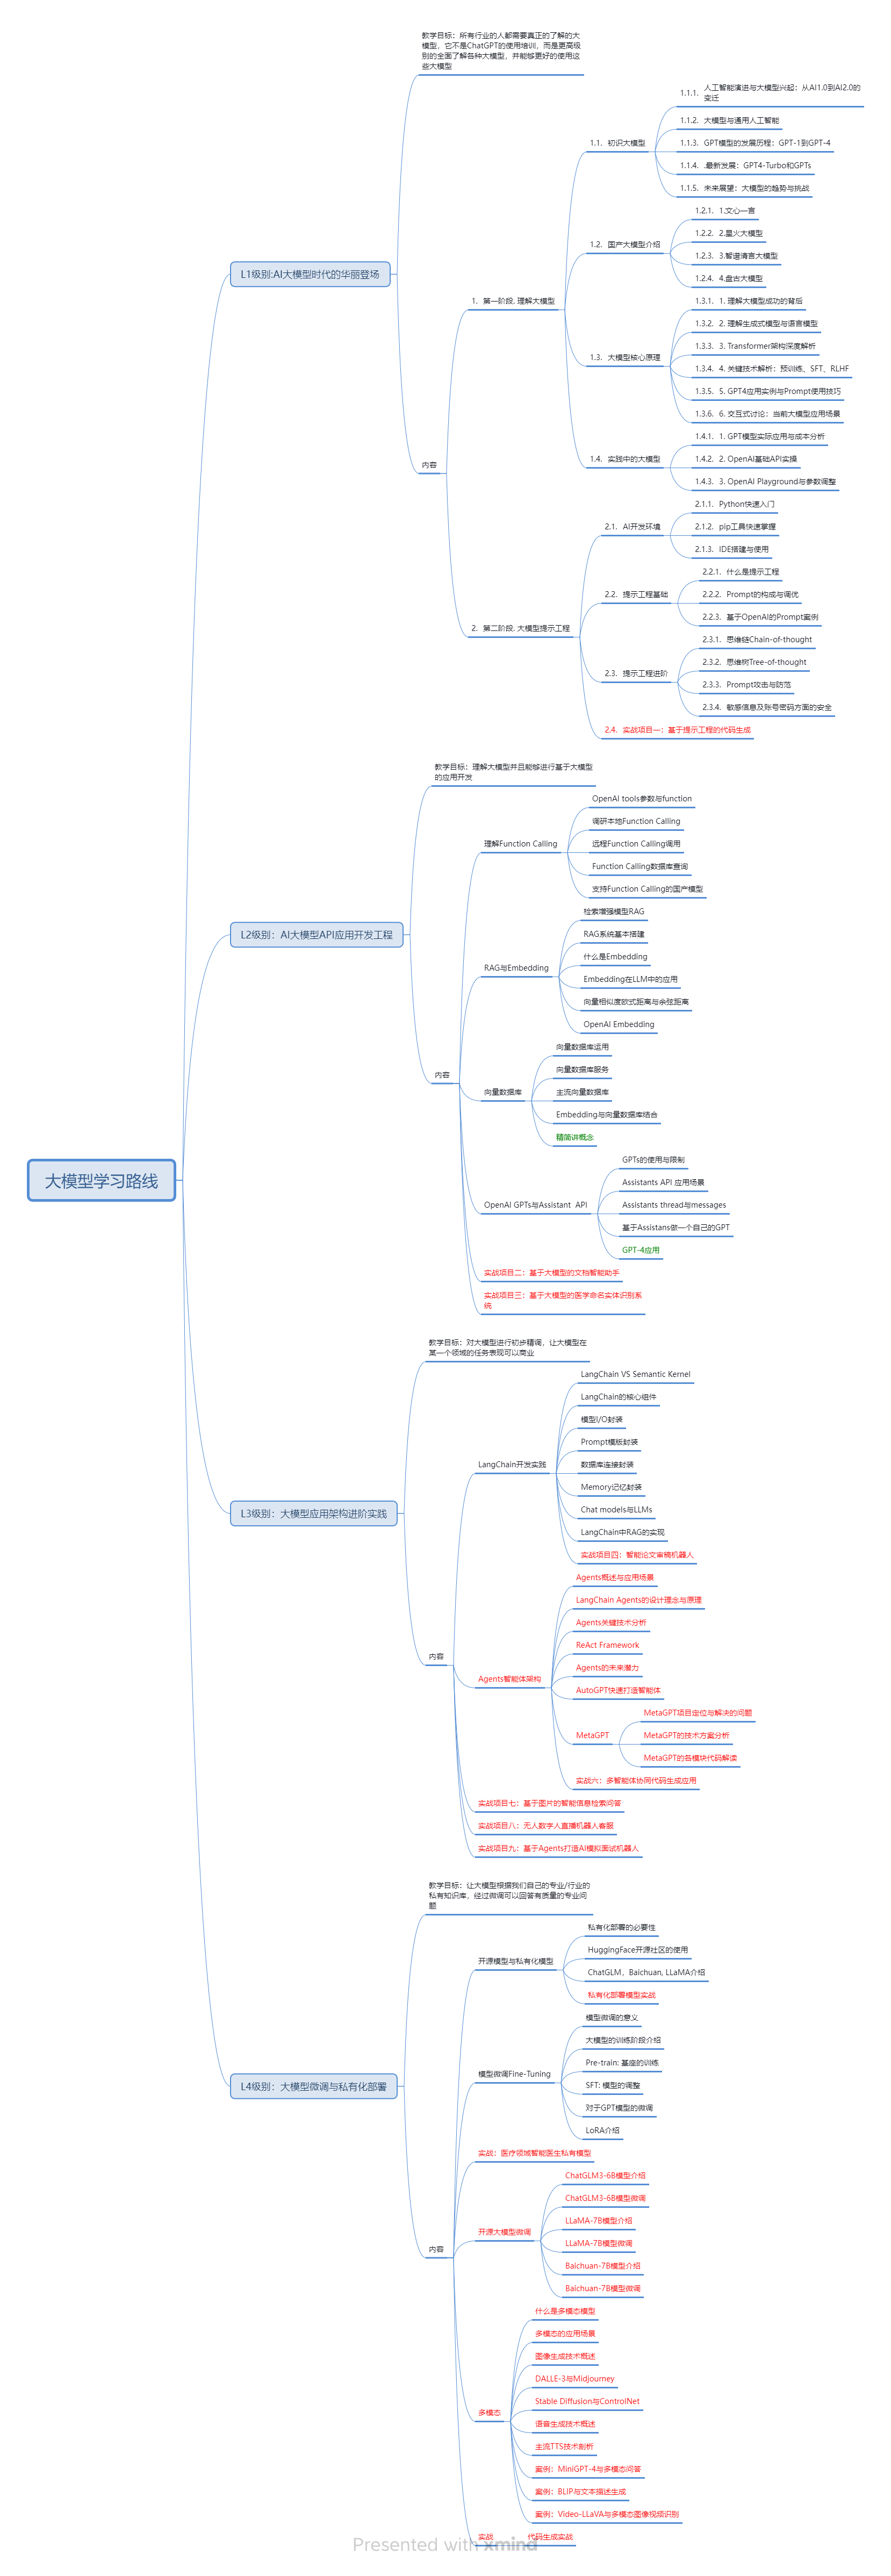
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Llama 3本地部署与RAG应用实战:从模型量化到私有化AI构建 大语言模型(LLM)作为人工智能的核心技术,通过海量数据预训练和Transformer架构,实现了强大的自然语言理解和生成能力。其技术价值在于能够作为通用基础模型,通过微调适配各类下游任务,显著降低AI应用开发门槛。在工程实践中,为了在有限资源下高效部署,模型量化与本地推理成为关键技术,其中GGUF格式和llama.cpp工具链已成为开源社区标准。同时,检索增强生成(RAG)架构通过结合外部知识库,有效缓解了模型幻觉问题,成为构建企业级知识问答系统的核心方案。本文聚焦Meta最新开源的Llama 3模型,详 阅读详情

相关推荐

Colab手撸RAG:从零实现检索增强生成全流程

RAG(检索增强生成)是一种将外部知识库与大语言模型动态结合的关键技术,其核心在于检索器、生成器与上下文融合管道的协同工作。原理上依赖语义向量空间对齐、高质量分块与精准重排序,技术价值体现在降低幻觉、提升事实准确性及支持私有知识实时更新。典型应用场景包括企业知识库问答、法律/医疗文档辅助决策、教育资料智能检索等。本文聚焦资源受限环境下的工程落地,基于 Google Colab 免费 T4 GPU,详解如何不依赖 LangChain 等高级框架,手动实现 bge-m3 嵌入、FAISS 向量索引、BM25+F

weixin_34288121的博客 377

在windows 11本地搭建RAG数据查询的AI大模型环境

其中,基于检索-生成器(Retrieval-Augmented Generation,简称RAG)架构的数据查询模型备受关注,因为它能够结合从大规模文本语料库中检索信息和生成自然语言文本的能力,实现更加智能和准确的数据查询。1. 下载 Docker Desktop:首先,打开浏览器,访问 Docker 官方网站(https://www.docker.com/products/docker-desktop),在该页面上找到适用于 Windows 的 Docker Desktop 安装程序,并点击下载。

ainnle的专栏 5634

开源大模型实战指南:从LLaMA部署到RAG应用开发

Transformer架构作为现代大语言模型的核心,通过自注意力机制和前馈网络等组件实现了强大的序列建模能力。其技术价值在于为自然语言处理任务提供了统一的框架,推动了AI技术的民主化进程。在实际应用中,开发者常面临模型部署、资源优化和领域适配等工程挑战。针对这些需求,以LLaMA为代表的开源模型生态提供了可行的解决方案,结合LoRA微调技术和RAG检索增强生成框架,能够在有限算力下实现高效的模型定制与应用开发。本文聚焦于开源大模型的实战落地,详细拆解了从环境搭建、模型量化到微调优化的全流程,并深入探讨了如何

weixin_30696427的博客 410

Hugging Face全攻略:轻松下载Llama 3模型,探索NLP的无限可能!【实操】

Hugging Face平台提供了海量的预训练模型,包括顶尖的Llama 3模型。本文将详细介绍如何从Hugging Face下载Llama 3模型到本地。

xiaoh_7的博客 1万+

Meta押注开源大模型:Llama本地部署与RAG应用实践指南

大模型的落地方式直接影响企业AI应用的架构设计与成本结构。当前主流选择主要分为两类:一类是调用闭源API,快速但数据需离开本地;另一类是部署开源模型,数据可控且可定制。深度学习技术发展至今,开源与闭源路线的能力差距已显著缩小,Meta近期的公开发声更是将这一议题推向高潮。从技术原理来看,开源模型的核心价值在于开放权重与可私有化部署,配合Ollama、vLLM等工具链,开发者能快速在本地GPU环境运行Llama系列模型。通过本地部署流程、RAG检索增强生成以及LoRA微调路径,企业可以构建数据安全、成本可控的

weixin_33985507的博客 986

RAG原理与工程落地:从检索增强到企业级知识系统

RAG(检索增强生成)是一种将信息检索与大语言模型生成能力协同的技术范式,其核心在于通过外部知识源实时补充模型的静态参数化知识,从而缓解幻觉、提升答案可追溯性与业务适配性。技术原理上,它依赖文档预处理、向量检索、上下文注入与受控生成四阶段闭环;工程价值体现在低成本迭代、知识实时更新与结果可验证三大优势;典型应用场景覆盖企业内部知识库问答、工业设备诊断、合规文档检索及技术文档智能助手等。本文聚焦中文技术文档场景下的RAG全流程实践,涵盖PDF解析、语义分块、bge-m3向量化、混合检索与引述式Prompt设计

weixin_30902251的博客 313

基于 LlaMA 3 + LangGraph 在windows本地部署大模型 (一)

基于LlaMA 3 + LangGraph 在windows本地部署大模型 (一)RAG 是未来人工智能应用的基石。大家并不是在寻求仅仅产生无意义反应的人工智能。而目标是人工智能能够从特定文档集中检索答案,理解查询的上下文,指导自己搜索其嵌入内容或在必要时诉诸网络搜索,评估自身响应的有效性以防止幻觉,并最终根据 提供的文档提供类似人类的答案进行Langchain 及其相关功能所需的基本模块和库的安装。

大模型与Agent智能体 4435

从零搭建个人AI智能体:本地部署、RAG与LangChain实践指南

大语言模型(LLM)作为当前人工智能的核心技术,通过理解与生成自然语言,为构建智能应用提供了基础。其工作原理基于Transformer架构,通过海量数据预训练获得通用语言理解能力。在工程实践中,检索增强生成(RAG)技术通过结合外部知识库,有效解决了模型幻觉与知识更新滞后的问题,显著提升了回答的准确性与时效性。向量数据库作为RAG的关键组件,负责存储和高效检索文本的向量化表示。基于这些技术,开发者可以构建私有化、定制化的AI应用,例如常驻个人AI智能体。这类智能体能够7x24小时在线,结合本地知识库与工具调

weixin_34008933的博客 306

【LLM大模型】AI小白使用Macbook Pro安装llama3与langchain初体验

上次在Macbook Pro上安装了Stable Diffusion,体验了本地所心所欲地生成各种心仪的图片,完全没有任何限制的惬意。今天想使用Macbook Pro安装一个本地大语言模型体验一下,刚好在2024年4月18日,Meta在官网上宣布公布了旗下最新大模型Llama 3,并开放了80亿(8b)和700亿(70b)两个小参数版本,据说能力显著提升。遂开干。

2301_81940605的博客 4618

本地部署Llama 3.1:从零构建私有AI助手完整指南

大语言模型(LLM)通过其强大的自然语言理解和生成能力,正在深刻改变人机交互方式。其核心原理基于Transformer架构,通过海量数据预训练和指令微调,使其能够理解和遵循人类指令。这一技术价值在于将通用人工智能能力平民化,为开发者、研究人员和个人用户提供了前所未有的定制化AI工具。在应用场景上,LLM已从云端API服务扩展到本地私有化部署,满足了数据安全、网络独立和深度定制的需求。本文聚焦于Meta最新开源的Llama 3.1模型,详细解析如何在消费级硬件上,利用Transformers库和4-bit量化

weixin_34210740的博客 379

Neo4j+LangChain构建图增强RAG系统实战

知识图谱是一种以节点和边显式表达实体及其关系的结构化知识表示方法,其核心原理在于通过语义建模实现可解释、可推理的知识组织;相比向量检索的模糊匹配,图谱能精准支持多跳关系查询与逻辑链推演,显著提升复杂问答的准确率与可审计性;在合规审查、供应链分析、研发溯源等强逻辑依赖场景中,图谱已成为RAG系统突破‘答案差点意思’瓶颈的关键技术路径;本文聚焦Neo4j原生图数据库与LangChain框架协同落地的工程实践,涵盖三元组抽取、Cypher路径查询、混合检索路由等真实可复现环节。

weixin_30307921的博客 690

LangChain+Llama3 实现LLM本地部署并通过文档实现RAG

使用git下载时(需要提前安装lfs),可能会遇到lfs下载大文件失败,可以在其余文件下载完成后,进入下载模型的主目录单独下载每一个大体积权重文件,命令如下。所需模型均可以在huggingface官网上找到源代码,其余包可以根据自身需要按官方所给名称分别安装。*.xxx表示权重文件的后缀名,差什么就下什么。实现代码如下,具体注释有空再补(相关依赖见。下载模型的镜像文件,也许会有些许滞后。

assassins123的博客 1296

(22-3-01)基于RAG的法律法规解析系统(Llama3+Langchain+ChromaDB):构建欧盟人工智能法案问题的RAG(1)

这个PDF 文件可以用于构建检索增强生成(RAG)系统中的检索组件,例如,可以将文档被分割成更小的块,然后转换为向量并存储在向量数据库中,如 ChromaDB,以便于快速检索。分割后的文本块可以用于构建检索增强生成(RAG)系统中的检索组件,例如将它们转换为向量并存储在向量数据库中,以便于快速检索和生成与查询相关的回答。构建本RAG系统的基本步骤如下所示。(2)检索器(Retriever):实现一个检索器,它能够理解用户的查询并将它与向量数据库中的文档进行匹配,以检索出相关的文档片段。

码农三叔 1497

huggingface模型本地部署

本文全面介绍了HuggingFace模型本地部署的6种主要方式:1)原生Transformers方式适合开发者深度定制;2)Pipeline快速推理适合原型验证;3)SentenceTransformer专为RAG向量模型设计;4)vLLM提供工业级API服务;5)GGUF量化实现低资源部署;6)Ollama提供类ChatGPT体验。针对GIS智能体开发,作者建议分三阶段实施:先用Transformers+BGE搭建基础框架,再升级vLLM服务化,最后结合PostGIS实现空间增强。全文提供了每种方式的具体

wujianyouhun的专栏 733

项目66:基于AI实现RAG问答

它的核心思想是:在生成回答之前,先从知识库中检索相关信息,然后基于这些信息生成回答。今天我们来探讨RAG(检索增强生成)技术——这是当前最热门的AI应用架构之一,能让AI回答更加准确和可靠。代码展示了一个简单的RAG问答系统。实际应用中,可以使用LangChain框架和Chroma等向量数据库构建更强大的RAG系统。​ 这是一种简单有效的文本相似度计算方法,实际应用中会使用更复杂的向量模型如Sentence-BERT。​ 直接让LLM回答可能产生幻觉,结合检索到的信息可以保证回答的准确性和可验证性。

weixin_51988935的博客 1044

2025小红书跳转卡片实战指南:从零搭建独立后台与自动化发卡系统

本文提供了一份2025年小红书跳转卡片的实战搭建指南,详细解析了独立后台系统的核心架构与自动化发卡流程。文章从零开始,手把手教你使用Node.js、Vue.js等技术栈构建包含后台管理、用户制卡中心与前端交互的完整系统,旨在帮助运营者实现合规引流,并掌握数据自主权与自动化运营能力。

weixin_29234423的博客 518

llama.cpp与GGUF本地部署实战:从Llama-server到RAG问答系统

大模型应用正从云端向本地化演进,这一过程中,模型格式与推理引擎的选择成为关键。GGUF作为社区主流的模型存储格式,将权重、分词器与超参数封装为单文件,结合量化技术能显著降低部署门槛;而llama.cpp作为高性能C++推理引擎,支持CPU/GPU混合运行,配套的llama-server提供OpenAI兼容HTTP API,让本地模型可被业务系统无缝调用。基于这些基础能力,开发者可以用FastAPI集成向量检索,搭建RAG知识库问答系统,实现数据不出内网、回答可溯源的企业级应用。本文从零讲解llama.cpp

ciqiaofu0192的博客 315

PHP证书图片生成

$realname = "姓名"; $schoolname = "学校"; $idcard = "身份证号"; $image = imagecreatefrompng('certification.png'); // 证书模版图片文件的路径 $red = imagecolorallocate($image,00,00,00); // 字体颜色

4037

【LangChain】langchain_huggingface.HuggingFaceEmbeddings:基于Hugging Face的 Transformer 的嵌入(embedding)模型类

langchain_huggingface.HuggingFaceEmbeddings是 LangChain 提供的一个嵌入(embedding)模型类,用于将文本转换为向量表示,基于 Hugging Face 的 Transformer 模型。核心功能包括:方法:embed_query(查询嵌入)、embed_documents(批量嵌入)。参数:model_name(模型选择)、model_kwargs(设备)、encode_kwargs(归一化)。使用方式:初始化 Hugging Face 模型,生成

彬彬侠的博客 3141

kaggle——销量预测的baseline(M5 Forecasting - Accuracy)

前言 在刚刚结束的kaggle比赛M5 Forecasting - Accuracy中,因为是第一次参加,笔者也是花了大量的时间和精力在上面,最终拿到一块银牌(所以我拿到了大学第一个考试挂科。。。求求电磁场老师高抬贵手给点平时分放我一马吧。。。早上看到kaggle成绩异常兴奋,中午考完直接爆炸=。=),当然运气占了很大因素,这次比赛private leadboard的shake up非常大,排名波动几千名都存在的。笔者运气不错,是向上的shake:)。这里总结一下销量预测的基本流程。 从下图可以看到这次比

weixin_43901221的博客 5433

2026滑块验证码终极实战:缺口检测算法+人机轨迹模拟,识别率从60%飙升至95%全方案

**摘要:2026年AIGC技术发展导致传统验证码失效,滑块验证码成为主流防护手段。本文深入分析了传统方案识别率低的原因,并提出多级检测融合和行为拟合优化方案。通过图像预处理优化、三级缺口检测引擎(差分图像法、Hu矩轮廓匹配、YOLOv8n模型兜底)将识别率提升至99.2%。同时针对轨迹模拟环节,设计了包含抖动特征、时间随机性和个体差异的行为模型,使通过率从12%提升至87%。该方案解决了传统方法在缺口定位精度和轨迹真实性方面的核心痛点,为应对新一代验证码风控提供了完整的技术框架。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1902
上一篇: 利用 coze + agent 落地企业级 AI 知识库方案
下一篇: 基于PyTorch的大语言模型微调指南:Torchtune完整教程与代码示例
少喝冰美式
博客等级 码龄3年 6847粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值