边缘端大模型是怎么部署的?重点关注哪些?

大模型在边缘部署可行吗?一文解析边缘AI的落地路径 边缘AI是指在靠近数据源的边缘设备(如摄像头、传感器、移动设备、边缘服务器)上,部署人工智能算法实现本地推理、数据处理与决策反馈的技术。相比传统云端AI,它具备低延迟、高实时性、隐私性强等优势。大模型,尤其以GPT、BERT、LLaMA等为代表的预训练模型,具有超强的泛化能力,但也伴随着参数量大、资源需求高、推理耗时长等问题。将这类模型直接部署在边缘设备上几乎不现实,因此轻量化与本地适配成为关键方向。随着硬件算力持续提升、模型压缩技术日益成熟,大模型“下沉”到边缘已逐步从理论走向现实。 阅读详情
AI摘要

本文围绕利用移动边缘智能(MEI)优化大语言模型(LLMs)展开。介绍了LLMs与MEI的基础知识,探讨资源高效的LLMs技术,展示网络边缘部署LLMs的应用场景,深入分析MEI4LLM的缓存、训练和推理等方面,还指出研究方向,并分享了AI大模型学习资料。

写在前面

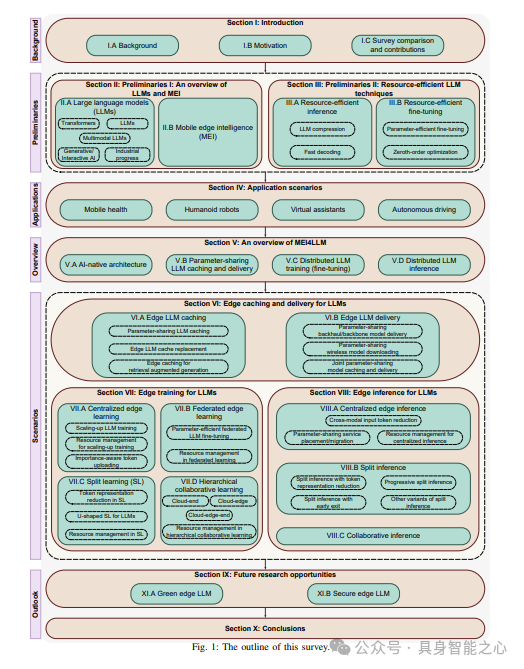
在设备端运行的大语言模型(LLMs),即指在边缘设备上运行LLMs,因其出色的隐私保护、低延迟和节省带宽的特点而引起了广泛关注。然而,与功能更为强大的云中心相比,设备端LLMs的能力本质上受到边缘设备有限容量的制约。为了弥合基于云端的AI与设备端AI之间的鸿沟,移动边缘智能(MEI)提供了一个可行的解决方案,它通过在移动网络边缘提供AI能力,相较于云计算,在隐私保护和延迟方面都有所改善。MEI位于设备端AI和基于云端的AI之间,具备无线通信功能,且计算资源比终端设备更为强大。本文提供了关于利用MEI来优化LLMs的当代综述。首先,我们介绍了LLMs的基础知识,从LLMs和MEI讲起,接着讨论了资源高效的LLMs技术。然后,我们通过几个关键应用实例,展示了在网络边缘部署LLMs的必要性,并介绍了面向LLMs的移动边缘智能(MEI4LLM)的架构概览。随后,深入探讨了MEI4LLM的各个方面,广泛涵盖了边缘LLMs的缓存与分发、边缘LLMs的训练以及边缘LLMs的推理。最后,指出了未来的研究方向。本文旨在激励该领域的研究人员利用移动边缘计算,促进LLMs在用户附近的部署,从而在各种注重隐私和低延迟的应用场景中发挥LLMs的潜力。

一些介绍

大型语言模型(LLMs)的部署远比传统深度神经网络(DNNs),如卷积神经网络(CNNs)更加资源密集,这是将LLMs推向网络边缘的主要障碍。本综述文章旨在从资源高效部署的角度,包括网络边缘的存储效率、计算效率和通信效率,对当前这一融合趋势,即移动边缘智能(MEI)与LLMs,进行当代综述。

本文与先前关于高效LLM训练/微调及推理的综述文章有所不同。这些文章大多聚焦于提高计算效率,却忽视了通信对LLM训练、推理、缓存及分发的影响,这在移动边缘网络中是一个显著的瓶颈。

本文也与现有的关于LLM边缘部署的综述文章/论文存在差异。这些文章探讨了通过云边协同实现LLM赋能的AI服务提供,但并未讨论资源高效的部署方案,如参数高效的微调、分割推理/学习、高效的LLM缓存及分发,以及它们与无线边缘网络的相互作用。

最后,值得注意的是,本综述文章与关于“LLMs用于网络”的论文在本质上不同,后者的设计目标是利用LLMs来优化边缘网络,而不是利用边缘计算来支持LLMs。与相关综述文章/论文的对比见表I。本文的主要贡献概括如下:

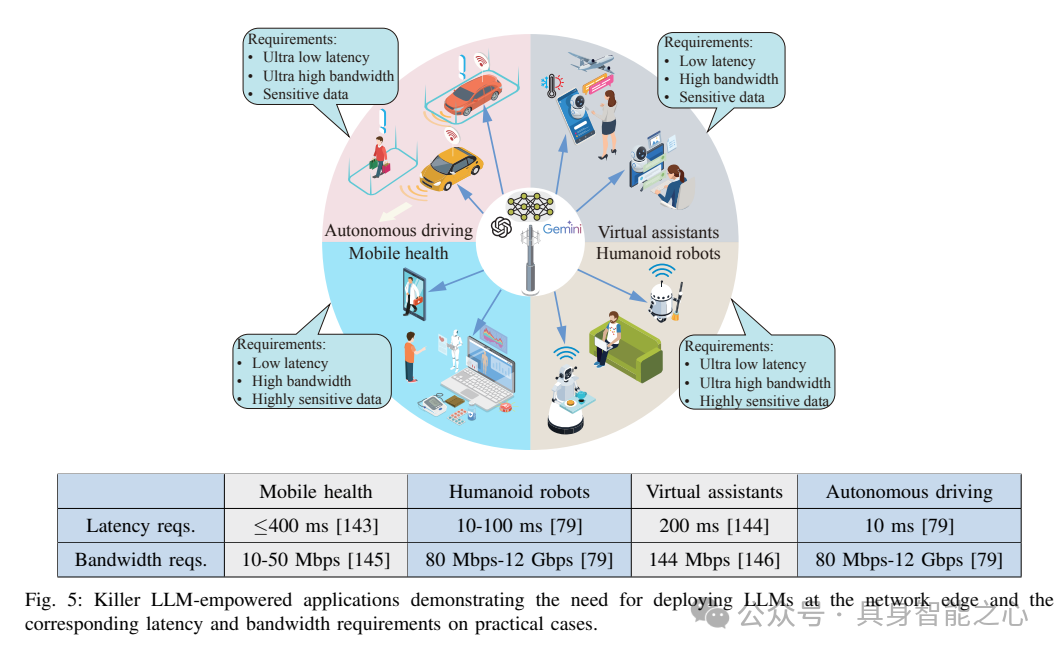
  • 介绍了推动大型语言模型(LLMs)在网络边缘部署的应用场景。尽管LLMs的应用案例已在其他地方得到广泛讨论,但我们将基于这些应用的服务需求,强调在移动边缘提供这些应用的必要性或益处。
  • 首次全面调查了6G边缘网络如何促进LLM的缓存与分发、训练及推理,包括边缘LLM的缓存与分发、边缘LLM的训练以及边缘LLM的推理。将特别关注LLM的资源高效部署,以提高网络边缘LLM的存储、通信和计算效率。
  • 指出了LLMs与移动边缘智能融合的几个关键研究方向,包括面向LLMs的绿色边缘AI和安全边缘AI。

大语言模型(LLMs)与移动边缘智能(MEI)概述

最新的相关综述汇总:
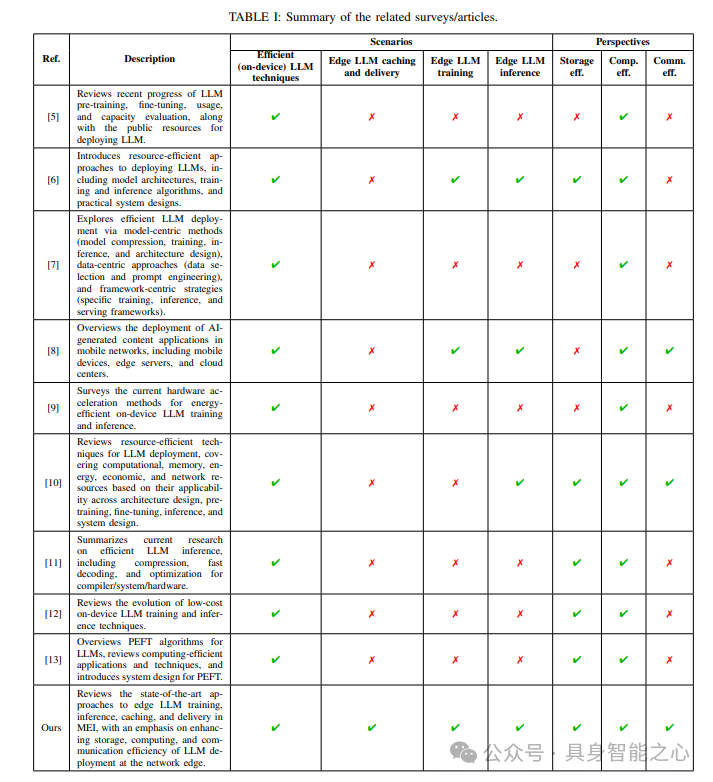
图片

图片

移动边缘智能(MEI)已成为一种将人工智能与移动边缘计算相结合的有前途的范式,彻底改变了移动服务和应用的格局。MEI的发展源于多种技术进步的融合,包括物联网(IoT)设备的普及、移动网络的部署以及人工智能算法的成熟。这些发展使得MEI能够克服传统以云为中心的架构的局限性,通过在网络边缘提供本地化的AI训练/推理和数据处理能力。

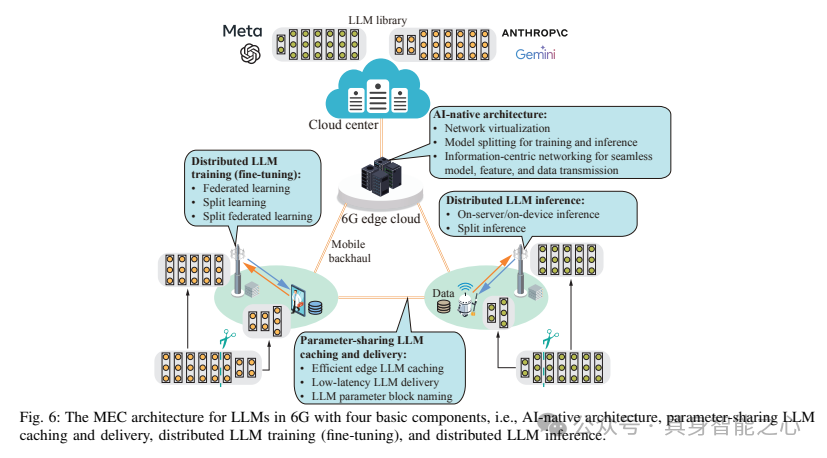
通过整合人工智能(AI)与通信技术,移动边缘智能(MEI)框架使移动网络能够提供超越通信的服务,为万物智联奠定了坚实基础。在此背景下,“集成AI与通信”的应用案例已被纳入6G国际移动通信(IMT)框架建议中。在标准化方面,电信标准化组织3GPP和国际电信联盟(ITU)分别在各自的白皮书中描绘了边缘智能的前景。ITU-3172基于机器学习(ML)应用对延迟的敏感要求,阐明了在网络边缘托管ML功能的必要性。在3GPP发布的5G标准化第18版中,MEI旨在支持分布式学习算法、拆分AI/ML以及高效的AI模型分发。接下来将详细阐述具体内容。首先,边缘网络将全面支持边缘学习,如联邦学习,这使得边缘服务器能够从多个分布式边缘设备聚合模型更新和知识,从而提高AI/ML模型的性能。其次,在5G边缘网络上拆分AI/ML可以促进在具有相互冲突需求(如计算密集型、能耗密集型、隐私敏感型和延迟敏感型需求)的设备上部署AI应用。例如,在边缘拆分推理中,AI模型被划分为子模型,其中计算密集型和能耗密集型的子模型被卸载到5G边缘服务器(如基站)。边缘服务器可以使用边缘侧的子模型和从边缘设备上传的中间数据进行推理。最后,高效的AI模型下载确保了当边缘设备需要适应新的AI任务和环境时,能够以低延迟将AI模型传输到边缘设备。例如,当驾驶环境发生变化时,自动驾驶车辆需要在1秒内从5G边缘服务器下载一个新的AI模型。为了将基于网络的AI算法集成到5G网络中,MEI框架需要满足边缘服务器与边缘设备之间高速稳定数据链路的需求。这些链路可以确保持续以高且稳定的上行数据速率将中间数据/模型更新上传到边缘服务器,并在需要时以高下行数据速率突发下载AI模型到边缘设备。此外,MEI的核心是利用数据源靠近边缘计算设备(如智能手机、笔记本电脑和可穿戴设备)的优势,使智能决策更接近数据源。这种分布式计算范式相较于传统的集中式架构具有诸多优势,包括降低延迟、提高带宽利用率、保护数据隐私以及增强对网络故障的韧性。

在应用方面,移动边缘智能(MEI)在多个领域如智慧医疗、自动驾驶和智慧城市等都有着重大影响。例如,在医疗领域,MEI能够实现对患者健康数据的实时监控,并在紧急情况下促进及时干预。同样,在智慧城市中,MEI有助于智能交通管理、环境监测和能源优化,从而推动可持续发展并提升生活质量。边缘智能也见证了显著的工业进步,特别是随着边缘计算技术的普及和5G网络的到来。微软、谷歌、亚马逊和英伟达等领军企业已经开发了边缘AI平台,以支持实时AI服务。对于边缘AI赋能的物联网应用,微软的“Azure IoT Edge”、谷歌的“Cloud IoT”、亚马逊的“Web Services IoT”以及英伟达的“EGX”等平台提供了边缘AI解决方案,为从实时视频分析、智能家居到工业物联网的广泛应用带来了实时AI服务。

显然,MEI4LLM不过是MEI(移动边缘智能)的一个特例。然而,在边缘训练和部署大量大型语言模型(LLM)的需求可以成为推动MEI发展的关键因素。一方面,下一代MEI的原则,包括推动AI与通信的全面融合,与边缘LLM的需求高度契合。另一方面,LLM对资源的极端需求推动了MEI的边界拓展。具体而言,MEI4LLM必须具备以下特点:1)原生支持模型拆分和跨互联边缘节点的并行训练/推理,以促进超大规模模型的部署;2)无线网络和资源高效LLM训练/推理技术的集成设计,如参数高效微调和token(表征)减少,以使LLM部署具有成本效益。本质上,与传统MEI相比,MEI4LLM主要关注探索资源管理和高效AI技术的集成设计,以在有限的通信-计算资源下支持LLM。

资源受限的LLM技术
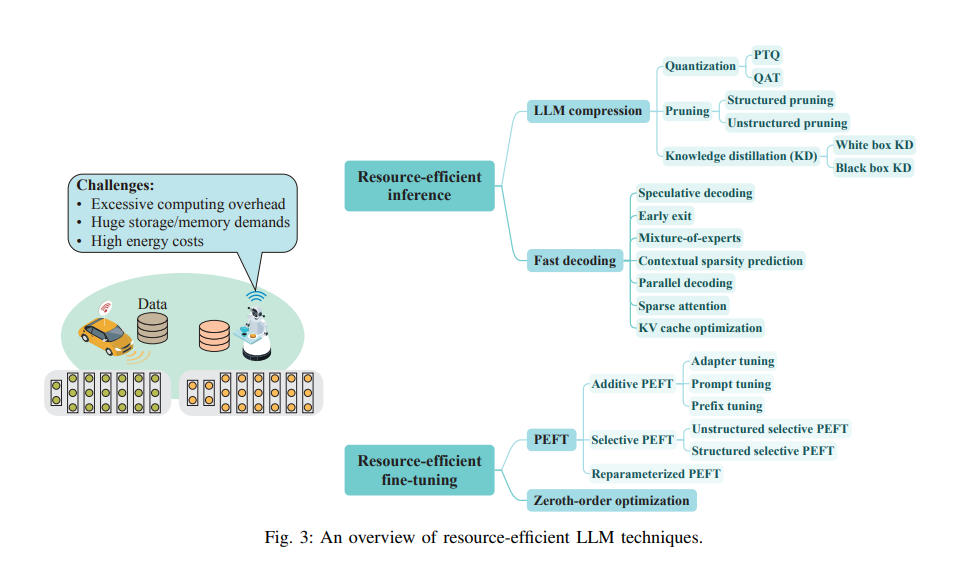
图片

图片

资源有限的fine-tuning

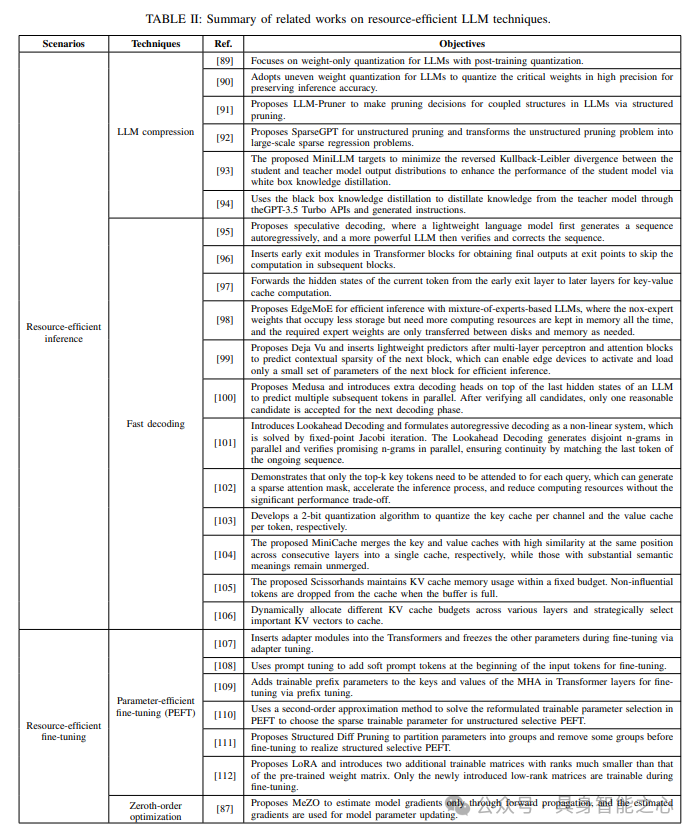
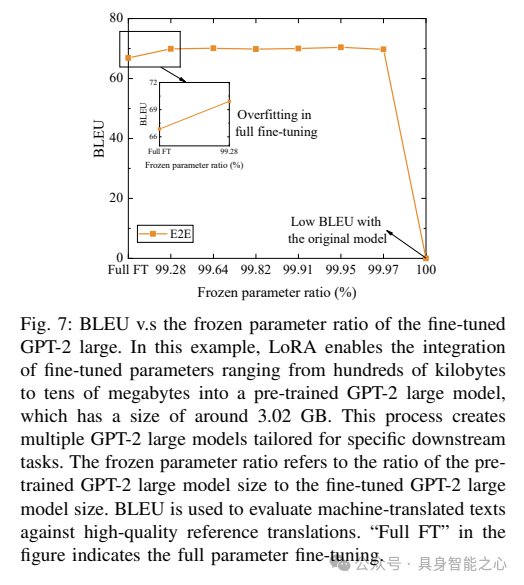
与推理相比,设备上大型语言模型(LLM)的训练需要显著更高的内存和计算资源。例如,计算LLM OPT-13B的梯度所需的内存是推理所需内存的12倍。然而,由于LLM微调所需的计算资源远少于全参数训练,因此在设备上部署LLM时广泛采用了LLM微调。

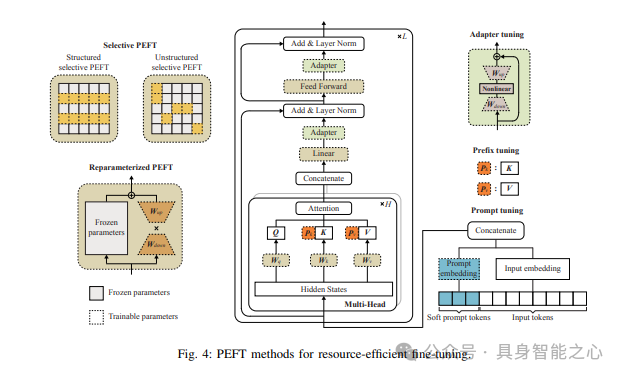
参数高效微调:参数高效微调(PEFT)已成为LLM微调的一个显著解决方案,它通过在微调过程中仅更新少数参数来实现。流行的PEFT技术可以分为三种主要类型,即加法PEFT、选择性PEFT和再参数化PEFT,下面将详细阐述这些类型。
图片

零阶优化:零阶优化是一种新颖的模型训练技术,它仅通过前向传播来估计梯度更新。这种方法大大减轻了计算负担,因为前向传播(相当于推理)所需的计算资源远少于训练过程中的反向传播。具体来说,与流行的一阶优化器(如Adam)相比,零阶优化器无需在训练过程中存储反向传播的中间结果,从而显著降低了大型语言模型(LLM)训练中的内存消耗。

应用场景
图片

MEI4LLM概述与应用

图片

LLM的边缘缓存与传输

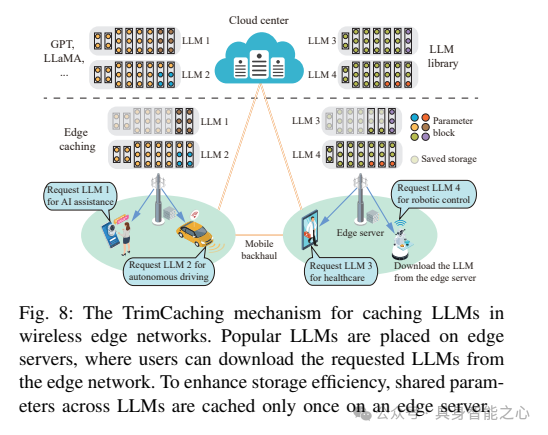
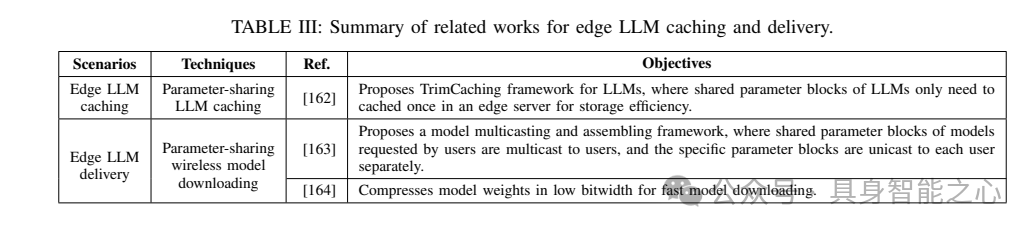
边缘LLM缓存与传输在LLM的训练和推理中都扮演着不可或缺的角色,是边缘LLM部署的基石。与传统的边缘服务/内容缓存与传输相比,边缘LLM缓存与传输的主要区别在于利用了LLM中普遍存在的参数共享性,旨在提高边缘网络的存储和通信效率。虽然传统深度神经网络(DNN)中也可能存在参数共享性,但由于PEFT技术的广泛应用,参数共享性在LLM中更为普遍且重要,这需要我们特别关注其设计。

1) Edge LLM Caching

边缘模型缓存可以通过提前将AI模型分发到无线边缘服务器来实现低模型下载延迟。与用于计算卸载的服务放置不同,边缘模型缓存侧重于缓存AI模型,以便从边缘服务器下载到终端用户。AI模型缓存的设计目的是在服务质量(QoS)要求范围内为更多用户提供模型。这种范式使用户能够直接从边缘服务器获取AI模型,而不是访问远程云数据中心,从而避免了过高的下载延迟。然而,实施边缘LLM缓存面临几个挑战:1)LLM缓存的存储空间有限:服务提供商旨在尽可能多地在边缘服务器上放置流行的LLM,以提高缓存命中率并降低用户的模型下载延迟。然而,LLM的巨大体积对其在边缘服务器上的存储构成了重大挑战;2)LLM边缘缓存(替换)成本高:随着时间的推移,之前缓存的LLM可能不再符合不断变化的用户需求。为了解决这一问题,服务提供商可能会替换边缘服务器上的LLM,以更好地适应最新的请求。但是,这些大规模模型的放置会导致巨大的通信开销,并对移动回程网络造成沉重负担。接下来,将介绍参数共享模型缓存,以应对上述挑战。
图片

图片

图片

2)Edge LLM Delivery

从缓存位置将模型传输到终端用户的关键步骤是高效延迟的模型传输。这一过程包括回程/骨干网内的模型路由和通过无线接入链路进行的模型下载,面临着以下挑战:1) 过高的回程/骨干网传输延迟:当请求的LLM(大型语言模型)未缓存在相关边缘服务器上时,LLM需要在边缘网络内进行路由。然而,与传统AI模型相比,LLM的模型尺寸要大得多。因此,LLM的路由需要在回程流量适中的边缘服务器之间进行;2) 显著的无线下载延迟:AI模型的下载需要低延迟,以满足终端用户的QoS(服务质量)要求。如3GPP所设想,自动驾驶应用要求AI模型的下载在1秒内完成。然而,LLM庞大的模型尺寸阻碍了快速下载,使其极难满足严格的服务延迟要求。这要求采取以下解决方案。
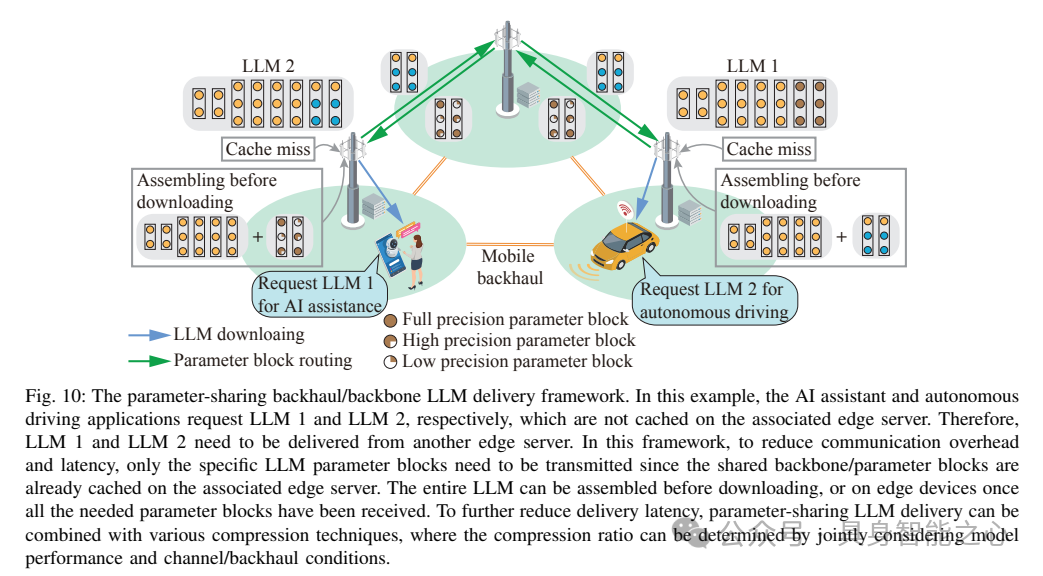
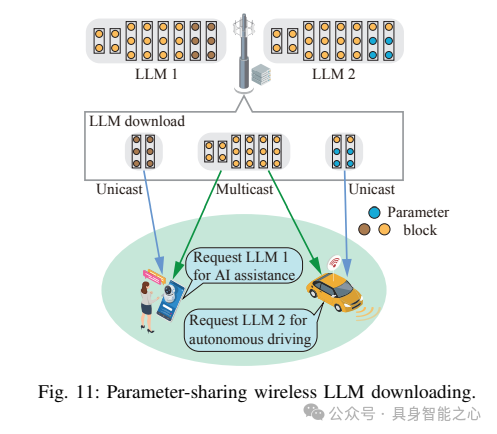
图片

图片

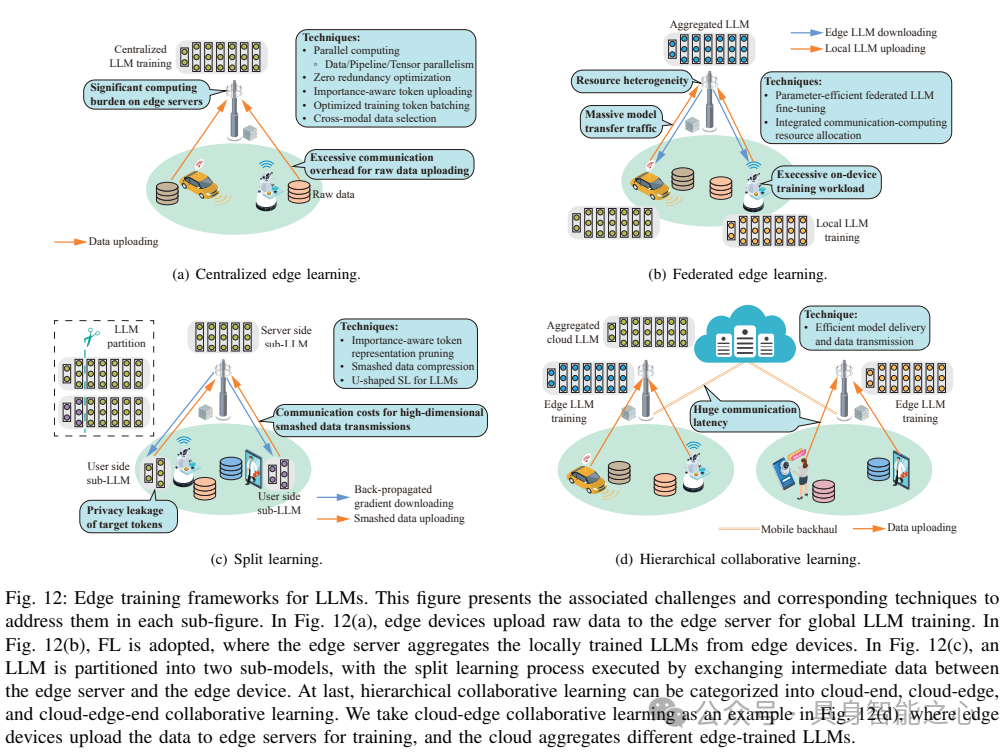
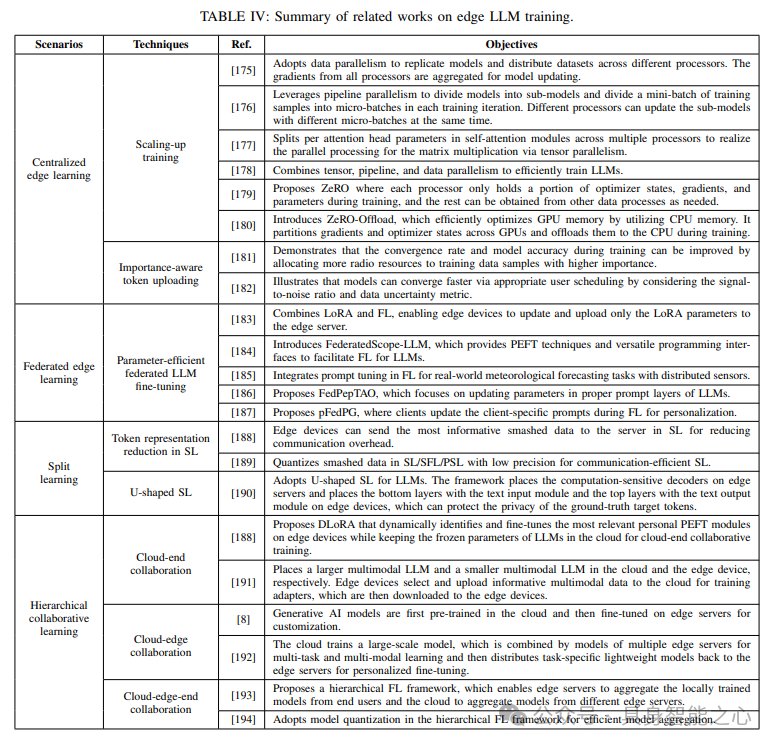
LLMs的边缘训练

图片

图片

边缘端的LLMs推理

边缘LLM(大型语言模型)推理利用边缘计算,基于训练良好的LLM为终端用户提供推理服务。边缘LLM推理与传统边缘推理框架的主要区别在于,它利用LLM的特性(如多模态性、参数共享性和自回归过程)来加速推理过程。边缘LLM推理可分为三种框架:集中式边缘推理、分割推理和协作推理。
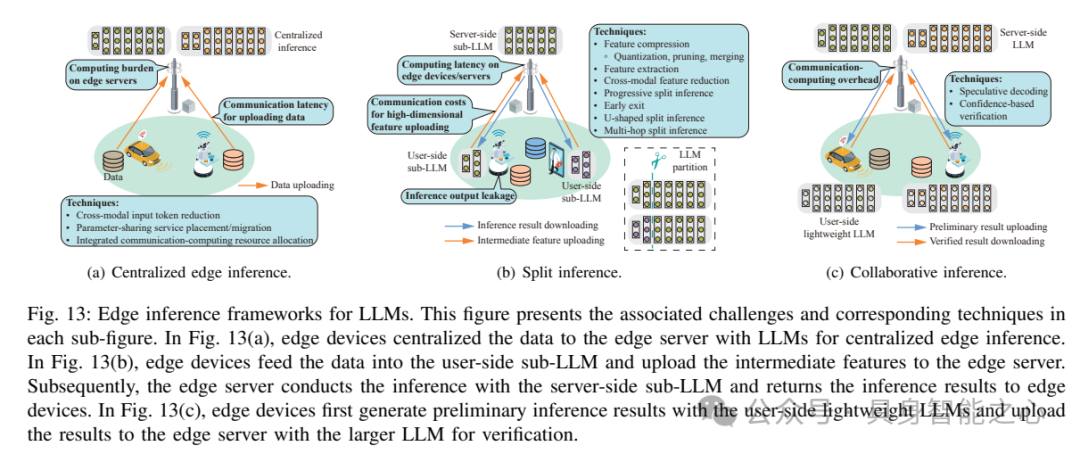
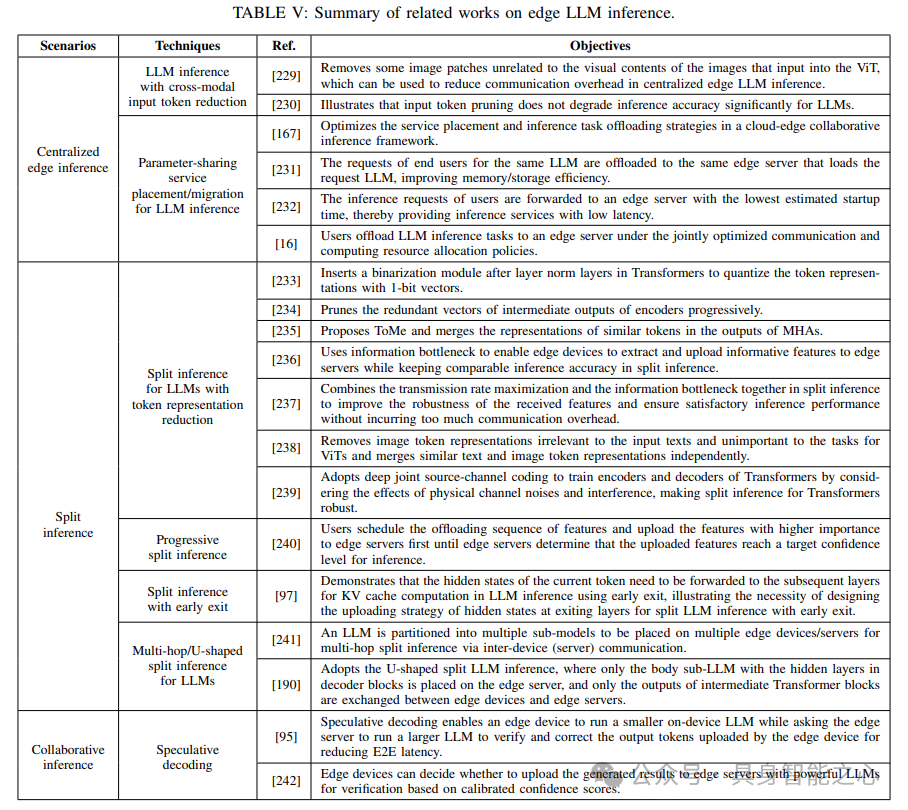
图片

图片

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

边缘大模型:去中心化的算力与控制 当前大多数大语言模型(LLM)应用都部署在中心化云环境中,随之带来延迟、隐私和能耗等方面的担忧。本文探讨将大模型推向边缘的潜力与挑战:边缘计算使处理更靠近数据产生源,在智能手机、物联网设备等终端上运行模型,从而获得更低延迟、更好隐私和更高鲁棒性。文中也会概述去中心化带来的优势(如隐私增强、用户可控、系统韧性),以及量化、剪枝、知识蒸馏、模型分区、混合架构、分布式推理与联邦学习等技术如何在资源受限的边缘设备上实现高效推理。 阅读详情

相关推荐

物理AI从数字世界走向物理世界:算力、大模型与人才体系的重构

物理AI正成为人工智能从信息处理迈向生产力工具的关键拐点,其核心在于让模型在真实物理环境中实时决策与稳定执行。这要求边缘推理芯片提供低延迟、高能效的算力支撑,同时多模态大模型需融合视觉、触觉与语言信号,实现感知-动作闭环。在工业质检、服务机器人、自动驾驶等场景中,物理AI通过仿真预训练与真实微调结合,逐步解决sim-to-real迁移难题。2026人工智能设计赛的启动,进一步推动具身智能与边缘部署方向的人才培养,加速AI从屏幕走向物理世界的进程。

weixin_30985047的博客 281

边缘大模型(Large Models)推理加速

混合专家(Mixture of experts, MoE)是一种增加大模型能力的重要技术,例如在Mixtral-8x7B Large Language Model (LLM)中就用到了这种技术。研究团队发现MoE大模型在推理时具有很强的(1)稀疏性和(2)时间局部性。具体来说,每次进行推理时,MoE模型只有不到10%的参数参与了运算,而剩下的90%都处于闲置状态;并且这种稀疏性会在一定时间或者domain保持稳定。

azuna的小屋 1258

边缘计算:算力下沉、端边云架构与AI部署实战

边缘计算作为算力下沉的关键模式,通过将AI推理能力部署到数据源头附近,以端边云协同架构解决云端决策带来的延迟、带宽与隐私问题。文章从算力为何要迁移至边缘切入,系统阐述端边云三层架构的分工逻辑,并围绕模型轻量化、推理引擎选配、硬件算力评估及场景化部署流程展开详解,结合工业质检、智能终端等真实案例,剖析落地中的工程难点与避坑经验。边缘计算正成为AI规模化应用的重要支撑,理解其原理与选型方法,能帮助技术团队更高效地构建实时、安全、低成本的智能系统。

weixin_32075843的博客 296

【大模型技术探索 | 01】边缘设备部署大模型可能性测试

本文探索了大模型部署到边缘设备平台的可能性。随着LLAMA.cpp的火热,大模型部署到边缘设备成为可能,手机自带大模型、工业控制设备自带大模型交互、智能汽车大模型交互成为可能。经过量化的大模型部署到边缘设备是可能的,对内存的要求要高于CPU,内存至少要2GB内存,4核Contex-AG35跑起来没啥压力,都没跑满。未来边缘设备可能是混合AI大模型:轻量的大模型任务在边缘设备上跑,重型的大模型任务在云上跑。双端部署大模型,既满足实时性,又满足性能要求。

机器未来的博客 2795

边缘AI/ML部署实战:从模型转换到端侧推理完整指南

边缘计算与人工智能的结合正加速推动物联网设备本地化智能。理解训练与推理的差异,是掌握边缘AI/ML的基础——训练依赖云端大算力,而推理则需在资源受限的终端设备上高效运行。为了让模型适配低功耗硬件,模型优化技术如量化、剪枝与知识蒸馏不可或缺,它们能在保持精度的同时大幅缩减体积和延迟。以轻量级目标检测模型YOLOv8n为例,通过ONNX中间格式转换,再借助ONNX Runtime推理框架,开发者即可在普通开发板上完成实时物体识别。这类边缘推理方案在工业质检、智慧安防、预测性维护等场景中拥有广阔应用。本文从部署链

weixin_34248023的博客 393

第六章:AI大模型的部署与应用6.2 模型部署6.2.2 边缘设备部署

1. 背景介绍 随着人工智能技术的快速发展,AI模型在各个领域的应用越来越广泛。然而,随着模型规模的增大,部署和应用这些模型变得越来越具有挑战性。特别是在边缘设备上,由于计算能力和存储空间的限制,部署大型AI模型变得更加困难。因此,如何在边缘设备上有效地部署和应用AI大模型成为了一个重要的研究课题。 本文将详细介绍边缘设备上AI大模型的

AI天才研究院 413

大模型工程化部署:边缘设备部署入门

大模型边缘部署入门指南 本文系统介绍了大模型在边缘设备上的工程化部署方法。主要内容包括: 核心概念:阐明了大模型边缘部署的关键术语和技术内涵,涉及模型部署、性能优化、系统架构等维度。 技术架构:提出分层架构设计,从应用层到底层基础设施,完整覆盖API网关、模型服务、推理引擎等关键组件。 实现原理:通过Python代码示例展示了模型加载、文本生成等核心功能实现,包含精度控制、设备管理等工程细节。 性能评估:定义了推理延迟、吞吐量等关键指标,为部署方案选择提供量化依据。 最佳实践:强调模型量化、动态批处理等技术

编程世界如山海,探索不止。 7259

Unity游戏开发实战:手把手教你用C#实现一个简单的反向运动学(IK)控制器

本文详细介绍了在Unity游戏开发中如何使用C#实现一个简单的反向运动学(IK)控制器。通过建立骨骼层级结构、实现CCD算法和角度限制,开发者可以轻松创建自然的角色动画效果。文章还提供了可视化调试工具和性能优化方案,帮助提升开发效率。

weixin_42523711的博客 244

大模型工程化部署:边缘计算与云协同部署

大模型工程化部署:边缘计算与云协同部署摘要 本文系统探讨了大模型在边缘计算与云计算协同环境下的工程化部署方案。首先分析了当前大模型部署面临的挑战,包括计算资源需求、延迟敏感性和隐私安全等问题。然后提出了一种分层架构设计,将模型推理任务智能分配到边缘节点和云端,实现计算资源的最优配置。关键技术包括模型量化剪枝、动态卸载机制、分布式推理框架等,通过实验验证了该方案在降低延迟(平均减少42%)、节省带宽(峰值减少65%)方面的显著优势。最后总结了边缘-云协同部署的最佳实践,为工业界大模型落地提供了可行的技术路径。

编程世界如山海,探索不止。 1万+

ubuntu18.04美化主题(完整版)

和网上的美化一样,但是我当初跟着博客美化的时候遇到一些问题,按博客的做法无法解决。 所以我自己也写一篇关于ubuntu18.04美化主题的博客。 第一步:安装主题工具:GNOME Tweaks sudo apt-get update sudo apt-get install gnome-tweak-tool 然后安装完成后我们打开Tweaks(截图如下): 第二步,修改窗口按钮位...

B丶atty的博客 7万+

Langchain分割方式

【代码】Langchain分割方式。

2896

实战揭秘|魔搭社区 + 阿里云边缘云 ENS,快速部署大模型的落地实践

大模型部署流程、配置及效果验证全归纳。

阿里云CloudImagine 1516

【2026年米哈游春招 - 3月14日 -第一题- 行列相等】(题目+思路+Java&C++&Python解析+在线测试)

摘要 本文解决了一个矩阵行列和匹配问题:统计矩阵中行和等于列和的所有行列对数量。算法首先计算每行和每列的元素和,然后利用哈希表统计各行列和的出现次数。通过遍历列和并查询对应的行和出现次数,高效计算出匹配对数。该方法时间复杂度为O(nm),空间复杂度为O(n+m),适用于大规模矩阵数据。代码实现了Python、Java和C++版本,通过哈希表优化避免了暴力枚举,显著提高了计算效率。

m0_73659489的博客 83

【2024实战】大模型轻量化部署全指南:从技术选型到边缘端落地

模型轻量化部署是解决大模型在低资源环境中高效运行的关键技术路径,本文系统梳理轻量化部署全流程,涵盖技术选型、跨平台实施、性能优化及行业落地经验,帮助技术团队在有限资源条件下实现大模型的高效部署。 ## 轻量化部署核心挑战 🔍 **核心问题**:如何在算力受限环境(如边缘设备、嵌入式系统)中平衡模型性能与资源消耗? 大模型轻量化部署面临三大核心矛盾: 1. **性能与效率的平衡**:模型压缩

gitblog_00412的博客 965

PyTorch深度学习实战(3)——使用PyTorch构建神经网络

PyTorch 是一个用于构建深度神经网络的库,具有灵活性和可扩展性,可以轻松自定义模型。在本节中,我们将使用 PyTorch 库构建神经网络,利用张量对象操作和梯度值计算更新网络权重,并利用 Sequential 类简化网络构建过程,最后还介绍了如何使用 save、load 方法保存和加载模型,以节省模型训练时间。

盼小辉丶的博客 8万+

基于STM32的智慧农业大棚监测与控制系统设计与实现

摘要:本文设计了一种基于STM32F103C8T6单片机的智慧农业大棚监测与控制系统,集成多参数环境监测、智能控制和远程管理功能。系统可实时采集光照、CO2、温湿度和土壤湿度等参数,通过OLED显示并采用双模式控制机制:自动模式下根据阈值调节设备,手动模式下支持APP或按键控制。通过ESP8266模块接入机智云平台实现数据云存储和远程控制。测试表明系统具有高精度(温度±0.5℃、CO2±50ppm)、快速响应(<2s)和稳定运行(30天无故障)等特点,有效解决了传统大棚调控不及时等问题。创新点包括多参

3254968421的博客 485

Ubuntu22.04下RK3588边缘主板端推理运行Qwen大模型

首先开发者使用RK3588板端的 Hugging Face下载的Qwen2等原始大模型是不能直接运行,原因在于,Hugging Face提供的是原始PyTorch模型,而RK3588的NPU只能识别经过Rockchip优化后的RKLLM模型格式。因此,部署流程中必须借助RKLLM工具链完成模型转换和部署。RKLLM主要由两个部分组成:

luluningmeng1的博客 186

基于毫米波雷达的智能风扇算法设计与实现

摘要:本文设计了一种基于毫米波雷达的智能风扇控制系统,采用FMCW雷达实现人体目标的精准检测与定位。系统通过距离FFT、速度FFT、CFAR检测和AoA估计构建完整的信号处理链路,并针对风扇叶片干扰设计了基于自相关函数的抗干扰算法。创新性地提出了人在开机、多人优先送风、摇头追踪等控制策略。研究采用MATLAB完成全链路算法仿真验证,并在STM32平台上实现实物系统。实验表明,该系统可实现0.15m测距精度和±60°方位角覆盖,有效解决了传统风扇的能源浪费和用户体验问题。本文提供了完整的MATLAB仿真代码和

huanghm88的专栏 404

为什么越来越多企业开始做本地大模型部署?——边缘AI时代已经来了

很多人第一次听到边缘AI,会觉得这个概念非常复杂。其实可以简单理解为:让设备自己拥有AI能力。以前:AI能力属于服务器。未来:AI能力属于设备本身。例如:AI盒子。AI工业平板。AI机器人。AI摄像头。AI玩具。自助终端。边缘计算服务器。它们都属于边缘AI设备。边缘AI最大的特点就是:数据在哪里产生,AI就在哪里完成计算。这样不仅提升了响应速度,也降低了网络依赖。AI行业正在经历一次重要的计算架构迁移。过去,我们习惯于把AI能力集中放在云端。

2601_96343834的博客 573

廉价却有效?ESD防护中的电容

摘要:在成本敏感型电子产品设计中,多层陶瓷电容(MLCC)可作为TVS二极管的替代方案用于静电放电(ESD)防护。其工作原理是通过电容充放电特性吸收静电能量,而非电压钳位。计算表明100nF/50V MLCC可有效缓冲8kV静电冲击,但存在吸收能量有限、无自恢复等局限。建议将MLCC作为一级缓冲措施,配合TVS等器件形成多级防护,并优先选择X7R材质、100nF容值、50V耐压的0402/0603封装MLCC。该方案在低速信号和电源引脚防护中具有显著成本优势,但不能完全替代专业ESD抑制器。

硬核科技 430

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

端侧大模型:手机、芯片本地运行AI

本文系统介绍了端侧大模型技术在手机和芯片本地运行AI的核心概念与发展。文章首先阐述了该技术的重要性,指出其已成为AI领域的关键发展方向。随后详细解析了端侧大模型的基本定义、技术架构和核心算法,包括Transformer架构、模型优化和推理加速技术。 在实践应用方面,文章分析了企业服务和个人应用两大场景,提供了从需求分析到开发实施的具体步骤。技术演进历程显示,端侧大模型正从云端向边缘设备快速迁移,2024年后进入多模态和Agent应用爆发期。 本文为读者构建了完整

未来 95% 的 AI 应用将变得隐形,广泛融入日常生活。 2772

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

AI大模型为什么开始跑到边缘设备上?——本地大模型部署正在成为新的行业趋势

过去,我们习惯于把 AI 放在云端。今天,我们开始思考 AI 是否能够部署到边缘设备。而未来,我们讨论的将会是:如何让每一台设备都拥有自己的智能。AI 大模型的发展方向,不仅仅是参数越来越大,更重要的是如何真正实现产业落地。从云端智能,到边缘智能,再到终端智能,本地大模型部署正在成为下一代 AI 产品的重要发展趋势。或许未来几年,我们不会再讨论“设备是否支持 AI”,而是会默认:所有智能设备,都应该拥有属于自己的 AI 能力。

2601_96343834的博客 393

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

LLM量化部署实战:GPTQ、AWQ与边缘端推理方案

随着大模型应用从云端向边缘端延伸,模型量化部署成为2026年最受关注的技术方向之一。在移动设备、IoT终端和嵌入式系统上运行大模型,量化几乎是唯一可行的路径。本文将深入对比主流量化方法,并给出端到端的部署实践方案。

yonggeit的博客 608

MiniCPM-V:如何在端侧设备上部署超高效的多模态大模型?

MiniCPM-V是一款专为端侧设备设计的口袋级多模态大语言模型,能够在手机等资源受限设备上实现高效的图像和视频理解。该项目由OpenBMB团队开发,通过创新的架构设计和优化的部署方案,让强大的多模态AI能力真正触手可及。 ## 为什么选择MiniCPM-V? 在AI模型日益庞大的今天,如何在资源有限的端侧设备上运行复杂的多模态模型成为开发者面临的主要挑战。MiniCPM-V通过以下核心优势解

gitblog_00234的博客 912

直击行业痛点!端侧模型部署的成熟解决方案有了!

深度学习经过多年发展,AI已经深入人心,事实上,在图像、文本领域,AI在多个产业已经落地了诸多应用,我们熟知的自动驾驶、语音助手,背后就大量运用了AI技术。当下,飞桨PaddlePaddl...

夕小瑶科技说 2683

2025年AI边缘计算趋势:Youtu-2B端侧部署入门必看

本文介绍了如何在星图GPU平台上自动化部署🚀 Youtu LLM 智能对话服务 - Youtu-2B镜像,快速构建端侧AI对话能力。该轻量级大语言模型专为边缘设备优化,适用于工控机、自助终端等离线场景,典型应用包括本地化智能客服、嵌入式代码辅助与实时技术问答,兼顾隐私安全与低延迟响应。

weixin_29050829的博客 219
上一篇: 双非本 985 硕,上岸快手大模型算法岗!面试面经|大模型面试八股含答案
下一篇: 一书讲透LLM大语言模型,《掌握大型语言模型》,看完我都懵了!
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值