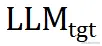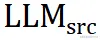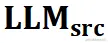训练开销骤减,10%成本定制专属类GPT-4多模态大模型

BLIP-2 官方库学习 BLIP-2通过在冻结的预训练图像编码器和大型语言模型(LLM)之间训练一个轻量级的12层Transformer编码器,利用它们,在各种视觉语言任务中实现最先进的性能。最值得注意的是,BLIP-2在可训练参数减少54倍的零样本VQAv2上比Flamingo(800亿参数模型)提高了8.7%。本文提出了 BLIP-2,这是一种通用且高效的预训练策略,可从现成的冻结预训练图像编码器和冻结大型语言模型 引导视觉语言预训练【hidden_size(int,可选,默认为1408)——编码器层和池器层的维度。 阅读详情

最近的多模态(对话)大模型将基于文本的 ChatGPT 的强大能力扩展到了多模态输入,实现强大的多模态语义理解,比如 GPT-4、BLIP-2、Flamingo 等。但对于很多研究者来说,训练一个多模态 GPT 代价非常昂贵。本文来自新加坡国立大学和清华大学的研究者提出了一个名为 VPGTrans 框架,以极低成本训练高性能多模态大模型。
图片

本工作亮点摘要:

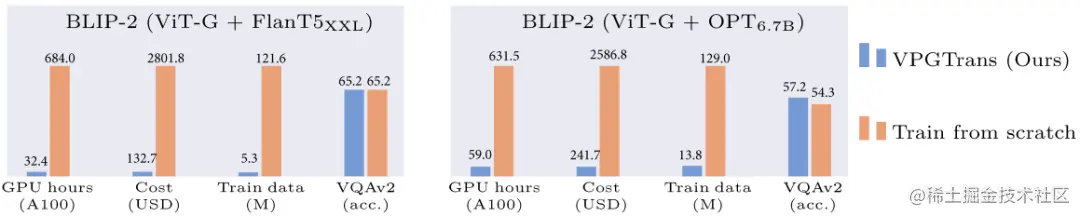
  1. 极低训练成本:通过我们提出的 VPGTrans 方法,可以快速 (少于 10% 训练时间) 将已有的多模态对话模型的视觉模块迁移到新的语言模型,且达到类似或更优效果。比如,相比于从头训练视觉模块,我们可以将 BLIP-2 FlanT5-XXL 的训练开销从 19000 + 人民币缩减到不到 1000 元:
图片

图 1:基于我们的 VPGTrans 方法的 BLIP-2 训练开销缩减对比
2. 多模态大模型定制:通过我们的 VPGTrans 框架可以根据需求为各种新的大语言模型灵活添加视觉模块。比如我们在 LLaMA-7B 和 Vicuna-7B 基础上制作了 VL-LLaMA 和 VL-Vicuna。
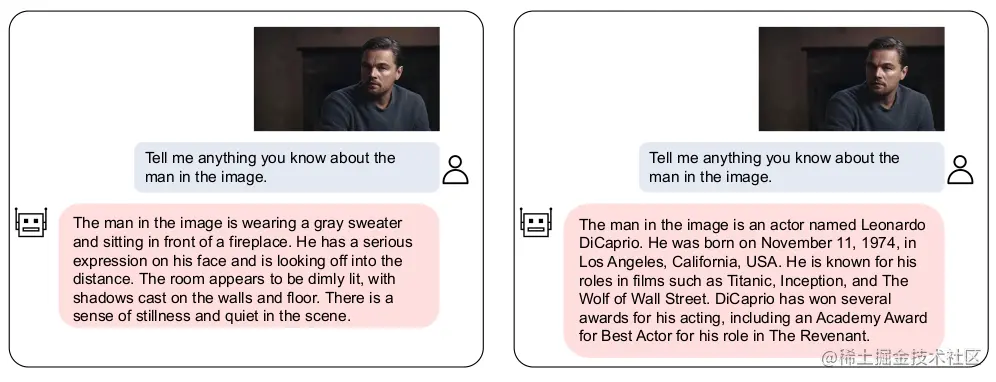
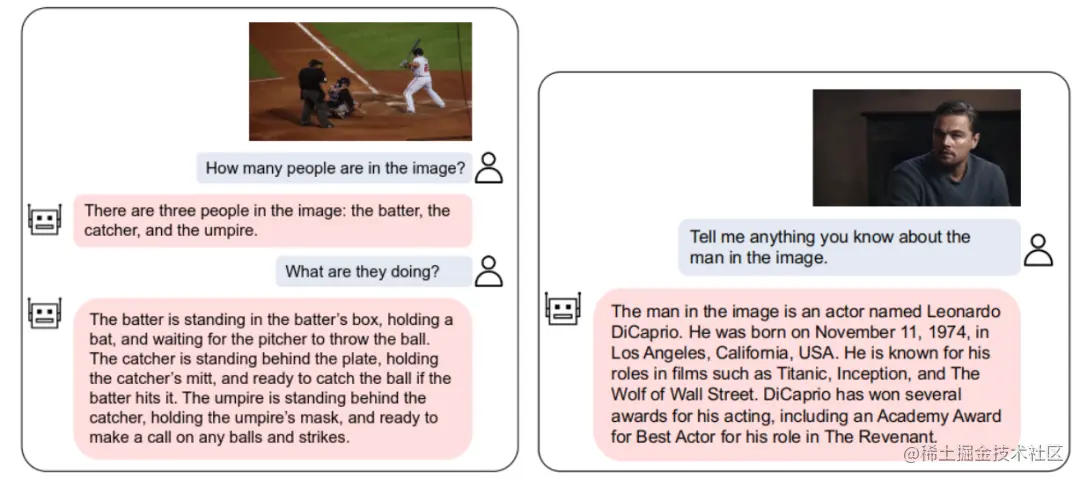
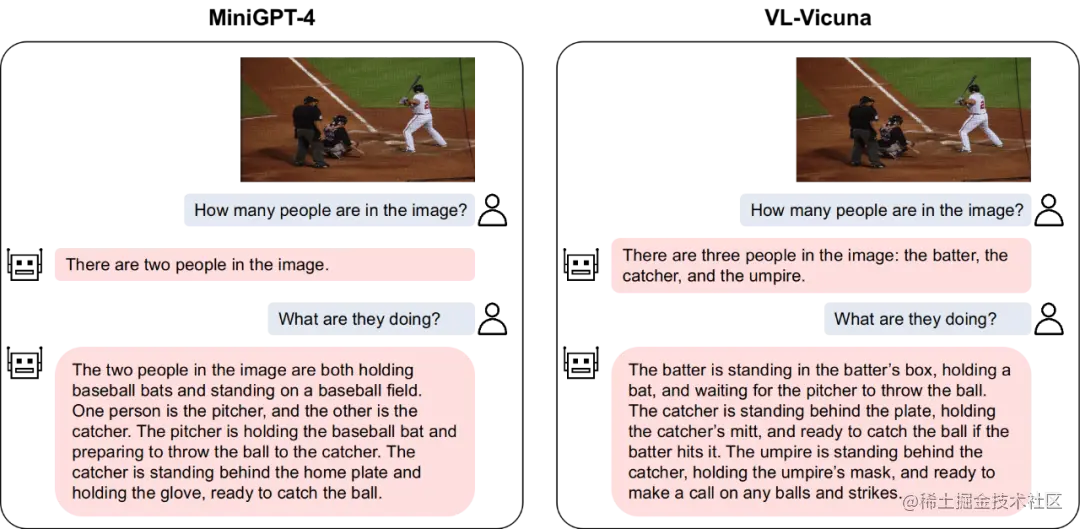
3. 开源多模态对话模型:我们开源了 VL-Vicuna,可实现高质量的多模态对话:
图片

图 2:VL-Vicuna 的交互实例
一、动机介绍
1.1 背景
2023 年是 AI 元年,以 ChatGPT 为代表的大语言模型 (LLM) 大火。LLM 除了在自然语言领域显示出巨大的潜力之外,也开始逐渐辐射到其他相关领域。比如,LLM 在多模态理解领域掀起了一股从传统预训练视觉语言模型 (VLM) 到基于大语言模型的视觉语言模型 (VL-LLM) 的变革。通过为 LLM 接入视觉模块,VL-LLM 可以继承已有 LLM 的知识,零样本泛化能力,推理能力和规划能力等。相关模型有 BLIP-2 [1],Flamingo [2],PALM-E 等。
图片

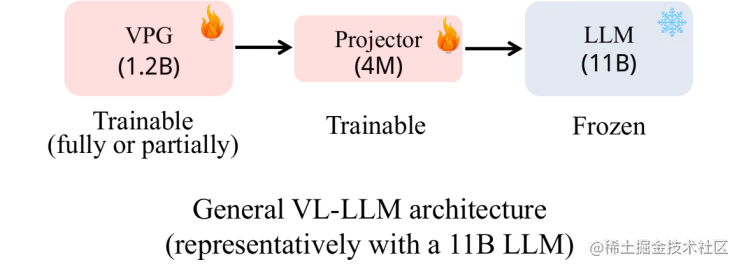
图 3:常用的 VL-LLM 架构
现有的常用的 VL-LLM 基本采取图 3 所示的架构:在一个基座 LLM 基础上训练一个视觉 soft prompt 生成模块 (Visual Prompt Generator, VPG),以及一个进行维度变换的线性层 (Projector)。在参数规模上,LLM 一般占主要部分 (比如 11B),VPG 占次要部分 (比如 1.2B),projector 最小 (4M)。在训练过程中,LLM 参数一般不会被更新,或者仅仅更新非常少量的参数。可训练参数主要来自于 VPG 和 projector。
1.2 动机
实际上,即便基座 LLM 的参数冻结不训,但由于 LLM 的大参数量,训练一个 VL-LLM 的关键开销依然在于加载基座 LLM。因此训练一个 VL-LLM 依然无法避免极大的计算代价。比如,要得到 BLIP-2(基座 LLM 为 FlanT5-XXL)需要付出超过 600 个小时的 A100 训练时长。如果租用亚马逊的 A100-40G 机器,大概需要将近 2 万元人民币的费用。既然从零训练一个 VPG 代价如此昂贵,那么我们开始思考能否把一个已有的 VPG 迁移到新的 LLM 上来节省开销。
图片

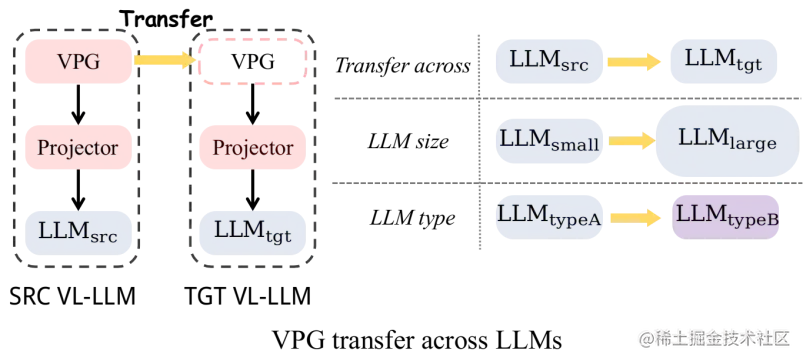
图 4:VPG 迁移:跨 LLM 大小迁移和跨 LLM 类型迁移
如图 4 所示,我们主要探索了两种类型的 VPG 的迁移:
(1) 跨 LLM 大小迁移 (TaS): 比如从 OPT-2.7B 到 OPT-6.7B。(2) 跨 LLM 类型迁移 (TaT): 比如从 OPT 到 FlanT5。
其中 TaS 的意义在于:在 LLM 相关科研中,我们通常需要在小 LLM 上调参,再扩展到大 LLM。有了 TaS,我们可以在调参之后,把小 LLM 上已经训好的 VPG 直接迁移到大 LLM 上。TaT 的意义在于:不同功能种类的 LLM 层出不穷,比如今天有了 LLaMA,明天又有了 Alpaca 和 Vicuna。TaT 可以让我们利用已有的 VPG 快速为新语言模型添加视觉感知能力。
1.3 贡献
(1) 提出高效的方法:我们首先通过一系列的探究实验,探究了影响 VPG 迁移效率的关键因素。根据探索实验发现,我们提出了一个两阶段的高效迁移框架 VPGTrans。该框架可以大幅度缩减训练 VL-LLM 所需的计算开销和需要的训练数据。比如,相比于从头训练,我们通过 BLIP-2 OPT-2.7B 到 6.7B 的 VPG 迁移,可以仅用大约 10% 的数据和计算时间就达成各个数据集相似或更好的效果 (图 1)。训练花销从 17901 人民币到 1673 元。
(2) 得到有趣的发现:我们同时提供了 TaS 和 TaT 场景下一些有趣的发现,并尝试给出解释: a) TaS 场景下,使用 VPGTrans 从小到大迁移不会影响最终模型效果。b) TaS 场景下,越小的语言模型上训练的 VPG,迁移到大模型时效率越高,最终效果越好。c) TaT 场景下,越小的模型之间迁移的 gap 越大。在我们验证实验中,OPT-350M 和 FlanT5-base 使用 VPGTrans 互相迁移几乎和从头训练一样慢。
(3) 开源:我们使用 VPGTrans 得到了两个新的 VL-LLMs: VL-LLaMA 和 VL-Vicuna,并开源在了社区上。其中 VL-Vicuna 实现了高质量的多模态对话。欢迎小伙伴尝试:vpgtrans.github.io/.
二、高效率的 VPG 迁移方案: VPGTrans
首先我们进行一系列的探索验证实验,分析如何最大化对于 VPG 的迁移效率。接着我们基于这些重要观察提出一个解决方案。
2.1 探究实验
我们选取 BLIP-2 架构作为我们的基础模型,预训练语料采用 COCO 和 SBU,总共 1.4M 图文对。下游任务采用 COCO Caption,NoCaps,VQAv2,GQA 和 OK-VQA 的 zero-shot 设定进行评测 (对 caption 任务并非严格 zero-shot)。下面是我们的关键发现:
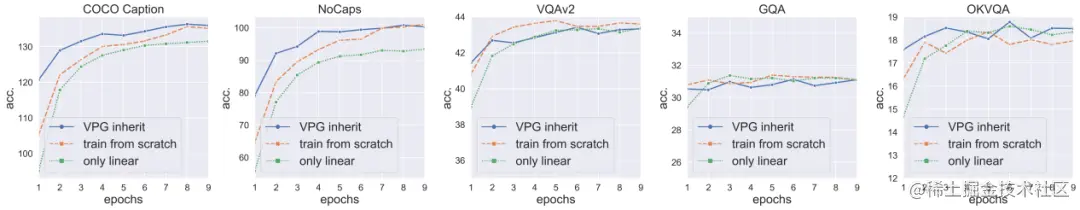
(1) 直接继承一个训练好的 VPG 可以加速收敛,但效果有限:我们发现,直接迁移一个 LLM 上训练好的 VPG 到大 LLM 可以加速模型收敛,但加速效果有限,且收敛后模型效果相比于从头训练 VPG 会掉点 (图 5 的 VQAv2、GQA 蓝线最高点均低于橘线)。我们猜测,这个掉点是由于随机初始化的 projector 会在训练起始阶段损伤 VPG 中已有的视觉感知能力。
图片

图 5:VPG inherit (蓝线): 直接继承训练好的 VPG。train from scratch (橘线):从头训练 VPG。only linear (绿线):只训练 linear projector 不训练 VPG。
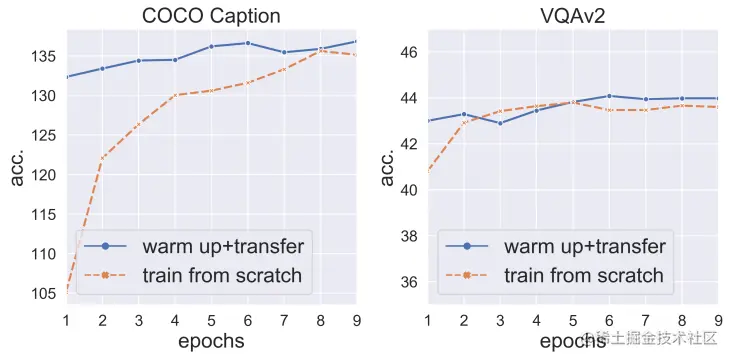
(2) 先 warm-up 训练 projector 可以防止掉点,且进一步加速收敛:于是,我们固定住 VPG 和 LLM,先 warm-up 训练 projector 3 个 epoch,再解冻 VPG 进行下一步训练。我们发现,这样不仅可以避免掉点情况,还能够进一步加速 VPG 收敛 (图 6)。但值得强调的是,由于训练的主要开销在 LLM (参数巨多),仅仅训练 projector 的开销不会比同时训练 VPG 和 projector 的开销小太多。所以,我们开始探究加速 projector warm-up 的关键技术。
图片

图 6: 先 warm-up 训练 projector 可以防止掉点 + 加速收敛
(3) 词向量转化器初始化可以加速 projector warm-up:首先,VPG 是通过把图像转化为 LLM 可以理解的 soft prompt 来产生效果的。而 soft prompt 的使用方式和词向量其实是非常相似的,都是直接输入语言模型来提示模型产生对应内容。所以,我们使用词向量来作为 soft prompt 的一个代理,训练了一个图片到 图片的词向量转化器 (一个线性层)。然后,我们将词向量转化器和 图片上的 projector 融合作为图片的 projector 的初始化。通过这个初始化,我们可以将 projector 的 warm-up 训练由 3 个 epoch 减为 2 个 epoch。
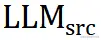
(4) projector 可以在超大学习率下快速收敛:我们进一步实验发现,projector 由于其参数量较少,可以使用 5 倍的正常学习率进行训练而不崩溃。通过 5 倍学习率的训练,projector warm-up 可以进一步被缩短到1个 epoch。
(5) 一个附加发现:虽然 projector warm-up 很重要,但仅训练 projector 是不够的。尤其在 caption 任务上面,仅仅训练 projector 的效果要比同时训练 VPG 的效果差一截 (图 5 绿线在 COCO Caption 和 NoCaps 均远低于蓝线)。这也就意味着,仅仅训练 projector 会导致欠拟合,无法充分对齐到训练数据。
2.2 我们所提出的方法**
**
图片

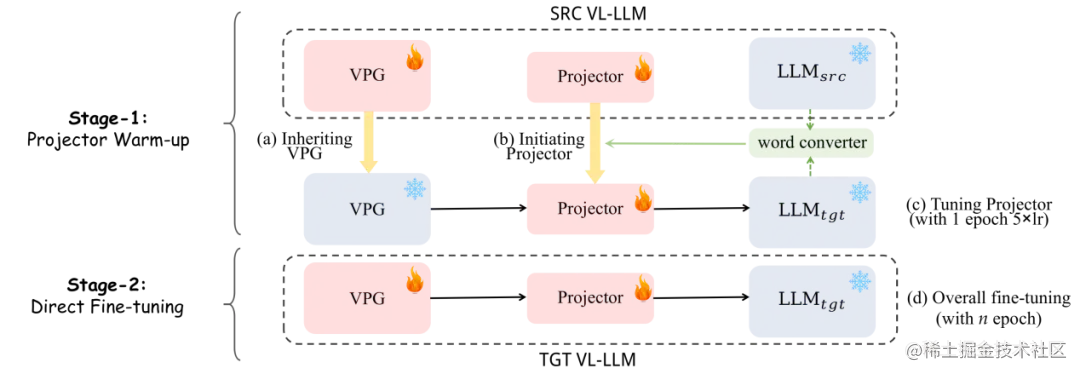
图 7:VPGTrans 框架: (1) 一阶段:projector 的 warm-up (2) 二阶段:整体微调
如图 7 所示,我们的方法共分为两个阶段:
(1) 第一阶段:我们首先使用词向量转化器和原有 projector 进行融合作为新 projector 的初始化。然后用 5 倍学习率训练新 projector 一个 epoch。(2) 第二阶段:直接正常训练 VPG 和 projector。
三、实验结果
3.1 加速比**
**
图片

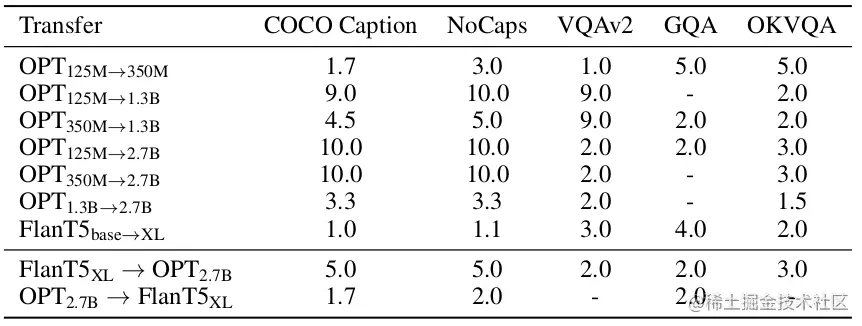
表 1:我们的 VPGTrans 的相比于从头训练在各个数据集的加速比
如表 1 所示,我们测试了在不同迁移类型下,VPGTrans 在不同数据集上的加速比。VPGTrans 在某指定数据集 A 上的加速比是通过从头训练达到 A 上最佳效果 a 的轮数除以 VPGTrans 在 A 上效果超过 a 的最小训练轮数得到。比如,从头在 OPT-2.7B 上训练 VPG,在 COCO caption 达到最佳效果需要 10 个 epoch,但从 OPT-125M 迁移 VPG 到 OPT-2.7B,仅需 1 个 epoch 就能达到该最佳效果。则加速比为 10/1=10 倍。我们可以看到,无论是在 TaS 还是在 TaT 场景下,我们的 VPGTrans 都可以实现稳定的加速。
3.2 有趣的发现
我们选取了一个比较有趣的发现进行了说明,其他更多更有意思的发现请参照我们的论文。
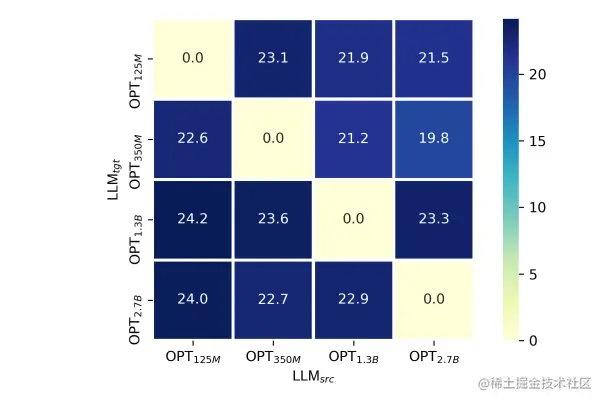
TaS 场景下,越小的语言模型上训练的 VPG,迁移起来效率越高,最后模型效果越好。参考表 1,我们可以发现 OPT-1.3B 到 OPT-2.7B 的加速比要远小于 OPT-125M、OPT-350M 到 OPT-2.7b 的加速比。我们尝试提供了一个解释:一般越大的语言模型,由于其文本空间的维度更高,会更容易损害 VPG (VPG 一般都是类似于 CLIP 的预训练模型) 本身的视觉感知能力。我们通过类似于 linear probing 的方式进行了验证:
图片

图 8:仅训练 linear projector 层的跨 LLM 大小迁移 (模拟 linear probing)
如图 8 所示,我们进行了 OPT-125M,350M,1.3B,2.7B 之间的跨 LLM 大小的迁移。在实验中,为了公平对比不同模型大小下训练过的 VPG 的视觉感知能力,我们固定住 VPG 的参数仅仅训练 linear projector 层。我们选取了 COCO Caption 上的 SPICE 指标作为视觉感知能力的衡量手段。不难发现,对于每一个给定的 图片,几乎都符合 图片越小,最终 SPICE 越高的一个现象。
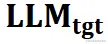
3.3 大规模实验
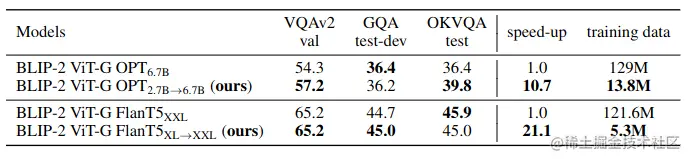
前文实验主要是在小规模场景下验证猜想。为了证明我们方法的有效性,我们模拟 BLIP-2 的预训练过程进行了大规模实验:
图片

表 2:真实场景下的大规模实验结果
如表 2 所示,我们的 VPGTrans 在大规模场景下依然有效。通过 OPT-2.7B 到 OPT-6.7B 的迁移,我们仅用 10.8% 的数据和不到 10% 的训练时长达到了相似或更优的效果。尤其是,我们的方法在 BLIP-2 以 FlanT5XXL 为基座 LLM 下实现了 5% 左右的训练成本控制。
四、定制自己的 VL-LLMs
我们的 VPGTrans 可以快速为任意新的 LLMs 添加视觉感知模块,从而得到一个全新的高质量 VL-LLM。在本工作,我们额外训练了一个 VL-LLaMA 和一个 VL-Vicuna。其中 VL-LLaMA 的效果如下:
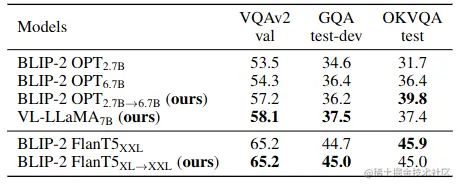
图片

表3:VL-LLaMA 的效果展示
同时,我们的 VL-Vicuna 可以进行多模态对话。我们和 MiniGPT-4 进行了简单的比较:
图片

图片

五、总结
在这项工作中,我们对 VPG 在 LLM 之间的可迁移性问题进行了全面调查。我们首先探讨了最大化迁移效率的关键因素。基于关键观察,我们提出了一种新颖的两阶段迁移框架,即 VPGTrans。它可以在显著降低训练成本的同时,实现相当或更好的性能。通过 VPGTrans,我们实现了从 BLIP-2 OPT-2.7B 到 BLIP-2 OPT-6.7B 的 VPG 迁移。相较于从零开始连接 VPG 到 OPT 6.7B,VPGTrans 仅需 10.7% 训练数据和不到 10% 的训练时长。此外,我们展示并讨论了一系列有趣发现及其背后的可能原因。最后,我们通过训练 VL-LLaMA 和 LL-Vicuna,展示了我们的 VPGTrans 在定制新的 VL-LLM 方面的实际价值。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
2025年最新雷电模拟器9.22安装Magisk面具和LSPosed框架完整图文教程 文章末尾附所需软件下载 操作环境:雷电模拟器9.0.22 虚拟系统版本android 91、设置-其他设置-Root权限-开启2、设置-性能设置-System.vmdk可写入3、安装Magisk-18a0b94a-delta(25205).apk,运行并给予root权限4、选择右上角安装弹出“允许“magisk Delta”访问您设备上的照片、媒体内容和文件吗?“选择允许,然后结束magisk进程。5、从新运行magisk选择右上角安装-选择修补boot镜像中的vbmeta和安装到Recovery。 阅读详情

相关推荐

COMSOL两相流(相场法)

COMSOL是一款功能非常强大的多物理场仿真软件,拥有可视化和后处理工具,可方便有效的展示您的仿真效果,具有灵活、高效、友好的特点,软件能够为用户提供各类工程问题的解决方案,从而帮助广大研究和工程人员能够在科研上取得新突破。 COMSOL可以实现声学、传热、流体力学、结构力学等方面的模拟仿真,具体模块如下图所示。 COMSOL软件设置流程 定义需要求解的问题类型:针对一个需要仿真的问题,需要先对问题进行分析;分析该问题用到哪些物理场,什么样的几何模型,以及如何设置研究等。该步骤可以使用COMSOL中的

weixin_47139559的博客 1万+

又一个GPT-4平替版!训练开销骤减,定制专属多模态大模型!

张傲,费豪,姚远,吉炜,黎力,刘知远,Chua Tat-Seng机构:新加坡国立大学,清华大学本文来源 机器之心最近的多模态(对话)大模型将基于文本的 ChatGPT 的强大能力扩展到了多模态输入,实现强大的多模态语义理解,比如 GPT-4、BLIP-2、Flamingo 等。但对于很多研究者来说,训练一个多模态 GPT 代价非常昂贵。本文来自新加坡国立大学和清华大学的研究者提出了一个名...

idol24的博客 526

TSmaster CANFD配置避坑指南:为什么你的PCAN盒不支持最新版本?

本文针对TSmaster配置PCAN硬件进行CANFD通信时的常见问题,提供了详细的避坑指南。重点解析了CANFD配置中TSEG1等关键参数的理解误区,并深入探讨了TSmaster新版本与PCAN硬件驱动之间的兼容性变化,帮助工程师快速定位并解决连接失败或无法发送CANFD报文等问题。

alpha的博客 542

别再纠结 GPT-4 了,最强平替 MiniGPT4 开源了,完全免费!

来源量子位 | 公众号 QbitAIGPT-4识图功能迟迟不开放,终于有人忍不住自己动手做了一个。MiniGPT-4来了,Demo开放在线可玩。传一张海鲜大餐照片上去,就能直接获得菜谱。传一张商品效果图,就可以让AI写一篇带货文案。手绘一个网页,可以给出对应的HTML代码除了生产力拉满,也支持根据常识推理图上内容是否合理、解释表情包为什么好笑,以及看截图找电影等娱乐玩法。可以说,GPT-4发布时展...

weixin_45727359的博客 841

Halcon图片拼接避坑指南:特征点匹配常见问题与解决方案

本文深入解析Halcon图片拼接中特征点匹配的常见问题与解决方案,涵盖特征点提取、匹配优化及变换模型选择等关键环节。针对工业视觉检测中的拼接错位、重影等问题,提供参数调优、图像预处理和算法选择等实战技巧,帮助开发者高效避坑并提升拼接精度。

weixin_28694169的博客 198

七、从0开始卷出一个新项目之瑞萨RZN2L 2.2.2 启动模式和flash

七、从0开始卷出一个新项目之瑞萨RZN2L 2.2.2 启动模式和flash。

cl234583745的博客 1466

平替这么多!谁能与我一战?GPT-4化身主考官

魏亦豪 投稿 量子位 | QbitAI(本文来源)GPT-4太强,甚至已经化身“主考官”了!给其他市面上主流的大模型打分,结果自己给了自己最高分:95.5。(好,给自己留点努力的空间)不过随后就没有上90的选手了。就连它的“前辈”ChatGPT(GPT-3.5),它也只给了89.1分。随后依次是号称最强竞品的Claude、谷歌Bard、UC伯克利出品的小羊驼Vicuna-13B,以及清华系开源...

idol24的博客 323

Starlink地面终端天线对星(一)对星流程,星历下载,信标信号

starlink卫星终端对星采用机械伺服+相控阵电子扫描的混合模式,兼顾快速盲扫和高精度跟踪;对星流程分三步:冷启动与盲捕获 → 建立初始链路并下载星历 → 进入正常通信模式;

chen2jiang3的博客 2724

【转】如何快速方便地下载huggingface的模型库

【个人使用记录】完全参考。

weixin_50862344的博客 921

Navicat Premium 12 永久激活保姆级教程(附最新补丁下载)

本文详细介绍了Navicat Premium 12的高效使用方法,从安装配置到高级功能应用,帮助用户充分发挥这款数据库管理工具的全部潜力。内容包括数据库连接管理、数据查询与编辑、数据同步与结构对比等核心功能,以及性能优化和最佳实践建议,提升数据库管理效率。

weixin_28834765的博客 643

使用ZYNQ芯片和LVGL框架实现用户高刷新UI设计系列教程(第七讲)

默认是第一种键盘模式,当需要切换模式,进入到ta_event_cb函数修改模式,下面代码以数字模式举例子lv_keyboard_set_mode(kb, LV_KEYBOARD_MODE_NUMBER);在该界面中可以设置键盘文字的大小和文本类型,最下方判断键盘是否支持中文输入(中文输入,当汉字库不够大时,用户点击中文输入会少很多字)。//当LV_USE_KEYBOARD为1时启用虚拟键盘,LV_USE_ZH_KEYBOARD为1时支持中文输入。随后在系统设置界面中点击项目选项,选择显示键盘。

weixin_38828382的博客 1416

从原理到落地!LoRA微调全解析:用百川智能实战,让大模型轻量化适配成本直降90%

文章摘要: LoRA技术通过低秩矩阵分解(如r=8时参数量降至0.39%),实现大模型轻量化微调,显著降低算力需求(单张RTX 3090可运行Baichuan2-7B)。其核心优势包括:1)仅更新局部权重,保留预训练通用知识;2)结合知识蒸馏避免任务过拟合。实战部分以百川Baichuan2为例,详细演示了从环境配置、数据格式(JSON多轮对话)到LoRA参数注入(peft库)的全流程,关键参数如秩r、学习率(2e-5)需按任务调整。该技术使垂直领域适配成本降低90%,成为中小团队落地AI的高效方案。

weixin_52610848的博客 1990

20.Labview使用子vi进行VI间的数据传递详解(模块化)

子VI(模块化)题主在题注中也提到, 子VI的建立只是为了减少程序的负担,那么我们当使用子VI的时候首先就要明确什么是子VI?什么样的程序可以作为子VI?首先我们来看NI官方给的定义,具体说明如下图所示:题主已经将重点画出来了,在官方的解释中将子VI定义为了模块化,大家可以看到创建模块化子VI的特点在于减少代码重复工作优化了程序的框架结构。把一个代码打包,需要的时候就拎出来让他处理处理,不需要的时候就让它躺在我的列表里就行了也不占用运行空间。那么创建子VI需要需要注意以下几点:①任何一个程序。

关注我,更多技术问题欢迎私聊~ 3516

AI大模型伦理治理:技术实现与工程实践

人工智能伦理治理是确保AI技术健康发展的重要保障,其核心在于平衡技术创新与社会责任。从技术原理看,通过多模态embedding、强化学习动态策略等技术构建文化识别与过滤机制,可有效控制模型输出的伦理风险。工程实践中,采用区域化微服务架构和实时监控体系,能够在保证合规的同时控制性能开销。特别是在处理文化差异和内容传播控制方面,动态衰减函数和敏感概念拓扑映射等技术展现出显著效果。当前AI伦理治理的关键挑战在于实现全球化标准与本土化实施的平衡,这需要开发者深入理解模型放大效应等核心概念,并掌握GDPR合规适配等实

weixin_33046983的博客 262

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

DeepSeek-V4系统级经济性:MoE架构与CSA+HCA如何重构AI应用TCO

大语言模型的真正价值正从单次推理性能转向系统级总拥有成本(TCO)。MoE(Mixture of Experts)架构通过动态专家调度提升计算效率,CSA+HCA(Compressed Sparse Attention + Hybrid Context Attention)则在1M长上下文场景下实现KV缓存压缩与分层注意力,显著降低内存占用与FLOPs消耗。这种技术组合使API调用从‘按token计费’升级为‘按语义复用计费’,尤其在代码分析、日志处理、智能合约审计等高复用、长周期AI工作流中释放出巨大经济

djph26741的博客 778

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

Claude归零层解析:语义保真度校验环的移除与推理优化

大语言模型推理过程中的冗余计算是影响延迟、成本与稳定性的核心瓶颈。传统动态语义校验机制虽提升输出一致性,却带来超线性计算开销和长文本性能衰减。Anthropic提出的‘归零层’并非简单删减,而是将实时校验范式升级为状态感知型轻量快照与偏差补偿机制,实现计算资源向高风险决策节点的精准投放。该技术显著降低首token延迟、提升长上下文连贯性,并重构RAG与客服对话等典型场景的成本结构。本文深入剖析语义保真度校验环(SFCL)的工程本质及其剥离后的系统级收益,覆盖架构原理、实操配置、监控指标与生态适配,助力开发者

liangqilang的专栏 500

MoE混合专家系统:大模型稀疏激活与高效推理原理

混合专家系统(MoE)是一种通过稀疏激活实现大模型高效计算的核心架构,其本质是在Transformer中引入动态路由机制,使每次前向仅激活少量专家子网络,从而突破稠密模型的算力与显存线性增长瓶颈。该技术基于门控路由、专家隔离、负载均衡等关键原理,显著提升计算密度与内存带宽利用率,在保持高精度的同时大幅降低推理延迟和硬件成本。当前主流大模型如DeepSeek-R1、Mixtral及GPT-4均采用MoE架构,支撑千亿至万亿参数规模的工业级部署。本文聚焦MoE的工程实现逻辑、参数激活机制与生产级部署要点,深入解

chongyuwan4121的博客 444

让 AI 替人写代码这件事,人类已经尝试了 70 年

文章摘要:AI编程辅助技术已探索70年,经历了多次范式转变。从1950年代霍珀的自动化编程愿景,1980年代MIT的“程序员学徒”项目,到1990年代微软的意图编程,每次尝试都因技术局限未能完全实现。现代AI编程基于统计学习和大语言模型(如Transformer),通过海量代码数据训练实现智能涌现,但其成功依赖于架构、数据和硬件的协同演进。尽管AI能替代90%常规编程任务,工程师仍需培养10%独特能力以应对AI时代挑战。历史表明,技术会变,但人与复杂性对抗的本质不变。

优快云资讯 2005

【亲测免费】 BLIP-2与OPT-2.7b模型的对比分析

在人工智能领域,选择合适的模型对于项目的成功至关重要。不同的模型在性能、资源消耗、适用场景等方面各有优劣。本文将对BLIP-2与OPT-2.7b模型进行详细的对比分析,帮助读者更好地理解这两个模型的特点,从而为实际应用中的模型选择提供参考。 ## 主体 ### 对比模型简介 #### BLIP-2模型概述 BLIP-2模型是由Salesforce开发的视觉语言模型,结合了CLIP-like...

gitblog_02758的博客 1420

BLIP-2:salesforce提出基于冻结视觉编码器和LLM模型参数的高效训练多模态大模型

对于基于encoder-decoder的LLM,使用前缀语言建模损失进行预训练,并且将文本分为两个部分,前缀文本与视觉表示作为LLM编码器的输入,后缀文本用作LLM解码器的生成目标。本文提出的BLIP-2方法是一套新型多模态预训练模型的框架,思路是通过在冻结的预训练图像编码器和冻结的预训练大语言模型之间添加一个轻量级 查询 Transformer (Query Transformer, Q-Former) 来弥合视觉和语言模型之间的模态隔阂 (modality gap)。Z表示输出的query。

wshzd的博客 1638

基于LLMs的多模态大模型(PALM-E,ArtGPT-4,VPGTrans )

本篇文章先放一些比较杂的延伸和应用的文章,后面形成分支了再单独开,目前主要是PALM-E,ArtGPT-4,VPGTrans 等。PALM-E是博主很关心的文章之一,它是一个562B的视觉语言模型(PaLM-540B + ViT-22B),有个是目前全球最大的视觉语言模型了。同时它将集成到机器人控制中,即多模态具身智能,这将为目前已经很强大的模型们加上机器人的手臂。关于多模态具身智能可以看博主以往的博文

nakaizura 3332

基于LoRA微调多模态大模型

BLIP-2通过利用预训练的视觉模型和语言模型来提升多模态效果和降低训练成本,预训练的视觉模型能够提供高质量的视觉表征,预训练的语言模型则提供了强大的语言生成能力。如下图所示,由一个预训练的,一个预训练的和一个可学习的Q-Former组成。image.png:负责从输入图片中提取视觉特征。:负责文本生成。Q-Former:负责弥合视觉和语言两种模态的差距,由和两个子模块构成,它们共享相同自注意力层,如下图所示。

2301_82275412的博客 1942

VPGTrans 使用指南

VPGTrans 使用指南 项目概述 VPGTrans 是一个开创性的视觉提示生成器迁移方案,由 Ao Zhang 等人开发。此项目旨在减少跨大型语言模型(LLM)传输现有视觉提示生成器(VPG)的成本,特别是在资源密集型的多模态学习任务中。通过精心设计的两阶段转移框架,VPGTrans 实现了效率与性能的双赢,允许开发者以较低成本快速定制高性能的视觉-语言大模型。 目录结构及介绍 VPGTran...

gitblog_00922的博客 737

BLIP-2 OPT-2.7b:常见错误及解决方法

在现代人工智能领域,BLIP-2 OPT-2.7b模型以其卓越的性能和广泛的应用前景受到了广泛关注。然而,如同任何技术产品一样,使用过程中可能会遇到各种错误。本文旨在探讨BLIP-2 OPT-2.7b模型在使用过程中可能出现的常见错误,并提供相应的解决方法,以帮助用户顺利地进行模型部署和应用。 ## 错误类型分类 在使用BLIP-2 OPT-2.7b模型时,用户可能会遇到以下几种错误类型: ...

gitblog_02048的博客 936
上一篇: 当大模型不是问题时,如何应对 LLM 的工程化落地挑战?
下一篇: 5种搭建LLM服务的方法和代码示例
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值