Spark-TTS: 不依赖模型生成声学特征的TTS

语言合成模型Spark-TTS-0.5B学习笔记 语言合成是通过计算机技术将文字信息转换为自然流畅的语音输出,模拟人类语音。 阅读详情

GitHub:https://github.com/sparkaudio/spark-tts

更多AI开源软件:发现分享好用的AI工具、AI开源软件、AI模型、AI变现 - 小众AI

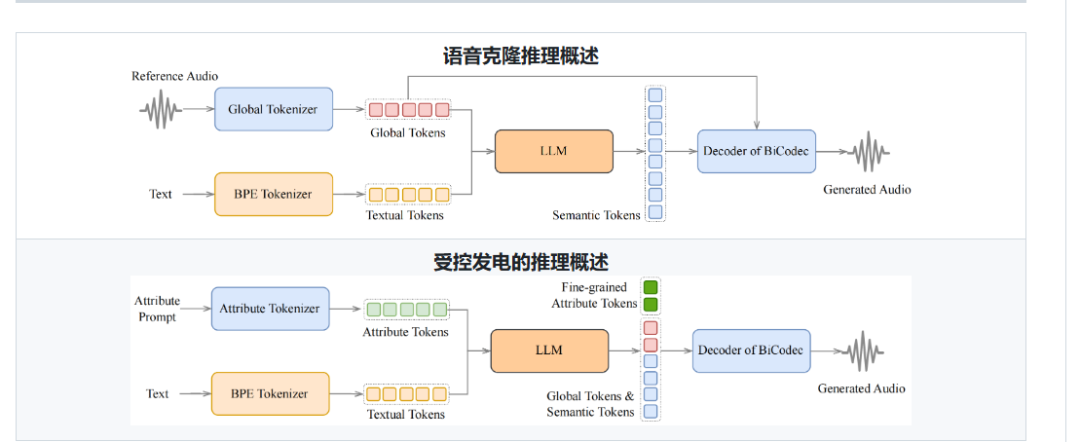
Spark-TTS 完全基于 Qwen2.5 构建,无需使用流匹配等额外生成模型。它无需依赖单独的模型来生成声学特征,而是直接从 LLM 预测的代码中重建音频。这种方法简化了流程,提高了效率并降低了复杂性。

上传任意10秒语音片段,瞬间复刻声纹特征!无论是跨语种的中英混说,还是模仿特定语调,通通零样本实现。自媒体博主惊呼:"我的百万声库要失业了!"
​

​

  • 简单高效:Spark-TTS 完全基于 Qwen2.5 构建,无需额外的生成模型,如流程匹配。它不依赖单独的模型来生成声学特征,而是直接从 LLM 预测的代码中重建音频。这种方法简化了流程,提高了效率并降低了复杂性。
  • 高质量语音克隆:支持零样本语音克隆,这意味着即使没有针对该语音的特定训练数据,它也可以复制说话者的语音。这是跨语言和代码切换场景的理想选择,允许在语言和语音之间无缝转换,而无需对每种语言和语音进行单独培训。
  • 双语支持:支持中英文,能够针对跨语言和换码场景进行零镜头语音克隆,使模型能够以高自然度和准确性合成多种语言的语音。
  • 语音生成可控:支持通过调整性别、音调、语速等参数创建虚拟说话人。

安装

克隆和安装

以下是在 Linux 上安装的说明。如果您使用的是 Windows,请参阅 Windows 安装指南。

  • 克隆存储库
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
# If you are in mainland China, you can set the mirror as follows:
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com

模型下载

通过 python 下载:

from huggingface_hub import snapshot_download

snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")

通过 git clone 下载:

mkdir -p pretrained_models

# Make sure you have git-lfs installed (https://git-lfs.com)
git lfs install

git clone https://huggingface.co/SparkAudio/Spark-TTS-0.5B pretrained_models/Spark-TTS-0.5B

基本用法

您只需使用以下命令运行演示即可:

cd example
bash infer.sh

或者,您也可以在命令行中直接执行以下命令进行推理:

python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"

可选方法

有关其他 CLI 和 Web UI 方法,包括替代实现和扩展功能,您可以参考:

运行

Nvidia Triton 推理服务

我们现在为使用 Nvidia Triton 和 TensorRT-LLM 部署 Spark-TTS 提供了参考。下表显示了单个 L20 GPU 的基准测试结果,使用 26 个不同的 prompt_audio/target_text 对(总共 169 秒的音频):

型注意并发平均延迟RTF
火花-TTS-0.5B代码提交1876.24 毫秒0.1362
火花-TTS-0.5B代码提交2920.97 毫秒0.0737
火花-TTS-0.5B代码提交41611.51 毫秒0.0704

有关更多信息,请参阅 runtime/triton_trtllm/README.md 中的详细说明。

实战演习

Spark-TTS 的核心功能是将文本转为语音,以下是具体操作流程:

1. 使用预训练模型生成语音
  • 准备文本:创建一个简单的文本文件(如 input.txt​),写入需要转换的文本,例如:“你好,这是一个测试语音。

  • python generate.py --input input.txt --output output.wav
    
  • 参数说明:

    • ​--input​:指定输入文本文件路径。
    • ​--output​:指定生成的语音文件保存路径(如 output.wav​)。
    • 如果脚本支持,可添加 --model​ 参数选择预训练模型,或 --voice​ 参数调整声音风格。
  • 结果:运行后,你会在指定路径找到生成的 output.wav​ 文件,用音频播放器打开即可听到效果。

2. 训练自定义模型
  • 准备数据集:你需要提供文本和对应的音频数据。数据格式通常是 .txt​ 文件(文本)和 .wav​ 文件(音频),建议参考仓库中的 README.md​ 或示例文件夹。

  • 配置参数:编辑配置文件(可能是 config.json​ 或类似文件),设置训练参数,如学习率、批次大小等。如果没有配置文件,直接在脚本中修改参数

  • python train.py --data_path ./dataset --output_model my_model
    
  • 训练过程:根据数据量和硬件性能,训练可能需要数小时甚至几天。完成后,你会得到一个新的模型文件(如 my_model.pth​)

  • python generate.py --input input.txt --model my_model.pth --output custom_output.wav
    
3. 调整语音风
  • python generate.py --input input.txt --speed 1.2 --pitch 0.8 --output styled_output.wav
    
  • 参数说明:

    • ​--speed​:语速,1.0 为正常速度,大于 1.0 加快,小于 1.0 减慢。
    • ​--pitch​:音调,值越高音调越高,反之越低。
  • 效果验证:生成后试听,逐步调整参数直到满意。

操作流程实例

假设你想将一段中文文本转为女性语音:

  1. 创建 test.txt​,写入:“今天天气很好,我们去公园散步吧。

  2. python generate.py --input test.txt --voice female --output park.wav
    
  3. 检查 park.wav​,确认语音是否自然流畅。

  4. 如果不满意,尝试调整参数或训练新模型。

智能解决装箱问题:使用优化算法实现高效包装 装箱问题(Bin Packing Problem)是组合优化领域中的一个经典问题,主要涉及如何将一系列对象高效地装入有限数量的容器(或“箱”)中,同时满足特定的约束条件。这个问题的目标是最小化所需使用的箱子数量或者最大化箱子的装载效率,以减少空间或资源的浪费。 阅读详情

相关推荐

IT运维必备 开源Urbackup 备份系统部署教程 实战操作

手动添加ip方式检查是否在线 ,linux需要按上述步骤6配置server端地址 不然一直不会进去状态栏。安装依赖sudo apt install -y libcrypto++-dev。补充客户端手动触发备份命令 (一般在服务端操作即可,特殊情况客户端进行操作)修改ubuntu主机名 建议修改为ip 方便上线以ip命名上线。默认客户端安装完毕大概几分钟之内服务端会自动上线。配置客户端指向server端地址。(2)ubuntu 客户端设置。新起一个远程窗口查看配置状态,配置客户端备份文件目录。

qq_34981755的博客 1281

DeepSeek-VL2实战指南:一步步构建您自己的智能视觉问答系统!

DeepSeek-VL2,这是一系列先进的大型混合专家 (MoE) 视觉语言模型,其显著改进了其前身 DeepSeek-VL。DeepSeek-VL2 在各种任务中都表现出卓越的能力,包括但不限于视觉问答、光学字符识别、文档/表格/图表理解和视觉基础。我们的模型系列由三个变体组成:DeepSeek-VL2-Tiny、DeepSeek-VL2-Small 和 DeepSeek-VL2,分别具有 1.0B、2.8B 和 4.5B 激活参数。

SJJS_1的博客 4683

Cadence psspxf实战:手把手教你仿真250MHz环形VCO的电源抑制比(附Verilog代码)

本文详细介绍了使用Cadence psspxf仿真器对250MHz环形VCO的电源抑制比(PSRR)进行仿真的全流程。从环形VCO的设计原理、Verilog代码实现,到Cadence环境配置、仿真参数设置,再到结果分析与优化技巧,提供了完整的实战指南。特别适合电路设计工程师学习如何评估和优化VCO的抗电源噪声能力。

weixin_42567752的博客 414

基于Qwen2.5模型的高效文本转语音(TTS)系统 Spark-TTS

一种基于大语言模型(Qwen2.5)的高效文本转语音(TTS)系统针对当前 TTS 领域的效率问题,提出了一种新的BiCodec语音编码方法,使得语音合成更加自然,可控,并支持零样本语音克隆。✅ 采用 BiCodec 编码,简化架构,提升推理效率。✅ 支持细粒度语音控制(性别、音调、语速等),远超传统 TTS。✅ 领先的零样本语音克隆(Zero-Shot TTS),能生成高质量个性化声音。✅ 在多个基准测试上超越现有 TTS 方法,并结合 Qwen2.5 LLM 进行端到端生成。

m0_65555479的博客 2775

R数据分析:潜在转化分析LTA的做法和解释(一)

之前给大家写了很多潜在类别分析的教程Mplus教程:如何做潜在类别分析LCAR数据分析:用R语言做潜类别分析LCAMplus数据分析:潜在类别分析(LCA)流程(详细版)R数据分析:再写潜在类别分析LCA的做法与解释,今天继续给大家拓展一步。 今天要介绍的就是潜在转换分析,这个东西就是LCA的纵向版本。是一个专门用来研究质变的统计技巧。有一句话叫做量变起质变,你怎么知道质变到底发生没有?就用潜在转换分析。 Latent transition analysis is an extension of...

Codewar的博客 7703

Android 13 灭屏音乐播放问题解决与优化建议

通过在中增加对音乐播放状态的检测,我们成功解决了客户应用在灭屏状态下音乐播放被中断的问题。

m0_60898338的博客 1157

最新开源TTS语音克隆,本地部署实测!跨语言、高保真。。。

最近,看到一款开源的语音合成(TTS)系统。今日分享,将介绍 `Spark-TTS`,并带大家本地部署体验,为本地 TTS 选型提供参考。

u010522887的专栏 6920

CodeQL查询时遇到报错:A fatal error occurred: Could not process query metadata for...如何解决?

🏆本文收录于 《全栈Bug调优(实战版)》 专栏,该专栏专注于分享我在真实项目开发中遇到的各类疑难Bug及其深层成因,并系统提供高效、可复现的解决思路和实操方案。无论你是刚入行的新手开发者,还是拥有多年项目经验的资深工程师,本专栏都将为你提供一条系统化、高质量的问题排查与优化路径,助力你加速成长,攻克技术壁垒,迈向技术价值最大化与职业发展的更高峰🚀!

**My Coding Family** 1084

官方链接内容整理的 Spark-TTS Windows 安装完整流程

pip 无法从指定的 PyTorch 旧版本索引中找到适合你当前环境的 torch 包。这通常是由于 ​​Python 版本不兼容​​ 或 ​​CUDA 环境问题​​ 导致的。​​PyTorch 2.0+​​ 需要 Python 3.8-3.11(​​不支持 Python 3.12​​)。这会安装最新的 1.x 版本(如 1.26.4),兼容大多数科学计算库。—1. ​​降级 numpy 到兼容版本​​。2. ​​重新安装冲突的包​​。检查 Python 版本​​。3. ​​验证安装​​。

asd2580147369的博客 2707

C# 与欧姆龙 PLC 实战:通过 Ethernet/IP 协议进行设备控制与监控

本文介绍了如何通过C#和Ethernet/IP协议实现与欧姆龙PLC的通信。Ethernet/IP是基于以太网的工业协议,适用于工业设备间的实时数据交换。文章详细讲解了使用EthernetIPSharp库建立连接、读写数据的步骤,并提供了示例代码。此外,还探讨了实时监控、报警系统等高级功能,为工业自动化控制系统开发提供了实用指导。该方法简化了PLC通信开发,提高了系统可靠性和智能化程度。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 811

YOLOv11涨点改进 | Neck改进篇 | YOLOv11引入 BiFPN双向特征金字塔网络,显著提升了多尺度特征融合效率

本文介绍了基于BiFPN特征融合模块优化的YOLOv11目标检测模型。BiFPN通过双向跨尺度连接和加权特征融合机制,显著提升了多尺度特征融合效率。该方法在COCO数据集上实现了55.1AP的检测精度,同时大幅降低计算成本(减少13-42倍FLOPs)。文章详细解析了BiFPN模块结构、核心代码实现方法,并提供了YOLOv11-BiFPN配置文件的修改指导,为计算机视觉领域提供了一种高效的目标检测解决方案。

Ai缝合怪、助力小伙伴高效发论文 714

Spark-TTS:基于大模型的文本语音合成工具

Spark TTS完全基于Qwen2.5构建,无需额外的生成模型,它不依赖于单独的模型来生成声学特征,而是直接从LLM预测的代码中重建音频。这种方法简化了流程,提高了效率并降低了复杂性;支持零样本语音克隆,它可以直接复制说话者的语音。这是跨语言和代码转换场景的理想选择,允许语言和语音之间的无缝转换,而不需要对每种语言进行单独的培训;支持中文和英文两种语言,使模型能够以高自然度和准确性合成多种语言的语音;支持通过调整性别、音高和语速等参数来创建虚拟说话者。

CITY_OF_MO_GY的博客 5534

SAP-ABAP: BP主数据完全指南:从基础到高阶应用

SAP-ABAP: BP主数据完全指南:从基础到高阶应用

baidu_35680696的博客 1647

最新开源文本转语音神器——Spark-TTS本地部署教程:打造超自然AI语音!

出门问问最新开源语音合成模型,具有超强语音合成能力

SJJS_1的博客 1万+

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Spark-TTS方言合成实战:零样本实现普通话到多地域口音转换的完整指南

想要让AI语音不仅说普通话,还能说地道的方言口音吗?🤔 Spark-TTS作为一款基于大语言模型的高效文本转语音系统,提供了零样本语音克隆技术,让你无需训练就能实现普通话到多地域口音的智能转换!本文将为你详细介绍如何使用Spark-TTS进行方言口音合成,从安装部署到实战应用,一步步带你掌握这项前沿技术。 ## 什么是Spark-TTS方言口音转换? Spark-TTS是一款基于Qwen2.

gitblog_00700的博客 1164

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Spark TTS,基于LLM的TTS模型,支持零样本语音克隆,允许语言和语音之间的无缝转换

Spark-TTS 是基于大型语言模型(LLM)的高效文本转语音(TTS)系统。

CherryXieのblog 818

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【Spark-TTS】从此你的声音是我的了

本文主要讲解了从克隆Spark-TTS库到进行声音克隆的过程,包括安装依赖、下载权重、UI界面及问题解决等。

录求学之迹,留影于凡庸之日,若有益于君,更胜琼瑶。 1559

终极指南:如何使用Spark-TTS构建企业级语音合成系统

Spark-TTS是一款基于大型语言模型(LLM)的高效文本转语音系统,能够生成高度自然、准确的语音。它采用创新的单流解耦语音令牌技术,直接从LLM预测的代码中重建音频,无需额外的生成模型,为企业级应用提供了强大而灵活的语音合成解决方案。 [![SparkAudio开源社区](https://raw.gitcode.com/gh_mirrors/sp/Spark-TTS/raw/2f1ea908

gitblog_00813的博客 1005

情感语音合成新范式:Spark-TTS文本情感驱动语音生成全指南

你是否还在为语音合成缺乏情感表现力而困扰?客户服务语音机器人语调生硬、有声书朗读缺乏情感起伏、智能助手无法传递情绪温度?本文将带你掌握Spark-TTS情感语音合成技术,实现从文本情感分析到情感语音生成的全流程落地,让你的语音交互系统真正"声"入人心。 读完本文你将获得: - 文本情感特征提取的核心方法 - Spark-TTS情感参数调优实战指南 - 多场景情感语音生成案例代码 - 情感迁移与声...

gitblog_00068的博客 423

Spark-TTS 0.5B 震撼发布:RTF低至0.04,开源TTS步入实时高清新纪元!

如果仅仅是快,那还不足以称为“新纪元”。Spark-TTS 的另一大杀手锏在于其卓越的**“高清”音质**。我们用**平均意见得分(Mean Opinion Score, MOS)**来衡量,这是一个 1 到 5 分的主观评价标准,分数越高,代表声音越自然、越清晰、越接近真人。Spark-TTS 0.5B 公布的 MOS 分数 稳定超过 4.1。MOS > 4.1 是什么水平?难以分辨: 一般认为 MOS 超过 4.0,普通听众就很难区分是机器合成还是真人录音。

nulifancuoAI的博客 1254

Spark-TTS语音合成中的方言转换:将普通话转换为方言

你是否遇到过这些场景:开发面向多区域用户的智能语音助手时,标准普通话无法满足地方用户的交互需求;构建文化传承应用时,难以将现代文本转换为地道的方言发音;或者在影视配音中,需要快速生成不同方言版本的语音内容?传统TTS系统往往受限于单一语言模型,难以实现精准的方言特征迁移。Spark-TTS通过创新的双编码架构和可控语音合成技术,为解决这些痛点提供了全新可能。 本文将系统讲解如何利用Spark-T...

gitblog_00321的博客 650

Spark-TTS语音合成异常检测:识别低质量合成音频的方法

你是否在使用TTS(Text-to-Speech,文本转语音)系统时遇到过这样的问题:合成音频突然出现机械音、断句混乱,或者情感表达与文本完全不符?在智能客服、有声阅读、语音助手等关键场景中,这类低质量合成音频不仅影响用户体验,还可能导致信息传达错误甚至商业损失。据Gartner 2024年报告显示,语音交互系统中30%的用户投诉源于合成音频质量问题,而传统人工质检成本高达每小时20美元,且准确率...

gitblog_00586的博客 413

Spark-TTS核心技术解析:单流解耦语音令牌如何提升TTS效率 3倍

想要了解如何通过创新的**单流解耦语音令牌技术**将文本转语音(TTS)效率提升3倍吗?Spark-TTS作为一款基于大语言模型的高效语音合成系统,通过其独特的架构设计彻底改变了传统TTS的工作流程。本文将深入解析Spark-TTS的核心技术原理,特别是**单流解耦语音令牌**如何实现高效语音合成,让您轻松理解这一前沿技术。 ## 🔥 什么是Spark-TTS? Spark-TTS是一款革命

gitblog_00066的博客 408

Spark-TTS代码实现原理:从文本输入到音频输出的完整流程详解

Spark-TTS是一款基于大语言模型(LLM)的高效文本转语音系统,它通过创新的单流解耦语音标记技术实现了高质量的语音合成。本文将深入解析Spark-TTS从文本输入到音频输出的完整工作流程,帮助您理解这一先进语音合成技术的实现原理。😊 ## 🔥 Spark-TTS架构概述 Spark-TTS采用端到端的语音合成架构,完全基于Qwen2.5大语言模型构建,无需额外的流匹配生成模型。这种设

gitblog_00745的博客 460

Spark-TTS新范式:语音合成技术的革命性突破与实战指南

Spark-TTS是一款基于先进AI技术的语音合成工具,它通过创新的深度学习模型,为用户提供高质量、自然流畅的语音合成体验。无论是语音克隆、自定义语音创建,还是文本转语音,Spark-TTS都能满足您的需求,让语音合成变得简单而高效。 [![SparkAudio Logo](https://raw.gitcode.com/gh_mirrors/sp/Spark-TTS/raw/2f1ea9082

gitblog_00313的博客 1048

让AI呼吸更自然:Spark-TTS语音合成中的呼吸声模拟技术

你是否注意到,许多AI语音合成听起来总像"一口气说完整段话"?缺乏自然呼吸节奏的语音,即便音色再逼真,也会让人感到机械和不自然。Spark-TTS通过创新的呼吸声模拟技术,让合成语音拥有了真人般的呼吸节奏,将语音真实感提升到新高度。读完本文,你将了解呼吸声模拟的技术原理、实现方式以及如何在实际应用中调整呼吸参数。 ## 呼吸声模拟的技术基石:自然语音的节奏密码 呼吸是人类语音的自然组成部分,在...

gitblog_00015的博客 633
上一篇: AutoAgent: 香港大学开源的AI智能体框架
下一篇: DevDocs:抓取并整理技术文档的MCP服务
小众AI
博客等级 码龄25年 1290粉丝 143原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
