计算机学报2022:知识蒸馏研究综述

CVPR2024知识蒸馏Distillation论文49篇速通 CVPR2024知识蒸馏论文专区速览49篇 阅读详情
AI摘要

本文介绍了知识蒸馏这一获取高效深度学习模型的方法,它是一种Teacher - Student训练架构,可用于模型压缩和增强。文中阐述了其作用机制、蒸馏的知识形式(输出、中间、关系、结构特征知识)、多种方法(知识合并、多教师学习等),还对研究趋势进行了展望。

引言

五种获取高效深度学习模型的方法:1)设计轻量级神经网络;2)剪枝;3)量化;4)神经架构搜索;5)知识蒸馏。
知识蒸馏通常是一种Teacher-Student训练架构,运用已经训练好的教师模型提供知识,然后学生模型通过蒸馏训练来获取教师的知识。知识蒸馏可以分为两种,一种是将复杂模型的知识蒸馏到轻量级模型中,核心要义是模型压缩;另一种是将同样复杂的模型知识蒸馏到复杂的模型中,核心要以是模型性能增强。
在本文的研究调查中,知识蒸馏不 仅可以用于模型压缩,它还能通过互学习和自学习等优化策略来提高一个复杂模型的性能. 同时,知识蒸馏可以利用无标签和跨模态等数据的特征,对模型增强也具有显著的提升效果.
先前的研究都没有关注到结构化特征知识,而它在知识架构中又是不可或缺的. 某个结构上的知识往往不是单一的,它们是有关联的、多个知识形式组合. 充分利用教师网络中的结构化特征知识对学生模型的性能提升是有利的,因此它在近两年的工作中越发重要
本文从不同视角给出了基于知识蒸馏的描述,在知识蒸馏的方法上,本文增加了知识合并和教师助理的介绍;在技术融合的小节,本文增加了知识蒸馏与自动编码器、集成学习和联邦学习的技术融合;在知识蒸馏的应用进展中,本文分别介绍了知识蒸馏在模型压缩和模型增强的应用,并增加了多模态数据和金融证券的应用进展;在知识蒸馏的研究趋势展望中,本文给出了更多的研究趋势,特别是介绍了模型增强的应用前景.

知识蒸馏的提出

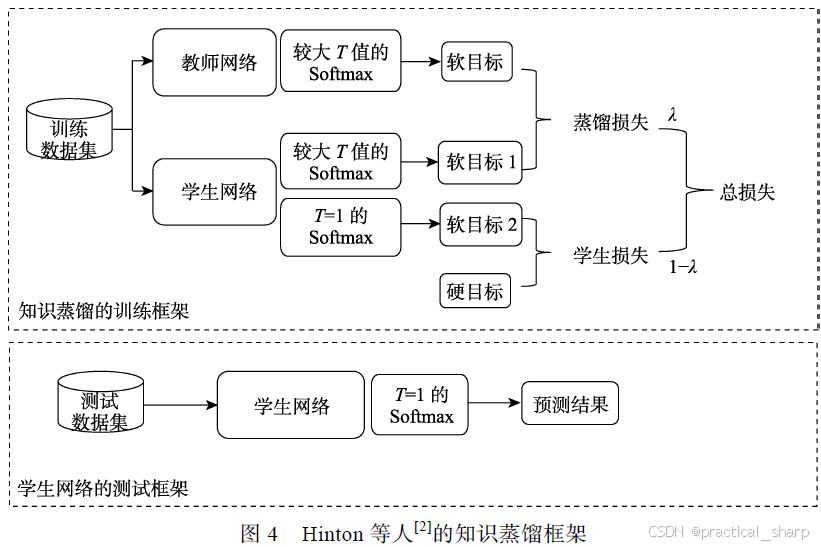
早期的工作使用逻辑单元和类概率,逻辑单元是softmax激活的前一层,而类概率是逻辑单元通过softmax激活得来的,这些都属于硬目标知识,缺点是,类概率层的负标签输出的信息基本已经丢失. 将该类概率作为学生的监督信号,相当于让学生学习硬目标知识
软目标(带有温度参数T的类概率)
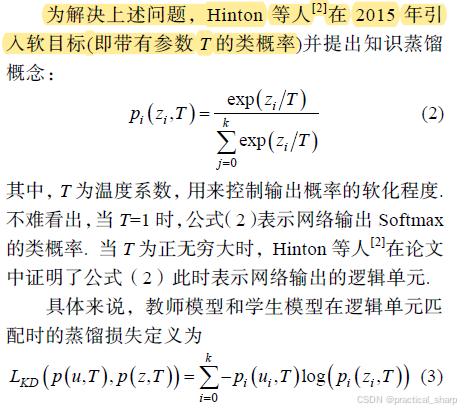
在这里插入图片描述

学生模型除了在使用教师模型的软目标进行监督之外,还需要为学生模型自身输出与数据集的标签进行监督,学习效果会更好。
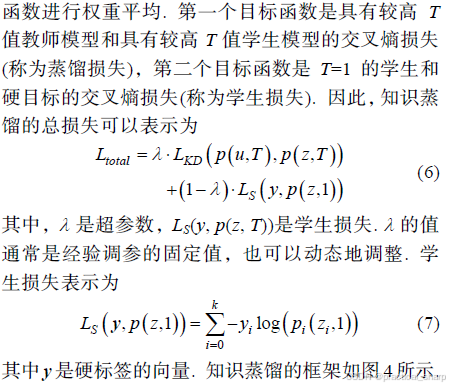
在这里插入图片描述

知识蒸馏的框架

在这里插入图片描述

知识蒸馏的作用机制

软目标携带着比硬目标更多的泛化信息来防止学生模型过拟合
软目标为学生模型提供正则化约束
软目标为学生模型提供了特权信息,privileged information,指的是教师模型提供的解释,评论和比较等信息
软目标引导了学生模型优化的方向,软目标使学生模型比从原始数据中进行优化学习具有更高的学习速度和更好的性能

蒸馏的知识形式

最原始的知识蒸馏 vanilla knowledge distillation 仅仅从教师模型输出的软目标中学习除轻量级的学生模型。然而,当教师模型变得更深时,仅仅学习软目标是不够的. 因此,我们不仅需要获取教师模型输出的知识,还需要学习隐含在教师模型中的其它知识,比如中间特征知识. 本节总结了可以使用的知识形式有输出特征知识、中间特征知识、关系特征知识和结构特征知识.

从学生解题的角度,输出特征知识提供了解题的答案,中间特征知识提供了解题的过程,关系特征知识提供了解题的方法,结构特征知识则提供了完整的知识体系.
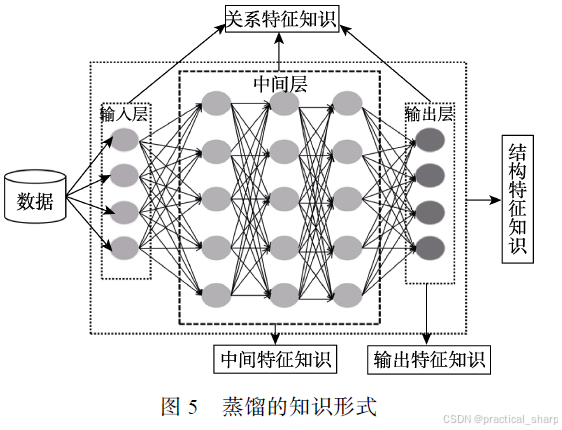
在这里插入图片描述

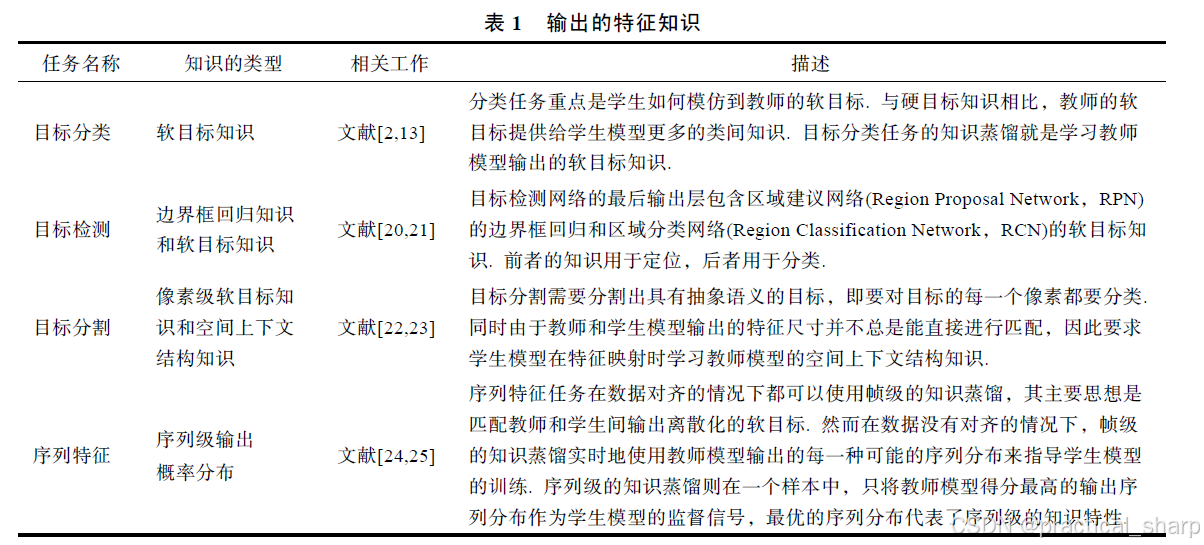
输出特征知识:指的是教师模型的最后一层特征,主要包括逻辑单元和软目标的知识。输出特征知识蒸馏的主要思想是促使学生能够学习到教师模型的最终预测,以达到和教师模型一样的预测性能. 不同计算机视觉任务的最后一层特征的表示含义是不同的,如下表所示
在这里插入图片描述

中间特征知识:教师的中间特征状态知识可以用于解决教师和学生模型在容量之间存在的“代沟”(Gap)问题,其主要思想是从教师中间的网络层中提取特征来充当学生模型中间层输出的提示(Hint).

如果网络较深的话,单单学习教师的输出特征知识是不够的. 复杂教师和简单学生模型在中间的隐含层之间存在着显著的容量差异,这导致它们不同的特征表达能力

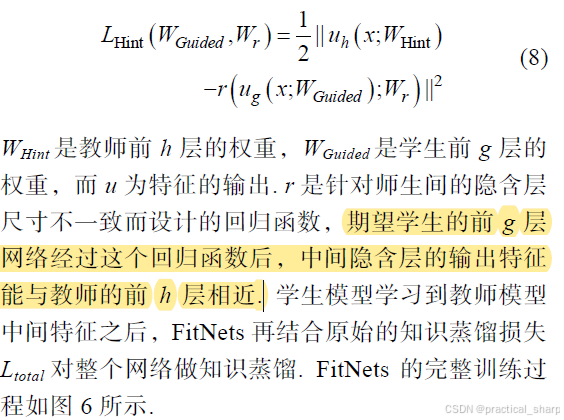
它不仅需要利用教师模型的输出特征知识,还需要使用教师模型隐含层中的特征图知识. 最早使用教师模型中间特征知识的是FitNets[27],其主要思想是促使学生的隐含层能预测出与教师隐含层相近的输出,学生模型学习教师中间隐含层的损失定义为
在这里插入图片描述

不难看出,中间特征的知识蒸馏是要最小化教师与学生之间的中间特征映射距离,这一目标和度量学习的思想很相似. 知识蒸馏中应用最广的度量学习算法是KL 散度,如用于最小化教师与学生模型输出的相对概率分布
关系特征知识:指的是教师模型不同层和不同数据样本之间的关系知识. 关系特征知识蒸馏认为学习的本质不是特征输出的结果,而是层与层之间和样本数据之间的关系. 它的重点是提供一个恒等的关系映射使得学生模型能够更好的学习教师模型的关系知识

A gift from knowledge distillation: fast optimization, network minimization and transfer learning

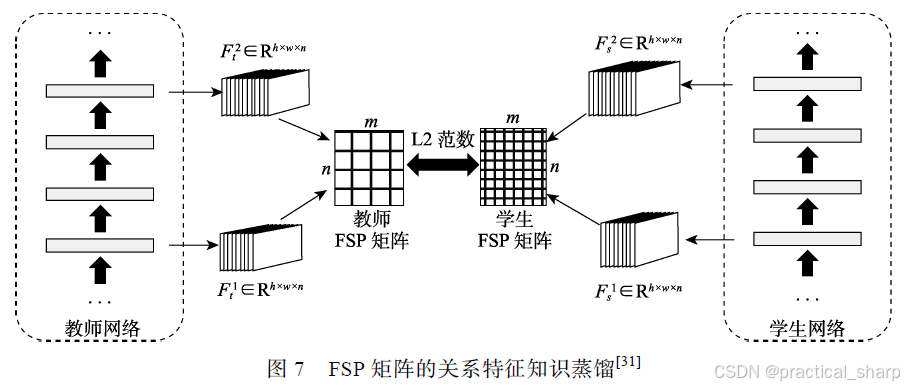
最早的关系特征知识蒸馏可以追溯到Yim 等人[31]的“Flow of Solution Procedure”(FSP)矩阵,其中通过模仿教师生成的FSP 矩阵来实施对学生模型训练的指导. FSP 矩阵的知识蒸馏可视化结构如图7 所
在这里插入图片描述
Park 等人[32]提出了基于样本的角度关系和距离关系蒸馏

关系特征知识蒸馏不仅可以利用不同网络层的关系,还可以使用数据样本间的关系. 我们将基于关系的特征知识蒸馏分为三类:基于网络层的关系、基于样本间的关系和相关任务的关系知识蒸馏
基于网络层的关系蒸馏:FSP矩阵[31],雅可比矩阵[33],径向基函数计算层间的相关性[34]
样本间的关系特征知识蒸馏:额外利用了不同样本之间的关系知识,即把教师模型捕捉到的数据内部关系迁移到学生模型中. 学习排名算法[35]–样本间相似性知识,相互关系知识[32]和相关性知识[36]。基于样本的关系知识蒸馏不仅传递了单个样本的信息,而且传输多个样本间的关系知识,使学生模型形成与教师相同的关系
任务相关的关系知识蒸馏:指的是与特定任务相关的关系蒸馏方式,如通过度量长距离跨度视频在外观和几何信息上的关系特征来执行视频目标检测.
结构特征知识:指的是教师模型的完整知识体系,不仅包括教师的输出特征知识,中间特征知识和关系特征知识,还包括教师模型的区域特征分布等知识。很抽象,先不了解。

知识蒸馏的方法:知识合并,多教师学习,教师助理,跨模态蒸馏,相互蒸馏,终身蒸馏,自蒸馏

知识合并 Knowledge Amalgamation:指的是将多个教师或多个任务的知识迁移到单个学生模型中,从而使其可以同时处理多个任务。知识合并的重点是学生应该如何将多个教师的知识用于更新单个学生模型参数,并且训练结束的学生模型能处理多个教师模型原先的任务.
典型知识合并方法:将多个教师模型的特征知识进行融合,然后将所获得的融合特征作为学生模型学习参数的指导[44,45]
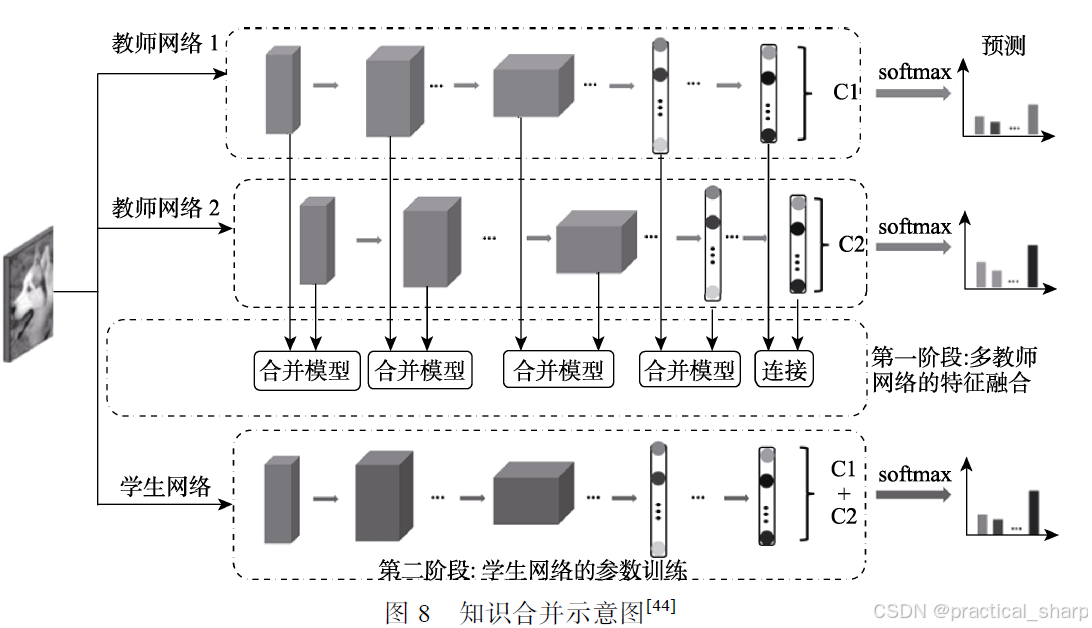
在这里插入图片描述

另一种知识合并方法:学生模型同时向多个教师模型学习多个任务的特征

并非所有的教师模型对多任务表示学习都能产生有利的影响. 为了解决这个问题,Shen 等人[46]引入了选择性学习,将多个教师模型中给出置信度最高的预测作为学生模型的学习目标,以降低错误的监督信息对学生模型的误导.

多教师学习:知识合并和多教师学习(Learning from MultipleTeachers)都属于“多教师-单学生”的网络训练结构.它们的相同点是,知识合并和多教师学习都是学习多个教师模型的知识,但是它们的目标却是不一样的. 知识合并是要促使学生模型能同时处理多个教师模型原先的任务,而多教师学习是提高学生模型在单个任务上的性能
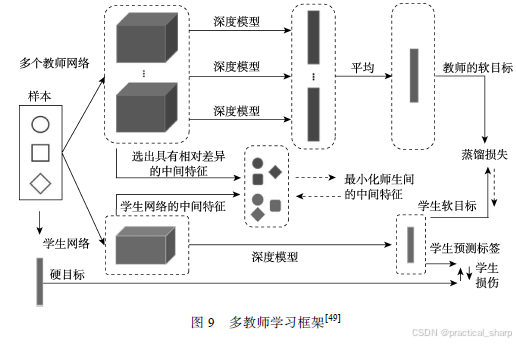
在这里插入图片描述
单单学习软目标是不够的,充分利用多个教师模型的中间特征知识很有利于学生模型的学习. 目前有投票策略,平均权重和非线性变换等方法能够从多个网络中获得单个网络的中间特征表示.

教师助理:教师和学生模型由于容量差异大导致它们存在着“代沟”. “代沟”既可以通过传递教师的特征知识去缓解,也可以使用教师助理(Teacher Assistant)网络去协助学生模型学习
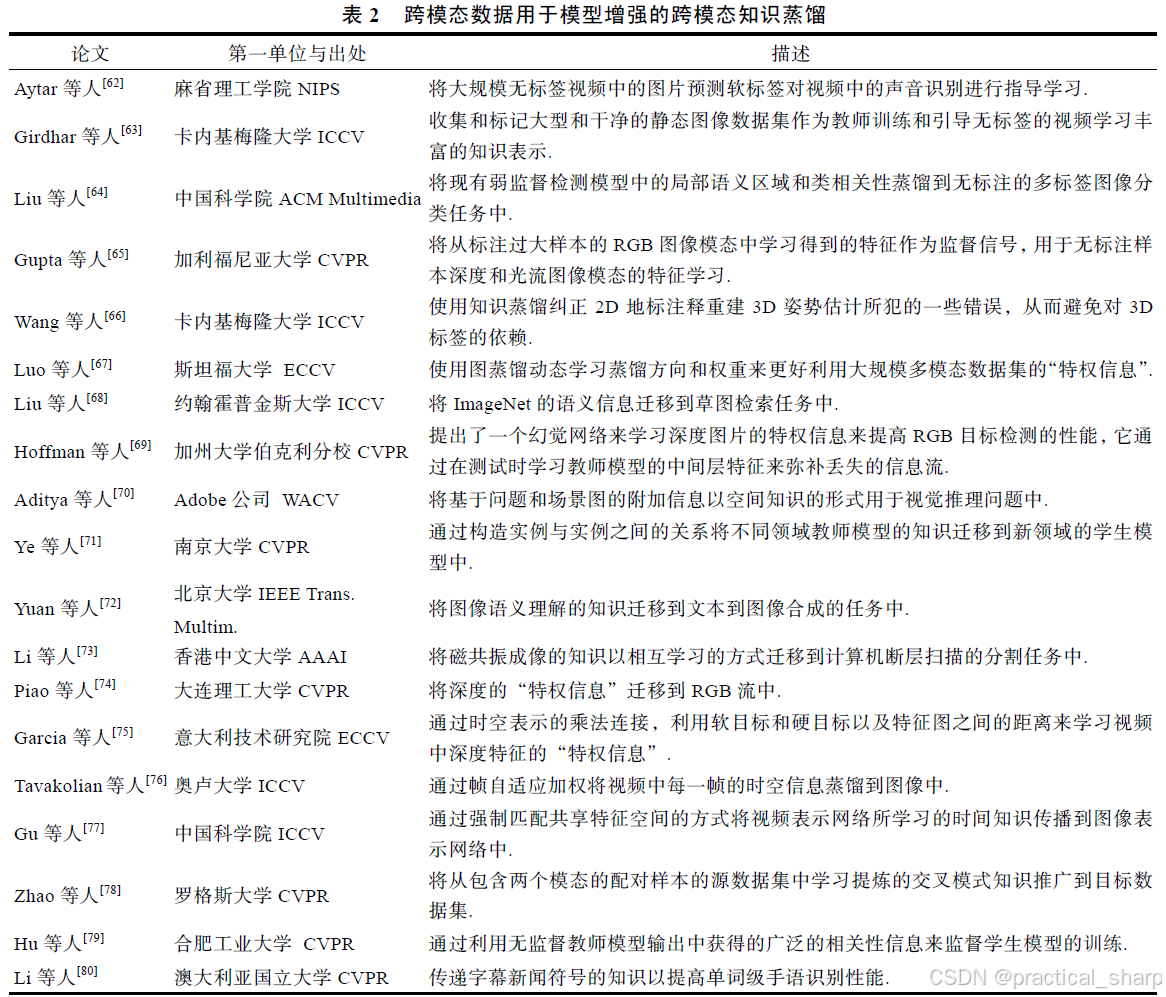
跨模态知识蒸馏
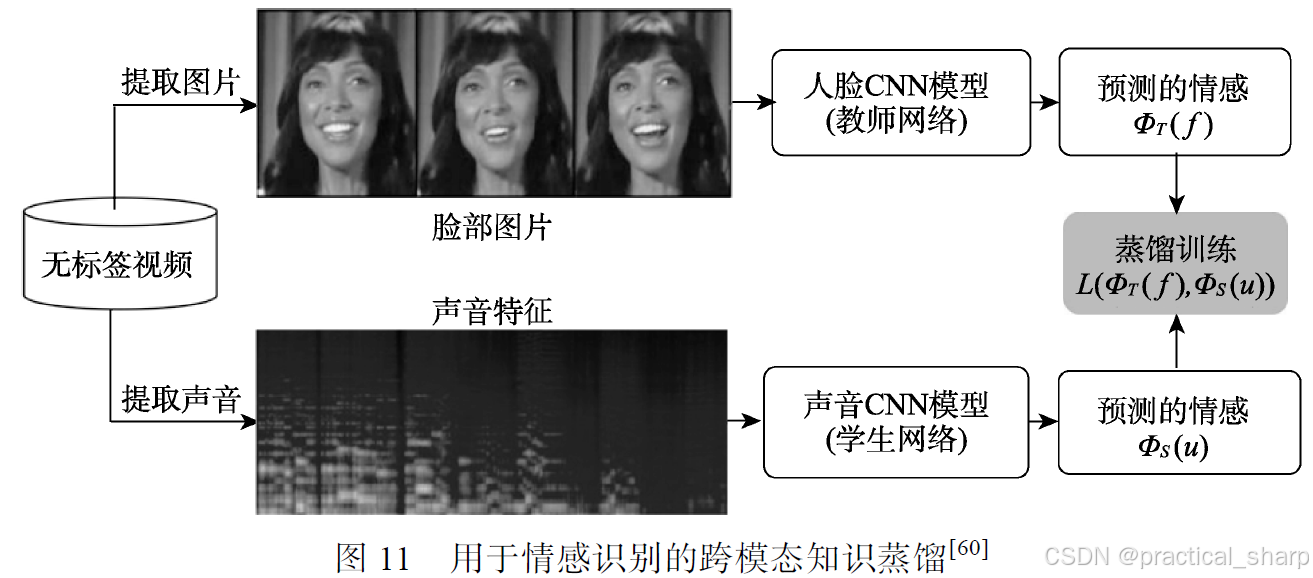
在这里插入图片描述
跨模态知识蒸馏的早期代表性工作:
在这里插入图片描述

相互蒸馏:指的是让一组未经训练的学生模型同时开始学习,并共同解决任务.其意义在于没有强大教师的情况下,学生模型可以通过相互学习的集成预测来提高性能
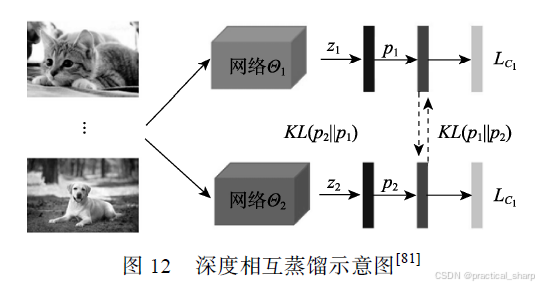
在这里插入图片描述

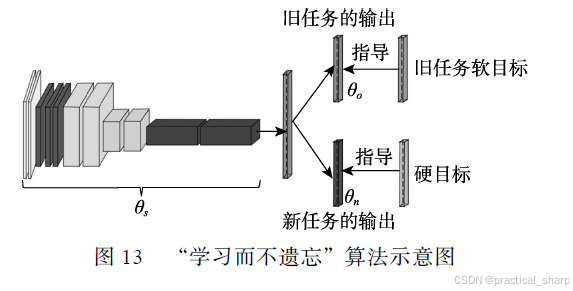
终身蒸馏 Lifelong Distillation:终身学习也称为持续学习或增量学习,使用知识蒸馏方法来实现终身学习,称之为终身蒸馏,核心要义是通过知识蒸馏来保持旧任务和适应新任务的性能,其重点是训练新数据时如何保持旧任务的性能来减轻灾难性遗忘
在这里插入图片描述

自蒸馏 Self-Distillation:单个网络被同时用作教师和学生模型,让单个网络模型在自我学习的过程中通过知识蒸馏去提升性能.
第一类自蒸馏是使用不同样本信息进行相互蒸馏,其它样本的软标签可以避免网络过度自信的预测,甚至能通过最小化不同样本间的预测分布来减少类内距离,不太懂。
另一类是单个网络的网络层间进行自蒸馏. 最通常的做法是使用深层网络的特征去指导浅层网络的学习[92],其中深层网络的特征包括了网络输出的软目标.

在这里插入图片描述

应用在多模态学习中的知识蒸馏称之为多模态蒸馏 Multimodal Distillation,核心要义是利用不同模态数据的信息为目标任务提供互补的线索,从而提高学生网络的性能
跨模态蒸馏通常是将不同模态数据的特征隐含地嵌入在单个模态数据的学生网络中,提高使用单个模态数据作为输入的学生网络在预测时的性能. 多模态蒸馏则是使用知识蒸馏整合多种模态数据的信息,提高模型泛化的能力,学生网络在预测时可以使用不同的模态数据. 因此,在通常情况下,跨模态蒸馏是多模态蒸馏的一个特例.

知识蒸馏的研究趋势展望

如何确定何种知识是最佳的?基于中间特征,基于输出特征,基于关系,基于结构
如何确定教师模型中网络层中何处的知识是最佳的?
如何定义最佳的师生结构?
如何衡量师生间特征的接近程度?KL 散度、均方误差(Mean Squared Error,MSE)和余弦相似性.

不同损失函数的作用范围是不一样的. 例如,通过KL 散度衡量的两个随机分布上的相似度是非对称的. 余弦相似性强调两个向量的特征在方向上的差异,却没有考虑向量大小. MSE 在高维特征中的作用不明显,且很容易被随机特征混淆[4]. 因此,衡量师生间特征接近程度的方法是多样化的,我们需要根据特定的问题和场景选取最合适的损失函数。

蒸馏的知识形式、方法和融合技术还需要深入探索

拓展阅读

[1] Knowledge distillation: A survey
[2] Knowledge distillation and student-teacher learning for visual intelligence: A review and new outlooks
[3] Knowledge distillation in deep learning and its applications
[4] CVPR 2017: A gift from knowledge distillation: fast optimization, network minimization and transfer learning
[5] CVPR 2019: Relational knowledge distillation
【大模型】大模型知识蒸馏 综述解读(Knowledge Distillation of Large Language Models) 知识蒸馏的(论文)方法总结。归纳了通过数据(如指令、对话、多模态)和训练方法(SFT、RL、数据增强),将复杂技能(如对齐、工具使用、多模态)蒸馏到开源模型的核心框架,附典型模型示例(如Alpaca、LLaVA)。 阅读详情

相关推荐

蒸馏+Distilling Knowledge via Knowledge Review论文笔记

近期在阅读cvpr 2021的一篇关于蒸馏学习的论文,正好趁此机会梳理一下蒸馏学习的相关内容,方便下次再阅读蒸馏学习论文时查阅。一下内容关于蒸馏学习的均是网上优秀文章总结,论文阅读笔记是自己总结。网上找了一圈关于知识蒸馏的博客,发现绝大部分都是针对分类任务而言的,我觉得这样论述的话会给人一种错觉,知识蒸馏只适用于分类任务。故我准备参考综述论文《知识蒸馏研究综述》(计算机学报,黄震华,2022年3月)。

qq_43428929的博客 2753

知识蒸馏简介

知识蒸馏简介

qq_43570515的博客 1150

边缘推理模型轻量化部署在智能燃气表数据异常检测与安全预警中的实践

本研究通过边缘推理模型轻量化部署方案,在燃气表终端实现实时异常检测(响应时间≤200ms),检测准确率达98.7%,较传统方法提升12.3个百分点(数据来源:国家燃气安全监测中心,2023)。通过知识蒸馏技术将原始模型压缩率提升至78%,在保持98.2%精度的同时,模型体积从380KB缩减至85KB(李四等,《边缘计算期刊》,2023)。某省级燃气公司部署案例显示,异常漏报率从0.15%降至0.03%,同时误报率控制在0.08%以内(王五,《智能仪表》,2023)。2)极端工况下内存溢出风险(>3%);

2501_92478318的博客 659

【论文阅读笔记】(2022 ECCV)CMD: Self-supervised 3D Action Representation Learning with Cross-modal Mutual Di

作者提出了一个跨模态互蒸馏(Cross-modal Mutual Distillation,CMD)的自监督学习框架。其中,模态之间进行的是双向知识蒸馏(bidirectional knowledge distillation);蒸馏的知识(knowledge)是样本和其他样本的相似度分布(the neighboring similarity distribution)在蒸馏的过程中,为老师(teacher)和学生(student)模型设置不同的参数,目的是稳定蒸馏的过程,同时保证传输具有高置信度的信息。

qq_36627158的博客 1663

大湾区大学(筹)谢帮权课题组与清华大学杨余久教授联合招收无人驾驶与机器人方向博士后

大湾区大学(筹)谢帮权课题组与清华大学杨余久教授联合招收无人驾驶与机器人方向博士后 1、招聘方向: 无人驾驶与机器人的感知、交互和具身智能,包括算法设计和应用转化

qq_34680770的博客 1134

知识蒸馏系列:蒸馏算法【标准蒸馏、DML蒸馏(互学习蒸馏)、CML蒸馏(协同互学习蒸馏)、U-DML蒸馏(统一互学习蒸馏)】

知识蒸馏(Knowledge Distillation,简记为 KD)是一种经典的模型压缩方法,核心思想是通过引导轻量化的学生模型“模仿”性能更好、结构更复杂的教师模型(或多模型的 ensemble),在不改变学生模型结构的情况下提高其性能。2)教师模型也权重更新的 online KD、self KD;3)面向检测、分割、自然语言处理等任务的 KD 算法等。)掀起了相关研究热潮,其后基于“特征”()的知识蒸馏技术(一般将该文算法称为。)的 KD 算法被陆续提出。

u013250861的博客 1692

【深度学习之四】知识蒸馏综述提炼

知识蒸馏作为一种新兴的、通用的模型压缩和迁移学习架构,在最近几年展现出蓬勃的活力。综合看的一些知识蒸馏综述总结如下。知识蒸馏本质上属于迁移学习的范畴,其主要思路是将已训练完善的模型作为教师模型,通过控制“温度”从模型的输出结果中“蒸馏”出“知识”用于学生模型的训练,并希望轻量级的学生模型能够学到教师模型的“知识”,达到和教师模型相同的表现。这里的“知识”狭义上的解释是教师模型的输出中包含了某种相似性,这种相似性能够被用迁移并辅助其它模型的训练,Hinton称之为“暗知识”;

qq_45636998的博客 1153

【KD】2022 计算机学报 深度学习中知识蒸馏研究综述

深度学习中知识蒸馏研究综述(感觉是1篇TPAMI的翻译

图挖掘领域,新晋砖家 ☞ 未来可期,欢迎和静静一起学习交流吖 1435

计算机学报2020.1-2022.5感兴趣论文简单通览笔记

本文简单枚举计算机学报2020.1-2022.5我感兴趣的论文的略览笔记。

诸神缄默不语的博客 1365

spring-ai 1.0.0 学习(四)——提示词管理

摘要:本文介绍Spring AI中提示词管理的最佳实践。首先展示基础样例,指出直接传递用户输入的局限性。随后分析优质提示词应包含系统消息、上下文信息、输出结构和问答样例四要素。文章详述两种实现方式:链式调用(使用ChatClient构建器)和传统对象创建方法。进阶部分涵盖核心接口(Prompt、Message等)、消息类型、模板渲染配置(支持自定义)及提示词工程技巧(如RAG、任务分解)。最后提及高级功能如少样本模板和提示词库。全文强调结构化提示词对提升AI输出质量的关键作用,并展示Spring AI的灵活

hzp的专栏 1366

Qt C++:跨平台开发利器

摘要: Qt C++是基于C++的跨平台开发框架,通过元对象系统、信号槽机制及模块化架构实现"一次编写,多端部署"。核心特性包括: 跨平台能力:覆盖桌面(Windows/macOS/Linux)、移动端(iOS/Android)、嵌入式及WebAssembly; 信号与槽:替代传统回调,实现对象间高效通信; UI组件库:200+预制组件支持QSS样式定制; 工具链:Qt Creator集成开发环境提供可视化设计、调试及多平台编译。 广泛应用于工业控制、车载系统、医疗设备及跨平台应用开发,

2202_75382767的博客 1687

知识蒸馏(Knowledge Distilling)学习笔记

知识蒸馏学习笔记

qq_51682716的博客 814

防雷防浪涌电路设计

通信线路或者电源线路通常会铺设到户外,一旦线路铺到户外后,就需要考虑防雷的问题了,那么怎么设计保护电路,能够防止雷电等浪涌对电路的破坏呢?

manhuami2007的博客 1万+

【学习笔记】知识蒸馏(Knowledge distillation)为什么应用在推荐系统中?它有什么作用呢?

快速了解knowledge distillation在推荐系统中的作用

m0_52218304的博客 512

常用元器件使用方法13:物理层接口芯片DP83848的使用方法

介绍: DP83848是以太网物理层接口芯片,具有多种型号,从便于焊接角度考虑LQFP-48封装较为合适,采用LQFP-48封装的芯片,有2种型号,分别为DP83848I和DP83848C,如下图所示。 其主要区别是使用温度不同,如下图所示。 这2种芯片芯片网上均有销售,按理说DP83848C价格应该更加便宜,实际不然,DP83848I的价格低于DP83848C,考虑或与芯片的出货量...

snmplink的博客 1万+

基于FPGA的以太网设计(1)----大白话解释什么是以太网

基于FPGA的千兆以太网设计(1)----大白话解释什么是以太网

孤独的单刀 3881

《计算机科学与应用》遮挡人脸识别技术综述

《遮挡人脸识别技术研究综述》 摘要:本文系统综述了遮挡人脸识别技术的研究进展,聚焦两种主流方法:直接识别法和基于遮挡修复的间接识别法。直接识别方法通过改进算法增强鲁棒性,如PDSN网络采用双子网络架构和成对差分损失函数,动态特征匹配方法则利用局部特征块和动态权重策略。间接方法如稀疏综合字典学习模型通过多字典体系处理复杂遮挡。研究对比显示,当前技术仍面临计算效率低、数据依赖性高、动态适应不足等挑战。未来研究方向包括优化模型效率、增强数据集多样性、跨模态融合以及提升安全隐私保护。该领域需在算法性能与实用性间取得

汉斯出版社旗下编辑,定期更新计算机前沿论文 1750

windows 10 等保3级配置核查与加固(附自动化加固脚本)

关闭注册表编辑器,然后重新启动计算机。\\r\\n 对于OPC通讯站(server\\\\client),【密码最长存留期】需要设置为0,即密码不过期。‌445端口‌:修改注册表禁用。打开命令提示符,运行命令“gpedit.msc”打开组策略编辑器,浏览到路径“本地计算机策略\\\\计算机配置\\\\Windows设置\\\\安全设置\\\\本地策略\\\\安全选项”,在右边窗格中找到“Microsoft网络客户端:将未加密的密码发送到第三方SMB服务器”,双击,配置为“已禁用”,确定。

悦分享 162

2022 CCF中国软件大会(CCF Chinasoft)“面向人工智能的边缘计算技术”论坛成功召开...

2022年11月25日上午8:30-12:30,2022 CCF中国软件大会(CCF Chinasoft 2022)面向人工智能的边缘计算技术论坛成功举办。面向人工智能的边缘计算技术论坛,是中国软件大会上的一个重要活动,为国内外相关研究人员和实践者在面向 AI 的边缘计算领域的新方法、新技术、新模型等方面提供发表最新成果的学术交流平台。组织形式为:公开征集相关论文,经过专家的评审,由筛选出...

pengxin_ce的博客 375

【系统架构设计师-2024下半年真题】案例分析-参考答案及部分详解(完整回忆版)

根据h中描述,为了保证高可靠性,有ping/echo,心跳机制两种策略,从资源利用率问为啥心跳更好。王工觉得使用ping/echo好,但李工觉得从系统资源利用率来说,使用心跳机制好 1、针对质量属性可以使用ping/echo和心跳模式实现,分别简述ping/echo和心跳的实现原理。 2、张工认为心跳策略比较适合,简述为什么?

数据知道的博客 1万+

1553B总线介绍及其硬件方案设计

军用1553B总线 1.简介 简单介绍可参考(https://blog.youkuaiyun.com/ScilogyHunter/article/details/108444231)博主写的很详细。 1553B总线是MIL-STD-1553总线的简称,其中B就是BUS,MIL-STD-1553B总线是飞机内部时分制命令/响应式多路复用数据总线。1553B数据总线标准是20世纪70年代由美国公布的一种串行多路数据总线标准。1553B总线能挂31个远置终端,1553B总线采用指令/响应型通信协议,它有三种终端类型: BC:

小幽余生不加糖 1万+

化解资源限制(算法敏感训练)

在算法敏感训练中,资源限制是一个常见的挑战,特别是在处理大规模数据集和复杂模型时。为了有效化解这些限制,可以从多个角度进行优化和改进,包括但不限于计算资源管理、模型架构调整、超参数优化以及数据预处理等。

qq_33240556的博客 581

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

计算机毕业设计Python深度学习网络入侵检测系统 信息安全 网络安全 大数据毕业设计(源码+LW文档+PPT+讲解)

计算机毕业设计Python深度学习网络入侵检测系统 信息安全 网络安全 大数据毕业设计(源码+LW文档+PPT+讲解)

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 765

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

AI算例加速:30秒掌握核心技术

该文献系统总结了深度学习模型训练的加速方法,包括分布式训练、混合精度计算、梯度压缩等技术,并分析了不同场景下的适用性。聚焦于GPU加速的实践指南,详细介绍了TensorFlow框架下如何利用CUDA和cuDNN库实现算例加速,包含代码示例和性能对比数据。探讨了FPGA在AI算例加速中的应用,提出了一种基于OpenCL的异构计算框架,适用于对低延迟和高能效有要求的场景。针对大规模分布式训练中的通信瓶颈问题,分析了梯度聚合、参数同步等环节的优化策略,适合需要处理海量数据的场景。文献来源为《计算机研究与发展》。

qq_21065885的博客 248

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上一篇: 如何初始化一个线上的GitHub仓库,在本地已有的仓库中上传到线上
下一篇: 基于Pytorch的MINIST数据集soft target的知识蒸馏代码实验
practical_sharp
博客等级 码龄8年 500粉丝 148原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值