聊聊几个MySQL“老生常被喷”点

数据库抗不住了?读写分离+分库分表才是稳住架构的“良心操作” 数据库高并发场景下,单库架构难以支撑业务增长。本文解析了两种核心优化方案:读写分离将读写操作分流到主从库,缓解主库压力;分库分表通过水平拆分数据提升扩展性。文章提供了Spring Boot+MyBatis的读写分离实现示例,以及ShardingSphere分库分表配置方案,并指出主从延迟、分片路由等关键注意事项。强调这些架构改造不是炫技,而是保障业务可持续发展的必要手段,建议从系统设计初期就考虑数据分布策略。文末总结了技术要点和工程实现方式,为数据库性能优化提供实践指导。 阅读详情

看喷有感

        这几天看到有公众号文章疯狂攻击MySQL,点进去看了一下,里面所谓的ACID、RR正确性问题,给大家介绍下背后的原理,以及为什么MySQL要选择这样的实现方式。

MySQL新版恶性Bug,表太多就崩给你看!----最近的这一篇,以及这里面引用的下面两篇

MySQL的正确性为何如此拉垮?
为什么说PostgreSQL前途无量?

        由于本人行业背景关系,对pg了解一点,对MySQL也了解一点,故有一点不同看法。

关于ACID

文章中原图如下,得出结论说MySQL不符合ACID,这  -_- !!!   -_- !!!   -_- !!!  -_- !!!
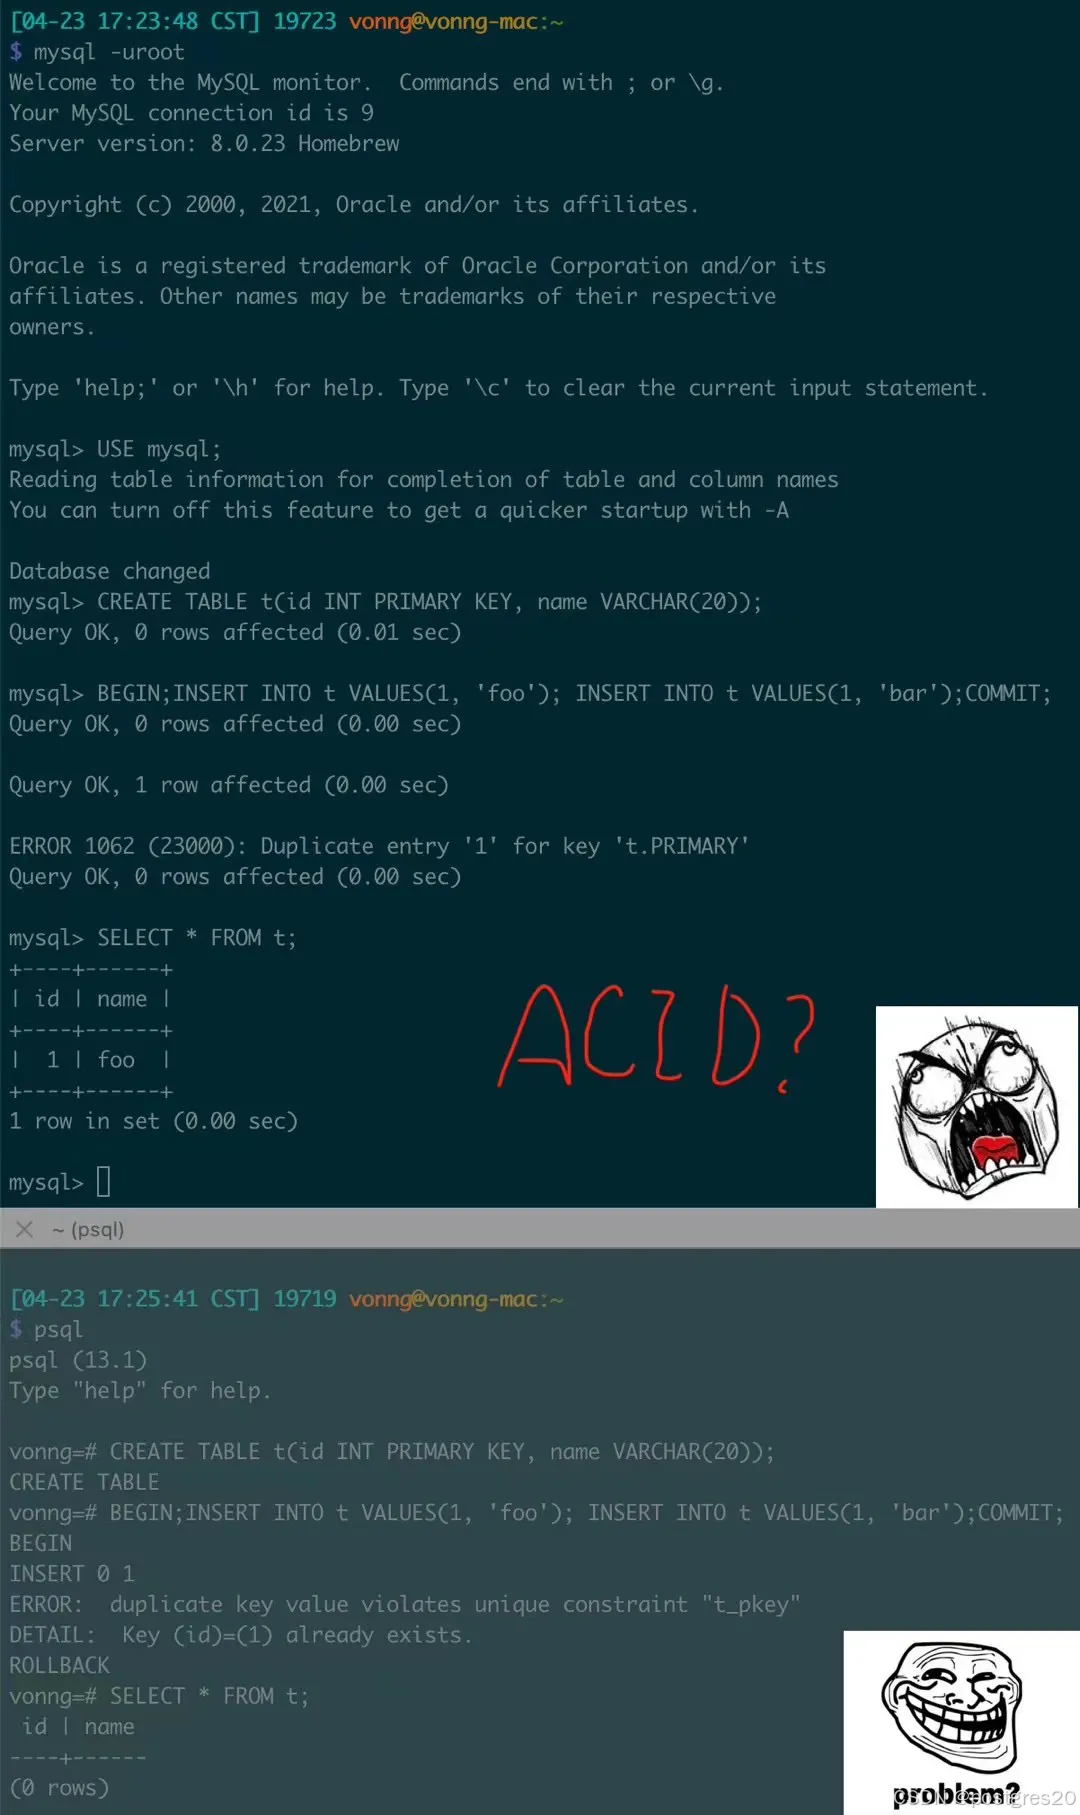
        在 MySQL 的事务处理中,出现错误并不会自动回滚整个事务,而 PostgreSQL 则会在发生错误时自动回滚整个事务。这是否意味着 MySQL 不符合 ACID 原则呢?

        实际上,上图中的最后一个 commit 已经给出了答案:MySQL只是将【提交】或【回滚】的选择权交给了用户而已!一个事务可能包含成千上万的增删改查SQL语句,在MySQL中,当某个语句执行出错后,用户可以根据错误信息进行处理,选择继续提交还是回滚。许多情况下,用户希望错误不影响之前的语句,那么就可以像上图一样直接提交;如果认为有影响,则可以选择回滚。选择权在用户手中。

        而在PostgreSQL中,发生错误时会强制回滚,用户没有选择权,即使用户执行的是 commit,也会被回滚,如上图所示。如果较真起来,PostgreSQL在这种情况下会丢失所有事务数据,而业务实际执行的是 commit,回滚并不是业务的预期结果。试想一个场景:某用户辛辛苦苦执行了几百条语句,某个语句手误出错,直接强制回滚整个事务,用户会是什么心态?硬要告诉用户ACID标准就是这样,所以要全部失败?为什么不能妥协一下,把选择权交给用户,让用户决定提交或回滚呢?用户来决策是否提交或回滚就不符合ACID了吗? -_- !!! -_- !!!

        此外这个公众号作者,列举的所有其它的用例sql都一条sql占一行,而这个用例偏偏把多条sql写在一行?为什么呢?这一行等价关系如下:

begin;insert into t values(1,'foo');insert into t values(1,'bar');commit;


--- 等价于下
begin;
insert into t values(1,'foo');
insert into t values(1,'bar');
commit;


        这好像也没啥,那复制过去执行一下如下:
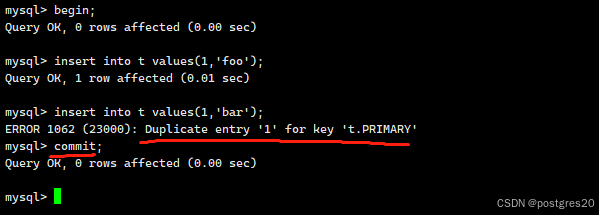
        如果分成多行输入,就会明显的看到,数据库已经报错了,用户仍然选择了提交。

       从技术上来说,MySQL 要支持在某个语句出错时强制回滚整个事务的能力,是非常容易实现的,执行出错时,my_error 捕获到错误打印错误信息的同时,增加一个ha_rollback就可以搞定,不存任何在技术难度,是现有功能。反而 PostgreSQL 使用 sigsetjmp 和 siglongjmp 这种“大跳”进行内部错误处理,如果要改造成类似 MySQL 这样的,出错时让用户来决定提交or回滚,还是略有些麻烦的,当然也不是什么大问题。那么,MySQL为什么非要支持这种麻烦的用法呢?真想统计下,有多少pg从业者,接到过客户这种类似需求,最后帮客户改写plsql部分实现?

       标准规定是死的,技术、业务、解决方案等是不断进化的,如果有对用户和业务更加灵活好用的方案,为什么不能改变呢? ORACLE数据库他就遵守什么sql92、sql99标准了吗?标准不是用来自嗨的,服务好用户才是最终的标准!

关于正确性

先说结论

        MySQL这么设计实现,是为了高并发下保证数据一致性的同时提高并发性能的设计选择,所谓的“内部一致性错误” 、“中间状态”是为了尽可能的保障性能的前提下的一种妥协。

公众号提到的两个问题

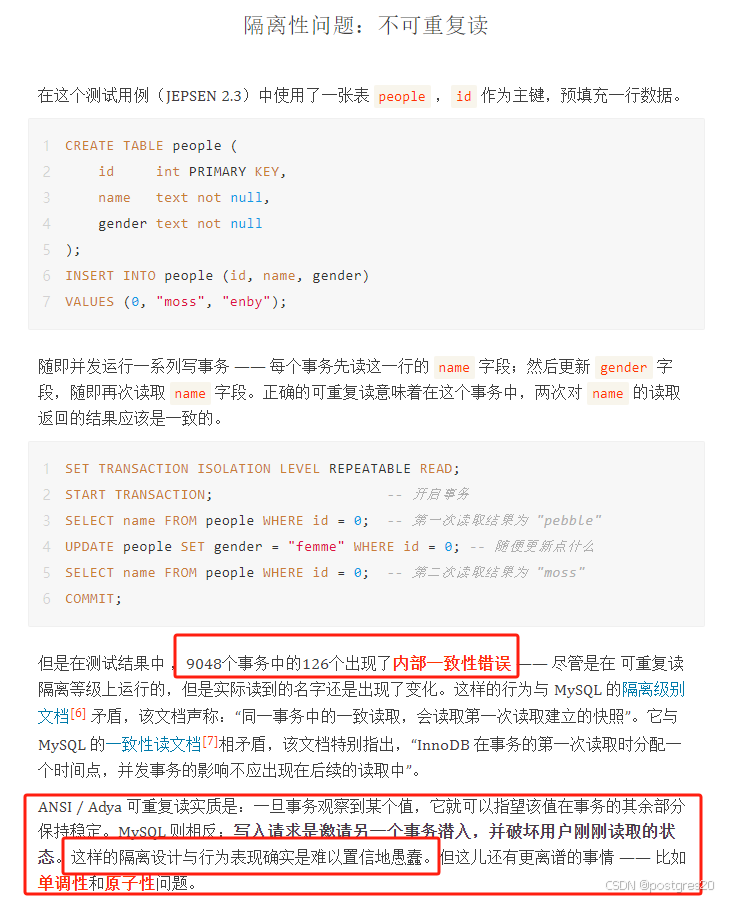
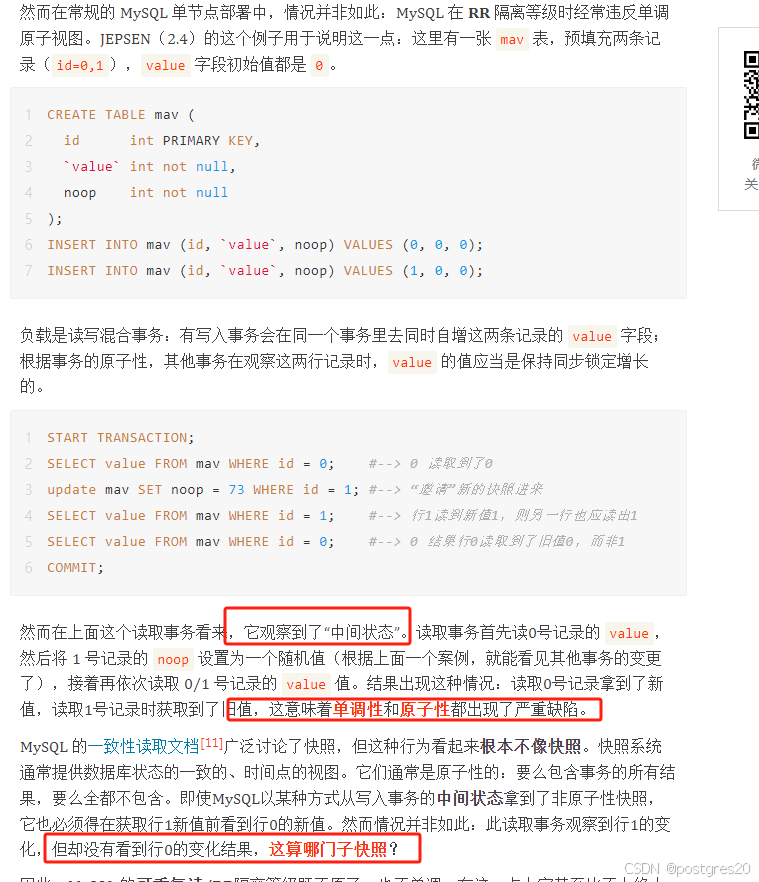
        公众号作者提到的 “隔离性问题” 和 “原子性问题" 这两个问题,引用的是什么 JEPSEN  的测试,这所谓的两个问题实际是一个问题,但设计那么复杂的测试用例,精确到 【9048个事务中的126个出现了内部一致性错误】,以及原子性问题 【它观察到了“中间状态”】,这就有点耐人寻味了,原图如下:

第一个问题原文
第二个问题原文
第一个用例解析与复现

        原图已经奉上,为什么要说“耐人寻味”呢?这几个用例设计的有些水准,在看起有些“复杂”的并发场景中跑一阵之后,就有数据不一致或者不符合预期的情况出现,给人一种错觉,这是MySQL的重大缺陷。且这几个用例,直接复制过来跑是不能复现上面所说的情况的,具有一定迷惑性,也能显示出这个测试机构的“水准”。

        这些用例的设计者应该是清楚或部分清楚MySQL这里的机制与逻辑的,但这个公众号作者是否了解就不好说了,下面我详细剖析一下这几个用例,以及为什么MySQL要这么实现,有什么优劣。

原用例1:

CREATE TABLE people (
    id     int PRIMARY KEY,
    name   text not null,
    gender text not null
);
INSERT INTO people (id, name, gender) 
VALUES (0, "moss", "enby");

SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
START TRANSACTION;                     -- 开启事务
SELECT name FROM people WHERE id = 0;  -- 第一次读取结果为 "pebble"
UPDATE people SET gender = "femme" WHERE id = 0; -- 随便更新点什么
SELECT name FROM people WHERE id = 0;  -- 第二次读取结果为 "moss"
COMMIT;


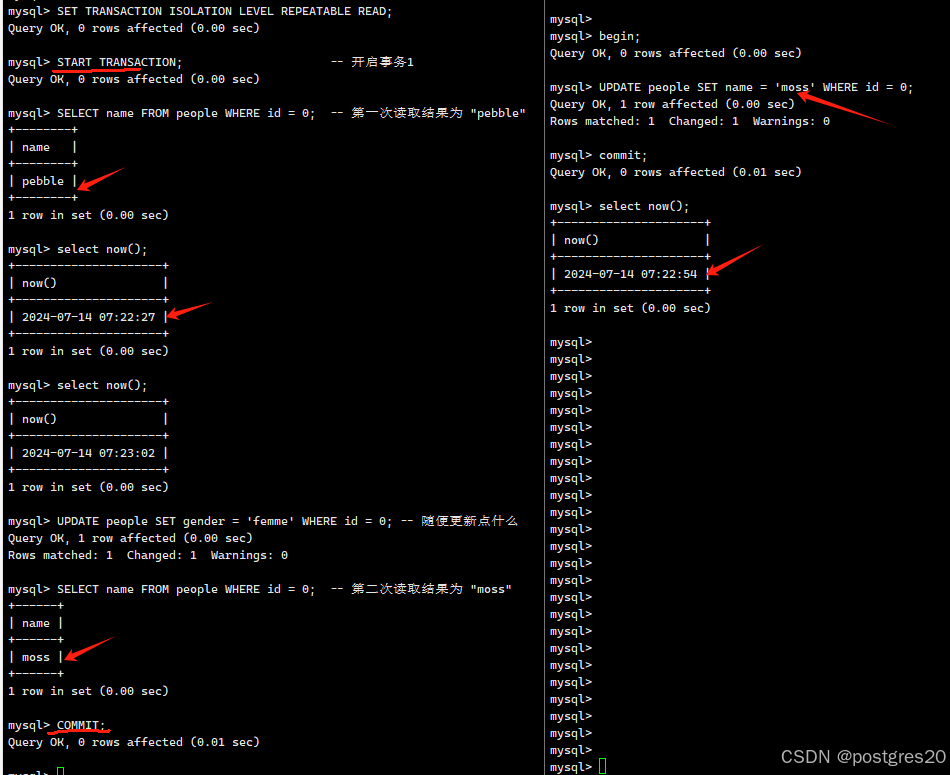
        原文说“9048个事务中的126个出现了内部一致性错误”,这个用例直接复制过来执行不会出现原文说的情况,把它稍改造一下,让它不用并发也能100%出现“内部一致性错误”,如下:

drop table people;
CREATE TABLE people (
    id     int PRIMARY KEY,
    name   text not null,
    gender text not null
);
INSERT INTO people (id, name, gender) 
VALUES (0, 'pebble', 'enby');


SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;  
START TRANSACTION;                     -- 开启事务1
SELECT name FROM people WHERE id = 0;  --第一次读取结果为 "pebble"

-------另开一个线程执行下面sql,并确保提交
BEGIN;
UPDATE people SET name = 'moss' WHERE id = 0; 
COMMIT;

-------回到事务1连接继续执行下面语句

UPDATE people SET gender = 'femme' WHERE id = 0; -- 随便更新点什么
SELECT name FROM people WHERE id = 0;  -- 第二次读取结果为 "moss",“不一致”
COMMIT;

        串行执行上面用例,完全不用任何并发,就会100%出现name为moss的所谓的"内部一致性错误", 如下图:
MySQL可见性判断逻辑为何如此设计?

        MySQL采用的回滚段方式实现的MVCC,而PG用的是页面内多版本方式实现MVCC(见文章Postgresql MVCC机制源码初探)。

        MySQL在更新时会产生版本链,最新的版本在页面上,老版本在回滚段中,物理页面元组上有指针指向老版本,形成版本链。判断是否可见依赖快照,快照是一个数组,里面存了所有活跃事务ID。MySQL根据行上的事务ID以及这个快照数组,可以判断出当前记录是否可见。所谓的RR和RC隔离级别,在判断可见性时没有区别,本质是完全相同。差别在于RR只在事务第一个语句执行时生成快照,而RC是在事务中的每个语句执行时都要生成一次快照。RR相对于RC的性能优势就在此,有非常多资料介绍MySQL的MVCC机制,这里不再展开。

        继续,MySQL通过快照判断可见性逻辑中,还有一个类似“超级用户权限”的逻辑:当前事务操作的行,当前事务默认可见(当然PG也是这样的)。举个例子,当前事务插入了一行,这一行记录当前事务立即可见,即使当前事务没提交,这很合理吧。当前事务删除了一行,这一行当前事务立即不可见,即使当前事务没提交,这也很合理吧。当前事务更新了一行,这一行的更新内容当前事务立即可见,即使当前事务没提交,这也.....等等,测试用例中的问题是否出现了?

        设计用例中的更新语句:

        UPDATE people SET gender = "femme" WHERE id = 0;

        看起来与 name 字段无关,它更新的是gender字段,而实际上,由于 name  已经在这个语句之前被更新成了 moss  , 所以这个 update 与下面语句是等价的:

        UPDATE people SET gender = "femme" ,name ="moss" WHERE id = 0;  (不管是pg还是mysql,物理元组或行是可操作的最小单位,有变化的字段更新,没变化的字段原样拷过去)

        所以,当前事务自己更新的内容,被当前事务看到,在可见性判断上是合理的,这里快照读到没有任何问题。

MySQL的争议点

        那MySQL在其它方面就没有可疑点吗?当然有,这里真正的问题是这个更新操作为什么可以看到了RR不应该看到的数据。这就涉及MySQL的另外一个机制,更新数据时,使用的是当前读,非快照读!即更新永远都读到最新的数据,可以理解成更新时用的RC级别,只要提交就可见(未提交则等锁)。

        简单来说就是两个原因导致了这个测试结果:

        1. 更新使用的是当前读,永远读最新数据。

        2. 当前事务对自己事务内的修改完全见。

        那么MySQL更新为什么要使用当前读呢?

        为了提升并发性能与容错性,当前读读到的数据是已经提交的数据,逻辑上不会有什么问题,最大的后果就是等价于退化到RC级别,但这样处理后对并发处理数据就非常友好了。                

        为什么当前读会对并发处理数据很友好呢?

        假如更新依旧要用快照读,那么更新就可能在旧版本上更新,其它事务可能已经提交了更新版本,在旧版本更新肯定是不对的,一定会造成数据不一致,怎么办?只能报错,遇到这种情况就报错,这就是PG的逻辑,它物理元组上有xmin和xmax是知道这行记录是被什么事务插入,被什么事务更新过的,当二次更新一个旧数据时,会直接报错:could not serialize access due to concurrent update,MySQL更新逻辑则是永远读最新版本来解决这个问题。

        试想一下,RR隔离级别下,一个事务A产生快照开始执行,在它提交前,晚于事务A开始的其它更新事务已经提交,如果A事务要修改过晚于A事务提交的数据,一律报错,并且,PG的逻辑,会彻底的贯彻执行ACID,只要报错就回滚整个事务,那在热点冲突数据稍微多一点的场景中,有并发修改相同数据的情况下,会产生大量“could not serialize access” 问题导致业务应用很难流畅的跑下去。而MySQL的设计逻辑,这种场景完全没问题,当然会有一个“后果”,并发修改的数据,实际会退化到RC级别,如果业务应用在一致性要求上不能接受,那么就使用RC级别,在性能和一致性之间,由用户自己去做权衡决策。

        另外,有个题外问题读者朋友可仔细以考虑下:为什么MySQL默认隔离级别用RR,而PG默认隔离级别用RC呢?  

        所以说MySQL这么设计实现,是为了高并发下保证数据一致性的同时提高并发性能的设计选择,是为了尽可能的保障性能的前提下的一种妥协。

第二个用例解析与复现

        至于第二个问题,什么“原子性问题:非单调视图”,其实是重复凑数问题,原因还是一样:

        1. 更新使用的是当前读,永远读最新数据。

        2. 当前事务对自己事务内的修改完全见。

        由于原因相同,不再展开啰嗦,附一下简化不需要并发即可复现用例如下,有兴趣的同学自己去玩一下:

drop table mav;
CREATE TABLE mav (
  id      int PRIMARY KEY,
  `value` int not null,
  noop    int not null
);
INSERT INTO mav (id, `value`, noop) VALUES (0, 0, 0);
INSERT INTO mav (id, `value`, noop) VALUES (1, 0, 0);

begin;   -- 事务1
SELECT value FROM mav WHERE id = 0; 


begin;  -- 事务2
update mav SET  value = 1 WHERE id = 1;
update mav SET  value = 1 WHERE id = 0;
commit;

 -- 事务1继续
update mav SET noop = 73 WHERE id = 1;
SELECT value FROM mav WHERE id = 1;    #--> 行1读到新值1,则另一行也应读出1
SELECT value FROM mav WHERE id = 0;    #--> 0 结果行0读取到了旧值0,而非1  
commit;

小结

     数据库设计应该重视客户体验,充分考虑业务应用需求实际场景,而不是老想着教育用户,你们应该怎么用数据库,强制用户按设计者思维使用数据库。不可否认,pg是一款优秀且先进的数据库,有非常多值得MySQL学习的地方,同样MySQL也一款优秀的数据库,有非常多值pg学习的点。上文提到的ACID与一致性相关问题,并不是说谁就一定是对的,谁一定是更好的。对于用户来说,他们不会因谁标榜自己最先进就选谁,也不会因为谁说自己最流行就选谁,一定会是基于自己的业务场景,技术储备,后续运维的便利性,性价比等非常多的综合因素才决定选什么数据库的。不可能有一款数据库能适用任何场景,但任何场景一定有一款最适合的数据库,用户会做出最符合自己业务逻辑的选择。

     建议pg加上MySQL的事务中报错不回滚模式供用户选择,同时建议MySQL加上pg这样的事务中报错就回滚的模式供用户选择,大家相互学习,共同进步嘛,多元多彩的世界多有意思,单极单调的世界多无趣!

      另外,泼妇骂街除了显示自己的愚蠢,没有其它收益,就事论事即可!

        

CentOS 7环境下MySQL离线安装脚本详细指南 简介:在服务器资源受限或网络不稳定的生产环境中,MySQL的离线安装成为关键部署方式。本文档以CentOS 7系统为基础,提供完整的MySQL离线安装流程说明,涵盖依赖库准备、MySQL服务安装、数据库初始化、服务启动与自启配置、以及安装验证等环节。通过结构化脚本化操作,帮助运维人员高效、安全地完成无网络环境下的MySQL部署,适用于企业级本地化数据库搭建需求。 阅读详情

相关推荐

局放起始电压(PDIV)与击穿电压(BDV):绝缘系统设计的核心参数 [特殊字符]

在电力设备绝缘系统设计中,**局放起始电压(Partial Discharge Inception Voltage, PDIV)和击穿电压(Breakdown Voltage, BDV)**是两个至关重要的参数。它们直接反映了绝缘材料的性能和绝缘系统的可靠性,对变压器的设计、制造和运行具有重要指导意义。本文将深入探讨这两项参数的定义、测试方法及其与绝缘设计制造的关系,帮助读者全面理解其在电力设备中的核心作用。

mubiao05的博客 2640

老生常谈:聊聊mysql幻读问题?

之前有位小伙伴美团三面,一直被追求「幻读是否被 MySQL 可重复度隔离级别彻底解决了?」

wdj_yyds的博客 394

保姆级教程:在Ubuntu 22.04上用VLLM+OpenWebUI部署DeepSeek-R1-14B(含Q8量化模型下载)

本文提供在Ubuntu 22.04上使用VLLM和OpenWebUI部署DeepSeek-R1-14B大语言模型的完整教程,包括环境配置、模型下载、VLLM参数调优及OpenWebUI集成。特别针对Q8量化模型优化部署流程,解决CUDA版本冲突等常见问题,适合开发者快速搭建本地AI对话系统。

weixin_26712075的博客 430

2021-Java后端工程师面试指南-(MySQL)

前言文本已收录至我的GitHub仓库,欢迎Star:https://github.com/bin392328206/six-finger种一棵树最好的时间是十年前,其次是现在Tips 面试...

qq_42820805的博客 2139

首个基于LBS方案的3D传感器,VoxelSensor解析

该传感器将结合OQmented的Lissajous模式的MEMS扫描镜,与每帧逐行工作的光栅扫描相比,Lissajous轨迹扫描速度更快,并且能耗很低,它可以更快地捕获完整的场景和快速移动,并且需要更少的数据处理,可满足AR/VR对于低延迟、高效率的需求。简单来讲,Switching Pixels的区别是专注于识别激光事件,性能比普通事件相机更好,但也可以使用事件相机的算法。在具体应用中,它需要在X和Y方向发射一个或多个脉冲光束,以在X和Y轴上定位,而Z轴,也就是深度,则是通过计算光返回的时间来测量。

qingtingwang的博客 576

mybaits-plus通用CRUD详解及代码案例

文章目录mybaitsplus通用CRUD插入操作方法定义测试用例mybaitsplus主键生成策略设置自增主键设置输入主键:UUID:ID_WORKER_STR:ID_WORKER:更新操作根据id更新方法定义:方法步骤根据条件更新方法定义:更新步骤:根据条件更新(可以更新NULL)删除操作根据id删除方法定义:删除步骤:根据 entity 条件删除方法定义:删除步骤:根据ID 批量删除方法定义:删除步骤:查询操作根据id查询方法定义:查询步骤:根据id批量查询方法定义:查询步骤:根据 entity 条件

流楚丶格念的博客 3407

把 mysql 整个加载进内存磁盘中_MySQL 罢福特普洱

今天来水水一篇mysql的关于Buffer Pool的知识点(以下写的都是Innodb存储引擎)大家都知道mysql中的数据都是以页为单位来读取的,mysql从磁盘读取一个页的数据,然后用户再在内存中获取到需要的数据,但其实这中间还有很多细节,接下来就来看看吧。什么是BufferPool首先要知道Buffer Pool是什么,Buffer Pool就是用来保存我们从磁盘中读取出来的一个...

weixin_32349711的博客 1293

基于Java+SpringBoot+Vue的热门网游推荐系统设计与实现

本文详细介绍了基于Java+SpringBoot+Vue技术栈的热门网游推荐系统的设计与实现过程。系统采用前后端分离架构,后端使用SpringBoot构建RESTful API,前端使用Vue.js框架实现用户界面,结合MySQL数据库进行数据存储。系统实现了用户管理、游戏信息管理、个性化推荐、评论互动等核心功能,并采用了协同过滤推荐算法为用户提供个性化的游戏推荐。本文将从需求分析、系统设计、技术选型、核心功能实现以及系统测试等方面进行全面阐述。关键词:Java;SpringBoot;Vue.js;

2201_76125393的博客 74

mysql看慢查询配置_聊聊Mysql——SQL优化、慢查询、配置优化

SQL优化是程序员老生常谈的事情,也是一个不可避免需要处理的事情,当系统性能得到一个瓶颈,优化SQL或许是一种让系统再次飞起的策略,可能效果不是很明显,但更多的细微优化,性能也随之提升。对数据库操作的慢查询是让程序员很头疼的事情,怎么样才能让慢查询变得不是那么慢呢?本文将讲述SQL优化的几种策略,以及SQL优化后针对慢查询再次改善的方案。常用SQL优化策略利用索引对查询进行优化,要尽量避免全表扫描...

weixin_36382534的博客 130

【定位模块项目实战】gnss_localizer、lidar_localizer功能包解析

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言一、1.2.3.4.二、1.2.3.4.三、1.2.3.4.四、1.2.3.4.总结参考资料 前言 认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长! 本文先对**【无人驾驶autoware项目实战】感知–定位模块**做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章 提示:以下是本篇文章正文内容 一、 1. 2. 3. 4. . . 二、

qq_35635374的博客 1931

SPI为什么不需要加上拉电阻

大家好,我是记得诚。I2C因为其开漏的结构,无法输出高电平,所以外部加上拉电阻。我们在使用SPI的时候,发现是不需要加上拉电阻的。主要因为SPI多为推挽的结构,推挽电路,高低电平都可以输出,所以外部不需要加上拉电阻。推挽电路可以用2个三极管或者2个MOS管搭建而成。

记得诚 2632

避坑指南:Win11 WSL安装MySQL8.0时遇到的ERROR 1396和远程访问配置问题

本文详细解析了在Windows 11的WSL环境中安装和配置MySQL 8.0时常见的ERROR 1396错误及其解决方案。文章深入探讨了用户权限绑定、网络配置(如修改bind-address)以及如何安全地启用远程访问,并提供了Docker部署作为更灵活的替代方案,帮助开发者高效搭建本地数据库开发环境。

linux6sysadmin的博客 1027

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

面试官:MySQL的架构体系是什么?

最近群里一位兄弟在面试中被问到:「MySQL的架构体系是什么」。 今天我们就来聊聊MySQL的架构体系,尽管咱们是java开发人员,但是在日常开发过程中也会经常和MySQL数据库打交道。如果公司有DBA能干点事还稍微好点,如果是没有DBA或者DBA没什么卵用的情况下,我们还是很有必要了解MySQL的整个体系的,况且在面试中遇到了也是一个加分项。 今天来聊一聊 Mysql 缓存池原理。 提纲附上,话不多说,直接干货。 前言 面试官:同学,你能说说Mysql 缓存池吗? 狂聊君:啊,这么

wdj_yyds的博客 256

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

mysql优化之N+1问题

周六收到老大通知说我之前写的两个接口因数据量过大有性能问题????,快乐的周末就这么没了。当时写接口的时候光想着实现功能未考虑性能问题。嗨呀,那写的叫一个舒坦,很快啊,左一个if判断,右一个for循环,for循环里面再加几个QueryWrapper查询,最后再用一下stream过滤一下数据,畅快淋漓,贼顺畅,当时多顺畅现在重构接口就多苦逼。 mysql优化一些老生常谈的咱就不细说了,像什么索引,加索引的注意点,索引失效的情况,不要用select *查询,where后面不要进行非空判断之类的,大家都是工作一

Aurora_____的博客 2314

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

字节三面:能说一说MySQL缓存池吗?

最近群里一位兄弟在面试中被问到:「MySQL的架构体系是什么」。今天我们就来聊聊MySQL的架构体系,尽管咱们是java开发人员,但是在日常开发过程中也会经常和MySQL数据库打交道。如果公司有DBA能干点事还稍微好点,如果是没有DBA或者DBA没什么卵用的情况下,我们还是很有必要了解MySQL的整个体系的,况且在面试中遇到了也是一个加分项。今天来聊一聊 Mysql 缓存池原理。提纲附上,话不多说,直接干货。面试官:同学,你能说说Mysql 缓存池吗?狂聊君:啊,这么难吗,容我组织一下语言。(内心OS:这T

wdj_yyds的博客 346

告别“刀耕火种”!我用Maven搭建的现代化开发“武器库”

嘿,各位新来的小伙伴们,今天想和大家聊聊一个老生常谈但又至关重要的工具——Maven。它远不止这些,但掌握了以上内容,你已经足以应对90%的日常开发场景,并且能理解它背后的设计思想。你不需要去记零散的命令,只需要告诉Maven你想达到什么“阶段”,它会自动执行该阶段之前的所有步骤。这套结构是所有Maven项目的通用语言,任何人拿到你的项目,都能立刻明白代码和资源在哪,极大地降低了沟通成本。Maven规定好了你的项目应该长什么样,你只要按图索骥就行,再也不用为“代码应该放哪”而纠结。如此循环,简直让人崩溃。

热爱WebGIS的博客 1050

MySQL课程

后来才明白,范式这东西,不是书上写着玩的,前三个范式尽量遵守,能避免未来很多扯皮的事儿。尤其记得配置 my.cnf(或者 my.ini,看你的系统)里的字符集,直接 utf8mb4 走起,别用那老的 utf8,存个表情符都不行,到时候追妹子想在用户昵称里加个😊都报错,多尴尬。还有那个 sql_mode,一定要根据你的业务场景严格设置,比如 ONLY_FULL_GROUP_BY 这种,一开始不严格,等数据量上来了,小组件一升级,满屏的报错能让你体会到什么叫“社会险恶”。SQL语句的编写,这里面的水也挺深。

2509_93946403的博客 366

聊聊Java程序员就业现状!

Java面试是一个老生常谈的问题。每年到了金三银四&金九银十这种跳槽黄金季就会有一大批程序员出来面试找工作。流程就是熟悉的网上开始找面试题,面试手册,面试宝典,一收藏就是一大把,看到什么都觉得Nice,看几眼之后就收藏夹吃灰,对面试其实起不到什么实际性帮助。

wdj_yyds的博客 293

数据缓存刷新_面试官:能说一说MySQL缓存池吗?跑的快怎么了,也能追上

最近群里一位兄弟在面试中被问到:「MySQL的架构体系是什么」。今天我们就来聊聊MySQL的架构体系,尽管咱们是java开发人员,但是在日常开发过程中也会经常和MySQL数据库打交道。如果公司有DBA能干点事还稍微好点,如果是没有DBA或者DBA没什么卵用的情况下,我们还是很有必要了解MySQL的整个体系的,况且在面试中遇到了也是一个加分项。今天来聊一聊 Mysql 缓存池原理。提纲附上,话不多说...

weixin_42297444的博客 147

MySQL核心语句实战指南:从基础语法到高级优化与避坑

SQL(结构化查询语言)是操作关系型数据库的标准语言,其核心原理是通过声明式语法对数据进行增删改查及定义管理。掌握SQL不仅能实现数据存取,更能通过查询优化、索引设计、事务控制等技术,在保证数据一致性与安全性的前提下,大幅提升应用性能,这是其核心的技术价值。在各类互联网应用、企业系统及数据分析场景中,高效、安全的SQL语句是支撑高并发访问与复杂业务逻辑的基石。本文将聚焦于MySQL这一广泛应用的关系型数据库,深入解析其常用语句的实战应用与高级特性。针对高频的查询操作,会详细探讨如何利用索引优化SELECT语

weixin_29913663的博客 234

最新出炉!2026年金三银四Java初中高级面试1000问

这份面试总结比较多,就不一一的详细介绍了,粗略的将主要内容展示一下,其中含有20+的知识点:目录总览目录详览基础篇JVM篇多线程&并发篇Spring篇MyBatis篇SpringBoot篇MySQL篇SpringCloud篇Dubbo篇Nginx篇MQ篇Linux篇Zookeeper篇Redis篇分布式篇网络篇设计模式篇maven篇ElasticSearch篇tomcat篇Git篇软实力篇内容一览JVM知识点汇总锁、线程MybatisZookeeper。

sjkflw121150的博客 298

2025年金九银十Java初中高级面试1000问

这份面试总结比较多,就不一一的详细介绍了,粗略的将主要内容展示一下,其中含有20+的知识点:目录总览目录详览基础篇JVM篇多线程&并发篇Spring篇MyBatis篇SpringBoot篇MySQL篇SpringCloud篇Dubbo篇Nginx篇MQ篇Linux篇Zookeeper篇Redis篇分布式篇网络篇设计模式篇maven篇ElasticSearch篇tomcat篇Git篇软实力篇内容一览JVM知识点汇总锁、线程MybatisZookeeper。

m0_50180963的博客 701

Golang高并发:深入解析Go+MySQL生产级数据库架构 (连接池、Context)

《构建高并发Go+MySQL数据库层的核心实践》 本文分享了支撑日均亿级请求的Go+MySQL数据库层设计经验。关键点包括: 连接池管理:正确配置MaxOpenConns(100-200)、MaxIdleConns(20-30%最大连接数)和ConnMaxLifetime(1小时)等参数,平衡性能与资源消耗。 安全CRUD操作:严格使用预处理语句防止SQL注入,推荐使用go-zero框架自动生成安全的CRUD代码。 实战案例:以临床研究系统为例,展示如何初始化连接池和实现安全的数据库操作,强调通过压测验证配

张国良的博客 927

我在PHP里学到的“套路”与“反套路” 设计模式与依赖注入

PHP开发中常用的设计模式与依赖注入实践。

ZHOUPUYU的博客 441
上一篇: glibc缺陷居然会导致MySQL卡住?
postgres20
博客等级 码龄10年 100粉丝 25原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

