解决scrpay-redis空爬问题

scrapy-redis所有request爬取完毕,如何解决爬虫空跑问题? scrapy-redis所有request爬取完毕,如何解决爬虫空跑问题?1. 背景 根据scrapy-redis分布式爬虫的原理,多台爬虫主机共享一个爬取队列。当爬取队列中存在request时,爬虫就会取出request进行爬取,如果爬取队列中不存在request时,爬虫就会处于等待状态,行如下:E:\Miniconda\python.exe E:/PyCharmCode/redisClawer 阅读详情

scrapy-redis在爬取页面完成后会处于空爬状态,不会自动结束
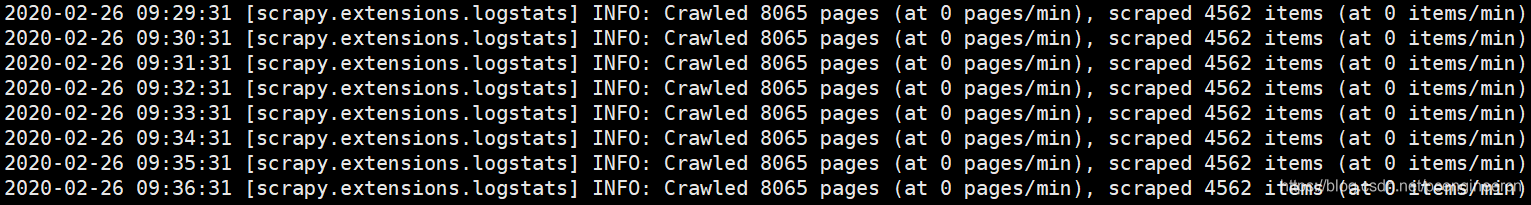
 可以通过配置scrapy扩展来解决这个问题

在项目目录新建extensions.py

import time

from scrapy import signals
from scrapy.exceptions import NotConfigured


class ScrapyRedisAutoClose(object):
    def __init__(self, item_count, crawler):
        self.item_count = item_count
        self.crawler = crawler
        self.count = 0  # 统计空闲次数
        self.idle_time = None  # 记录时间,可有可无

    @classmethod
    def from_crawler(cls, crawler):

        # 判断是否启用扩展
        if not crawler.settings.getbool('MYEXT_ENABLED'):
            raise NotConfigured

        # MYEXT_ITEMCOUNT 默认10分钟,时间单位为12次每分钟,空闲时5秒进来一次
        item_count = crawler.settings.getint('MYEXT_ITEMCOUNT', 120)

        ext = cls(item_count, crawler)

        crawler.signals.connect(ext.spider_opened, signal=signals.spider_opened)

        crawler.signals.connect(ext.spider_closed, signal=signals.spider_closed)

        crawler.signals.connect(ext.spider_idle, signal=signals.spider_idle)  # 加载空闲信号

        return ext

    def spider_opened(self, spider):
        spider.log("opened spider %s" % spider.name)

    def spider_closed(self, spider):
        spider.log("closed spider %s" % spider.name)

    def spider_idle(self, spider):
        """
        记录信息,作出关闭选择
        :param spider:
        :return:
        """
        # 记录第一次进入的时间
        if self.count == 0:
            self.idle_time = time.time()

        # 判断redis_key中是否为空,如果为空时,则空闲一次,统计 + 1
        if not spider.server.exists(spider.redis_key):

            self.count += 1
        else:
            self.count = 0

        # 空闲超过指定次数,结束程序
        if self.count > self.item_count:
            spider.log("spider continued idle number exceed:%s  idle datetiem exceed:%s" % (
                self.count, time.time() - self.idle_time))
            # 发送结束信号
            self.crawler.engine.close_spider(spider, 'close spider')

修改settings.py

# redis没有requests时自动关闭爬虫
MYEXT_ENABLED = True  # 开启扩展
MYEXT_ITEMCOUNT  = 60  # 配置空闲持续时间单位为 60个 ,一个时间单位为5s,即5分钟

# 在 EXTENSIONS 配置,激活扩展
EXTENSIONS = {
    '<项目名>.extensions.ScrapyRedisAutoClose': 540,
}



VC Spyglass实战指南:从零开始掌握CDC约束配置与调试 本文详细介绍了如何使用VC Spyglass进行CDC约束配置与调试,从基础环境搭建到典型CDC问题调试实战,帮助开发者快速掌握跨时钟域验证技术。通过TCL脚本和SDC约束的深度解析,提升CDC验证效率,避免常见设计风险。 阅读详情

相关推荐

使用 Ansys Q3D 进行电容提取

精确的电容提取在高速和 RF 设计中至关重要。在本博客中,我们演示了如何使用Ansys Q3D Extractor来计算电容值,从基本的平行板电容器开始,然后转到MEMS芯片的切口,以检查焊盘和RF线对整体电容的影响。在下面的比较中,我们使用 Q3D 从 MEMS 芯片切口中提取两种配置的电容矩阵:一种仅带有焊盘,另一种带有连接到 RF 线路的焊盘。这种比较表明,焊盘是总电容的主要贡献者,而 RF 线路则略有增加。按照上述工作流程,提取焊盘的电容,得到的电容矩阵如下所示。,选择一个已识别的网络,然后单击。

jkh920184196的博客 1816

解决Scrapy-Redis爬取完毕之后继续空跑的问题

解决Scrapy-Redis爬取完毕之后继续空跑的问题

p15097962069的博客 211

自学ROS完成智能小车路径规划(一)--配置功能包

此系列文章记录本人学习ros的过程,将会尽可能详细以便自己能够看懂 参考系列:古月居老师,优快云,ROS tutorials,科大讯飞智能车竞赛线上赛 本文章的目标: 比较全局路径规划算法中A*算法与Dijkstra算法在该地图场景下的规划与运行时间 比较局部路径规划算法中DWA算法与TEB算法在该地图场景下的规划与运行时间 在同等参数条件下选择出各自适合的算法进行融合,经过比较,我将选择dijkstra算法作为全局路径规划算法,TEB算法为局部路径规划算法 第一步,按照科大讯飞的教程配置文件 科大讯

weixin_42621524的博客 9366

解决 scrapy redis爬虫空跑,redis中的链接跑完后,程序仍然在监听队列,不关闭问题

平时使用scrapy redis主从式爬虫的时候,一般都是每天都会有爬取,所以没有考虑过这个问题,但是现在有个爬虫项目,redis队列是直接生成的,并且数量是一定的,所以在使用 scrapy slave时,需要判断一下队列是否已经被爬取完毕!经过度娘指点,知道了需要重写spider_idle 方法,在该方法中写自己的规则来判断是否要停止爬取。我在此基础上写了自己的规则,不需要像他一样等待那么长时间,我只要判断redis为空时,立刻停止爬虫即可。...

m0_67393828的博客 676

AI人工智能与TensorFlow的教育科技应用

随着科技的飞速发展,AI人工智能在各个领域都展现出了巨大的潜力,教育领域也不例外。本文章的目的在于深入探讨AI人工智能与TensorFlow在教育科技中的具体应用,包括智能教学系统的开发、学生学习情况的评估与预测等方面。范围涵盖了从基础概念到实际项目应用的各个层面,旨在为教育科技工作者和相关研究者提供全面且深入的技术指导。本文将首先介绍AI人工智能和TensorFlow的核心概念及其联系,让读者对相关技术有基本的了解。接着详细讲解核心算法原理和具体操作步骤,并结合数学模型和公式进行深入分析。

AI智能探索者的博客 1699

【STM32系统】基于STM32+手机APP设计的智能停车场系统

功能简介1、进出停车场时需要刷卡,进行一个记时、计费的功能。2、停车位配有超声波检测,主要识别车位是否被占用。3、车位区域配有OLED显示屏,用户可以通过显示屏看到空闲车位。4、车位配有车位灯。当用户找不到车位可以通过手机点亮车位灯5、停车场配有温湿度检测和烟雾检测模块。当环境发生异常状态。会触动紧急报警。6、停车场信息会通过Wi-Fi发送数据上传至阿里云。用户可以通过手机了解到停车场空闲车位和停车时间、费用。

嵌入式阿齐Archie 2万+

scrapy-redis空跑如何中止,队列为空时自动关闭scraper

在旧版的scrapy-redis中可能并没有相关的配置,因此需要自己去实现,参考:https://cloud.tencent.com/developer/article/1406573。使用scrapy-redis,可以将scrapy的爬取任务分布式部署,这里指的是同一个爬虫可在多个设备上或者同一个设备上部署多个实例。在使用调度器,比如cron, interval等调度器自动创建爬虫任务时,先前创建的爬虫在执行完任务后并不能自动退出,这样造成爬虫实例越来越多。但是稍后的版本,直接通过配置的方式即可实现。

逐月 821

基于 STM32 的乒乓球发球机控制系统设计与实现

乒乓球发球机是一种能够按照预设参数自动、连续发出乒乓球的训练设备。本系统以 STM32F103C8T6 为主控核心,通过控制实现球速调节、实现落点与旋转方向控制、实现出球节奏控制,并配合 OLED 显示与按键人机交互,实现速度、频率、落点、旋转四大参数的可调发球训练。

weixin_42300449的博客 213

python scrapy_redis 解决断点续爬时request请求为空, 再次启动时爬取失败办法

如果在使用scrapy进行断点续爬的时候 正好request中没有要爬取的链接了, 这个时候如果直接启动爬虫项目则会续爬失败, 达不到断点续爬的目的, 为此经过测试得出解决办法 注意点一 需要在次启动程序时候, 当作新的一个请求, 从新往redis中设置start_url值, 但此时需要注意, 翻页的时候就得添加dont_filter=True, 因为如果不加scrapy会自动进行去重请求, 假如翻页的这几个链接已经被爬取过了, 当从头跑的时候, 经过去重集合去重, 会认为所有的页码都已经爬取过了, 然后爬

一勺菠萝丶的博客 1199

【100%通过率】华为OD机试真题 C++ 实现【水库蓄水问题】【2022.11 Q4 新题】

给定一个长度为 n 的整数数组height。数组的元素表示山的高度,选择两个元素作为水库的边界,求蓄水量的最大值并输出蓄水量最大时的边界下标(蓄水量相同时输出下标较近的)。

MISAYAONE的博客 1万+

数据库小技能:数据导入脚本

背景:版本大升级,从2.0升级到3.0 ,服务端开发语言从c#换到java语言。数据库类型从microsalft sql server 换到mysql。数据来源于微信,用于查询卡bin。

专注于计算机研发知识和资讯分享 775

scrapy_redis配置

scrapy_redis服务

qq_64075230的博客 629

相位偏折PMD全栈技术拆解 | 四步相移解算+梯度积分形貌重建,助力镜面工件微米级缺陷高精度稳定检测

工业精密检测领域中,高反光镜面类工件长期存在检测瓶颈,涵盖汽车高亮车漆、半导体抛光晶圆、光学透镜、精密抛光模具、玻璃盖板等主流产品。传统2D机器视觉仅能识别表面明显污渍、大尺寸破损,完全无法捕捉微米级划痕、凹坑、橘皮、曲面微形变等微观缺陷;常规线激光3D、普通结构光3D检测设备,面对镜面材质会产生严重镜面反射杂光,激光条纹、结构光图案完全失真,必须喷涂显影粉辅助检测,不仅破坏工件表面完整性,还无法适配自动化量产产线,检测效率与良率极低。

getusushu的博客 544

Scrpay解决增量重复过滤的URL

在使用scrapy抓取网页的时候,我们通常会有个增量的需求,但是在这个过程中就会牵涉到一个url去重功能.一般去重复我们可以使用不同的策略,根据数据量的大与少,使用的策略也不一样。对于数据量不是很大的情况下,可以直接使用md5算法,然后把抓取过得存放到一个文本内容,下一次再抓取的时候直接对比文件内容是否有,有的话就跳过,没有的话就重新抓取。但是对于数量是海量的情况下,如果放在文本里面有几个缺点:1...

贾红平 903

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

爬虫面经--中网数据

1.介绍一下你的爬虫项目 2.我看你用的scrapy-redis,当时用了几台机器? 2.scrpay到scapy-redis的转换 3.爬虫中遇到的反爬策略 4.selenium了解吗? 5.xpath中的一些函数(substring\substring-before) 6.容器docker了解吗? 7.python的多线程(GIL) ...

Candance_star的博客 536

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

scrapy分布式爬虫部署

来自包子的傲娇 下载scrapy_redis模块包 打开自己的爬虫项目,配置scrapy项目使用的调度器及过滤器 3:修改自己的爬虫文件 4:.如果连接的有远程服务,例如MySQL,Redis等,需要将远程服务连接开启,保证在其他主机上能够成功连接 5:配置远程连接的MySQL及redis地址 6:修改MySQL的my.ini文件,以MySQL8为例 路径在C:\ProgramDa...

qq_40084869的博客 475

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

爬虫教程( 6 ) --- CrawlSpider、RedisCrawlSpider、Bloom Filter

追踪(CrawlSpider)、过滤(布隆过滤)、去重、解析

freeking101的博客 6564

基于Python实现的文章整合搜索引擎网站(Scrapy+Django+MySQL)

在熟练运用 Python 语言的基础上,更加深入的掌握开源的爬虫框架 Scrapy,为后续其他与爬虫相关的业务奠定理论基础和数据基础;爬虫的应用领域非常广泛,目前利用爬虫技术市面上已经存在了比较成熟的搜索引擎产品,如百度、谷歌,以及其他垂直领域搜索引擎,这些都是非直接目的;zset,hash 等数据结构的存储。(1)Redis 支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。Redis 是完全开源免费的,遵守 BSD 协议的,高性能的 key-value 数据库。

毕业作品网站 1218

爬虫基础之Scrapy框架架构

目录 Scrapy框架 Scrapy框架介绍: Scrapy架构图(Scrapy 使用了 Twisted异步网络库来处理网络通讯): Scrapy框架模块功能: Scrapy运行流程大概如下: 安装和文档: 快速入门: 创建项目: 目录结构介绍: spiders包:以后所有的爬虫,都是存放到这个里面。 使用Scrapy框架爬取糗事百科段子项目 糗事百科Scra...

qq_43158393的博客 884

终极Serf内部架构解析:从消息处理到状态同步的完整工作流指南

Serf是一款强大的服务编排与管理工具,通过高效的 gossip 协议实现分布式节点间的状态同步与事件处理。本文将深入剖析Serf的核心架构,揭示其从消息传递到集群状态维护的完整流程,帮助开发者理解分布式系统的设计精髓。 ## 一、Serf核心架构概览 Serf的架构设计围绕分布式系统的三大核心挑战展开:**成员管理**、**状态同步**和**事件传播**。其底层依赖高效的gossip协议实现

gitblog_00648的博客 450

[236]解决Scrapy-Redis 空跑问题,链接跑完后自动关闭爬虫

Scrapy-Redis 空跑问题,redis_key链接跑完后,自动关闭爬虫 问题: scrapy-redis框架中,reids存储的xxx:requests已经爬取完毕,但程序仍然一直运行,如何自动停止程序,结束空跑。 分布式扩展: 我们知道 scrapy 默认是单机运行的,那么scrapy-redis是如何把它变成可以多台机器协作的呢? 首先解决爬虫等待,不被关闭的问题: 1、s...

周小董 5157

scrapy_redis 解决空跑问题,自动关闭爬虫

使用过scrapy_redis框架的人一定知道,scrapy redis 在没有requests的时候,会阻塞等待接收start_url,程序无法自动结束。那如何自动停止程序,结束空跑呢??? spider_idle 信号 scrapy.signals.spider_idle(spider) 当spider进入空闲(idle)状态时该信号被发送。空闲意味着: requests正在等待被下载...

qq_31362537的博客 2576

解决scrapy+redis分布式爬虫 空跑问题

问题说明: 在scrapy 结合redis做分布式爬取时,会出现scrapy已经完成爬取,但是爬虫却不会结束,一直等待新的url。  将以下代码复制即可   实现: 1. 在settings.py目录下创建一个extensions.py文件,代码如下 # -*- coding: utf-8 -*- # Define here the models for your scraped ...

Pylemon Blog 1313

scrapy-redis分布式爬虫框架详解

scrapy-redis分布式爬虫框架详解 随着互联网技术的发展与应用的普及,网络作为信息的载体,已经成为社会大众参与社会生活的一种重要信息渠道。由于互联网是开放的,每个人都可以在网络上发表信息,内容涉及各个方面。小到心情日志,大到国家大事。 互联网已成为思想文化信息的集散地,并具有传统媒体无法相比的优势:便捷性,虚拟性,互动性,多元性。...

weixin_34072857的博客 1192
上一篇: Scrapy配置Redis集群
下一篇: ElasticSearch集群搭建
pcengineercn
博客等级 码龄10年 4粉丝 19原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值