关于二叉查找树的一些题目

二叉查找树(BST)定义及类模板实现,及相关面试题目 文章目录一、二叉搜索树的概念二 、二叉搜索树操作2.1. 二叉搜索树的查找2.2 二叉搜索树的删除2.3 二叉搜索树的实现2.4 二叉查找树实现2.5 二叉搜索树的性能分析 一、二叉搜索树的概念 二叉搜索树又称二叉排序树,它或者是一棵空树,或者是具有以下性质的二叉树 若它的左子树不为空,则左子树上所有节点的值都小于根节点的值 若它的右子树不为空,则右子树上所有节点的值都大于根节点的值 它的左右子树也分别为二叉搜索树 int a [] = {5,3,4,1,7,8,2,6,0,9}; 二 、二叉搜索树操作 阅读详情

转载自:http://blog.youkuaiyun.com/beiyeqingteng/article/category/859395


1. 找出二叉查找树中第n大的值

问题:

给一个二叉查找树(BST),找出第 k 大的值。比如:
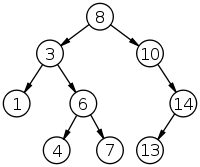

该图中,第3大的值是10.

分析:

我们可以通过类似中序遍历的方法把BST从大到小排序,然后,就可以得到第 k 大的值了。代码如下

public class NthLeaf {
    
    static int k = 0;


    // get the nth leaf by using preorder traversal
    public void getNthleve(Node root, int n) {
        if (root == null)
            return; 


        if (root.rightChild != null)
            getNthleve(root.rightChild, n); 


        k++;
        if (k == n) {
            System.out.println(root.toString());
        }   
        else
            getNthleve(root.leftChild, n); 
    }   
    
    public static void main(String[] args) {
         Node a = new Node(8);
         Node b = new Node(3);
         Node c = new Node(10);
         Node d = new Node(14);
         Node e = new Node(13);
         Node f = new Node(1);
         Node g = new Node(6);
         Node h = new Node(4);
         Node i = new Node(7);
    
         a.leftChild = b;
         a.rightChild = c;
         c.rightChild = d;
         d.leftChild = e;
         b.leftChild = f;
         b.rightChild = g;
         g.leftChild = h;
         g.rightChild = i;
         System.out.println("begin!");    
         new NthLeaf().getNthleve(a, 3);    
    }   
}

class Node {
    Node leftChild = null;
    Node rightChild = null;
    int value;

    Node(int value) {
        this.value = value;
    }

    @Override
    public String toString() {
        return value + "";
    }
}

2.问题:
给定一个二叉树,从左到右,找出第 k 个叶子节点。

比如
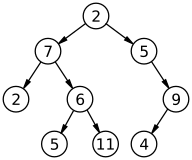

图中二叉树的第 3 个叶子节点(从左到右)是 11.

分析:

因为顺序是从左往右数,所以,对于一个节点下的两个叶子节点来讲(比如 6 下面有两个叶子节点 5 和 11),我们要确保先遍历最左边一个,然后再遍历右边一个。这样,其实,在中序遍历,前序遍历和后序遍历中,都能保证左边叶子节点比右边叶子节点先被遍历。我们只需要对每一个遍历的节点进行检查,看是否是叶子节点,是,则把个数+1. 代码如下:

public class NthLeaf {
	
	static int k = 0;

	// get the nth leaf by using preorder traversal
	public void getNthleve(Node root, int n) {
		
		if (root == null) return;
		
		if (root.rightChild == null && root.leftChild == null) {
			k++;
			if (k == n) {
				System.out.print(root.toString());
			}
		}

		getNthleve(root.leftChild, n);
		getNthleve(root.rightChild, n);
	}
	
	public static void main(String[] args) {
		 Node a = new Node(2);
	     Node b = new Node(7);
	     Node c = new Node(5);
	     Node d = new Node(2);
	     Node e = new Node(6);
	     Node f = new Node(9);
	     Node g = new Node(5);
	     Node h = new Node(11);
	     Node i = new Node(4);
	     
	     a.leftChild = b;
	     a.rightChild = c;
	     b.leftChild = d;
	     b.rightChild = e;
	     c.rightChild = f;
	     e.leftChild = g;
	     e.rightChild = h;
	     f.rightChild = i;
	     
	     new NthLeaf().getNthleve(a, 3);		
	}
}

class Node {
    Node leftChild = null;
    Node rightChild = null;
    int value;

    Node(int value) {
        this.value = value;
    }

    @Override
    public String toString() {
        return value + "";
    }
}

3.问题:
给你一个complete 二叉树,逆时针打印所有边缘节点, 比如:
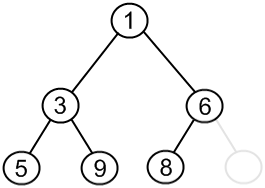

那么,逆时针打印边缘节点后,输出:1 , 3, 5, 9, 8,  6 .


分析:

如果想写一个方法实现这个要求是很难的,但是,我们可以考虑分步实现。

第一步:打印左边的边缘节点;

第二步:打印底部所有节点;

第三步:打印右边所有边缘节点。

public static void printLeft(Node root) {
	if (root.leftChild != null || root.rightChild != null) {
		print(root);
		printLeft(root.leftChild);
	}
}

public static void printButtom(Node root) {
	 
	if (root != null) {
		if (root.leftChild == null && root.rightChild == null) {
			print(root);
		}
		printButtom(root.leftChild);
		printButtom(root.rightChild);
	}
}

public static void printRight(Node root, Node node) {
	if (root.leftChild != null || root.rightChild != null) {
		printRight(root.rightChild, node);
		// do not print the root again
		if (root != node) {
			print(root);
		}
	}
}

4. check whether two binary trees are identical

Question:
Given two binary trees, check whether they are identical or not.
Analyze:
we first compare the roots of these two trees, if they are the same, we continue to compare the root of their left and right subtrees.
Code:

boolean sameTree(Node a, Node b) { 
  // 1. both empty -> true 
  if (a == null && b == null) return(true);

  // 2. both non-empty -> compare them 
  else if (a!=null && b!=null) { 
    return (a.data == b.data && 
      sameTree(a.leftChild, b.leftChild) && 
      sameTree(a.rightChild, b.rightChild) 
    ); 
  } 
  // 3. one empty, one not -> false 
  else return false; 
} 

5.检查一个数组是否可能是一棵二叉查询树后序遍历的结果

问题:

给一个数组,检查它是否可能是一棵二叉查询树后序遍历的结果。换句话说,是否存在一棵二叉查询树,对它进行后序遍历后,得到的数组和给定的数组完全一样。


比如,对上面这个二叉查询树后序遍历后,得到的数组是:[1, 4, 7, 6, 3, 13, 14, 10, 8]。

思路:

因为二叉树后序遍历的时候,先左后右然后中间。所以,数组的最后一个一定是整个二叉查询树的根(比如 8),而且,数组前一部分比数组最后一个值(也就是二叉查询树的根)小,因为它们是根的左子树部分。数组剩余部分,是根的右子树部分。而且,在剩余部分里,所有的值都必须比根要大。这样,我们可以把原来的数组分成两个部分,然后每一个部分可以进行递归判断,直到数组的长度小于等于2。(因为当长度小于等于2时,什么样的情况都是可以的)。

我们先把给定的数组分成两个部分,即我们需要先找到数组的分界点。代码如下:

[java]  view plain copy
  1. /** 
  2.      *  
  3.      * @param array  the input array     
  4.      * @param begin  the starting index of the array 
  5.      * @param end    the ending index of the array 
  6.      * @return   the turning point of the array, where the left part of turning point is smaller than array[end], the right  
  7.      *           part of the turning point is larger than array[end]. 
  8.      */  
  9.     public int turningPoint(int[] array, int begin, int end) {  
  10.           
  11.         int tp = -1;  
  12.         for (int i = begin; i < end; i++) {  
  13.             if (array[i] > array[end]) {  
  14.                 tp = i;  
  15.                 break;  
  16.             }  
  17.         }  
  18.           
  19.         return tp;  
  20.     }  

找到分界点后,我们还要判断从分界点开始,到数组末,是否所有的值都比数组的最后一个值(也就是根)大,否则,这样的数组不是一个二叉查询树的后序遍历。代码如下:

[java]  view plain copy
  1. //check whether all the elements from strat are larger than array[end]  
  2.     public boolean checkValid(int[] array, int start, int end) {  
  3.         for (int i = start; i < end; i++) {  
  4.             if (array[i] < array[end]) return false;  
  5.         }  
  6.         return true;  
  7.     }  

有了上面两个方法,我们就可以把递归写出来了,代码如下:


[java]  view plain copy
  1. // the main method to check whether the array is identical to a BST's post order array  
  2.     public boolean isPostOrder(int[] array, int begin, int end) {  
  3.         // the exit  
  4.         if ((end - begin + 1) <= 2) return true;  
  5.         //get the turning point  
  6.         int turningPoint = turningPoint(array, begin, end);  
  7.         boolean result = checkValid(array, turningPoint, end);  //check whether the right part of the array is valid  
  8.         if (result == false) {  
  9.             return false;  
  10.         }  
  11.         // recursion  
  12.         return isPostOrder(array, begin, turningPoint - 1) && isPostOrder(array, turningPoint, end - 1);  
  13.     }  

OMNET++ INET框架学习教程(一) 在自组网学习的道路上摸石头过河,帮你快速入门OIMNET++平台下的INET框架。 阅读详情

相关推荐

基于Java+SpringBoot+Vue的中小企业设备管理系统的设计与开发(源码+lw+部署文档+讲解等)

💗博主介绍:✌新人博主,工作经验两年+、专注于Java、小程序技术领域和毕业项目实战✌💗🌟文末获取源码+数据库🌟

2301_76502068的博客 1385

【Java实现】剑指Offer54——二叉搜索树的第K大节点(利用BST的性质遍历)思路分享

【Java实现】剑指Offer54——二叉搜索时的第K大节点(利用BST的性质遍历):思路分享 关于二叉搜索树的一些学习笔记在这里哦: 接下来几期内容会更新《剑指Offer》中所有“树”标签的习题及思路,传送门在此: 解题思路: 从题目看到二叉搜索树,就要联想到BST的性质: 中序遍历是递增的 我们都知道二叉树的中序遍历: 先遍历左子树,然后根节点,最后右子树 既然BST这样遍历能得到递增序列,那如何得到递减序列呢? 先遍历右子树、然后根节点、最后左子树,即可得到递减序列 到这里,大体的思路已经

油炸丸子George的博客 190

深度学习环境配置系列文章(二):Anaconda配置Python和PyTorch

Anaconda有着强大的包管理和环境管理的功能,使用后可以方便地使用和切换不同版本的Python和PyTorch等科学计算库,本文将介绍其下载安装和使用方法。第二章和第三章内容分别提供Window系统和Linux系统安装Anaconda的方式,读者可根据自己电脑系统选择其一安装即可。

极光喵的博客 4178

面试题54. 二叉搜索树的第k大节点

Problem 给定一棵二叉搜索树,请找出其中第k大的节点。 Example 1 Example 2 Solution Solution1 利用BST中序遍历为递增序列的特性,将遍历结果储存在数组中,然后从后向前找到第k个数。 Solution2 BST反向中序遍历(右->中->左)的结果是递减序列。所以在反向中序过程中,记录当前遍历的是第几个节点,当遍历到第k个时,就是结果。 /...

Bryan要加油 743

FPGA编译加速实战:6大可落地的Vivado优化策略

FPGA编译本质上是NP-hard约束满足问题求解,而非传统软件编译;Vivado作为时序驱动的硬件实现工具链,其耗时瓶颈集中在Implementation阶段的布局布线(PnR)与逻辑优化。理解这一原理,才能跳出‘加线程’‘升版本’等表面优化,转向精准时序约束、增量编译、物理锚点控制、IP配置精简等工程级干预。这些技术手段直接作用于Vivado的Tcl执行流与底层求解空间,显著压缩搜索范围、减少无效迭代——尤其适用于Zynq/UltraScale等中大型项目(LUT > 80K、多时钟域、DDR/PCIe

weixin_34226182的博客 416

同步辐射材料科学应用指南:从XAFS原位实验到数据处理

材料结构分析是材料研究的核心环节,但传统实验室X射线受限于能量固定、亮度不足,往往难以回答原子局域配位、非晶结构及动态演变等关键问题。同步辐射光源以高通量、连续可调、偏振可控及脉冲时间结构等特性,将材料表征从静态观察推进到原位动态追踪层次。基于X射线吸收精细结构谱(XAFS)、原位实验、X射线衍射与散射、微区成像等技术,研究人员可实现元素选择性分析、近邻原子环境解析及真实工况下的结构演变监测。本文从技术原理出发,覆盖实验方案设计、样品制备、现场对光、数据处理与常见故障排查,并结合典型应用场景,为材料科学领域

weixin_32612263的博客 182

【二叉树】BST的第k大结点,二叉树的深度,平衡二叉树

面试题54:二叉搜索树的第k个结点 给定一棵二叉搜索树,请找出其中的第k大的结点。 左边都比中间小,右边都比中间大,所以用中序遍历(左中右)就可以实现按结点的值从小到大遍历,遍历时候进行计数即可。 #include&amp;lt;bits/stdc++.h&amp;gt; #include &quot;../Utilities/BinaryTree.h&quot; using namespace std; //递归函数:输入...

大桔骑士的学习笔记 1333

图形学基础知识:着色(三)Rendering Pipeline与Shader

管线(Pipeline) 什么是管线? 管线我们可以理解为流水线,流水线大家都懂,就是工厂里面生产东西的一整套流程。例如饮料厂要生产饮料,需要洗瓶子,倒饮料,加盖,包装等等,这一整套过程就是流水线。那么我们要把一个三维场景渲染成一幅二维的图像,同样需要一个先干嘛再干嘛然后干嘛最后干嘛的过程,这个过程或流水线,我们就称之为管线。 实时渲染管线(Real-time Rendering Pipeline) 通过前面几篇的学习,我们知道了要把一个三维场景渲染成一幅二维的图像大致分为以下几个步骤: M.

王王王渣渣的博客 2534

二叉搜索树(BST)的第k大节点

给定一颗二叉搜索树,请找出其中的第k大的结点。例如, 5 / \ 3 7 /\ /\ 2 4 6 8 中,按结点数值大小顺序第三个结点的值为4。 利用BST中序有序的性质 中序遍历二叉树,依次将节点存入result,则result[k-1]是我们寻找的节点 设置一个标识k,遇到一个节点k++,中序遍历二叉树,当k=搜索数时返回正在访问的节点 # -*- coding:utf-8 ...

北歌的博客 1017

60、新型共轴直升机建模与事件触发积分强化学习研究

本文研究了新型共轴直升机的动力学建模与控制方法,基于牛顿-欧拉方程建立了6自由度非线性模型,并设计了四通道闭环控制器实现稳定飞行。同时,提出一种事件触发积分强化学习方法,用于解决非零和博弈中的最优跟踪控制问题,在减少通信开销的同时保证系统性能。通过仿真验证了控制器的轨迹跟踪能力,并证明了算法下跟踪误差与神经网络权重估计误差的一致最终有界性。两种方法协同可提升飞行器的自主性与鲁棒性,未来可拓展至多智能体协作、智能交通等复杂系统应用。

rl6adventurer的博客 118

YOLOv11原创改进专栏|原创自研篇|DAA模块手把手添加教程

个人简介:大家好!我是 DAA 注意力机制,堪称深度学习中的“聚光灯”。我的任务是帮助模型聪明地识别关键特征,就像一位经验丰富的侦探,能够在繁杂的数据中找到重要线索。通过结合通道和空间的注意力,我能确保模型把重点放在最有价值的信息上,从而提升识别准确率。简单来说,我就是帮助你的模型变得更加专注、敏锐,让它在一堆数据中轻松找到“宝藏”,为检测精度加分!动态适应性特征提取DAA通过动态生成卷积核来适应输入特征的变化,从而实现针对不同数据的自适应特征提取。

mywhyyds的博客 380

二叉搜索树的第k大节点(简单)

题目描述 给定一棵二叉搜索树,请找出其中第k大的节点的值。 示例1 输入: root = [3,1,4,null,2], k = 1 3 / \ 1 4 \ 2 输出: 4 示例2 输入: root = [5,3,6,2,4,null,null,1], k = 3 5 / \ 3 6 / \ 2 4 / 1 输出: 4 做题思路 1.按照“右根左”的顺序遍历二叉搜索树得到递减序列 2...

zxw20171828的博客 267

OpenStack详解、排错、经验总结

第1章 Openstack简介 1.1 计算(Compute):Nova。 一套控制器,用于为单个用户或使用群组管理虚拟机实例的整个生命周期,根据用户需求来提供虚拟服务。负责虚拟机创建、开机、关机、挂起、暂停、调整、迁移、重启、销毁等操作,配置CPU、内存等信息规格。自Austin版本集成到项目中。 1.2 对象存储(Object Storage):Swift。 一套用于在大规模可扩展系统中通过内置冗余及高容错机制实现对象存储的系统,允许进行存储或者检索文件。可为Glance提供镜像存储,为Cinder提供

weixin_40548182的博客 1974

LeetCode总结 -- 二叉查找树篇

LeetCode总结 -- 二叉查找树篇

qq_44939824的博客 213

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

题目:在二叉查找树中插入节点

给定一棵二叉查找树和一个新的树节点,将节点插入到树中。 你需要保证该树仍然是一棵二叉查找树。 您在真实的面试中是否遇到过这个题? Yes 哪家公司问你的这个题? Airbnb Alibaba Amazon Apple Baidu Bloomberg Cisco Dropbox Ebay Facebook Google Hulu Intel Linke

452

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

二叉查找树概念与相关leetcode题目

概念 二叉查找树,也叫二叉搜索树。树中任意一个节点,该节点的左子树中每个节点的值,都小于该节点的值;右子树中每个节点的值,都大于该节点的值。 查找 从根节点开始查找,若查找的数据等于根节点的值,则返回;若查找的数据小于根节点的值,则在左子树递归查找;若查找的数据大于根节点的值,则在右子树递归查找。 插入 插入的数据一般会放置到叶子节点上,因此也是从根节点开始遍历。 如果插入的数据比节点的数据大,且节点的右子树为空,那么直接将插入数据作为右子树节点;如果不为空,则循环遍历右子树,查找插入位置。 同- 理,

olewa_HHH的博客 245

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

题目:不同的二叉查找树

 通过 给出 n,问由 1...n 为节点组成的不同的二叉查找树有多少种? 您在真实的面试中是否遇到过这个题? Yes 样例 给出n = 3,有5种不同形态的二叉查找树: 1           3    3       2      1 \         /    /       / \      \   3      2     1 

497

题目:不同的二叉查找树 II

 给出n,生成所有由1...n为节点组成的不同的二叉查找树 您在真实的面试中是否遇到过这个题? Yes 样例 给出n = 3,生成所有5种不同形态的二叉查找树:    1           3       3       2      1     \         /        /         / \         \

1225

题目:二叉查找树中搜索区间

 给定两个值 k1 和 k2(k1 您在真实的面试中是否遇到过这个题? Yes 样例 如果有 k1 = 10 和 k2 = 22, 你的程序应该返回 [12, 20, 22].     20    /  \   8   22 / \ 4   12 标签 Expand    相关题目 Expand    解题思路:

1260

《算法笔记》 pat二叉查找树类型题目做题总结

/* 本题要用的知识点 ** 完全二叉树的序列,即层次遍历的序列 ** 完全二叉树可以直接用数组做中序遍历,(从0开始)父亲是i,左孩子是2i+1; ** 二叉搜索树的中序序列有序 ** 因此,假设我们已经用数组保存好了完全二叉树 ** 那么可以递归的在这个数组中,进行中序遍历 ** 现在反过来,我们有了中序遍历的序列,求数组 ** 可以在递归的时候,将访问,变为将中序序列输入进数组 ** 再遍历数组即可。 */ ...

hldgs的博客 379

题目编号001:二叉查找树转变成排序的双向链表

这是第一篇文章也是第一个题目,希望我能坚持下去,突破自己的编程功底。 题目:把二元查找树转变成排序的双向链表(树) 输入一棵二元查找树,将该二元查找树转换成一个排序的双向链表。 要求不能创建任何新的结点,只调整指针的指向。    10   / /   6  14  / / / / 4  8 12 16  转换成双向链表 4=6=8=10=12=14=16。    首先我

gdut_abc 419

二叉查找树

构建一棵二叉查找树的过程就是逐渐插入结点的过程。新插入的结点一定是一个新添加的叶结点,并且是查找不成功时查找路径上访问的最后一个结点的左子节点或右子节点。(其实这里我觉得就是把问题转化成了之前的查找)否则:若key值小于根结点的关键字值,在根结点的左子树上继续查找,转向步骤①;若key值大于根结点的关键字值,在根结点的右子树上继续查找,转向步骤①。②若二叉查找树非空,比较key值与根结点关键字值的大小,若相等则查找成功。①若二叉查找树为空二叉树,则查找失败。这个就要分情况讨论。

soilovedogs的博客 363

二叉查找树的典型面试题目汇总

二叉查找树的经典面试题

huruzun的专栏 1712

POJ 1577 Falling Leaves(二叉查找树)

题目链接:http://poj.org/problem?id=1577 题目大意: 二叉查找树按照叶子节点,从下往上抹去该树,给出抹除字符序列,求该二叉树,并前序打印 解题思路: 最后抹除的是根节点,把抹除的字符序列,逆序插入到一棵空的二叉查找树就是答案。 AC代码: /** * @description: poj1577,告知一层层的叶子节点,求二叉查找树 * @author: micha...

Michael是个半路程序员 1362

数据结构 ch04 - 二叉查找树 - 题解

思路:尝试插入一个新的线段 [L, R] 时,需要将所有与 [L, R] 相交的线段合并进来,从而扩展 [L, R] 成为一个更长的线段,并移除所有被合并的线段。思路:本题在“二叉查找树 I”问题的基础上,进一步实现了查找节点前驱和后继的功能。详见 ch04 的 “信息与公告” 页面。思路:通过模拟 multiset 的操作来解决问题。知识点:二叉查找树模拟。

u011247863的博客 304

ch04题目参考思路

思路:尝试插入一个新的线段 [L, R] 时,需要将所有与 [L, R] 相交的线段合并进来,从而扩展 [L, R] 成为一个更长的线段,并移除所有被合并的线段。思路:本题在“二叉查找树 I”问题的基础上,进一步实现了查找节点前驱和后继的功能。思路:通过模拟 multiset 的操作来解决问题。知识点:二叉查找树模拟。

qq_43359992的博客 498
上一篇: 一个Linux下C线程池的实现
下一篇: Time-wait状态(2MSL)一些理解
overstack
博客等级 码龄14年 115粉丝 55原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

