




博客主页:小馒头学python
本文专栏: Python爬虫五十个小案例
专栏简介:分享五十个Python爬虫小案例
🐍引言
猫眼电影是国内知名的电影票务与资讯平台,其中Top100榜单是影迷和电影产业观察者关注的重点。通过爬取猫眼电影Top100的数据,我们可以分析当前最受欢迎的电影,了解电影市场的变化趋势。在本文中,我们将介绍如何使用Python实现爬取猫眼电影Top100榜单的过程,并通过简单的数据分析展示电影的评分分布及其它相关信息。
🐍准备工作
在开始爬虫之前,我们需要做一些准备工作:
🐍安装必要的库:
首先,我们需要安装几个常用的Python库:
pip install requests beautifulsoup4 pandas matplotlib seaborn
🐍了解页面结构:
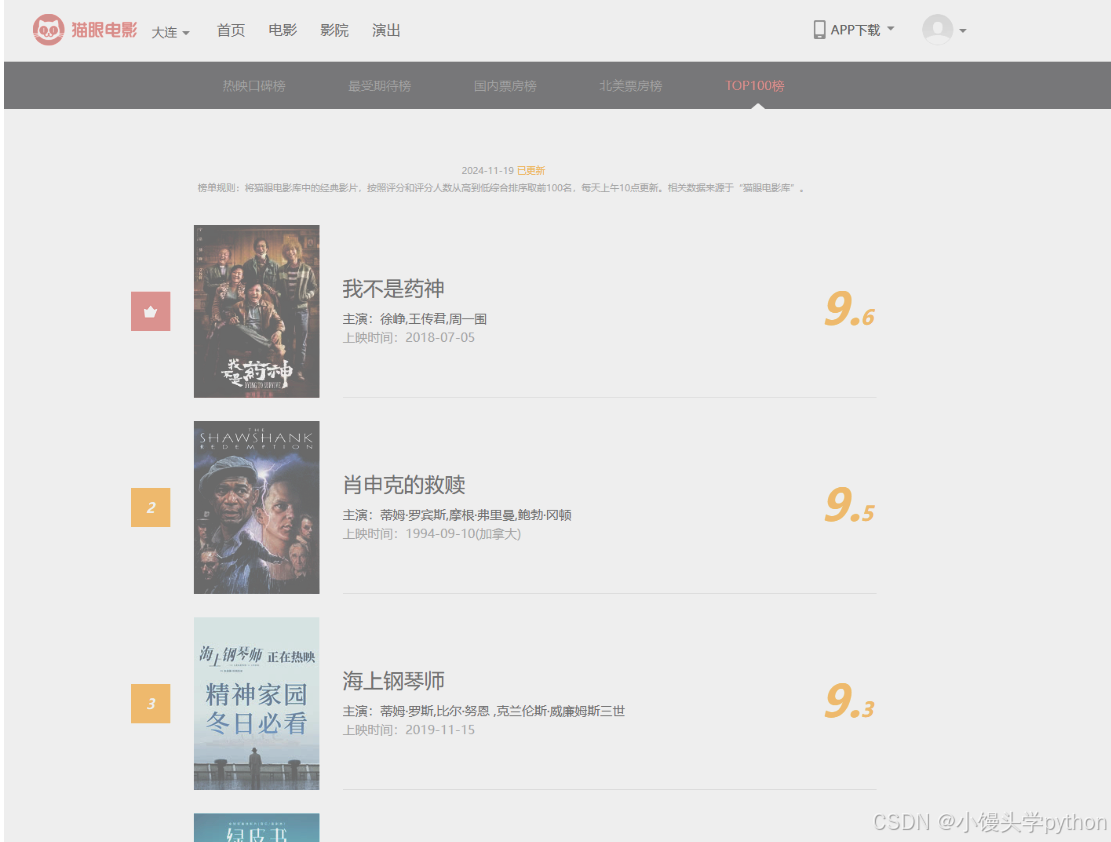
使用浏览器的开发者工具打开猫眼电影Top100的网页,观察页面的DOM结构,找到包含电影信息的元素
下面是页面的大概结构
🐍分析猫眼电影Top100页面结构
猫眼电影Top100的URL通常是类似于 https://maoyan.com/board/4。我们可以通过浏览器开发者工具(F12)来查看HTML结构,识别出电影的名称、评分、上映时间等数据。通过<li class="board-item">标签,每个电影的信息都包含在这个标签下。我们需要提取出其中的子标签来获取所需的数据。
🐍 编写爬虫代码
接下来,我们编写爬虫代码,来抓取页面中的电影信息。爬虫的主要任务是获取电影的名称、评分、上映时间等数据,并处理分页逻辑,直到抓取完Top100。
import requests
from bs4 import BeautifulSoup
import pandas as pd

# 设置目标URL
url = 'https://maoyan.com/board/4'

# 发送请求
response = requests.get(url)
response.encoding = 'utf-8'

# 使用BeautifulSoup解析HTML
soup = BeautifulSoup(response.text, 'html.parser')

# 存储电影信息的列表
movies = []

# 提取电影列表
for item in soup.find_all('dd'):
    movie = {}
    movie['name'] = item.find('a').text.strip()  # 电影名称
    movie['score'] = item.find('p', class_='score').text.strip()  # 电影评分
    movie['release_time'] = item.find('p', class_='releasetime').text.strip()  # 上映时间

    movies.append(movie)

# 将数据保存到DataFrame
df = pd.DataFrame(movies)

# 输出前5行数据
print(df.head())

# 保存到CSV文件
df.to_csv('maoyan_top100.csv', index=False)
🐍数据清洗与存储
在爬取数据之后,我们需要进行数据清洗,确保抓取的数据是准确和完整的。例如:
- 清理电影名称中的空格和特殊字符
- 处理评分字段中缺失或非数字的情况
- 上映时间可能需要转换为标准日期格式
使用pandas可以方便地进行数据清洗:
# 清洗数据:去除空值
df.dropna(inplace=True)

# 转换上映时间为标准格式
df['release_time'] = pd.to_datetime(df['release_time'], errors='coerce')

# 处理评分数据,将评分转换为浮动类型
df['score'] = pd.to_numeric(df['score'], errors='coerce')
🐍数据分析与可视化
通过简单的数据分析,我们可以查看电影评分的分布、上映年份的趋势等:
import matplotlib.pyplot as plt
import seaborn as sns

# 绘制评分分布图
plt.figure(figsize=(8, 6))
sns.histplot(df['score'], bins=20, kde=True)
plt.title('电影评分分布')
plt.xlabel('评分')
plt.ylabel('数量')
plt.show()

# 电影上映年份分布
df['release_year'] = df['release_time'].dt.year
plt.figure(figsize=(10, 6))
sns.countplot(x='release_year', data=df)
plt.title('电影上映年份分布')
plt.xticks(rotation=45)
plt.show()
🐍反爬虫机制与应对策略
猫眼电影网站有一定的反爬虫机制,比如限制频繁的请求。因此,在编写爬虫时,我们需要注意以下几个问题:
- 使用User-Agent:模拟浏览器请求头,避免被识别为爬虫
- 设置请求间隔:通过
time.sleep()设置请求的间隔,防止过于频繁的请求 - 使用代理:避免IP封禁
import time
import random

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
}

# 模拟延时,避免频繁请求
time.sleep(random.uniform(1, 3))
🐍完整源码
import requests
from bs4 import BeautifulSoup
import pandas as pd
import time
import random
import matplotlib.pyplot as plt
from matplotlib import rcParams
import seaborn as sns
import re

# 设置Matplotlib使用的字体为SimHei(黑体),以支持中文显示
rcParams['font.sans-serif'] = ['SimHei']  # 使用黑体
rcParams['axes.unicode_minus'] = False  # 解决负号 '-' 显示为方块的问题

# 设置目标URL
url = 'https://maoyan.com/board/4'

# 请求头,模拟浏览器访问
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
}

# 发送请求
response = requests.get(url, headers=headers)
response.encoding = 'utf-8'

# 使用BeautifulSoup解析HTML
soup = BeautifulSoup(response.text, 'html.parser')

# 存储电影信息的列表
movies = []

# 提取电影列表
for item in soup.find_all('dd'):
    movie = {}

    # 获取电影名称,从a标签的title属性中提取
    movie['name'] = item.find('a')['title'].strip() if item.find('a') else 'N/A'

    # 获取评分,确保评分字段存在
    score_tag = item.find('p', class_='score')
    movie['score'] = score_tag.text.strip() if score_tag else 'N/A'

    # 获取上映时间,确保上映时间字段存在
    release_time_tag = item.find('p', class_='releasetime')
    release_time = release_time_tag.text.strip() if release_time_tag else 'N/A'

    # 使用正则表达式清洗数据,提取年份部分
    movie['release_time'] = re.findall(r'\d{4}', release_time)  # 匹配年份

    if movie['release_time']:
        movie['release_time'] = movie['release_time'][0]  # 只取第一个年份
    else:
        movie['release_time'] = 'N/A'  # 如果没有找到年份,设置为'N/A'

    # 将电影信息添加到列表中
    movies.append(movie)

# 将数据存储到pandas DataFrame
df = pd.DataFrame(movies)

# 输出前5行数据
print("爬取的数据:")
print(df.head())

# 数据清洗:去除空值并处理评分数据
df.dropna(subset=['score', 'release_time'], inplace=True)  # 删除评分和上映时间为空的行

# 将评分转换为数值类型,无法转换的设置为NaN
df['score'] = pd.to_numeric(df['score'], errors='coerce')

# 删除评分为空的行
df.dropna(subset=['score'], inplace=True)

# 将release_time列转换为数值类型的年份
df['release_year'] = pd.to_numeric(df['release_time'], errors='coerce')

# 输出清洗后的数据
print("清洗后的数据:")
print(df.head())

# 保存数据为CSV文件
df.to_csv('maoyan_top100.csv', index=False)

# 数据分析:电影评分分布
plt.figure(figsize=(8, 6))
sns.histplot(df['score'], bins=20, kde=True)
plt.title('电影评分分布')
plt.xlabel('评分')
plt.ylabel('数量')
plt.show()

# 数据分析:电影上映年份分布
plt.figure(figsize=(10, 6))
sns.countplot(x='release_year', data=df)
plt.title('电影上映年份分布')
plt.xticks(rotation=45)
plt.xlabel('年份')
plt.ylabel('电影数量')
plt.show()

# 结束
print("爬取和分析完成!数据已保存至 maoyan_top100.csv")
🐍翻页功能
我们完成了基本的功能,接下来我们为了爬取前100个电影(即10页数据),你需要构造爬虫来遍历每一页并合并数据。每一页的URL格式为https://www.maoyan.com/board/4?offset=n,其中n是每页的偏移量,分别为0、10、20、30等,
import requests
from bs4 import BeautifulSoup
import pandas as pd
import time
import random
import matplotlib.pyplot as plt
from matplotlib import rcParams
import seaborn as sns
import re

# 设置Matplotlib使用的字体为SimHei(黑体),以支持中文显示
rcParams['font.sans-serif'] = ['SimHei']  # 使用黑体
rcParams['axes.unicode_minus'] = False  # 解决负号 '-' 显示为方块的问题

# 设置目标URL基础部分
base_url = 'https://www.maoyan.com/board/4?offset={}'

# 请求头,模拟浏览器访问
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3'
}

# 存储所有电影信息的列表
movies = []

# 爬取10页数据,每页偏移量为0, 10, 20, ..., 90
for offset in range(0, 100, 10):
    url = base_url.format(offset)  # 构造每一页的URL
    response = requests.get(url, headers=headers)
    response.encoding = 'utf-8'

    # 使用BeautifulSoup解析HTML
    soup = BeautifulSoup(response.text, 'html.parser')

    # 提取电影列表
    for item in soup.find_all('dd'):
        movie = {}

        # 获取电影名称,从a标签的title属性中提取
        movie['name'] = item.find('a')['title'].strip() if item.find('a') else 'N/A'

        # 获取评分,确保评分字段存在
        score_tag = item.find('p', class_='score')
        movie['score'] = score_tag.text.strip() if score_tag else 'N/A'

        # 获取上映时间,确保上映时间字段存在
        release_time_tag = item.find('p', class_='releasetime')
        release_time = release_time_tag.text.strip() if release_time_tag else 'N/A'

        # 使用正则表达式清洗数据,提取年份部分
        movie['release_time'] = re.findall(r'\d{4}', release_time)  # 匹配年份

        if movie['release_time']:
            movie['release_time'] = movie['release_time'][0]  # 只取第一个年份
        else:
            movie['release_time'] = 'N/A'  # 如果没有找到年份,设置为'N/A'

        # 将电影信息添加到列表中
        movies.append(movie)

    # 随机延迟,避免频繁请求被封禁
    time.sleep(random.uniform(1, 3))

# 将数据存储到pandas DataFrame
df = pd.DataFrame(movies)

# 输出前5行数据
print("爬取的数据:")
print(df.head())

# 数据清洗:去除空值并处理评分数据
df.dropna(subset=['score', 'release_time'], inplace=True)  # 删除评分和上映时间为空的行

# 将评分转换为数值类型,无法转换的设置为NaN
df['score'] = pd.to_numeric(df['score'], errors='coerce')

# 删除评分为空的行
df.dropna(subset=['score'], inplace=True)

# 将release_time列转换为数值类型的年份
df['release_year'] = pd.to_numeric(df['release_time'], errors='coerce')

# 输出清洗后的数据
print("清洗后的数据:")
print(df.head())

# 保存数据为CSV文件
df.to_csv('maoyan_top100.csv',encoding='utf-8-sig' ,index=False)

# 数据分析:电影评分分布
plt.figure(figsize=(8, 6))
sns.histplot(df['score'], bins=20, kde=True)
plt.title('电影评分分布')
plt.xlabel('评分')
plt.ylabel('数量')
plt.show()

# 数据分析:电影上映年份分布
plt.figure(figsize=(10, 6))
sns.countplot(x='release_year', data=df)
plt.title('电影上映年份分布')
plt.xticks(rotation=45)
plt.xlabel('年份')
plt.ylabel('电影数量')
plt.show()

# 结束
print("爬取和分析完成!数据已保存至 maoyan_top100.csv")
遍历10页:
- 我们使用
range(0, 100, 10)来设置偏移量,依次爬取从offset=0到offset=90的URL - 每一页的URL由
base_url.format(offset)生成。
随机延迟:
- 为了避免频繁请求导致被封禁,爬虫请求每一页后,加入了
time.sleep(random.uniform(1, 3)),模拟随机延迟
爬取并合并数据:
- 所有电影信息都会存储到
movies列表中,最后通过pandas的DataFrame进行数据整合
运行结果


下图展示了电影评分分布情况还有电影上映年份的分布


🐍结语
通过本篇博客,我们展示了如何使用Python爬虫技术抓取猫眼电影Top100的数据,并进行简单的数据清洗与分析。除了数据抓取和分析,我们还学习了如何应对反爬虫机制。通过这些知识,我们可以很好的进行后续的数据分析,或者可以查看自己喜欢哪个电影,当然本节主要还是为了练手,为了后续我们进行其他项目任务
 3520


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


