从动态语言到 Rust:类型系统与所有权的心智模型转换

编程语言难度量化分析:从Python到汇编,五维模型解析学习曲线 编程语言的学习难度是开发者普遍关注的核心问题,它直接影响学习路径选择与技术栈评估。从技术原理上看,语言难度本质上是语法规则、抽象概念、工具生态、运行时心智模型及调试复杂度等多维度因素的综合体现。高抽象度的语言如Python通过隐藏底层复杂性提升开发效率,而系统级语言如Rust、C++则通过显式的所有权、内存管理等机制换取更高的性能与控制力,这背后反映了在开发效率、执行性能与程序安全性之间的经典权衡。本文基于语法复杂性、概念抽象度、生态成熟度、心智模型和调试难度五个核心维度,构建了一套可量化的分析框架,对Py 阅读详情

从动态语言到 Rust:类型系统与所有权的心智模型转换
cover

一、动态类型的自由与代价——为什么转 Rust 会"痛"

Python 和 JavaScript 赋予了开发者极大的灵活性:变量无需声明类型,函数参数可以是任意类型,运行时动态派发。这种灵活性在项目初期效率极高——快速原型、脚本自动化、数据处理流水线,几行代码就能跑起来。

但灵活性是有代价的。当项目规模增长到数万行代码时,动态类型的弊端开始显现:重构时无法确定某个变量的所有使用场景,函数签名无法表达参数约束,运行时类型错误在生产环境中爆发。更关键的是,动态语言无法提供编译期的内存安全保证——Python 的引用计数和 GC 隐藏了内存管理的细节,但也剥夺了开发者对内存布局的控制权。

转 Rust 的过程,本质上是心智模型的转换:从"运行时再说"切换到"编译期保证"。这个转换不是渐进的,而是跳跃式的——Rust 的编译器会强制你重新思考每一行代码的内存语义。本文将梳理这条转换路径上的关键认知节点,以及每个节点上的典型踩坑场景。

二、心智模型转换的四层阶梯:从动态到静态的渐进映射

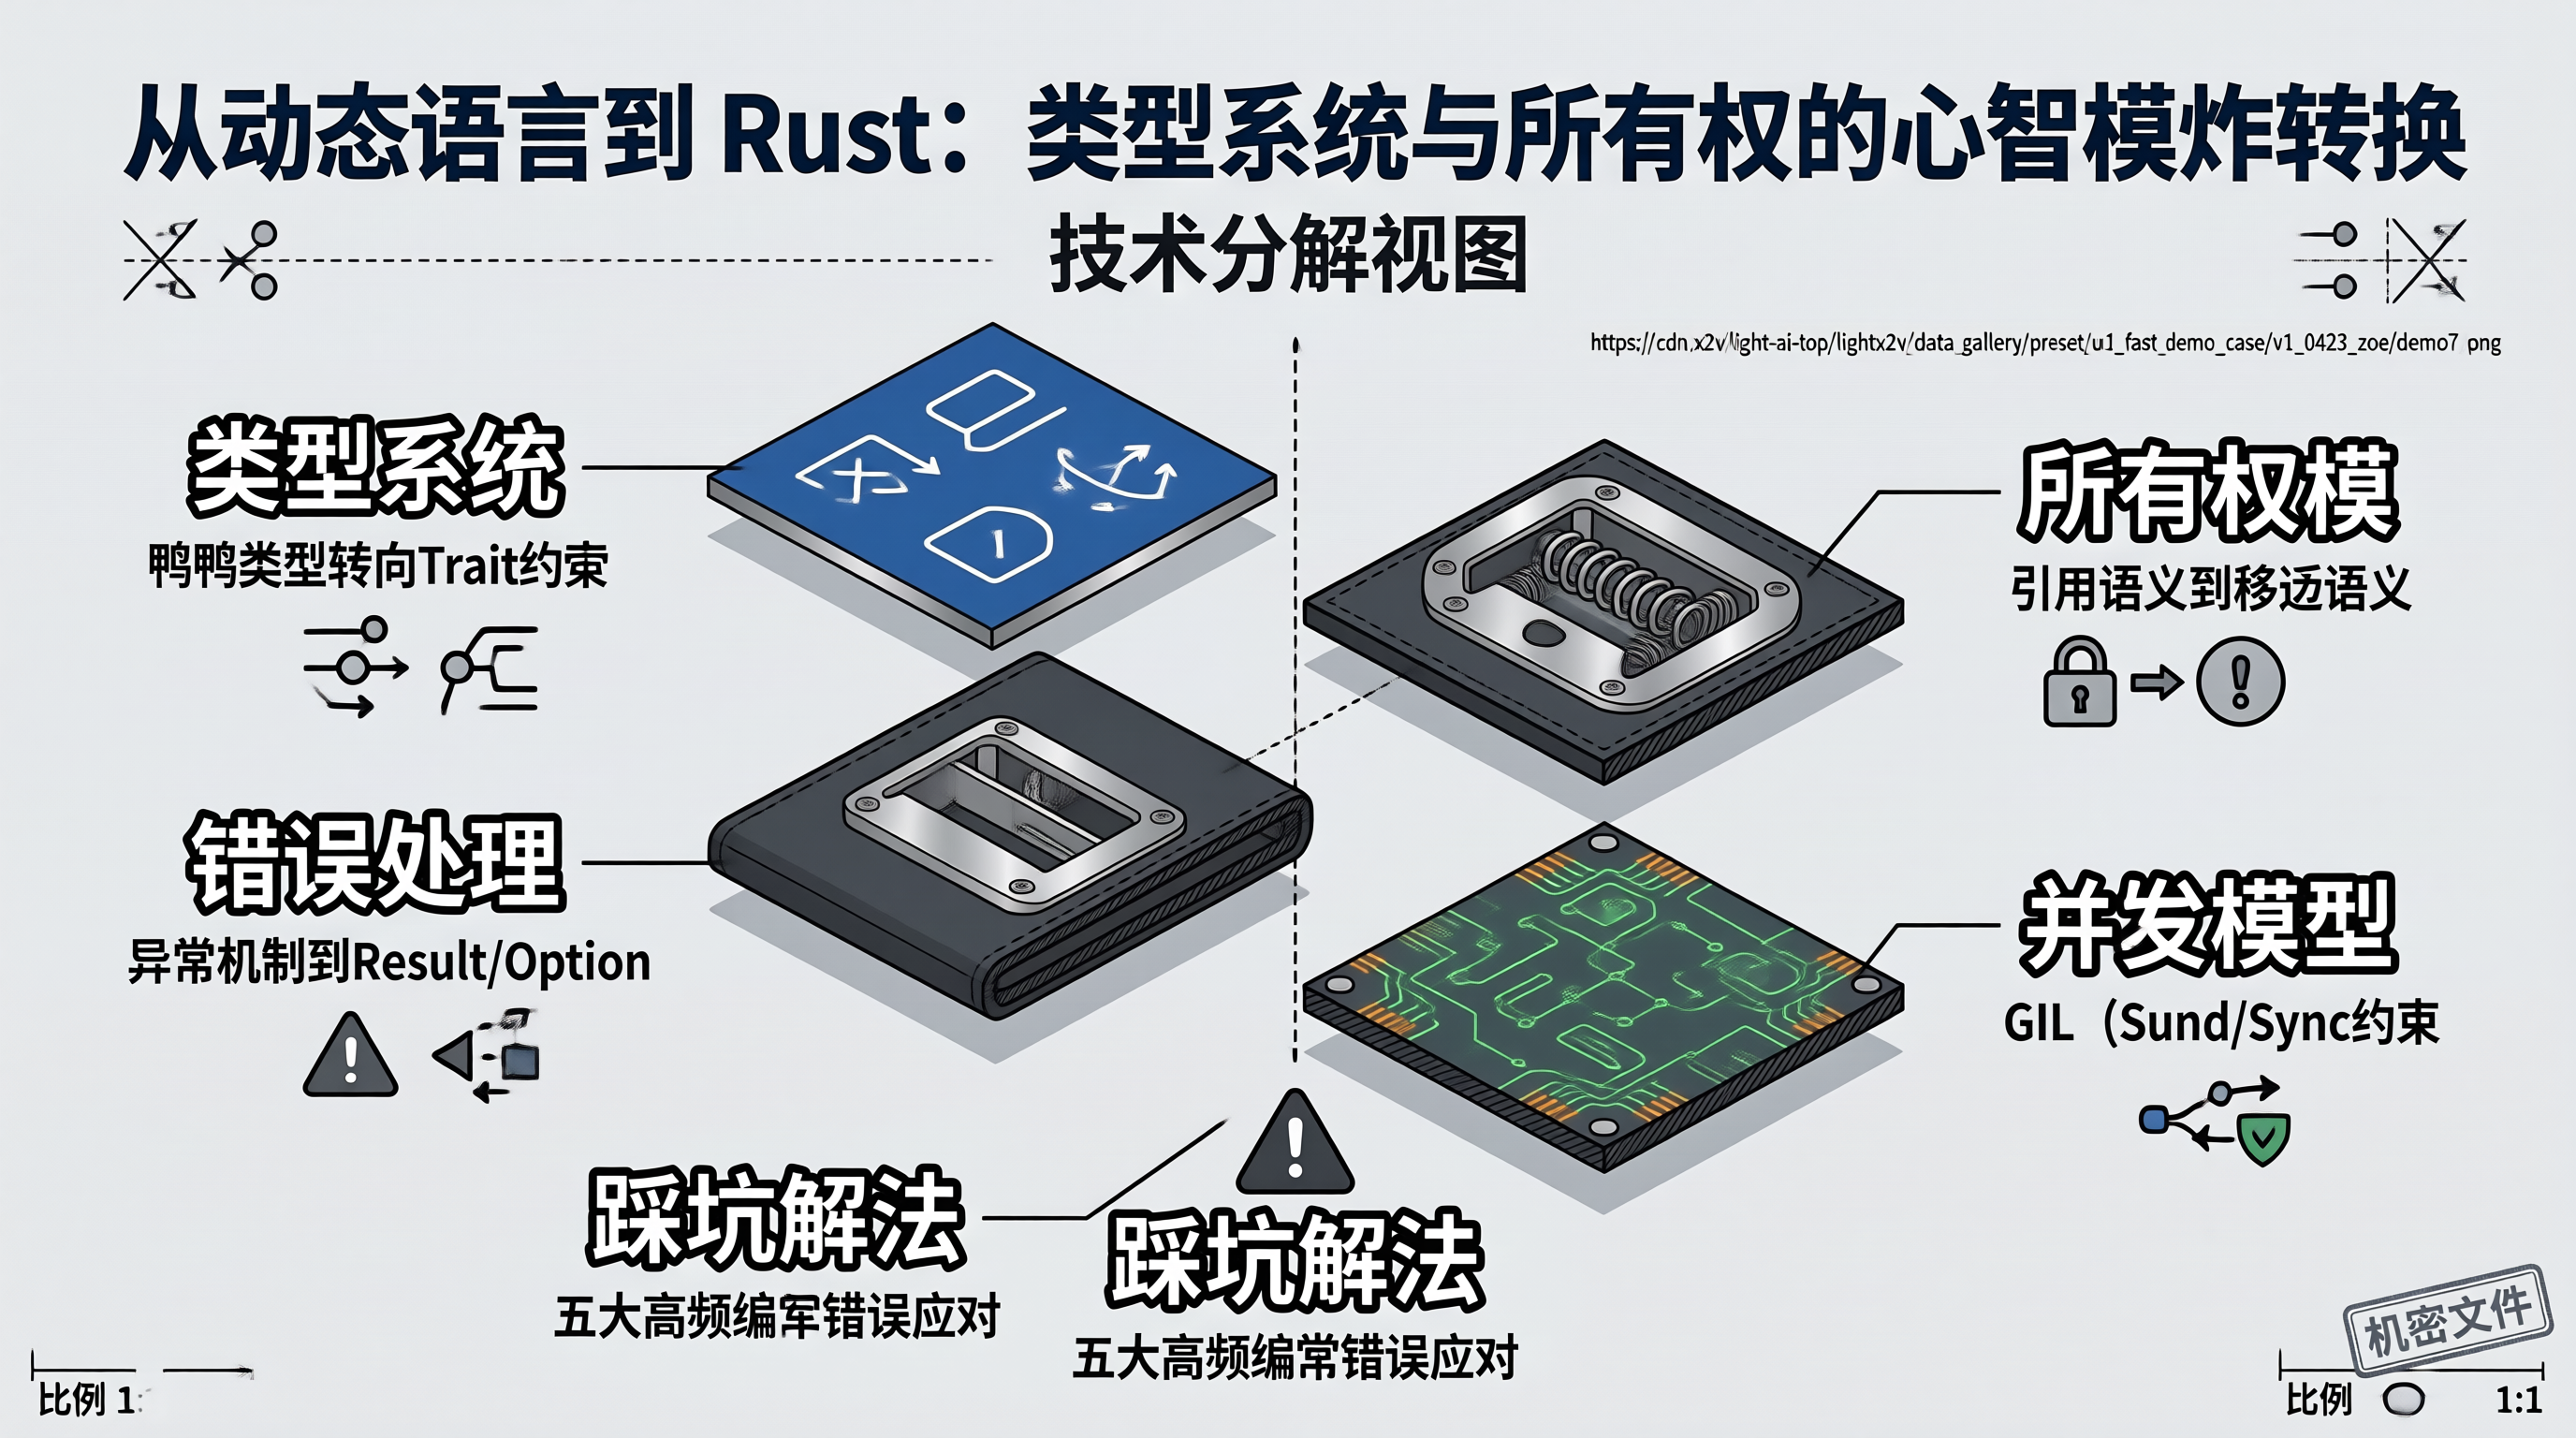
从动态语言转 Rust,需要跨越四个认知层次。每一层都对应着一种思维方式的根本转变。

graph TB
    subgraph "第一层:类型系统"
        A1[动态类型 → 静态类型] --> A2[类型推导 ≠ 无类型]
        A1 --> A3[泛型与 trait 约束]
    end

    subgraph "第二层:值语义与引用语义"
        B1[一切皆引用 → 所有权模型] --> B2[移动 vs 拷贝]
        B1 --> B3[借用规则:读写互斥]
    end

    subgraph "第三层:错误处理"
        C1[异常/None → Result/Option] --> C2[显式处理每个错误]
        C1 --> C3[? 运算符与错误传播]
    end

    subgraph "第四层:并发模型"
        D1[GIL/单线程 → Send/Sync] --> D2[编译期消除数据竞争]
        D1 --> D3[消息传递优于共享内存]
    end

    A3 --> B1
    B3 --> C1
    C3 --> D1

    style A1 fill:#e8f4fd,stroke:#333
    style B1 fill:#fff3e0,stroke:#333
    style C1 fill:#e8f5e9,stroke:#333
    style D1 fill:#fce4ec,stroke:#333

2.1 第一层:类型系统——从"鸭子类型"到"trait 约束"

Python 的鸭子类型(Duck Typing)哲学是:如果它走起来像鸭子,叫起来像鸭子,那它就是鸭子。函数不关心参数的具体类型,只关心它有没有需要的方法。这很灵活,但也很脆弱——运行时才发现参数缺少某个方法,是 Python 项目的常见崩溃原因。

Rust 的 trait 约束是鸭子类型的编译期版本。fn process<T: Read>(mut input: T) 表达的是:我不关心 T 是什么类型,只要它实现了 Read trait。区别在于,约束在编译期检查,而非运行时崩溃。

use std::io::Read;

/// 通用数据读取器:不关心具体类型,只要求实现 Read trait
/// 对比 Python:def read_data(source) — 运行时才知道 source 有没有 read 方法
fn read_data<T: Read>(source: &mut T) -> Result<Vec<u8>, std::io::Error> {
    let mut buffer = Vec::with_capacity(4096);
    source.read_to_end(&mut buffer)?;
    Ok(buffer)
}

// 编译期就能确定 File 实现了 Read,无需运行时检查
fn example() -> Result<(), Box<dyn std::error::Error>> {
    let mut file = std::fs::File::open("data.bin")?;
    let data = read_data(&mut file)?;
    println!("读取 {} 字节", data.len());
    Ok(())
}

2.2 第二层:值语义——从"一切皆引用"到"所有权模型"

这是转 Rust 最大的心智模型跳跃。在 Python 中,变量是对象的引用标签,赋值操作创建新的引用而非拷贝数据。Python 开发者习惯了"多个变量指向同一对象"的思维模式。

Rust 的默认语义是移动(Move),而非引用。let s2 = s1 之后,s1 不再可用。这条规则消除了别名(Aliasing),是 Rust 内存安全的基石。

fn process_name(name: String) -> String {
    // name 的所有权已转移到这里
    // 调用者不再拥有 name,无法在调用后使用它
    format!("处理完成: {}", name)
}

fn main() {
    let name = String::from("Rust");
    let result = process_name(name);
    // println!("{}", name); // 编译错误:name 已被移动

    // 如果调用者需要保留 name,必须显式克隆
    let name2 = String::from("Rust");
    let result2 = process_name(name2.clone()); // 克隆:深拷贝,调用者保留 name2
    println!("原始值: {}", name2); // name2 仍然有效
}

Python 开发者的典型踩坑:在循环中反复移动同一个变量,导致"值已移动"的编译错误。解决思路是区分"需要所有权"和"只需要借用"两种场景——如果函数只需要读取数据,传引用 &T 而非 T。

2.3 第三层:错误处理——从 try/except 到 Result/Option

Python 的异常机制允许错误在调用栈中隐式传播,任何函数都可能抛出任何异常。Rust 的 Result<T, E> 强制开发者在类型层面处理每种可能的错误。

use std::fs;
use std::io;

/// 多步文件处理:每一步都可能失败
/// 使用 ? 运算符传播错误,保持代码简洁
fn process_config(path: &str) -> Result<Config, AppError> {
    // ? 运算符:如果 read_to_string 失败,立即返回 Err
    // 对比 Python:需要 try/except 包裹,且无法在签名中声明可能抛出的异常
    let content = fs::read_to_string(path)
        .map_err(|e| AppError::Io(e))?;

    let config: Config = toml::from_str(&content)
        .map_err(|e| AppError::Parse(e))?;

    validate_config(&config)?;
    Ok(config)
}

/// 自定义错误类型:枚举所有可能的错误变体
/// 比Python的裸Exception更精确,调用者可以按模式匹配处理
#[derive(Debug)]
enum AppError {
    Io(io::Error),
    Parse(toml::de::Error),
    Validation(String),
}

impl std::fmt::Display for AppError {
    fn fmt(&self, f: &mut std::fmt::Formatter<'_>) -> std::fmt::Result {
        match self {
            AppError::Io(e) => write!(f, "IO 错误: {}", e),
            AppError::Parse(e) => write!(f, "解析错误: {}", e),
            AppError::Validation(msg) => write!(f, "校验失败: {}", msg),
        }
    }
}

impl std::error::Error for AppError {}

#[derive(Debug)]
struct Config {
    name: String,
    version: String,
}

fn toml::from_str(_: &str) -> Result<Config, toml::de::Error> { unimplemented!() }
fn validate_config(_: &Config) -> Result<(), AppError> { Ok(()) }

2.4 第四层:并发模型——从 GIL 到 Send/Sync

Python 的 GIL(全局解释器锁)使得多线程无法真正并行执行 CPU 密集型代码。开发者习惯了多进程或 asyncio 的并发模型。Rust 没有运行时锁,线程可以真正并行执行,但编译器通过 Send 和 Sync trait 在编译期保证线程安全。

use std::sync::{Arc, Mutex};
use std::thread;

/// 多线程安全计数器
/// Arc:原子引用计数,跨线程共享所有权
/// Mutex:互斥锁,保证同一时刻只有一个线程访问数据
fn parallel_count(data: &[u64], thread_count: usize) -> u64 {
    let chunk_size = (data.len() + thread_count - 1) / thread_count;
    let result = Arc::new(Mutex::new(0u64));

    let handles: Vec<_> = data
        .chunks(chunk_size)
        .map(|chunk| {
            let chunk = chunk.to_vec();
            let result = Arc::clone(&result);
            thread::spawn(move || {
                let partial: u64 = chunk.iter().sum();
                // Mutex 保护:同一时刻只有一个线程在写入
                let mut guard = result.lock().unwrap();
                *guard += partial;
            })
        })
        .collect();

    for handle in handles {
        handle.join().unwrap();
    }

    let guard = result.lock().unwrap();
    *guard
}

三、转码踩坑实录:五个高频编译错误与解法

坑 1:借用检查器报错——"cannot borrow as mutable more than once"

// 错误代码:同一作用域内多次可变借用
let mut data = vec![1, 2, 3];
let first = &mut data[0]; // 第一次可变借用
let second = &mut data[1]; // 第二次可变借用——编译错误
*first += 1;

解法:缩小借用作用域,让第一次借用在使用完毕后立即释放。

let mut data = vec![1, 2, 3];
{
    let first = &mut data[0];
    *first += 1;
} // first 的借用在此结束
let second = &mut data[1]; // 现在可以安全借用

坑 2:生命周期标注传染——结构体持有引用后到处加 'a

解法:对于不需要零拷贝优化的场景,用 String 替代 &str,用 Vec<T> 替代 &[T]。所有权自有,无需生命周期标注。性能损失通常可以接受——数据拷贝一次的代价,远小于代码可维护性的收益。

坑 3:闭包捕获导致所有权错误——"may outlive the captured value"

// 错误:闭包借用了局部变量,但闭包可能比局部变量活得更久
fn spawn_worker() -> thread::JoinHandle<()> {
    let config = load_config();
    thread::spawn(|| {
        process(&config); // 借用 config,但线程可能比 config 活得久
    })
}

解法:使用 move 将所有权转移给闭包。

fn spawn_worker() -> thread::JoinHandle<()> {
    let config = load_config();
    thread::spawn(move || {
        process(&config); // config 的所有权已转移,闭包拥有它
    })
}

坑 4:Option 与 Null 的混淆——"use of moved value after Some extraction"

Python 的 None 可以直接判断,Rust 的 Option 需要模式匹配。初学者常犯的错误是在 if let Some(x) = opt 之后继续使用 opt,但 x 可能已经取走了内部值。

坑 5:特征对象与泛型的选择困惑

当需要动态派发时用 Box<dyn Trait>,当需要静态派发时用泛型 <T: Trait>。前者有运行时虚表查找开销,后者有编译期单态化带来的二进制膨胀。

四、转码的隐性成本:不只是语法,更是工程哲学

从动态语言转 Rust,最大的成本不在语法学习,而在工程哲学的转换。

迭代速度下降是首要冲击。Python 的"写完就跑"在 Rust 中变成了"写完编译改错再跑"。编译器的严格检查在项目初期会显著拖慢开发节奏,但随着代码库增长,这种前期投入会以更少的运行时 Bug 回报。关键是要调整预期:Rust 的开发节奏是"慢启动、快迭代"——前期的编译错误,避免了后期的运行时调试。

库生态的差异需要适应。Python 的 PyPI 拥有数十万包,几乎任何功能都能找到现成方案。Rust 的 crates.io 生态在快速增长,但在某些领域(如数据科学、机器学习)仍然不如 Python 成熟。这意味着某些场景下需要自己实现底层逻辑,或者通过 FFI 调用 C/Python 库。

调试方式不同。Python 的 print() 调试法在 Rust 中依然可用,但 Rust 的类型系统使得很多 Bug 在编译期就被捕获,运行时调试的需求反而更少。当需要调试时,dbg! 宏比 println! 更方便——它自动输出表达式、值和位置信息。

五、总结

从动态语言转 Rust,核心是四层心智模型的转换:类型系统从鸭子类型到 trait 约束、值语义从一切皆引用到所有权模型、错误处理从异常到 Result/Option、并发模型从 GIL 到 Send/Sync。每一层转换都伴随着编译器强制的行为约束,这些约束在短期内增加开发成本,在长期内提升代码可靠性。

五个高频踩坑场景——多重可变借用、生命周期标注传染、闭包捕获所有权、Option 提取后使用、特征对象与泛型选择——都有成熟的解法模式。关键在于理解每个编译错误背后的设计意图,而非将其视为编译器的刁难。

落地路线建议:从 Python 中最熟悉的脚本工具开始,用 Rust 重写一个简单的文件处理或命令行工具;遇到编译错误时先理解错误信息,再搜索解法;逐步从简单的所有权场景过渡到生命周期标注和并发编程。编译器是最好的老师,每一次编译错误都是对心智模型的修正。

Rust编程语言核心概念与实践:从内存安全到系统编程实战 系统编程语言的核心挑战在于如何平衡性能、安全性与开发效率。传统语言如C/C++提供了对硬件的底层控制和高性能,但内存管理和并发安全问题长期困扰开发者;而拥有垃圾回收机制的语言虽提升了安全性,却引入了运行时开销与不可预测的停顿。Rust语言通过其独特的所有权系统、借用检查器和生命周期模型,在编译期静态保障内存安全与并发安全,实现了“零成本抽象”的承诺,从而在系统软件、基础设施、高性能服务等场景中展现出巨大价值。本文聚焦于Rust的所有权、借用、Trait等核心机制,并结合内存安全、并发安全等关键概念,通过实际 阅读详情

相关推荐

Rust与Godot 3深度整合:从架构原理到性能优化的实战指南

在现代游戏开发中,脚本语言与游戏引擎的交互是核心技术环节,它决定了项目的性能、安全性与可维护性。其核心原理在于通过类型安全的绑定系统,在脚本语言与引擎原生代码之间建立高效的通信通道,实现数据编组与对象生命周期管理。这种技术架构的价值在于,开发者既能利用高级语言的安全特性和开发效率,又能直接调用引擎底层的原生性能。尤其在需要处理复杂游戏逻辑、高并发或对内存安全有严苛要求的应用场景中,这种组合优势明显。本文聚焦于Rust语言与Godot 3引擎通过`gdnative`库实现的深度绑定,深入剖析其双向通信模型与类

weixin_30260191的博客 241

编程语言难度评估:从多维度拆解到个人学习路径规划

编程语言作为软件开发的基石,其学习难度一直是开发者关注的核心议题。从技术原理上看,语言难度并非单一指标,而是由语法入门门槛、心智模型转换、生态工具链成熟度及目标问题域复杂度等多个维度共同构成。在工程实践中,理解这些维度有助于开发者进行更精准的技术选型与学习规划。例如,Python以其低语法门槛和丰富生态,在快速原型开发中体现高使用价值;而Rust的所有权系统和编译期安全检查,虽然提升了初期学习曲线,却在系统编程领域提供了不可替代的安全保障。本文通过建立个人化的“难度-收益”评估框架,结合具体的热门语言如Ru

weixin_34161083的博客 369

Python、JavaScript、Rust、C++ 全景对比:从语言哲学到实战选型指南

编程语言是软件开发的基石,其核心设计哲学决定了其行为模式与适用边界。从原理上看,语言通过类型系统、内存管理模型和并发机制等底层设计,在性能、安全性与开发效率之间进行权衡。其技术价值在于,优秀的语言能提升代码可靠性、团队协作效率并降低长期维护成本。在实际应用场景中,不同语言各擅胜场:Python凭借简洁语法和丰富生态,在数据分析与快速原型领域无可替代;JavaScript依托事件驱动模型,成为高并发Web服务的首选;Rust通过编译时所有权系统,在需要内存安全与高性能的系统编程中脱颖而出;C++则以其零开销抽

weixin_33859231的博客 420

编程语言心智模型:从核心维度到技术选型的实战指南

编程语言作为软件开发的基石,其设计思想与核心特性决定了其适用场景与技术价值。理解编程范式(如命令式、面向对象、函数式)是把握语言世界观的关键,它定义了代码的组织方式与思维方式。类型系统(静态/动态、强/弱)和内存管理(手动/GC/所有权)则直接影响着代码的可靠性、开发效率与运行时性能,是工程实践中必须权衡的核心要素。从编译与解释等执行方式的差异,到具体应用场景的匹配,这些通用概念构成了评估任何编程语言的统一框架。掌握这一模型,开发者便能超越语法细节与社区争论,在面对Python、JavaScript、Go、

weixin_30301449的博客 541

AI工程化语言选型:Python、Rust、Java、Go在真实场景中的不可替代性

编程语言是AI工程落地的核心载体,而非算法研究的附属工具。理解语言的本质需回归其设计目标:Python以开发效率和生态丰富性支撑快速实验;Rust凭借内存安全与零成本抽象成为高并发推理与基础设施的首选;Java依托JVM成熟度与企业级集成能力,稳坐风控、金融等关键系统的‘压舱石’;Go则以轻量协程和单二进制部署专治Python服务的性能瓶颈。这些语言的价值不在语法优劣,而在于它们如何匹配数据预处理、模型训练、边缘推理、系统集成等不同阶段的刚性约束。本文基于23个工业级AI项目实践,解析六种主流语言在AI全链

weixin_33858485的博客 735

QT5.14.2离线安装包保姆级教程:断网、选组件、避坑全记录

本文详细介绍了QT5.14.2离线安装包的完整流程,特别针对Windows平台开发者提供断网安装、组件选择及避坑指南。作为QT5系列中最后一个免费离线版本,5.14.2具有免注册、全组件离线安装等独特优势,是开源开发者的理想选择。文章涵盖从环境准备到安装后配置的全方位指导,帮助开发者高效完成安装并避免常见问题。

weixin_30924087的博客 580

rust中的类型系统(trait的了解)

有些静态语言,如C和C++,在编译期并不检查数组是否越界访问,运行时可能会得到难以意料的结果,而程序依旧正常运行,这属于类型系统中未定义的行为,所以它们不是类型安全的语言。,这样的类型系统就叫作多态类型系统。Rust中绝大部分类型都是在编译期可确定大小的类型(SizedType),比如原生整数类型u32固定是4个字节,u64固定是8个字节,等等,都是可以在编译期确定大小的类型。比如str类型的字符串字面量,编译器不可能事先知道程序中会出现什么样的字符串,所以对于编译器来说,str类型的大小是无法确定的。

weixin_53344209的博客 1058

南京邮电大学电工电子实验(二)复习一

本文给电工电子实验(二)的复习进行一些知识点的提醒

YOUXISUN的博客 2963

Rust入门

少开发者心智负担安全容易优化某一类数据可能含有一些共同的行为:例如它们能被显示在屏幕上,或者能相互之间比较大小…我们将这种共同的行为称作Traits。我们使用标准库这个traits举例,这个traits实现了在Formatter中使用空白格式的功能x: i32,y: i32,write!assert_eq!(format!

qq_37155440的博客 1824

安装esxi7.0

保存重启后就能安装。vCenter Server是VMware vSphere虚拟化架构中的核心管理工具,充当ESXi主机及虚拟机中心管理点的服务,利用vCenter Server,可以集中管理多ESXi主机及其虚拟机,安装、配置和管理vCenter Server 不当可能会导致管理效率降低,或者致使EXSi主机和虚拟机停用。提示选择安装VMware ESXi 使用的存储,ESXi支持U盘以及SD卡安装,如系统中存在多块存储设备,选择需要安装系统的磁盘【注意磁盘142G,ESXI会将120G做VMFSL】

u011220233的博客 1万+

告别手动群发!用IDA Pro和CE搞定企业微信4.1.38.6011的HOOK开发(附完整代码)

本文详细介绍了如何利用IDA Pro和Cheat Engine进行企业微信4.1.38.6011的HOOK开发,实现自动化群发功能。从逆向工程环境配置、关键函数定位到HOOK框架设计,提供完整代码示例,帮助企业提升运营效率。

weixin_42533120的博客 480

类型系统和trait相关

特征就是定义一个共同的行为集合,做接口类,不同的类型可以具体实现这些行为,这就实现了ad-hoc,同一个函数签名,不同类型的参数使用,具体实现不一样。还有一些表达式,有时有返回值,有时没有返回值(也就是只返回单元值),或者有时返回正确的值,有时返回错误的值,Rust 将这类情况也纳入了类型系统,也就是。几乎总是使用特征对象的引用方式,如 &dyn Draw、Box(虽然特征对象没有固定大小,但它的引用类型的大小是固定的,它由两个指针组成(ptr 和 vptr),因此占用两个指针大小)

weixin_53344209的博客 737

Hermes Agent 对阵 OpenClaw:自我改进的 AI 队友

但在 2026 年 2 月,Nous Research 发布了 Hermes Agent,它带来了不同的愿景:一个不仅能够运行,还能学习的代理。在完成复杂的多步骤任务后,它会分析自己的操作并创建一个可复用的技能。对于已在使用 OpenClaw 的澳大利亚企业而言,这意味着您可以试用 Hermes Agent,而无需丢失数月的配置和自定义成果。最重要的区别在于理念:OpenClaw 是一个需要配置的工具,而 Hermes Agent 则是一个会学习的队友。OpenClaw 的技能是静态的。

xiaoshun007的专栏 1573

编程语言难度五维评估模型:从Python到汇编的逆向排名解析

编程语言的学习与应用涉及多维度的技术挑战,其核心在于理解不同语言的设计哲学与实现原理。从概念层面看,编程语言通过语法、类型系统和执行模型构建了开发者与计算机沟通的抽象层;其原理体现在内存管理、并发模型和编译运行机制上。这些设计直接影响语言的技术价值,如在性能、安全性与开发效率间的权衡。在实际应用场景中,心智模型和生态系统复杂度成为关键因素,例如JavaScript的异步事件循环和npm生态的依赖管理,以及Rust的所有权系统带来的编译期安全保障。本文通过构建学习曲线、心智模型、生态系统复杂度、调试排错和生产

weixin_33898233的博客 375

蓝桥杯第七届省赛试题--“模拟风扇控制系统”

题目要求 功能简述 “模拟风扇控制系统”能够模拟电风扇工作,通过按键控制风扇的转动速度和定时时间,数码管实时显示风扇的工作模式,动态倒计时显示剩余的定时时间,系统主要由数码管显示、单片机最小系统、按键输入和电机控制保护电路组成,系统框图如图 1 所示: 单总线驱动程序、CT107D 单片机考试平台电路原理图以及本题所涉及到的芯片数据手册,可参考计算机上的电子文档。程序流程图及相关工程文件请以考生...

qq_43280087的博客 2663

特别章节-0.1 SolidWorks导出机械臂的URDF模型各个关节坐标系设置

通过Solidworks导出机械臂的URDF模型文件,建立机械臂的各个关节坐标系的规则以及注意点,详细步骤

六眼飞鱼的博客 1万+

感受 Rust

首先, 有了它, 就可以将语句也纳入类型系统了, 这样子整个类型系统就完整了, 可以将所有的语言特性都归纳到类型系统之上. 类型系统可以做到如此的严谨性是我在学习 rust 之前所没有认识到的. 就接近于数学系统或者逻辑系统了.其次, 为什么用这个符号()来表示空呢?之前也没有过多的思考, 总是觉得用两个符号来表示一个概念, 是有点奇怪, 但是今天突然醒悟, 如果不用这个, 那么又能用什么呢?这个空类型, 我在学习 rust 之前是没有接触过的, 所以我对于有这样一个类型觉得很奇怪, 也很有趣.

shisiye15的专栏 476

YOLOv5改进策略|实战应用案例|YOLOv5苹果成熟度检测 ,准确率提升4.6%

苹果作为世界四⼤⽔果之⼀,富含多种维⽣素和矿物质,⼀直深受世界各地消费者的喜爱。据联 合国粮⻝及农业组织统计,全球⽔果产量中,苹果位列第⼆位,仅次于葡萄(贾等⼈,2020 )。然⽽,⼤多数苹果果实都是⼿⼯采摘的,这样的⽣产⽅法效率很低。此外,随着⼈⼝⽼龄化 和农村劳动⼒⼤量涌⼊城市,⽔果种植⾏业的劳动⼒成本也相应上升。所有这些因素都显着影响 着⽔果产品的市场竞争⼒。因此,实时⾼效采收苹果等⽔果,降低采收成本势在必⾏。基于机器 视觉的⽔果采摘机器⼈可以利⽤其信息感知来识别和采摘⽔果。

斌擎科技 2209

编程语言难度评估框架:从Python到汇编的10级排名与选型指南

编程语言的学习曲线和工程实践难度是开发者进行技术选型与学习规划的核心考量。从概念上讲,编程语言的难度并非单一维度,而是由入门门槛、精通成本、生态成熟度及心智负担等多个层面共同构成。其原理在于不同语言的设计哲学、类型系统、内存管理模型及并发范式存在本质差异,这直接影响了开发效率与代码质量。从技术价值看,理解语言难度有助于团队匹配技术栈与项目需求,平衡开发速度与系统可靠性。在应用场景上,快速原型开发常选用Python等脚本语言,而高性能系统、嵌入式开发则需考虑Rust、C++等系统级语言。本文基于工程实践视角,

weixin_34133829的博客 353

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

rust基础知识

类型是对二进制数据的一种约束行为.类型比起直接使用二进制数据,有许多优势:·减少开发者心智负担·安全·容易优化。

qq_44588140的博客 1874

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

编程语言难度排名:从Python到汇编,如何选择最适合你的学习路径?

编程语言作为软件开发的基石,其学习难度直接影响开发者的入门效率和职业发展。不同语言的设计哲学、语法特性和应用场景决定了其学习曲线的陡峭程度。从语法亲和力、编程范式、生态工具链、调试成本和社区资源五个维度综合评估,可以构建一个务实的“难度测量仪”。例如,Python以其简洁语法和丰富库生态成为新手友好型语言,而JavaScript则因异步编程和快速迭代的框架生态增加了实践复杂度。对于追求高性能和系统级控制的开发者,C++和Rust提供了强大能力,但也带来了手动内存管理和所有权模型等高级概念的学习门槛。理解这些

weixin_30326741的博客 431

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Go到Rust项目重写实战:并发模型、错误处理与性能对比

并发编程是现代软件开发的核心概念,它允许多个任务同时执行,从而提升系统吞吐量和响应速度。其原理通常基于线程、协程或事件循环等机制,通过合理的任务调度和资源共享来实现并行处理。在工程实践中,选择适合的并发模型能显著提升应用性能与可靠性。Go语言凭借其轻量级的goroutine和channel机制,为高并发场景提供了简洁的解决方案;而Rust则通过所有权系统和async/await范式,在编译期即保障内存安全与线程安全,从根本上杜绝数据竞争等问题。这两种语言在错误处理上也风格迥异:Go采用显式的if err !

weixin_33694620的博客 626

Rust与Node.js内存管理深度对比:从GC到零成本抽象的技术选型指南

内存管理是后端服务性能优化的核心议题,其实现原理直接决定了系统的资源效率与稳定性。垃圾回收(GC)机制通过运行时自动管理内存,为开发者提供了便利,但引入了堆内存膨胀与GC停顿的不确定性开销。相比之下,零成本抽象理念通过在编译期进行严格的所有权与生命周期检查,实现了确定性的内存分配与释放,从根源上避免了运行时GC开销。这种差异在长期运行、高并发的AI推理与微服务场景下价值凸显,能够显著降低内存占用、提升资源利用率,并为延迟敏感型应用提供更稳定的性能表现。本文以Rust和Node.js的对比为切入点,深入剖析了

weixin_33842304的博客 398

编程语言难度排名:从Python到Lisp,10种语言学习成本全解析

编程语言是开发者与计算机沟通的核心工具,其设计哲学和语法特性决定了学习曲线和应用场景。从原理上看,语言的难度通常由语法复杂度、概念抽象层级、生态成熟度等维度综合决定。在技术价值层面,易学的语言能快速实现想法、降低入门门槛,而复杂的语言则提供了更强的控制力、性能或独特的编程范式,适用于系统级开发、高性能计算或学术研究。常见的应用场景包括Web开发、数据分析、移动应用、操作系统、嵌入式系统等。本文基于‘编程语言难度测量仪’思维模型,对Python、JavaScript、Java、Go、C#、C++、Rust、H

weixin_33806914的博客 412

掌握多门计算机语言之后,如何高效学习新语言与切换编程思维

摘要:资深工程师学习新编程语言时,核心挑战在于思维模式的切换而非语法掌握。文章提出三大策略:1)避免用旧语言思维套用新语言,应从设计哲学入手理解差异点;2)识别主导范式(如函数式、Actor模型),通过刻意练习建立新心智模型;3)快速掌握工具链与生态特性。强调学习本质是抽象能力的迭代,应关注语言在特定场景的表现力而非优劣比较,最终实现从"语法转换"到"范式迁移"的认知升级。(149字)

nbsaas-boot基于Request-Response的企业级快速开发框架 1164
上一篇: 用 Rust 构建智能命令行工具:从 Agent 调用到流式输出
下一篇: 从动态语言到 Rust:类型系统与所有权的心智模型转换
第一程序员
博客等级 码龄1年 1万+粉丝 1827原创
评论 6
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值