基于大数据的地铁客流预测系统的设计与实现(源码+lw+部署文档+讲解等)

医美小程序实战教程-建立数据源及创建应用 我们前几期分析了一下官方的模板,官方模板使用了大量的自己封装的SDK,而且还没有任何说明,研究了一下发现路不是特别行的通。 既然逆向的思维不奏效,那我们就正着实现。正着实现的起点是先从数据源的建立开始。那具体需要怎么做呢? 我们需要先研究一下官方模板的PC端的功能是如何实现的。因为PC端的功能对应的是增删改查,我们只要理顺了里边的逻辑就可以照着实现。 店铺管理的功能 官方提供了店铺管理的功能,就是一个编辑和查看的功能。从我自己的角度去看,直接提供修改的功能好像也不太合理,这种就需要初始化的时候就把店铺的信息 阅读详情

   💯博主:✌全网拥有20W+粉丝、博客专家、全栈领域优质创作者、平台优质Java创作者、专注于Java技术领域和毕业项目实战✌💯
💗开发技术:SpringBoot、Vue、SSM、PHP、Nodejs、Python、爬虫、数据可视化、小程序、安卓app、大数据、机器学习等设计与开发。💗
👇🏻 推荐订阅👇🏻

Java精品实战案例《600套》
🌟文末获取源码+数据库方式🌟
感兴趣的可以先收藏起来,大家在毕设选题,项目以及报告编写等相关问题都可以给我咨询,希望帮助更多的人(免费提供选题指导)

系统需求分析:

   系统开发采用“前端 + 后端 + MySQL数据库”三层架构的模式进行分层设计与开发。这种架构有助于代码的模块化管理,提升系统的可维护性和扩展性。在实际开发中,前端主要负责与用户交互的界面展示与数据提交,常用技术包括Vue;后端则负责业务逻辑处理、数据接口开发与权限管理,常用技术有Java(Spring Boot)、Python(Flask、Django)等;数据库层则使用MySQL等关系型数据库进行数据存储与管理。系统开发的第一步通常是进行数据库表的结构设计,根据业务需求规划数据模型和字段关联关系,确保数据逻辑的完整性。随后再进行前后端框架的搭建,前后端各自独立开发,通过RESTful API等接口实现数据的交互与功能的集成,从而提高系统开发效率与运行性能。

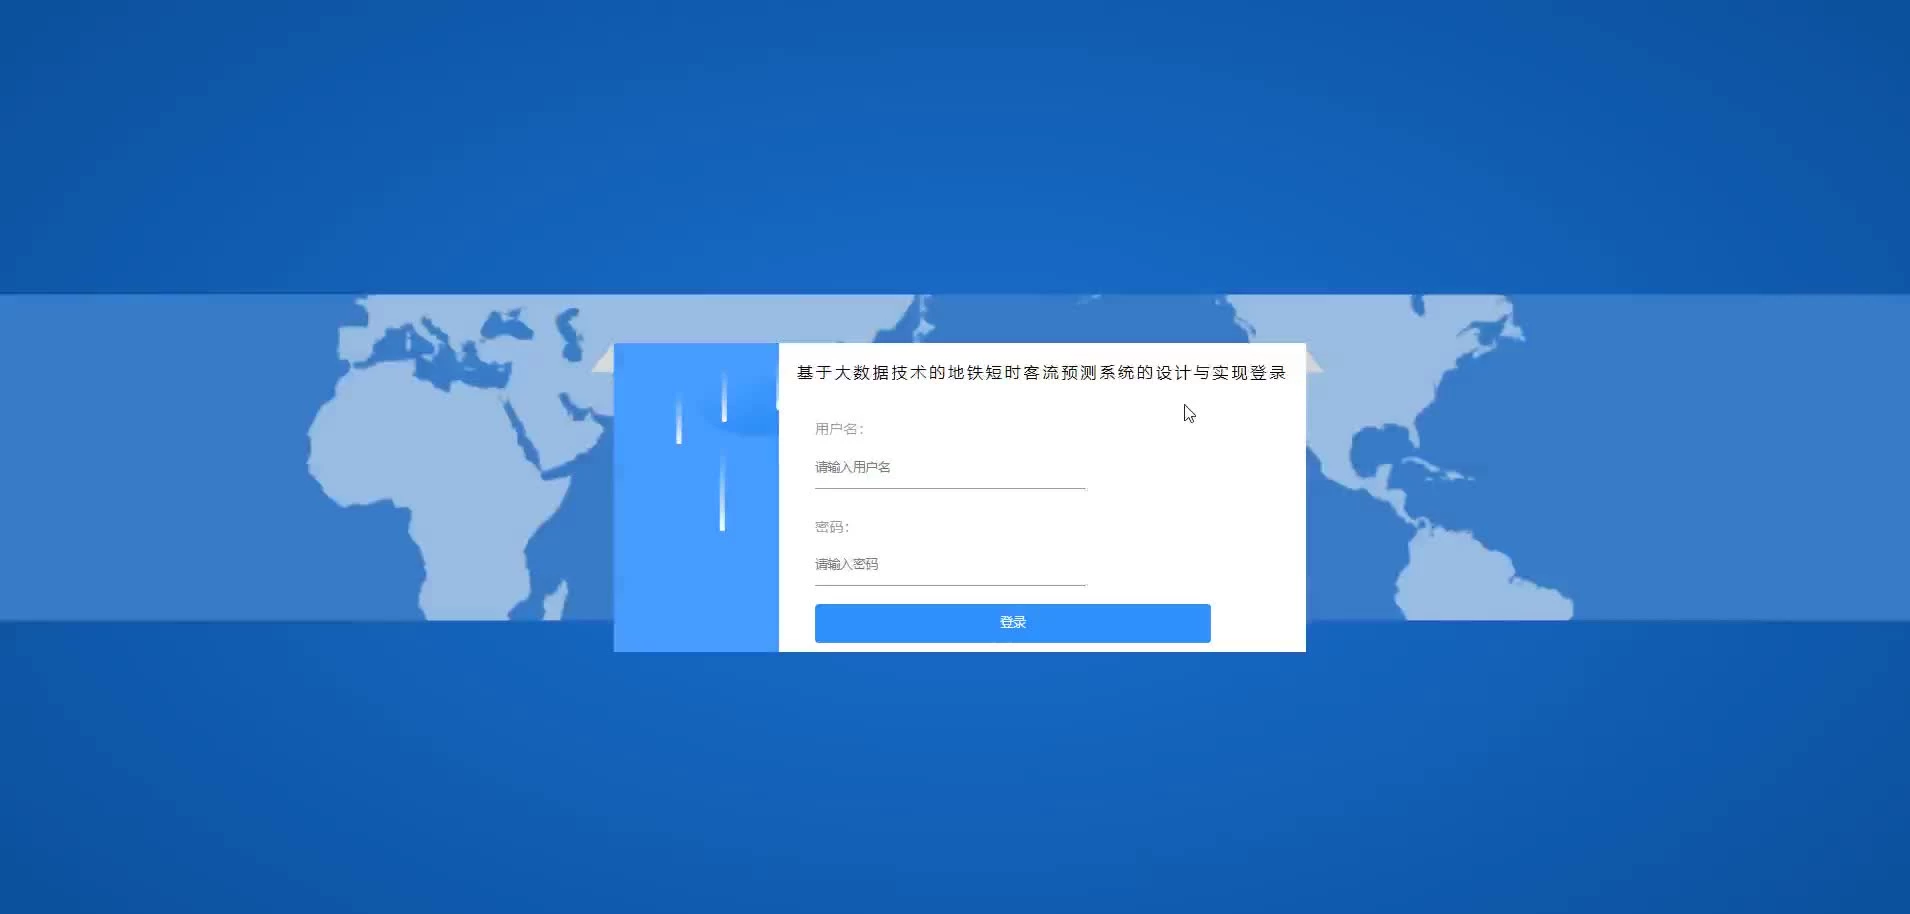
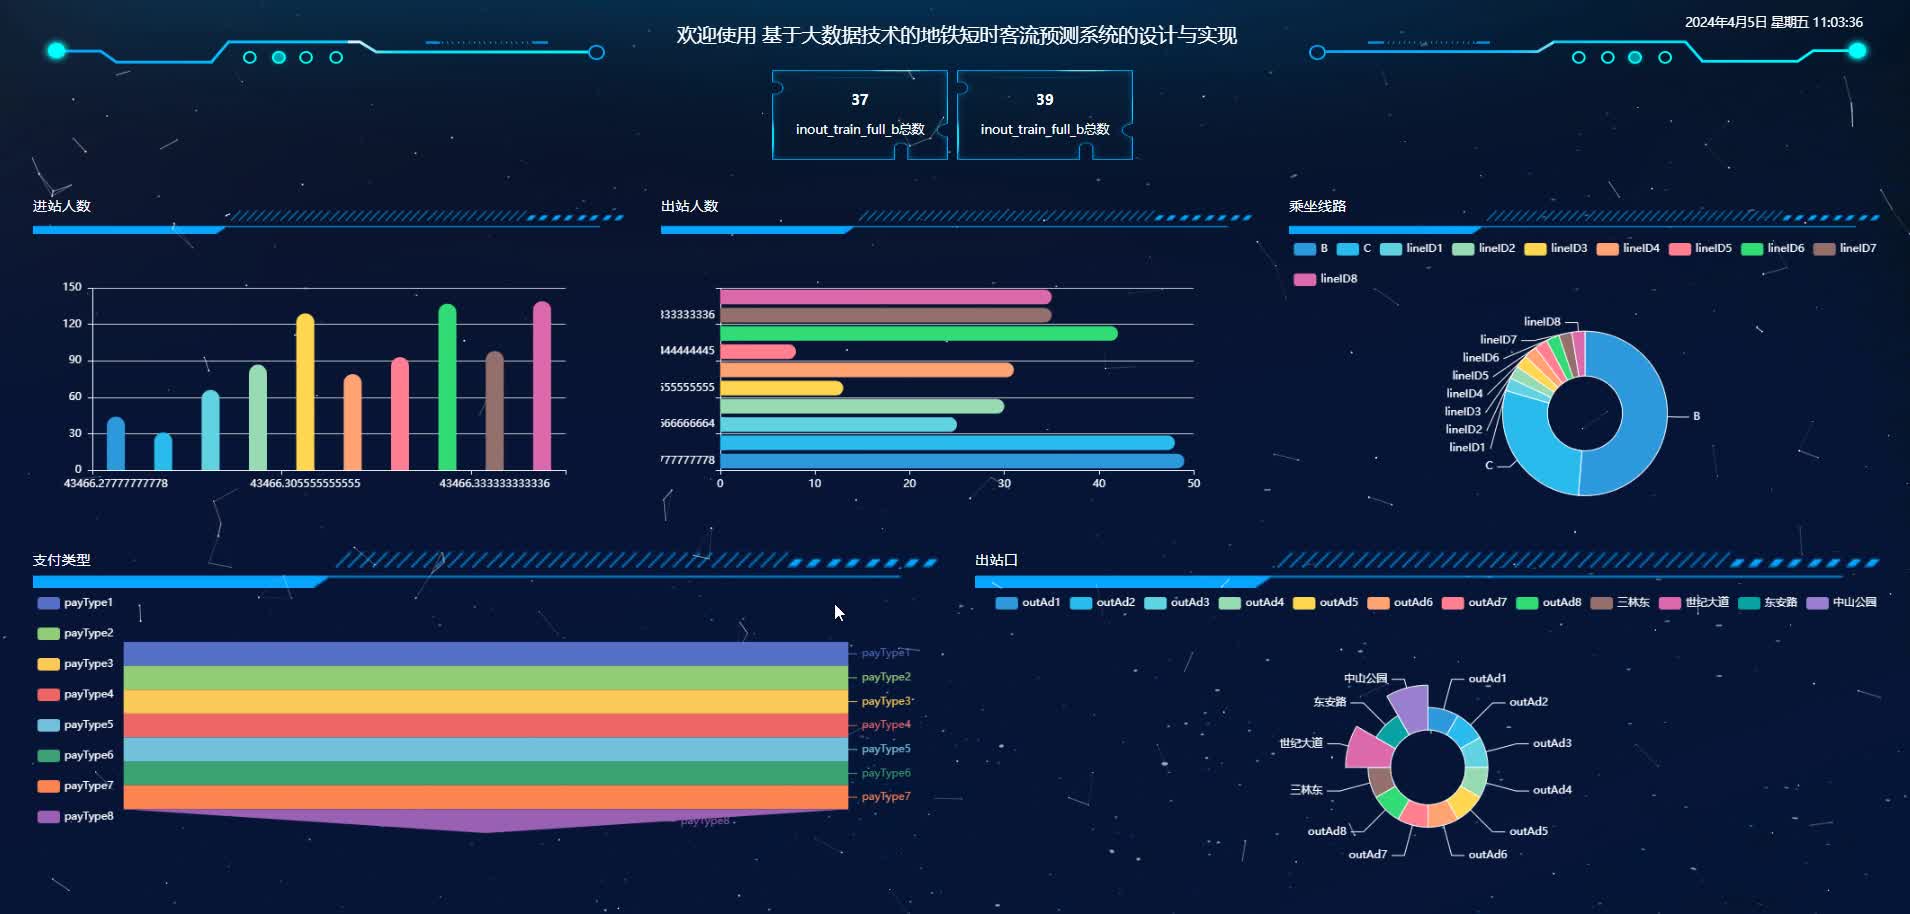
实现截图:


 代码参考:

/**
     * 协同算法(基于用户的协同算法)
     */
    @RequestMapping("/list")
    public R xietong(@RequestParam Map<String, Object> params, ZaixianyinleEntity zaixianyinle, HttpServletRequest request){
        String userId = request.getSession().getAttribute("userId").toString();
        Integer limit = params.get("limit")==null?10:Integer.parseInt(params.get("limit").toString());
        List<StoreupEntity> storeupEntities = storeupService.selectList(new EntityWrapper<StoreupEntity>());
        Map<String, Map<String, Double>> ratings = new HashMap<>();
        if(storeupEntities!=null && storeupEntities.size()>0) {
            for(StoreupEntity o : storeupEntities) {
                Map<String, Double> userRatings = null;
                if(ratings.containsKey(o.getUserid().toString())) {
                    userRatings = ratings.get(o.getUserid().toString());
                } else {
                    userRatings = new HashMap<>();
                    ratings.put(o.getUserid().toString(), userRatings);
                }
                if(userRatings.containsKey(o.getRefid().toString())) {
                    userRatings.put(o.getRefid().toString(), userRatings.get(o.getRefid().toString())+1.0);
                } else {
                    userRatings.put(o.getRefid().toString(), 1.0);
                }

            }
        }
        // 创建协同过滤对象
        UserBasedCollaborativeFiltering filter = new UserBasedCollaborativeFiltering(ratings);

        // 为指定用户推荐物品
        String targetUser = userId;
        int numRecommendations = limit;
        List<String> recommendations = filter.recommendItems(targetUser, numRecommendations);

        // 输出推荐结果
        System.out.println("Recommendations for " + targetUser + ":");
        for (String item : recommendations) {
            System.out.println(item);
        }

        EntityWrapper<ZaixianyinleEntity> ew = new EntityWrapper<ZaixianyinleEntity>();
        ew.in("id", recommendations);
        if(recommendations!=null && recommendations.size()>0) {
            ew.last("order by FIELD(id, "+String.join(",", recommendations)+")");
        }

        PageUtils page = zaixianyinleService.queryPage(params, ew);
        List<ZaixianyinleEntity> pageList = (List<ZaixianyinleEntity>)page.getList();
        if(pageList.size()<limit) {
            int toAddNum = limit-pageList.size();
            ew = new EntityWrapper<ZaixianyinleEntity>();
            ew.notIn("id", recommendations);
            ew.orderBy("id", false);
            ew.last("limit "+toAddNum);
            pageList.addAll(zaixianyinleService.selectList(ew));
        } else if(pageList.size()>limit) {
            pageList = pageList.subList(0, limit);
        }
        page.setList(pageList);

        return R.ok().put("data", page);
    }

SQL设计参考:

DROP TABLE IF EXISTS `chat`;
CREATE TABLE `chat` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '主键',
  `addtime` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
  `userid` bigint NOT NULL COMMENT '用户id',
  `adminid` bigint DEFAULT NULL COMMENT '管理员id',
  `ask` longtext CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci COMMENT '提问',
  `reply` longtext CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci COMMENT '回复',
  `isreply` int DEFAULT NULL COMMENT '是否回复',
  `isread` int DEFAULT '0' COMMENT '已读/未读(1:已读,0:未读)',
  `uname` varchar(200) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '用户头像',
  `uimage` longtext CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci COMMENT '用户名',
  `type` int DEFAULT '1' COMMENT '内容类型(1:文本,2:图片,3:视频,4:文件,5:表情)',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=9 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='智能客服';

技术栈介绍:

Springboot介绍:

     Spring Boot 是基于 Spring 框架的快速开发框架,旨在简化企业级应用的开发过程。它通过自动配置、内嵌服务器(如Tomcat)、简化依赖管理等特性,大幅减少了繁琐的配置工作,使开发者能更专注于业务逻辑的实现。Spring Boot 支持主流数据库、缓存、消息队列等常用组件,提供强大的RESTful接口支持,广泛应用于微服务架构开发中。其项目结构清晰,适合构建可维护、可扩展的系统。使用Spring Boot能有效提升开发效率,加快项目上线速度。。

黑白盒测试:

   黑盒测试和白盒测试是软件测试中常用的两种方法。黑盒测试关注软件的功能性,不考虑内部代码结构,主要通过输入和输出验证系统是否按预期工作,适用于功能测试、界面测试等。白盒测试则注重程序内部逻辑结构,测试人员需要了解代码实现,通过代码覆盖、条件判断、路径执行等方式验证程序的正确性,常用于单元测试、逻辑测试等。两者各有侧重,黑盒侧重“看得见的功能”,白盒强调“看得见的代码”。在实际项目中,通常结合使用,提升软件质量和稳定性。

开发案例:

源码获取: 

    博主专注于java、python、小程序开发,拥有多年开发经验,可以一对一进行程序开发和讲解,成品源码和项目定制都可以帮您实现!!!

大家点赞、收藏、关注、评论啦 、查看👇🏻获取联系方式👇🏻

Java精品实战项目案例《600套》

精彩专栏推荐订阅:在下方专栏👇🏻

下方名片联系我即可~

java项目管理系统源码 1.登录界面:背景识别模块主要用于验证管理员的身份和密码。 2.主页:进入主页后可以点击左侧项目信息管理、资源信息管理、进度信息管理、个人密码修改等图标,进入相应的管理页面 3.项目管理:本模块实现对企业项目信息的管理操作,包括企业项目信息的添加、删除操作。 4.项目资源管理:本模块实现对项目资源信息的管理操作,包括项目资源信息的添加、删除操作。 6.项目经费管理:本模块实现对项目经费信息的管理操作,包括项目经费信息的添加、删除操作。点击项目经费信息管理菜单,进入项目经费信息管理页面,该页面通过列表列出已添加的项目经费信息,包括项目名称、经费金额、追加时间等。 7.项目进度管理:本模块实现对项目进度信息的管理操作,包括项目进度信息的添加、删除操作。点击项目进度信息管理菜单,进入项目进度信息管理页面,该页面通过列表列出已添加的项目进度信息,包括进度描述、添加时间、百分比等。 8.项目成果管理:本模块实现对项目成果信息的管理操作,包括项目成果信息的添加、删除操作。点击项目成果信息管理菜单,进入项目成果信息管理页面,该页面通过列表列出已添加的项目成果信息,包括进度描述、添加时间、百分比等。 立即下载

相关推荐

[详细完整版]档案管理系统.doc

RFID智能档案管理系统 设计方案 1. 档案管理的现状与问题 近年来,我国档案管理事业取得了长足的发展,档案管理事业的规模扩大了,数量也 逐日增多,档案的种类日趋多样化,信息量迅速膨胀。但传统保密档案管理手段与技术 所导致的问题日益突显: 1. 保密档案编目流程繁琐低效、整理时间冗长   传统方式下,保密档案入馆后先需进行分类、排序,并去装钉,然后由人工撰写档 案盒的相关信息,最后手工抄写档案目录,并将目录连同档案一起封装入档案盒内。这 种操作方式耗费大量活劳动和时间,导致较多档案入馆后被长期堆放、一隅得不到及时 整理归档。此外,档案编目与档案盒誊写多为简单、重复性劳动,手工处理方式使得整 个流程既繁琐又低效。 2. 档案存放次序较易被打乱 虽然档案一般都分类存放,但是在档案存取过程中,由于人工操作的随意性和一些不 可避免的错误,档案存放的次序难免被打乱,造成档案存放无序,查找困难。 3. 档案查阅耗时长 随着档案规模与种类越来越庞大,要查找某一档案时,先由管理员找到存放该类型档 案的架,再根据档案的编目信息在档案架的每一格进行查找。一旦档案存取时没有按规 定存放在指定的位置,查找起

java版工程项目管理系统源代码-功能清单 图文解析

项目计划管理:计划的查询、新增、编辑、删除、甘特图保存为基线、设置为模板、任务时间及顺序调整、全局资源配置、引用系统模板、导入project文件、导出XML文件等功能。工程竣工验收:工程竣工验收的查询、新增、编辑、查看、删除、附件上传、验收异常填写异常信息、选择整改部门和责任人等功能。质量检查:质量检查的查询、新增、编辑、查看、删除、附件上传、验收异常填写异常信息、选择整改部门和责任人等功能。项目列表:项目的新增、编辑、删除、导出、终止、查询、项目指引的编辑删除、文件的存档、提审等功能。

m0_59198293的博客 1274

工程项目管理系统(源码+开题)

2)实现员工信息、项目负责人信息、项目信息、立项信息、方案决策、施工情况、审计情况、合同信息、项目核算等的录入和管理功能;然后,开发系统的前端界面和后端功能模块,实现员工信息、项目负责人信息、项目信息、立项信息、方案决策、施工情况、审计情况、合同信息、项目核算等的录入和管理功能。最后,测试和优化系统的性能和用户体验,确保系统能够满足项目管理的需求。同时,系统还可以提供立项信息、方案决策、施工情况、审计情况、合同信息、项目核算等功能,帮助项目负责人进行项目的全面管理和监控。最终成品以下面运行环境。

萧达毕设程序 2312

Java Swing之多文档界面设计-JDesktopPane、JInternalFrame类简单应用示例

Java MDI多文档界面是一种用户界面风格,允许在一个主窗口中包含多个子窗口(文档窗口),每个子窗口可以显示不同的内容或功能模块,从而可以满足用户打开不同窗口完成不同功能的需求。开发多文档程序,一般需要JDesktopPane(桌面面板类)和JInternalFrame(内部窗体类)两个类。以下简单介绍,最后通过一个实例介绍实现逻辑。

编程语言教学工作者的博客 2212

POWER(十一)charge pump原理

电荷泵是一种基于电容充放电原理的DC-DC转换电路,通过开关控制实现电压转换,包括升压、降压和负压输出。其核心是利用电荷守恒原理,通过电容存储和转移电荷来改变输出电压。典型拓扑结构包括倍压电路和多阶升压电路,具有结构简单、体积小等优势。关键参数包括转换效率、输出电流能力和开关频率,适用于芯片供电、显示屏驱动等低功耗场景。LVDS部分补充说明了自举电路在驱动电路中的应用及其自同步特性。

zhlwsh的博客 2833

基于大数据技术的地铁短时客流预测系统的设计与实现(源码+lw+部署文档+讲解等)

在地铁网络化运营与客流激增的背景下,传统客流管理存在明显短板:依赖历史数据人工估算,早高峰 "某换乘站瞬时客流超承载量 30%" 的情况频发;预测维度单一,无法结合 "天气、大型活动" 等动态因素调整,导致 "暴雨天未加派临时列车" 引发拥堵;预警响应滞后,等站台出现拥挤才启动疏导,错失最佳干预时机;数据碎片化,各线路客流数据未联动分析,难以支撑全网运力调配决策。 基于大数据技术的地铁短时客流预测系统,可破解上述问题。技术上采用 Hadoop 存储历史客流与多维影响因子数据,Spark MLlib 构建时序

984

halcon 深度学习标注_Halcon deep learning之目标检测笔记(一)

设置输入输出的路径输入路径有两个,一个是图像路径HalconImageDir,一个是Json文件路径PillBagJsonFile。这两个参数用于后续在图像路径中读取coco文件。输出路径首先定义一个新的文件夹路径,用于存放样本和模型文件等数据。设置基于深度学习的目标检测模型的路径,该模型文件以.hdl结尾。设置样本数据文件夹ExampleDataDir:'detect_pills_data'数据...

weixin_27885313的博客 2701

基于python+django的大数据技术的地铁短时客流预测系统的设计与实现(源码+lw+部署文档+讲解等)

基于 Python + Django 的大数据技术的地铁短时客流预测系统,借助 Python 的丰富数据处理能力与 Django 强大的 Web 开发框架,实现对地铁短时客流的精准预测与展示。 Python 拥有众多适合大数据处理与机器学习的库,像 Pandas 用于数据清洗和预处理,Numpy 进行高效数值计算,Scikit - learn 提供各类机器学习算法,而 TensorFlow 或 PyTorch 可用于深度学习模型搭建,这些都为客流数据的深度分析和预测提供了有力支持。Django 则负责搭建系

全网粉丝10W+、全栈领域优质创作者、掘金、阿里云等社区博客专家、专注于全栈领域和毕业项目实战 1049

从CAD到Web:高效转换STEP/IGES模型为GLB格式的实践指南

本文详细介绍了如何将工业设计中的STEP/IGES模型高效转换为Web友好的GLB格式。通过PythonOCC和gltf-pipeline等工具链,实现从CAD到Web的无缝转换,大幅提升模型加载速度和展示效果。文章包含实战案例、优化技巧和常见问题解决方案,帮助开发者快速掌握3D模型转换技术。

weixin_29072299的博客 510

【Proteus仿真】点亮小灯系列仿真——小灯闪烁/流水灯/交通灯

本文介绍了基于AT89C51单片机的LED控制案例,共包含5个实例:1)单个LED闪烁;2)共阳极流水灯;3)共阴极流水灯;4)花样流水灯;5)交通灯模拟。每个案例详细说明了电路原理图、接线方式和控制程序实现,其中重点讲解了PWM调光原理及其在LED控制中的应用。案例由简至繁,从基础I/O控制到复杂花样显示,最后实现交通灯逻辑控制,展示了单片机在LED控制中的典型应用方法。文中提供了完整的源代码,便于读者理解和实践。

XU157303764的博客 1884

基于Hadoop大数据的地铁短时客流预测系统的设计与实现(源码+lw+部署文档+讲解等)

💗博主开发经历:全网拥有20W+粉丝、优快云作者、博客专家、全栈领域优质创作者、平台优质Java创作者、专注于Java、小程序、python、大数据、深度学习技术领域和毕业项目实战✌💟Java精品实战案例《1000套》2026-2027年最值得选择的Java毕业设计选题大全:1000个热门选题推荐✅✅✅📲文章开头咨询源码+数据库📱MySQL采用结构化查询语言SQL作为数据库操作的标准语言,具有高性能、高可靠性、易使用和跨平台等优点。

leishencode的博客 182

把数字化转型真正落到组织里:读懂 SAP 的 OCM 六维框架

摘要: SAP的变革管理框架(OCM)强调数字化转型不仅是技术任务,更需关注组织与人的适应性。OCM包含六大维度:变革战略(明确方向与风险)、变革领导力(统一关键管理者行动)、变革沟通(分层传递信息)、变革实现(细化岗位级影响)、变革赋能(按角色设计培训)和变革有效性(持续评估)。该框架贯穿项目全周期,尤其在云项目中,需从早期规划变革策略,避免后期高代价调整。OCM的核心是将系统设计转化为组织语言,确保业务真正采纳新方式运作。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1439

基于大数据技术的地铁短时客流预测系统的设计与实现(毕业设计源码+lw文档)

当前地铁运营管理存在明显短板:传统地铁运营方多依赖历史经验预判客流,难精准捕捉短时客流波动(如通勤高峰突发客流、大型活动散场客流),易出现站台拥挤、列车超载或运力浪费;客流数据(进出站人数、换乘量、列车满载率)分散在各站点终端,缺乏实时整合分析,难快速识别客流热点区域与拥堵风险;应急调度响应滞后,遇客流激增时,需人工研判后调整发车频次,易延误疏导时机,影响乘客出行体验;同时,客流预测与运营规划脱节,难以科学指导车站人员排班、设备运维,制约地铁服务效率与安全保障能力。 基于大数据技术的地铁短时客流预测系统,依

博主自己就是程序员、避免中介对接,从事软件开发多年,累计开发或辅导多名同学, 有丰富的项目开发和文档编写经验、同学们有任何项目问题都可以联系我~ 1130

论文翻译:Automatic Lesson Plan Generation via Large Language Models with Self-critique Prompting

在本文中,我们利用大型语言模型(LLMs)的理解和生成能力来自动生成定制化的课程计划。这解决了传统计划可能无法充分满足不同教学环境和学生群体的特定需求的常见挑战。我们提出了一个新颖的三阶段过程,包括使用检索增强生成(RAG)逐步生成课程计划的每个关键组成部分,通过LLMs进行自我批评,以及随后的细化。我们使用这种方法为小学2至5年级生成了涵盖80多个主题的数学课程计划。邀请了三位经验丰富的教育工作者制定全面的课程计划评估标准,然后使用这些标准将我们的LLM生成的课程计划与同一主题的实际课程计划进行基准比较。

CSPhD-winston的博客 1103

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

计算机毕业设计hadoop+spark+hive地铁预测可视化 智慧轨道交通系统 大数据毕业设计(源码+文档+PPT+讲解)

本文介绍了一个基于Hadoop+Spark+Hive的地铁客流量预测与可视化系统开发项目。项目利用大数据技术处理海量历史客流数据,结合机器学习模型实现精准预测,并通过可视化界面展示结果,辅助地铁运营调度。系统包含数据采集清洗、Hive数据仓库构建、Spark机器学习建模、Hadoop集群运维和前端可视化开发等模块,支持日均处理1000万条数据,查询响应时间≤3秒。项目采用Hadoop生态技术栈,预期实现短时预测误差≤50人/小时,日预测误差≤200人/天的目标,最终交付包含数据仓库、预测模型和可视化系统的完

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 1306

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

计算机毕业设计Spark地铁客流量预测 交通大数据 交通可视化 大数据毕业设计 深度学习 机器学习 大数据毕业设计(源码+LW文档+PPT+讲解)

本文介绍了一个基于Apache Spark的地铁客流量预测系统开发项目。系统采用分层架构设计,利用Spark处理TB级数据,结合机器学习算法(LSTM/XGBoost)实现高精度客流预测(MAPE≤10%)。项目包含数据采集、模型训练、可视化三大模块,支持实时预测与历史数据分析。实施周期9周,需4节点Spark集群资源。交付成果包括系统代码、模型文件和完整文档。该系统可提升地铁运营效率,适合大数据和机器学习领域的学习开发。

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 871

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

计算机毕业设计hadoop+spark+hive智慧交通 交通客流量预测系统 大数据毕业设计(源码+论文+PPT+讲解视频)

本文介绍了一个基于Hadoop+Spark+Hive的智慧交通客流量预测系统项目。项目通过整合多源交通数据(历史客流、天气、节假日等),利用大数据技术实现数据存储、清洗和特征工程,并应用机器学习算法(LSTM、XGBoost等)进行客流量预测。系统包含数据采集、分布式存储、模型训练、预测服务和可视化展示等模块,采用Hadoop生态技术栈,旨在为交通管理部门提供决策支持。项目预计8周完成,最终将部署可扩展的预测系统,支持地铁、公交等多种交通场景,目标预测精度达到行业领先水平。

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 825
上一篇: 基于python的高校二手交易网站设计与实现(源码+lw+部署文档+讲解等)
下一篇: 基于springboot+vue的微信小程序的投票系统的设计实现(源码+lw+部署文档+讲解等)
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值