llmware:在笔记本上跑 RAG 和本地大模型

5.3K+ Star!llmware:一个构建企业级RAG管道的统一框架 llmware[1]提供了一个统一的框架,用于构建基于大型语言模型(LLM)的应用,例如RAG(Retrieval-Augmented Generation)和多步骤代理工作流(Agent)。它使用小型、专门的模型,这些模型可以私有部署,安全地与企业知识源集成,并针对任何业务流程进行成本效益的调整和适应。 阅读详情

llmware:在笔记本上跑 RAG 和本地大模型

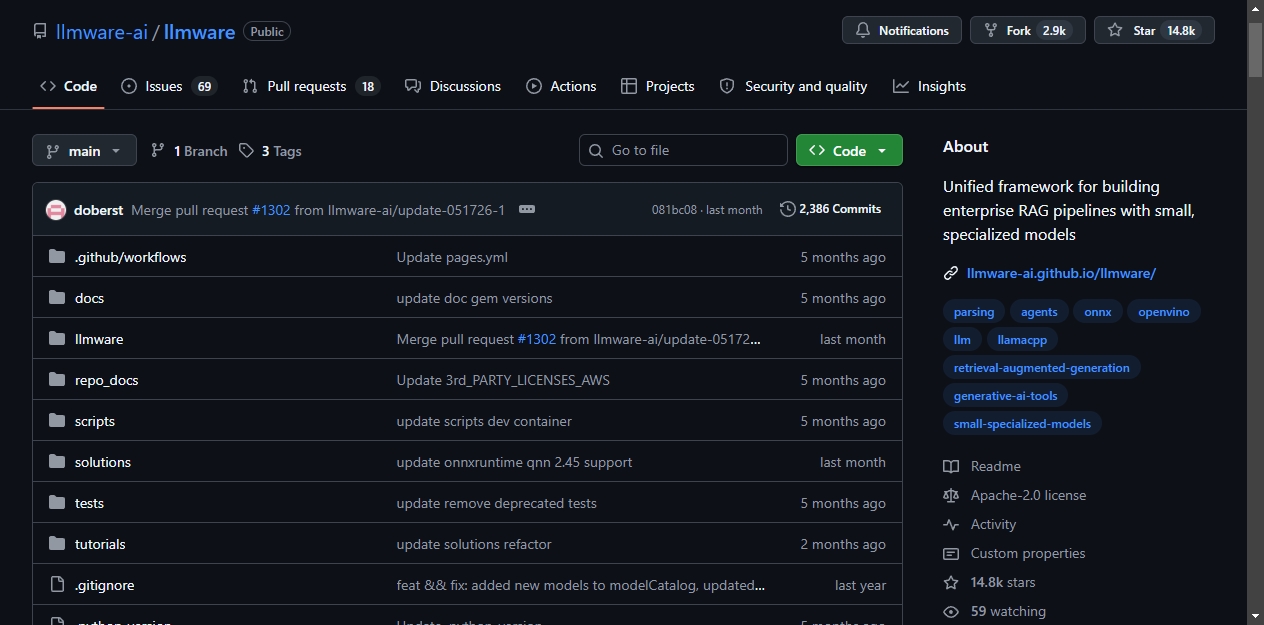
llmware 在 GitHub 上拿到 14.8K Star。

这个项目做了一件事:让你在本地设备上跑完整的 RAG 流程,从文档解析、知识库构建到模型推理,全程不需要调用外部 API。300 多个模型可以直接用,1B 到 9B 参数的小模型针对 RAG 做了专门优化。

1、它解决什么问题

做 RAG 的人都知道,真正的瓶颈往往不在模型本身,而在数据处理和部署环境。

企业文档格式五花八门,PDF 表格解析出来乱七八糟,Word 样式丢得一干二净。好不容易把文档处理好了,发现模型只能跑在云端,数据一上传,合规部门找上门。

llmware 把整条链路搬到了本地。文档解析、文本切分、向量嵌入、检索、推理,每一步都可以在你的笔记本上完成。对于那些对数据隐私有要求的企业场景,这基本是刚需。
正文顶部截图

2、核心架构

llmware 分两个部分。

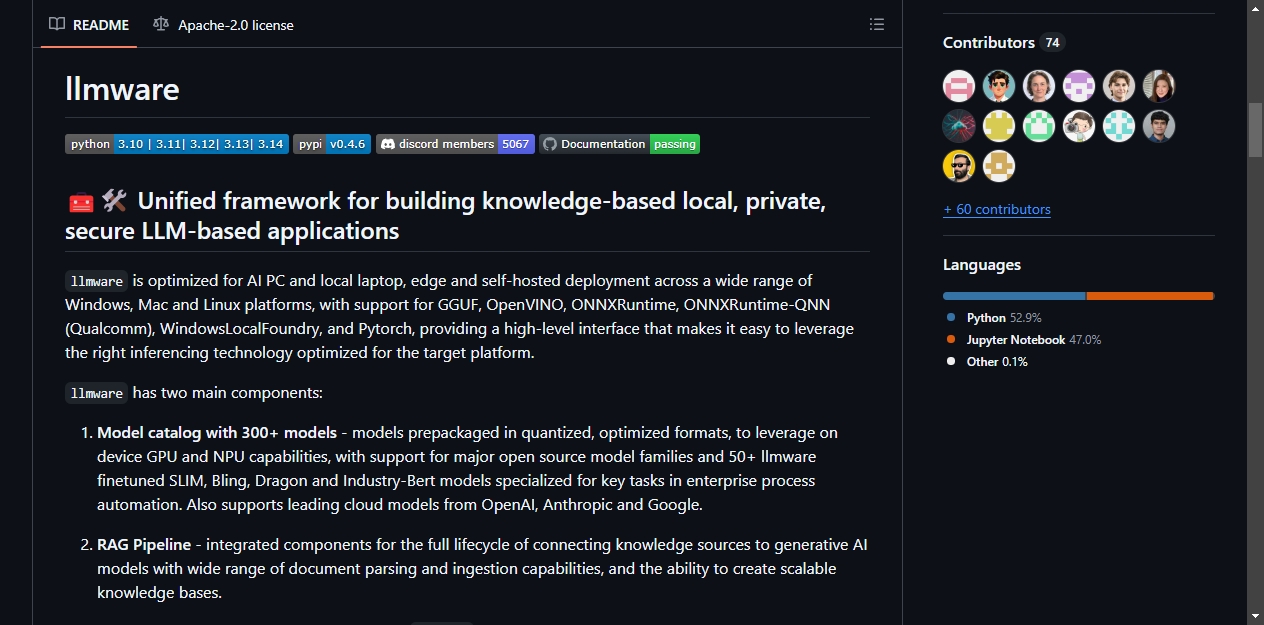
第一是模型目录。300 多个模型,按用途分成几个系列:BLING 系列是 1B 到 5B 的轻量模型,适合在 CPU 上跑 RAG 问答;DRAGON 系列是 6B 到 9B 的生产级 RAG 模型;SLIM 系列专门做函数调用和多步骤 Agent 工作流。模型都做了 GGUF 量化,笔记本上直接能加载。

第二是 RAG 管线。从解析文档到建立知识库再到查询推理,全流程内置。支持 PDF、Word、Excel、PPT、HTML、图片、音频等十几种格式的解析。向量数据库方面,Milvus、ChromaDB、FAISS、Qdrant、PGVector 都能接,灵活搭配。

3、几个值得关注的能力

本地推理:支持 GGUF、OpenVINO、ONNXRuntime,还能在高通芯片的 NPU 上跑。Windows、Mac、Linux 都覆盖,包括 ARM64 设备。

Prompt with Sources:把检索结果直接注入 prompt,模型回答基于你提供的上下文。自带事实校验方法,可以检查模型输出是否有来源支撑。

Agent 和函数调用:用 SLIM 模型可以做情感分析、实体提取、主题分类、布尔判断等结构化输出。多个 SLIM 模型组合起来就是一个多步骤 Agent。

数据库可插拔:文本存储支持 SQLite(开箱即用)、MongoDB、Postgres;向量库支持 10 种。从笔记本到集群都能适配。
README区域截图

4、快速上手

安装:

pip3 install llmware

如果需要完整功能(包括更多格式解析和向量库支持):

pip3 install 'llmware[full]'

最小化 RAG 示例,三步跑通:

from llmware.library import Library
from llmware.retrieval import Query
from llmware.prompts import Prompt

# 创建知识库,导入文档
lib = Library().create_new_library("my_library")
lib.add_files("/path/to/my/files")

# 安装向量嵌入
lib.install_new_embedding(embedding_model_name="mini-lm-sbert", vector_db="chromadb")

# 加载模型,基于知识库问答
prompter = Prompt().load_model("llmware/bling-phi-3-gguf")
source = prompter.add_source_new_query(lib, query="my question", result_count=5)
responses = prompter.prompt_with_source("my question")

不装数据库也行,SQLite + ChromaDB 都是文件级的,零配置启动。

5、适合谁用

  • 在做 RAG 系统、需要把企业文档灌进向量库的开发者,尤其是对数据安全有要求的场景
  • 想在本地设备上跑大模型推理、不想依赖云服务的团队
  • 在搭 AI Agent、需要多模型协作处理文档的场景

的开发者,尤其是对数据安全有要求的场景

  • 想在本地设备上跑大模型推理、不想依赖云服务的团队
  • 在搭 AI Agent、需要多模型协作处理文档的场景
llmware之小而精:构建企业级RAG管道的统一框架 llmware是一个开源企业级RAG框架,提供50+专业化小型模型和完整知识管理工具链。其核心优势包括:统一模型目录支持150+模型调用;灵活的Library模块构建知识库;多样化查询检索功能;Prompt模块实现检索与生成的端到端整合。相比Haystack等同类项目,llmware更注重轻量化部署和操作简化,支持普通笔记本无GPU运行。该框架通过优化RAG流程和本地化模型,为企业提供安全高效的LLM应用解决方案,特别适合私有化部署和流程自动化场景。 阅读详情

相关推荐

llmware:本地化AI应用开发框架,基于小模型与RAG实现私有知识库构建

检索增强生成(RAG)技术通过将外部知识库与大型语言模型结合,有效提升了模型回答的准确性和事实性,解决了传统模型容易产生“幻觉”的问题。其核心原理是先将文档进行向量化处理并存入向量数据库,当用户提问时,系统通过语义检索从知识库中找出最相关的文档片段,并将其作为上下文提供给模型,从而生成基于事实的答案。这项技术的核心价值在于能够低成本、高效率地将私有或领域知识注入AI应用,确保数据隐私和安全。在应用场景上,RAG特别适用于企业内部的智能客服、合同文档分析、技术知识库问答等需要精准、可靠信息的领域。本文聚焦的l

weixin_30437847的博客 437

LLM之RAG实战(十五)| RAG的自动源引文验证技术

方法指向我们的合同文件夹和特定的合同,然后这个方法将找出文档类型,通过解析文档特定的格式(例如PDF或Word文档)来提取内容,对文本进行分组,然后可以应用一个可选的过滤器,然后作为一个“上下文”进行批处理和打包,为推理做好准备,这样我们就不必再考虑它,也不必进行所有的数据操作——所有这些都是在这个强大的方法调用的幕后处理的。——这将审查LLM响应,识别响应中的任何数字,然后在源材料中查找匹配的数字值,如果提供,则会提供一个包含已确认事实的词典,显示事实、状态,以及提供确认的源和页码文本片段。

wshzd的博客 2348

机械臂抓取前言

机械臂相关的笔记

weixin_64037619的博客 3909

探索未来智能:揭秘 LLMware

是一个令人兴奋的开源项目,旨在提供高效、灵活的人工智能模型训练和推理框架。作为一个专注于自然语言处理(NLP)的技术平台,它将帮助开发者和研究人员更好地利用AI的力量,为各种应用提供强大的语义理解和生成能力。 ## 技术分析 LLMware 基于现代深度学习库如 TensorFlow 和 PyTorch,利用先进的 transformer 模型,如 BERT 或 GPT 系列,进行大规模文本数...

gitblog_00044的博客 606

Prometheus常用配置介绍

除了 scrape_configs 外,上部还有 global 和 rule_files 部分, 其中 global 中 是 全 局 参 数 , scrape_interval 指 定 全 局 默 认 的 时 间 间 隔 , evaluation_interval 指定告警规则校验的时间间隔,rule_files 指定了告警规 则文件的位置名称。• annotations(注释):它们被用于存储更长的其他信息,例如警报描述 或者链接,注释值也可以被模板化。• alert:告警的名称。

weixin_42886699的博客 2263

Kali Linux下John the Ripper实战:从识别yescrypt哈希到破解zip压缩包(保姆级避坑指南)

本文详细介绍了在Kali Linux中使用John the Ripper工具从识别yescrypt哈希到破解zip压缩包的全过程。针对常见的'No password hashes loaded'报错,提供了两种解决方案,并扩展讲解了哈希识别、zip文件破解及性能优化技巧,是安全测试人员的实用指南。

weixin_29323365的博客 237

llmware-ai/llmware 项目解决方案指南

`llmware`是一个用于构建企业RAG(Retrieval-Augmented Generation)流程的统一框架,它使用小型的专门模型,这些模型可以被私有部署,与企业知识源安全地集成,并可以针对各种业务流程进行高效调整和适配。该项目支持使用小而专业的模型构建基于LLM(大型语言模型)的应用程序,如基于事实的问题回答、分类、总结和提取等关键任务。 ### 主要编程语言 `llmware`项...

gitblog_00862的博客 783

ChatGPT Plus完整开通指南:从账号注册到稳定使用全流程

自然语言处理(NLP)技术通过深度学习模型实现对人类语言的理解与生成,其核心原理是基于Transformer架构的大规模预训练。GPT-4作为当前最先进的生成式AI模型,在代码编写、文档分析等场景展现出显著的技术价值。在实际应用中,稳定的网络环境和合规的支付方式是确保AI助手持续服务的关键因素。针对ChatGPT Plus的开通,需要系统性地解决账号验证、虚拟信用卡支付等工程实践问题,才能实现工作流的高效整合。

weixin_34239592的博客 431

LLMWare: 构建企业级RAG应用的统一框架

总的来说,LLMWare为企业提供了一个全面、灵活且易于使用的框架,用于构建基于小型专业化模型的RAG应用。模型目录(Model Catalog):提供统一的模型访问方式,支持150多个模型,包括50多个针对RAG优化的BLING、DRAGON和行业BERT模型。通过整合这两个组件,并集成领先的开源模型和底层技术,LLMWare为快速构建基于知识的企业LLM应用提供了一套全面的工具。这些新特性进一步扩展了LLMWare的应用场景,为企业用户提供了更多灵活和强大的工具来构建定制化的LLM应用。

m0_75126181的博客 871

从Transformer到Mamba:显著性检测领域的计算效率革命(Samba框架深度解析)

本文深入解析了Samba框架在显著性目标检测(Salient Object Detection)领域的创新应用,通过结合Mamba架构的优势,实现了计算效率的革命性提升。Samba框架采用显著性引导的Mamba模块(SGMB)和上下文感知上采样(CAU),有效解决了传统CNN和Transformer的局限性,同时在RGB-D等多模态任务中展现出卓越性能。

mmm90的博客 557

Python爬虫教程:抓取地方政府网站的公开文件与政策信息

Web爬虫是指一种自动化脚本,用于模拟人类浏览器访问网页、提取网页内容的数据抓取工具。发送请求到目标网页;获取网页内容;解析网页内容,提取所需数据;将数据保存或进一步处理。爬虫可以抓取各种形式的数据,如文本、图片、文件等。本教程将重点展示如何抓取地方政府网站上公开的政策文件、公告等信息。许多政府网站都会采取一定的反爬虫措施,防止大量数据被爬取。IP封锁:如果短时间内大量请求来自同一IP,可能会被封锁。验证码:一些网站会使用验证码来验证访问者是否为机器人。动态加载。

2201_76125261的博客 1981

llmware BLING模型家族:RAG优化的本地推理最佳实践

在企业级AI应用场景中,检索增强生成(Retrieval-Augmented Generation, RAG)已成为连接大语言模型与企业知识库的关键技术。然而,传统的云端大模型部署面临数据隐私、网络延迟和高昂成本等挑战。llmware BLING(Best Little Instruct-following Nifty Generative)模型家族正是为解决这些问题而生的本地化RAG优化解决方案...

gitblog_00685的博客 1056

【微服务】Spring AI Alibaba Jmus 从部署到项目实战详解

Spring AI Alibaba Jmus 从部署到项目实战详解

congge 4192

llmware快速入门:5分钟搭建本地RAG应用的新范式

还在为构建企业级RAG应用而头疼?需要GPU服务器才能运行大语言模型?llmware带来了革命性的解决方案——使用小型专业化模型,在普通笔记本电脑上5分钟搭建完整的RAG应用! ## ???? 读完本文你能得到什么 - **零配置快速启动**:无需复杂环境配置,pip安装即可使用 - **本地化部署**:完全在本地运行,无需GPU服务器 - **企业级功能**:支持多格式文档解析、向量检索、智能问...

gitblog_00298的博客 419

cadence中利用sva进行FPV实战(可直接使用)

在cadence中使用fpv进行formal验证

youzjuer的博客 749

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

llmware 如何调整 RAG 提示的采样参数以提高回答准确度

用 llmware 跑 RAG 时,同一个问题多次提问可能得到措辞或细节不同的回答;如果你希望本地模型的输出更稳定、更可核对,可以调整模型加载时的采样参数(`sample`、`temperature`、`get_logits`、`max_output`),并用 llmware 自带的 `analyze_sampling` 方法量化检查采样对 token 选择的影响。README 把这个任务称为 "

gitblog_00259的博客 381

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

本地RAG优化新标杆:llmware BLING模型家族完全指南

llmware是一个统一的框架,专为使用小型专业模型构建企业级RAG(检索增强生成)管道而设计。其中,BLING模型家族作为llmware的核心组成部分,以其高效的本地部署能力和出色的RAG优化表现,成为众多开发者在构建本地RAG应用时的理想选择。 [![llmware BLING模型家族](https://raw.gitcode.com/GitHub_Trending/ll/llmware/r

gitblog_00386的博客 483

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

使用llmware快速掌握RAG技术:从入门到实战

在当今人工智能领域,检索增强生成(Retrieval-Augmented Generation, RAG)技术正成为构建智能问答系统和知识密集型应用的核心方法。llmware项目为开发者提供了一套完整的工具链,使得RAG应用的开发变得简单高效。本文将带你快速上手llmware,通过9个精心设计的示例,逐步掌握RAG技术的核心组件和应用场景。 ## 环境准备 在开始之前,我们需要搭建开发环境: ...

gitblog_00183的博客 384

【亲测免费】 探索llmware:构建企业级RAG管道的利器

`llmware` 是一个专为企业级应用设计的统一框架,旨在帮助开发者构建基于大型语言模型(LLM)的应用程序,如检索增强生成(RAG)和代理(Agents)。通过集成小型、专业化的模型,`llmware` 能够在私有环境中安全、高效地部署,并与企业知识源无缝集成,从而实现成本效益的业务流程优化。 ## 项目技术分析 `llmware` 的核心技术架构包括两个主要组件: 1. **RAG管道...

gitblog_00614的博客 630

最完整指南:用llmware实现GGUF量化模型的本地化部署与高效推理

你是否还在为大模型部署时的硬件门槛发愁?是否想在普通笔记本上就能运行高性能的量化模型?本文将带你一步掌握llmware框架下GGUF(通用GPU/CPU量化格式)模型的高效部署与推理技术,让AI大模型在本地设备轻松落地。读完本文,你将能够:快速加载GGUF模型、优化推理性能、实现实时流式对话,并掌握常见问题的解决方案。 ## GGUF模型简介 GGUF(General GPU/CPU Quan...

gitblog_00185的博客 671

llmware:企业级RAG开发框架的全面解析

llmware是一个专为企业级RAG(检索增强生成)应用开发而设计的统一框架,通过整合小型专业化模型与完整的RAG流水线,为企业提供完整的私有化部署解决方案。该项目旨在解决企业在构建AI应用时面临的数据隐私、成本控制和部署复杂性等核心挑战,采用双核心架构设计,将模型能力与数据处理流程深度整合。 ## llmware项目概述与核心价值定位 llmware是一个专为企业级RAG(检索增强生成)应...

gitblog_00779的博客 486

LLMWare项目快速入门指南:6个示例掌握RAG核心技术

LLMWare是一个功能强大的开源工具库,专门为构建基于大语言模型(LLM)的应用程序而设计。本文将带您通过6个精心设计的示例,快速掌握检索增强生成(RAG)的核心技术栈。 ## 环境准备 在开始之前,请确保您的开发环境满足以下要求: **硬件要求**: - 操作系统:Mac M系列芯片、Windows或Linux(Ubuntu 20/22推荐) - 内存:至少16GB - 存储:建议预留1...

gitblog_01144的博客 326

llmware对比分析:与其他LLM框架的优劣势深度比较

在当今AI应用开发领域,选择合适的LLM(Large Language Model)框架已成为技术决策的关键环节。面对LangChain、LlamaIndex、Haystack等成熟框架,新兴的llmware以其独特的企业级RAG(Retrieval-Augmented Generation)解决方案脱颖而出。本文将深入分析llmware与其他主流框架的核心差异,帮助开发者做出明智的技术选型决策。...

gitblog_00648的博客 1085

llmware查询引擎深度:文本、语义、混合检索的实战技巧

在企业级RAG(Retrieval-Augmented Generation)应用中,检索质量直接决定了最终生成效果的好坏。传统的单一检索方式往往难以满足复杂业务场景的需求: - **文本检索**:擅长精确匹配关键词,但缺乏语义理解能力 - **语义检索**:能够理解查询意图,但对专业术语和精确匹配支持不足 - **混合检索**:结合两者优势,但实现复杂度高 llmware作为企业级LLM...

gitblog_00368的博客 877

llmware基准测试:RAG性能评估与优化指标详解

还在为选择合适的RAG模型而苦恼?面对众多小型语言模型,如何准确评估其在企业级应用中的表现?llmware提供的RAG基准测试框架,让你一键获取200个标准测试问题的性能数据,彻底解决模型选择难题! 读完本文,你将获得: - ✅ RAG基准测试的完整实现原理 - ✅ 性能评估指标的深度解析 - ✅ 模型筛选与优化的实战技巧 - ✅ 企业级应用的最佳实践指南 ## ???? RAG基准测试框架概...

gitblog_00514的博客 1090

革命性企业AI框架llmware:一站式解决RAG与小型模型部署难题

还在为构建企业级AI应用而头疼吗?面对RAG(检索增强生成)系统复杂、大模型部署成本高、数据安全风险大等痛点,企业AI落地之路充满挑战。llmware作为革命性的开源框架,提供了一站式解决方案,让企业AI开发变得前所未有的简单高效。 ## 读完本文你能获得 - ???? 掌握llmware核心架构与核心组件 - ???? 学会快速搭建企业级RAG系统 - ???? 了解50+小型专业化模型的应用场景 - ...

gitblog_00319的博客 1030
上一篇: python-pdfkit:HTML 转 PDF,几行代码的事
下一篇: jOOQ:用 Java 代码写 SQL,编译器帮你兜底
mofangcode820
博客等级 码龄156天 0粉丝 6原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值