


文章转载自:http://my.oschina.net/u/877348/blog/272066,感谢作者。
概述:
又到了一个总结提炼的阶段,这次想具体聊聊游戏引擎中使用的内存管理模块tcmalloc组件的使用心得。项目的前期曾经遇到过内存瓶颈,特别是windows系统下的客户端程序在经历长时间运行之后会出现内存占用率很高疑似泄漏的现象,排查了很久都没有找到原因,甚至一度无法定位问题出自游戏脚本层还是引擎层,后来在引擎中链接了tcmalloc组件,通过实时dump程序的内存信息最终找出了泄漏的元凶。tcmalloc的另一个优势就是通过高效率内存分配来提高游戏运行时性能,不得不说在使用tcmalloc之后,整个游戏的稳定性和效率都有了很大的提升。为了今后更有效和稳定地使用tcmalloc组件,就在这里深入剖析一下这个神器。Tcmalloc是Google Perftools中的一个组件,提供一整套高效健壮的内存管理方案,比传统glibc的内存分配和释放要快数倍;其次,基于tcmalloc之上的heapprofiler可以实时dump程序中heap的使用信息,是一个很好的检测内存泄漏的辅助工具;同时tcmalloc的使用又是极其方便,只需要在编译时增加一个链接选项,就可以无缝拦截(patch)原生操作系统运行库中的内存分配和释放接口,而无需修改已经完成的项目工程代码,大大减少移植整合的成本。
在windows平台下,tcmalloc可以通过静态库或者动态库(DLL)的形式嵌入到工程里面,这里将主要 分析tcmalloc如何DLL动态链接到工程里面,同时将重点剖析一下tcmalloc如何在不改变工程原有代码的前提下无缝地拦截windows原生内存管理接口。
配置步骤:
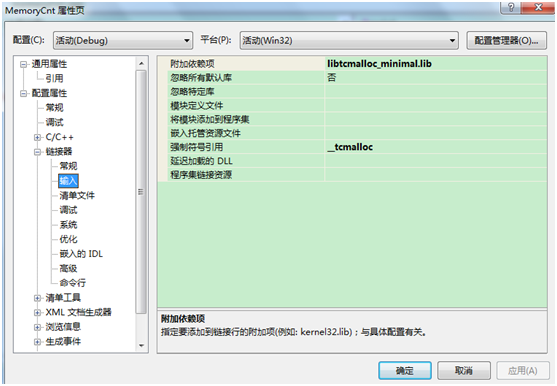
以DLL形式链接进入工程的主要步骤如下:首先从官网下载并解压gperftools包,下载地址为:http://code.google.com/p/gperftools/downloads/list,现有的版本是2.1;打开并编译gperftools-2.1目录下的gperftools.sln;编译通过后,在build输出目录下生成libtcmalloc_minimal.dll和对应的lib文件;将lib和dll文件拷贝到工程编译目录下,并在链接选项中添加两个配置,如下图所示:additional dependencies(附加依赖项): libtcmalloc_minimal.dll; force symbol references(强制符号引用):__tcmalloc (64bit 系统);重新编译链接后,exe运行时tcmalloc将在程序静态变量初始化阶段拦截所有原生内存管理接口。
无缝链接原理剖析:
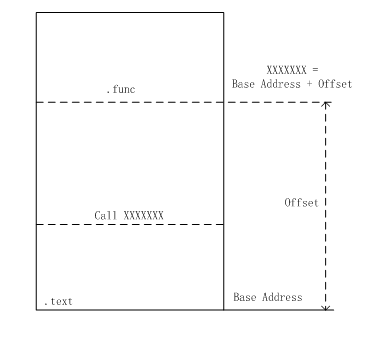
要理解tcmalloc如何无缝拦截底层运行库(runtime library)中的内存管理函数,首先需要理解windows平台下的可执行文件和 exe加载流程。windows平台下的可执行文件是以PE(Portable Executable)格式存在的,由各个不同的段组织而成,如.data .text .rsrc等,其中.text段包含了模块内所有代码的二进制输出,相应的函数调用是以
call XXXXXXXX
的汇编指令存在,其中XXXXXXXX表示程序运行时的函数虚拟地址。由于本模块PE文件各个段的布局和相应加载地址是在链接时决定,所以对于本模块内的函数调用可以在链接时就计算得到相应的函数地址,如下图所示,对某.text段中的.func函数进行调用,.func函数地址XXXXXXX可以通过将该段的加载地址和函数在段内的偏移两者相加得到:
对于隐式(implicit)链接的DLL模块,由于链接器无法在链接阶段得到DLL模块中各个段的布局和加载信息,所以无法直接计算得到具体函数地址。如果其他模块需要调用DLL内的函数,PE文件通过一种称为引用地址数据表(Import Address Table, IAT)的数据结构间接指向这些函数,在链接阶段链接器简单在IAT中写入各个函数的symbol,而相应的call指令也变成了如下形式:
CALL DWORD PTR [XXXXXXXX]
其中[XXXXXXXX]表示.func函数在IAT中相应slot的地址,如下图所示,XXXXXXXX值是由IAT表的加载地址和.func的slot index两者相加得到的:
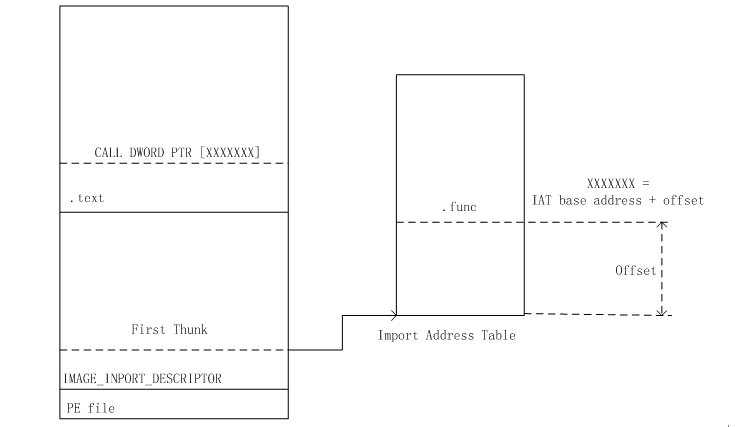
当这个可执行文件加载运行时,windows的程序加载器(Loader)负责解析这个PE文件格式,将文件中的各个数据段和代码段映射到进程的地址空间,同时通过遍历IMAGE_IMPORT_DESCRIPTOR 段,将所有隐式链接的DLL都加载到内存中,同时更新各个IAT中的slot,写入symbol所对应函数所在的内存地址,这样就保证了指令CALL DWORD PTR [XXXXXXXX]可以正确地调用到其他模块中的函数。
内存管理模块一般由操作系统底层运行库(runtime library)或第三方库提供,以动态或者静态的方式链接入可执行文件,拦截这些函数的方法一般有两种:
1)对需要拦截的内存管理函数,修改所有本地对其call指令的目的地址和IAT slot中可能引用到的间接函数地址,将它们指向新的替换函数地址,如下图A所示:
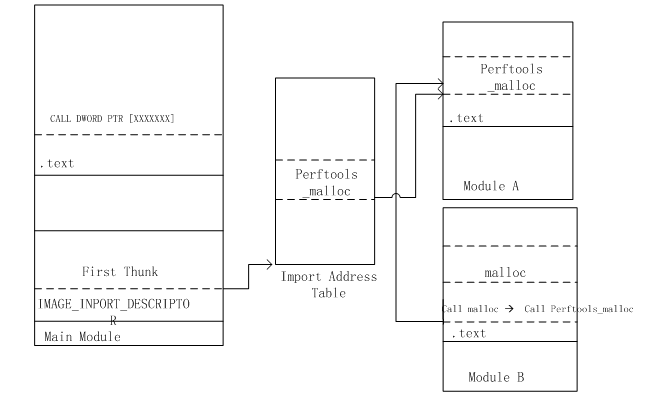
图A,main module是可执行文件,module B是底层运行库或者实现了内存管理的第三方库,module A是tcmalloc,tcmalloc需要拦截所有module的IAT表中原来调用module B中malloc的slot,同时还要拦截所有module B中本地调用malloc的call指令,将他们都拦截到tcmalloc中相应的替换函数。
2)直接修改需要拦截的内存管理函数实现,将函数空间的前几个bytes修改成一个跳转指令,跳转到新函数的地址空间,如下图B所示:

图B,tcmalloc保留所有module的IAT内容和本地call指令,只修改module B中malloc的实现,将最前面bytes修改成一个jmp指令,将程序的指令流跳转到tcmalloc中相应的提替换函数。
Google的tcmalloc组件正是以第二种方式无缝拦截了内存管理函数,修改原有目标函数的前kRequiredTargetPatchBytes(5)字节,将程序强制跳转到tcmalloc自己的内存管理函数。当然tcmalloc更为周到地考虑了以下几点:
-
tcmalloc接管了底层运行库和第三方库中的整套内存管理方案,拦截了各模块中所有的内存管理函数:malloc, free, realloc, calloc, new, newArray, delete, deleteArray, newNothrow, newArrayNothrow, kDeleteNothrow, deleteArrayNothrow, msize, expand, callocCrt
-
准确区分程序运行时各个内存空间的分配者,严格遵循由谁分配则由谁负责释放的原则,程序在tcmalloc拦截前申请分配的内存空间由原始内存释放函数进行释放,在tcmalloc拦截后申请分配的内存空间由tcmalloc的内存释放函数进行释放,保证整个程序运行正确性和最终dump信息的准确性;
-
保证每个内存管理函数只会被拦截一次,对某些DLL中export forwarding的内存管理函数,tcmalloc会遍历整个export链找到最终的实现函数进行拦截;
-
对于显示(explict)链接的DLL库,tcmalloc通过拦截loadLibrary, LoadLibraryExW, FreeLibrary等module操作函数来做到拦截这些模块中的内存管理函数
-
tcmalloc考虑了unpatch的过程,上层程序可以通过适当的操作,恢复到原始运行库提供的内存管理方案,所以tcmalloc实现中不仅要修改目标函数的内容,还需要将被修改前的内容进行保存,在适当的时候进行还原。
单一函数拦截流程:
下面从tcmalloc如何拦截单个内存管理函数开始介绍,文件preamble_patcher_with_stub.cc中的函数
|
1
|
SideStepError PreamblePatcher::RawPatchWithStub(
void
* target_function,
void
* replacement_function, unsigned
char
* preamble_stub, unsigned
long
stub_size, unsigned
long
* bytes_needed)
|
实现了对单个函数的拦截逻辑,整个流程中涉及了三个至关重要的变量,他们指向的三个地址空间,理解这三个地址空间含义也就理解了tcmalloc的整个拦截流程:
-
target_function:需要被拦截的目标函数地址,譬如运行库的malloc函数地址;
-
replacement_function:tcmalloc中用来替换被拦截函数的新函数地址,譬如tcmalloc中的Perftools_malloc函数就是拦截运行库malloc函数后的替换函数;
-
preamble_stub:用来存放目标函数起始几个bytes内容的空间,这个空间是tcmalloc通过函数AllocPageNear额外申请的,具体有两个作用将下面介绍;
这个三个变量对应函数的前三个参数,函数的后两个参数相对比较简单:
stub_size:表示preamble_stub内存块的总大小;
bytes_needed:作为返回值,传递给函数的调用者该拦截过程实际占用preamble_stub的字节数。
拦截流程具体如下:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
|
while
(读取目标函数的内容偏移量(preamble_bytes)小于kRequiredTargetPatchBytes) {
// 反汇编得到相应的指令类型
InstructionType instruction_type =
disassembler.Disassemble(target + preamble_bytes, cur_bytes);
if
(IT_JUMP == instruction_type) {
// 如果是跳转指令
1) 将指令类型字节码拷贝到preamble_stub
2) 重新计算该指令相对跳转偏移original_jump_dest - stub_jump_from,并拷贝到preamble_stub,保证该迁移后的指令在执行时能够正确跳转到原来指令应该跳转到的目的地址,如果原目的地址在需要迁移kRequiredTargetPatchBytes的字节内,则还需要再一次重新计算相对跳转偏移到新的目的地址。
}
else
if
(IT_GENERIC == instruction_type) {
if
(IsMovWithDisplacement(target + preamble_bytes, cur_bytes)) {
// 如果是mov displace指令
1) 将指令类型字节码拷贝到preamble_stub
2) 重新计算mov的目的地址,逻辑与上面处理跳转指令类似
}
else
{
// 其他普通指令
1)将整个指令简单copy到preamble_stub
}
}
// 将读取目标函数内容的指针向后偏移刚刚copy的指令字节数
preamble_bytes += cur_bytes;
}
if
(NULL != bytes_needed)
// 计算preamble_stub会被占用的字节数
*bytes_needed = stub_bytes + kRequiredStubJumpBytes
+ required_trampoline_bytes;
// Now, make a jmp instruction to the rest of the target function (minus the
// preamble bytes we moved into the stub) and copy it into our preamble-stub.
// find address to jump to, relative to next address after jmp instruction (注释很清晰,不多解释)
int
relative_offset_to_target_rest
= ((
reinterpret_cast
<unsigned
char
*>(target) + preamble_bytes) -
(preamble_stub + stub_bytes + kRequiredStubJumpBytes));
// jmp (Jump near, relative, displacement relative to next instruction)
//在preamble_stub的最后添加一条特殊jmp指令ASM_JMP32REL,其目的是保证上面所提到的2,5需求能正确实现,当程序需要调用原来target_function时,在执行preamble_stub最前几个bytes指令后能够成功跳转到原来target_function空间在kRequiredStubJumpBytes后的指令序列继续执行
preamble_stub[stub_bytes] = ASM_JMP32REL;
// copy the address
memcpy
(
reinterpret_cast
<
void
*>(preamble_stub + stub_bytes + 1),
reinterpret_cast
<
void
*>(&relative_offset_to_target_rest), 4);
// Inv: preamble_stub points to assembly code that will execute the
// original function by first executing the first cbPreamble bytes of the
// preamble, then jumping to the rest of the function.
// Overwrite the first 5 bytes of the target function with a jump to our
// replacement function.
// (Jump near, relative, displacement relative to next instruction)
// 所有准备工作结束,万事俱备开始真正拦截,往目标函数的前kRequiredStubJumpBytes写入一个跳转指令,跳转到tcmalloc的替换函数
target[0] = ASM_JMP32REL;
// Find offset from instruction after jmp, to the replacement function.
// 计算tcmalloc替换函数的相对地址
int
offset_to_replacement_function =
reinterpret_cast
<unsigned
char
*>(replacement_function) -
reinterpret_cast
<unsigned
char
*>(target) - 5;
// complete the jmp instruction
memcpy
(
reinterpret_cast
<
void
*>(target + 1),
reinterpret_cast
<
void
*>(&offset_to_replacement_function), 4);
// 圆满完成
|
下图是拦截之后三个空间所包含的内容:

图中黄色部分表示tcmalloc所做的修改,preamble_stub最初的kRequiredStubJumpBytes字节内容是target_function最前面kRequiredStubJumpBytes字节内的指令经过相对地址重计算后的替代指令;kRequiredStubJumpBytes字节后面跟着一条JMP指令用来跳转到target_function中第(kRequiredStubJumpBytes + 1)byte地址空间;JMP指令后还跟着几条trampoline指令,用来处理preamble_stub和target_function的地址空间间隔超过4G的情况,这里不做过多介绍。target_function最前面kRequiredStubJumpBytes字节用一个JMP指令替代,跳转到tcmalloc的replacement_function的地址空间。从中可以看到preamble_stub的作用其实有两个:
-
当tcmalloc拦截原始的内存管理函数后,如果需要调用target_function函数,譬如释放tcmalloc拦截前已经分配的内存空间,则只需要call preamble_stub就可以实现。
-
当需要unpatch内存管理函数时,只需要对preamble_stub前kRequiredStubJumpBytes字节内的指令进行patch的逆操作,并拷贝回target_function的空间就可以了。
相关文件:
tcmalloc中主要有4个文件涉及到函数拦截逻辑,分别如下:
-
patch_functions.cc:无缝拦截所有DLL中的内存管理函数和windows kernel32模块内针对heap进行操作的函数。
-
preamble_patcher.cc:主要实现指令的反汇编逻辑,判断各指令类型和计算地址符在指令中的偏移;将RawPatchWithStub进行了包装,检查三个地址空间的有效性和准确性;针对module中的export forwarding情况进行处理,根据JMP指令找到真正的target_function实现函数 (ResolveTarget)。
-
preamble_patcher_with_stub.cc:主要实现了对单个函数的拦截功能(前面已经介绍)。
-
libc_override.h:tcmalloc中有关函数拦截的函数定义。
以下将主要介绍patch_functions.cc中如何对module进行拦截的流程。
相关数据结构:
在介绍流程之前,先简单介绍一下patch_functions.cc中主要涉及的几个重要数据结构:
LibcInfo:这个类与需要被拦截的module一一对应,该类通过成员函数patch对module中所有内存管理函数进行拦截,需要拦截的函数都定义在enum中:
|
1
2
3
4
5
6
7
8
9
10
|
enum
{
kMalloc, kFree, kRealloc, kCalloc,
kNew, kNewArray, kDelete, kDeleteArray,
kNewNothrow, kNewArrayNothrow, kDeleteNothrow, kDeleteArrayNothrow,
// These are windows-only functions from malloc.h
k_Msize, k_Expand,
// A MS CRT "internal" function, implemented using _calloc_impl
k_CallocCrt,
kNumFunctions
};
|
这个类还有有三个重要的数据成员:
-
function_name_:记录了所有需要被拦截的函数名,可以通过调用windows函数GetProcAddress得到需要被拦截的函数地址;
-
static_fn_:用于静态链接的库,动态链接时不会用到,在这里不做介绍;
-
windows_fn_: 需要被拦截的函数地址,即前面提到的target_function,这个成员变量是在函数PopulateWindowsFn内进行赋值的,该函数通过遍历function_name_找到module中所有需要拦截的函数地址,并通过调用PreamblePatcher::ResolveTarget()函数遍历module的export forwarding链找到真正的target_function实现。
LibcInfoWithPatchFunctions:该类继承自LibcInfo,通过Template来具体对应一个需要被拦截的module,由于每个module都可能有自己的内存管理函数和需要拦截的替换函数,tcmalloc通过显示的定义一堆
|
1
2
3
4
5
|
static
LibcInfoWithPatchFunctions<0> main_executable;
static
LibcInfoWithPatchFunctions<1> libc1;
static
LibcInfoWithPatchFunctions<2> libc2;
static
LibcInfoWithPatchFunctions<3> libc3;
...
|
来表示各个加载到内存的module。该类有两个重要的数据成员:
-
origstub_fn_:保存了拦截后target_function的调用地址,即上面提到的各个被拦截函数相对应的preamble_stub地址。
-
perftools_fn_:保存了tcmalloc的替换函数,如下所示:
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
|
static
void
* Perftools_malloc(
size_t
size) __THROW;
static
void
Perftools_free(
void
* ptr) __THROW;
static
void
* Perftools_realloc(
void
* ptr,
size_t
size) __THROW;
static
void
* Perftools_calloc(
size_t
nmemb,
size_t
size) __THROW;
static
void
* Perftools_new(
size_t
size);
static
void
* Perftools_newarray(
size_t
size);
static
void
Perftools_delete(
void
*ptr);
static
void
Perftools_deletearray(
void
*ptr);
static
void
* Perftools_new_nothrow(
size_t
size,
const
std::nothrow_t&) __THROW;
static
void
* Perftools_newarray_nothrow(
size_t
size,
const
std::nothrow_t&) __THROW;
static
void
Perftools_delete_nothrow(
void
*ptr,
const
std::nothrow_t&) __THROW;
static
void
Perftools_deletearray_nothrow(
void
*ptr,
const
std::nothrow_t&) __THROW;
static
size_t
Perftools__msize(
void
*ptr) __THROW;
static
void
* Perftools__expand(
void
*ptr,
size_t
size) __THROW;
|
WindowsInfo:该类与LibcInfo十分相似,但它主要负责拦截windows kernel32中针对heap进行操作的函数,需要拦截的函数都定义在enum中:
|
1
2
3
4
5
|
enum
{
kHeapAlloc, kHeapFree, kVirtualAllocEx, kVirtualFreeEx,
kMapViewOfFileEx, kUnmapViewOfFile, kLoadLibraryExW, kFreeLibrary,
kNumFunctions
};
|
下来的代码定义了与其相对应的tcmalloc替换函数:
|
1
2
3
4
5
6
7
8
9
|
WindowsInfo::FunctionInfo WindowsInfo::function_info_[] = {
{
"HeapAlloc"
, NULL, NULL, (GenericFnPtr)&Perftools_HeapAlloc },
{
"HeapFree"
, NULL, NULL, (GenericFnPtr)&Perftools_HeapFree },
{
"VirtualAllocEx"
, NULL, NULL, (GenericFnPtr)&Perftools_VirtualAllocEx },
{
"VirtualFreeEx"
, NULL, NULL, (GenericFnPtr)&Perftools_VirtualFreeEx },
{
"MapViewOfFileEx"
, NULL, NULL, (GenericFnPtr)&Perftools_MapViewOfFileEx },
{
"UnmapViewOfFile"
, NULL, NULL, (GenericFnPtr)&Perftools_UnmapViewOfFile },
{
"LoadLibraryExW"
, NULL, NULL, (GenericFnPtr)&Perftools_LoadLibraryExW },
{
"FreeLibrary"
, NULL, NULL, (GenericFnPtr)&Perftools_FreeLibrary },
|
tcmalloc拦截这些windows api并不是为了接管windows自身的heap操作逻辑,而是为了对内存操作进行计数。每个替换函数里面都简单调用了origstub_fn所指向的原有windows api实现,只是在每个api调用前后增加一些计数hook。因为kernel32只会被加载一次,所以WindowsInfo在tcmalloc中也是以单例形式存在的。
ModuleEntryCopy:该类保存每个module被加载到内存后的加载信息,包括该module的加载地址和module的大小;在LibcInfo被PopulateWindowsFn前,该类还负责保存module中需要被拦截函数的函数地址。
拦截流程:
tcmalloc究竟是在何时对函数进行了拦截?一切还得从文章最开始所提到的两个配置讲起,使用tcmalloc时只需要在程序中添加两项配置:additional dependencies: libtcmalloc_minimal.dll; force symbol references:__tcmalloc; 其中第一项是配置任何DLL都所必需的步骤,而第二个选项是由于在实际工程里面不会显式调用tcmalloc模块内的函数,而导致编译器在编译优化阶段忽略整个tcmalloc模块,所以需要强制引入一个该模块内的符号,即__tcmalloc,告诉编译器tcmalloc是工程所依赖的模块,对于32位的系统只需要强制引入符号_tcmalloc即可。其实__tcmalloc在tcmalloc里面只是一个空函数,不起任何作用,那么哪里才是tcmalloc拦截的真正入口?那得从另一个类TCMallocGuard说起,在文件Tcmalloc.cc中定义了一个TCMallocGuard的静态对象module_enter_exit_hook
|
1
2
3
4
5
6
7
8
|
TCMallocGuard::TCMallocGuard() {
if
(tcmallocguard_refcount++ == 0) {
....
ReplaceSystemAlloc();
// defined in libc_override_*.h
tc_free(tc_malloc(1));
......
}
}
|
看到函数调用ReplaceSystemAlloc()时,谜底已经揭晓,这正是tcmalloc拦截内存管理函数的入口,所有的无缝操作都是从这里开始,在程序初始化静态变量module_enter_exit_hook之后,在正式跳转到main函数之前。
下面是tcmalloc拦截一个函数时的调用堆栈:
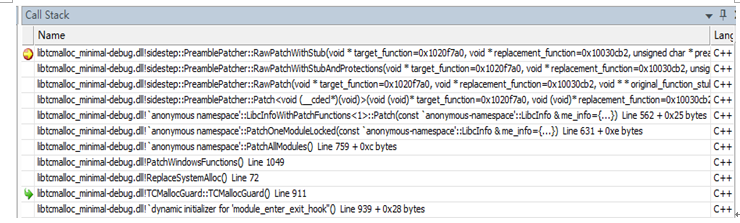
其中函数PatchAllModules会调用windows 函数EnumProcessModules遍历已经加载到内存的所有module,并且重复调用RawPatchWithStub对每个内存管理函数进行拦截。
最后还需要指出的一点是tcmalloc还拦截了windows的LoadLibrary函数,当每次有新的module显式加载到程序时,都会调用PatchAllModules函数,对新加入的module内可能存在的内存管理函数进行拦截。

 400


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


