Kafka的基本概念和Dokcer中部署Kafka

Docker 部署 Kafka 集群详解教程 Kafka 是一个分布式流处理平台,广泛用于构建实时数据管道和流应用。它能够处理高吞吐量的数据,并支持实时数据的发布和订阅。在本文中,我们将详细介绍如何使用 Docker 来部署 Kafka 集群,包括 Kafka 的选举原理。 阅读详情

Kafka是消息队列的一种实现,类似的还有RocketMQ 和 RabbitMQ

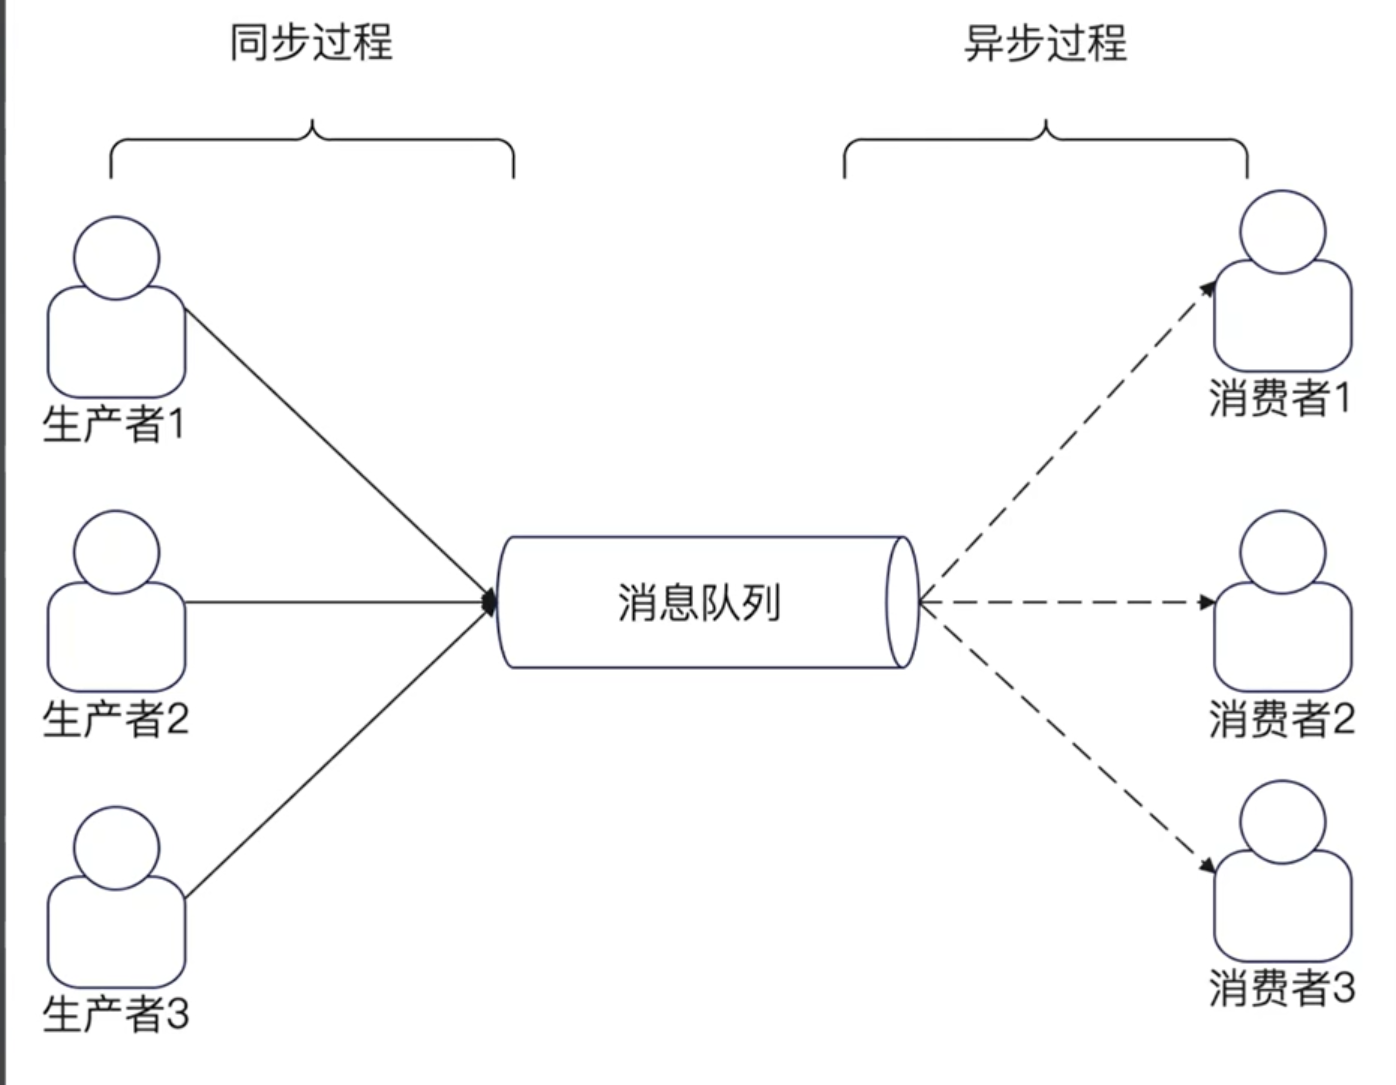
消息队列的基本形态,就是有N个生产者,N个消费者
在这里插入图片描述

这种形态下,生产者和消费者就解耦了

Kafka中的基本概念

  • 生产者 producer
  • 消费者 consumer
  • broker 可以理解为消息服务器
  • topic与分区(partition)
  • 消费者组和消费者

Broker

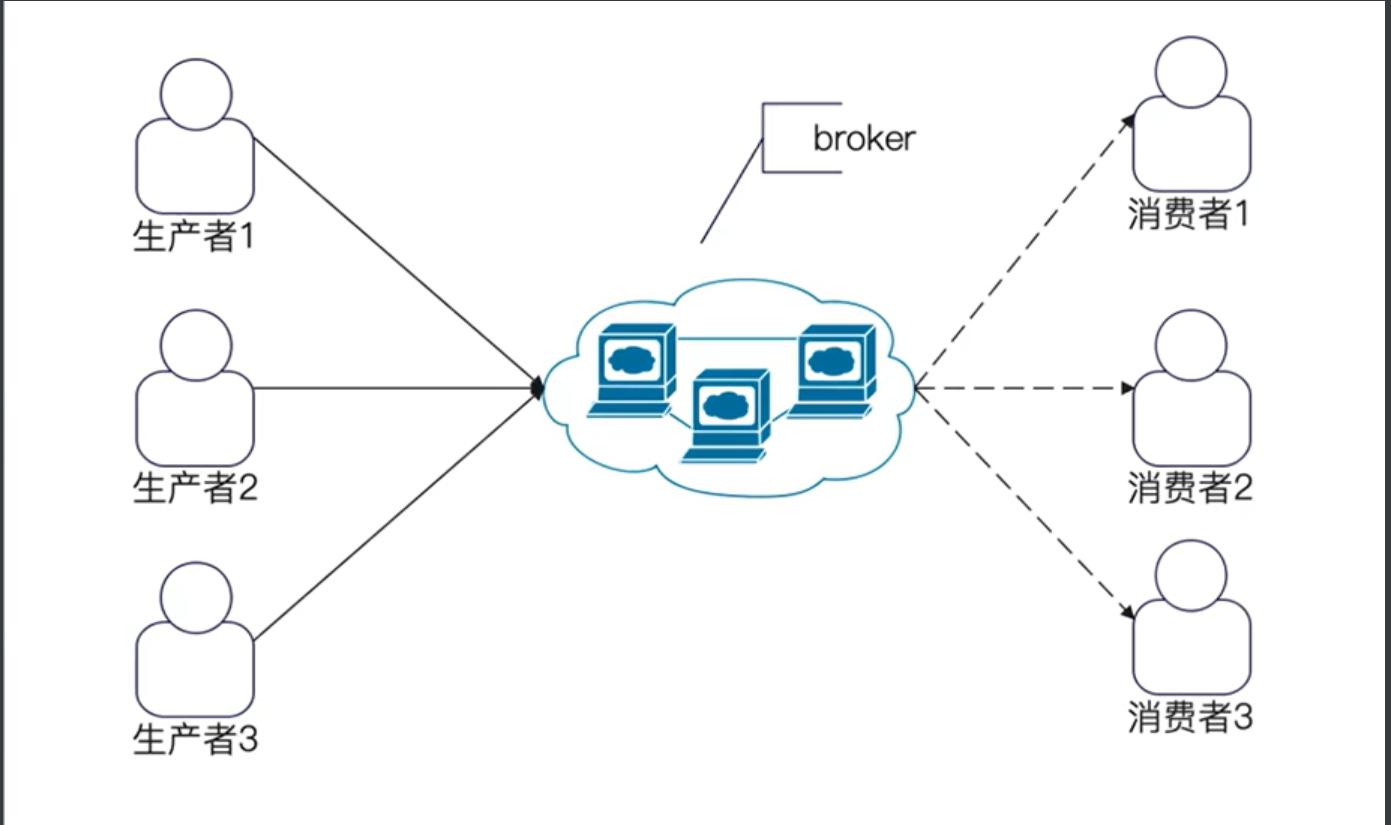
Broker 的意思是“中间人”,是一个逻辑上的概念。

在实际中,一个broker就是一个消息队列进程,也可以认为一个broker就是一台机器。
外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

topic 和 分区

Topic 是消息队列上代表不同业务的东西

简单来说,一个业务场景就是一个topic。

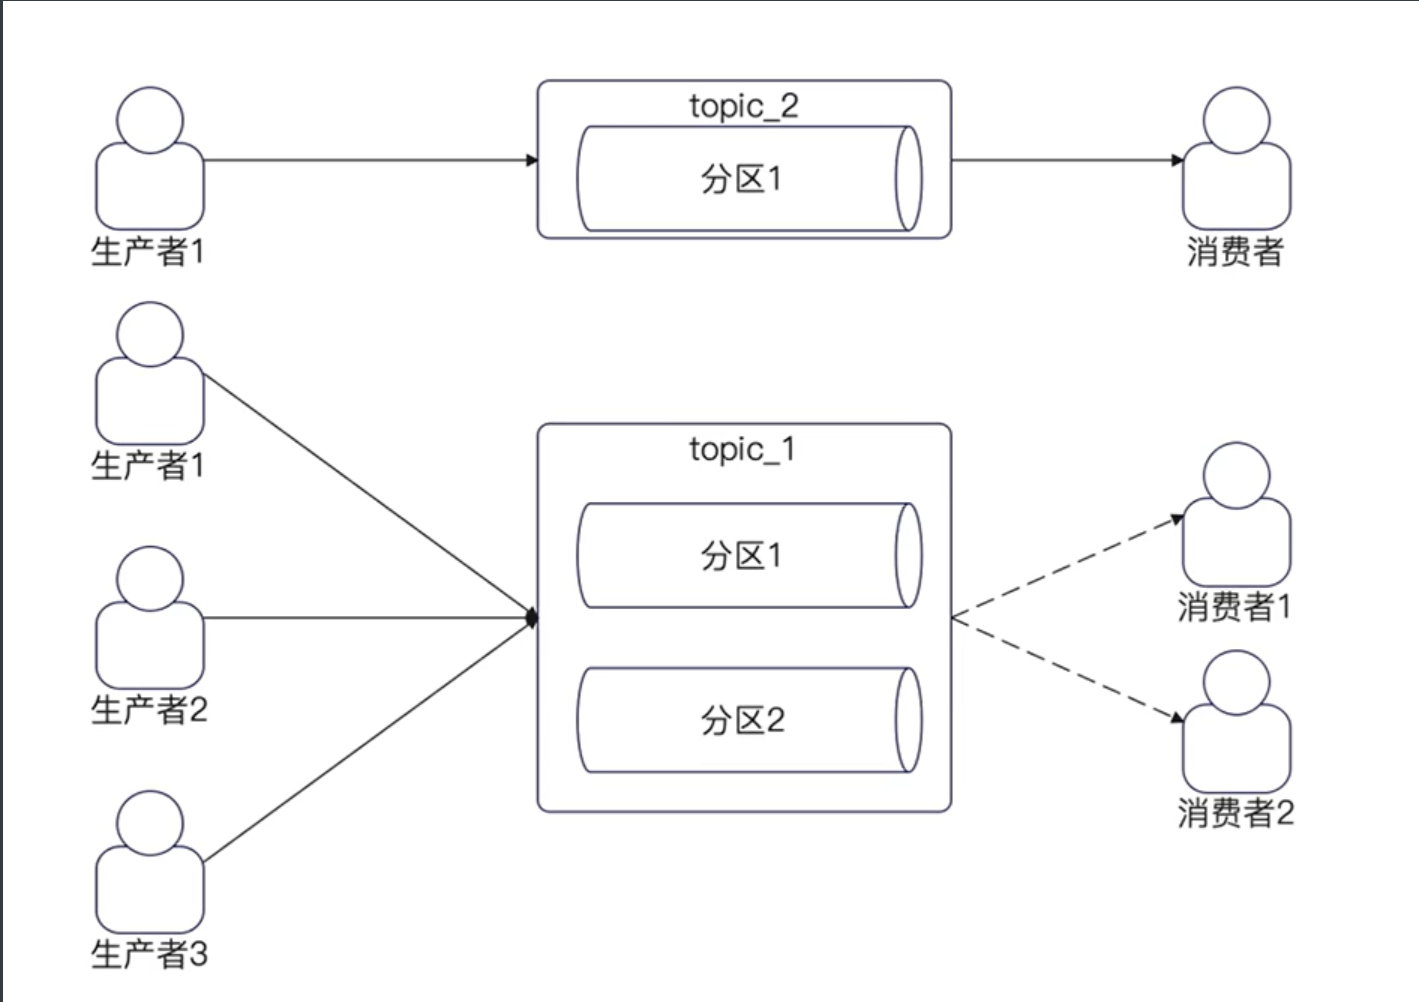
而一个topic有多个分区。

需要多少分区:max(发送者总速率/单一分区写入速率,发送者总速率/单一消费者速率)+buffer

下图中topic1有两个分区,而topic2有一个分区
在这里插入图片描述

主分区和从分区

实际上,我们说某个topic有多少个分区的时候,指的是有多少个主分区。

但是事实上,Kafka为了保证高可用和数据不丢失,分区有主分区和从分区。

当发送消息到Kafka上的时候,Kafka会把消息写入主分区之后,再同步到从分区。

如下图所示,每一个分区实际上是一主两从(不是固定的规则)的结构。
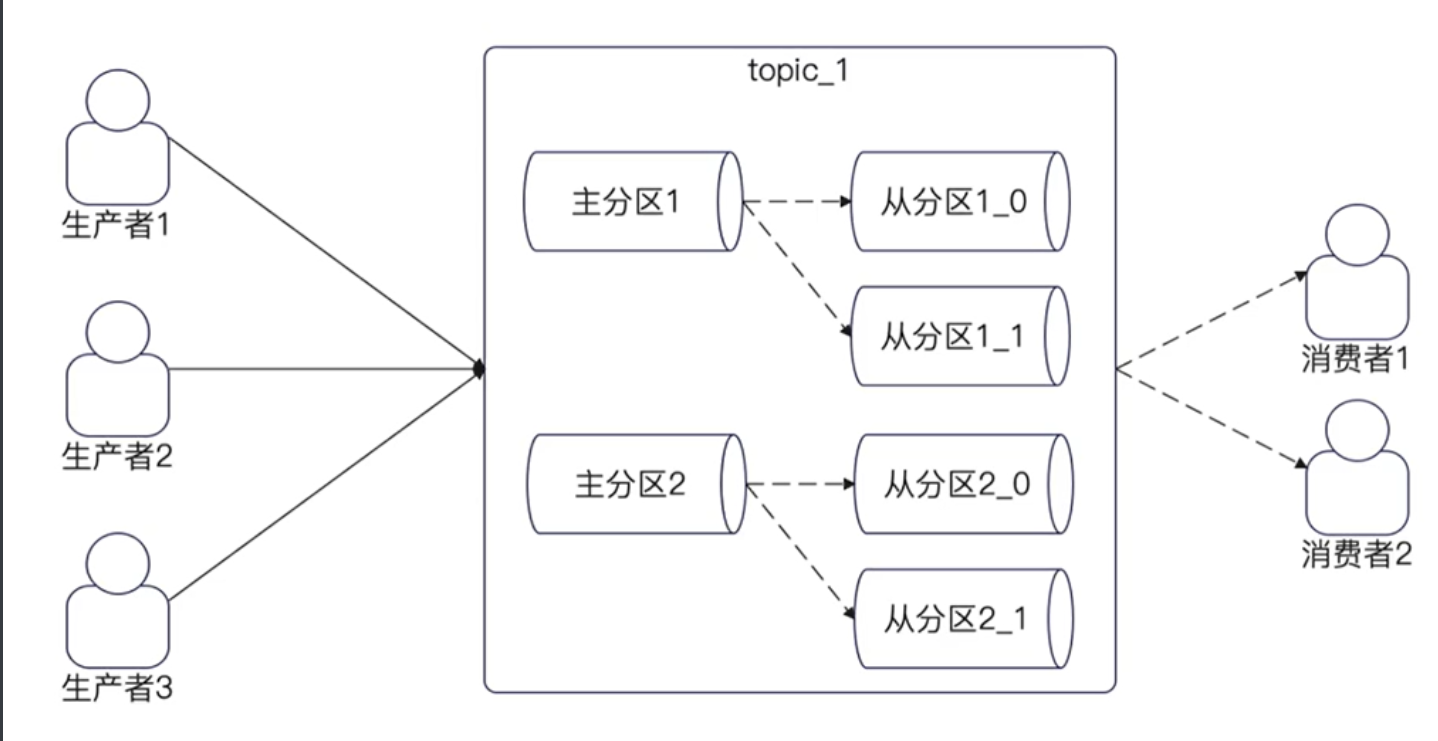
在这里插入图片描述

分区和broker的关系

正常情况下,同一个topic的分区会尽量均匀分散到所有的broker上。

这意味着两件事:

  • 主分区之间,不会在同一个broker上。
  • 同一个分区的主分区和从分区,也不会在同一个broker上。

核心目标:保证当某个broker崩溃的时候,对业务的影响最小,满足上面两个要求的话,某一个broker崩溃,最多导致topic的某一个主分区不可用,不至于完全不可用。
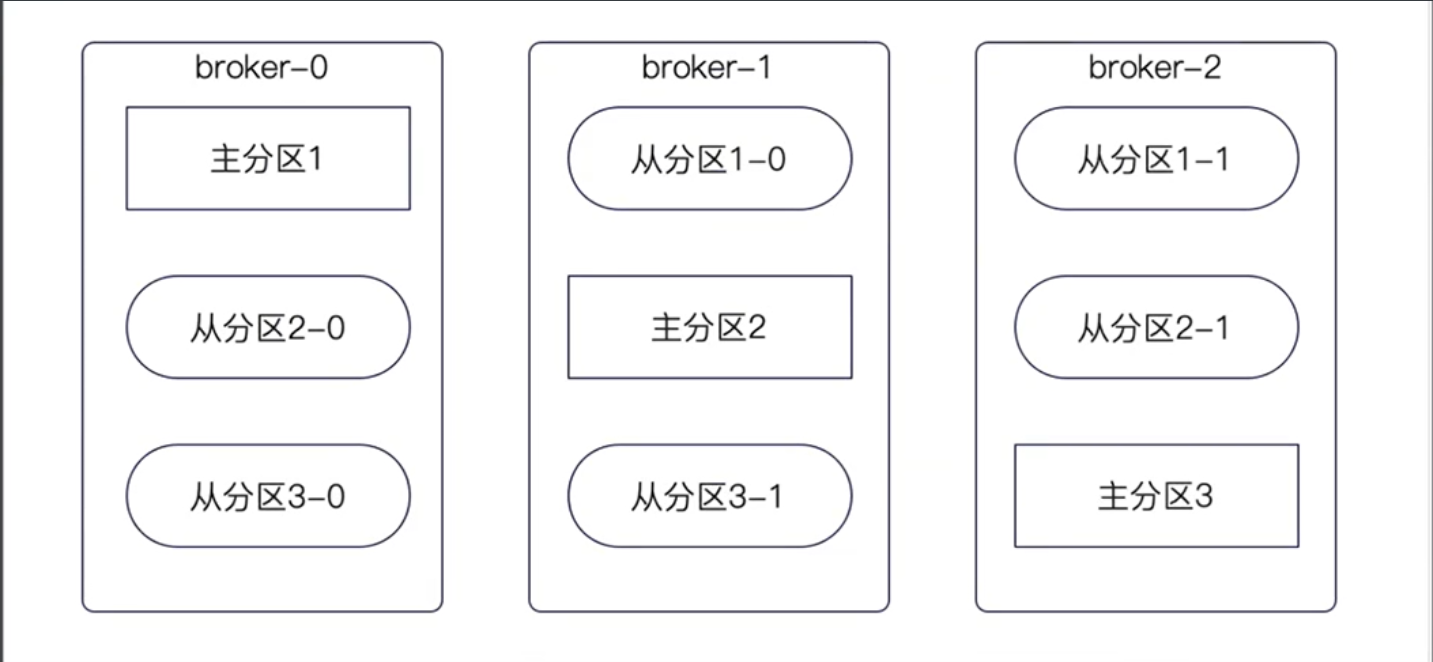
在这里插入图片描述

分区和生产者的关系

正常情况下吗,一个topic 都会有多个分区,所以发送者在发送消息的时候,就需要选择一个目标分区。

比较常用的有三种:

  • 轮询:一个分区发送一次,挨个轮流。
  • 随机:随机挑选一个。
  • 哈希:根据消息中的key来筛选一个目标分区。

遵循QPS均匀比较好

也可以自己设计一些比较复杂的路由策略,用在面试中效果会比较好。
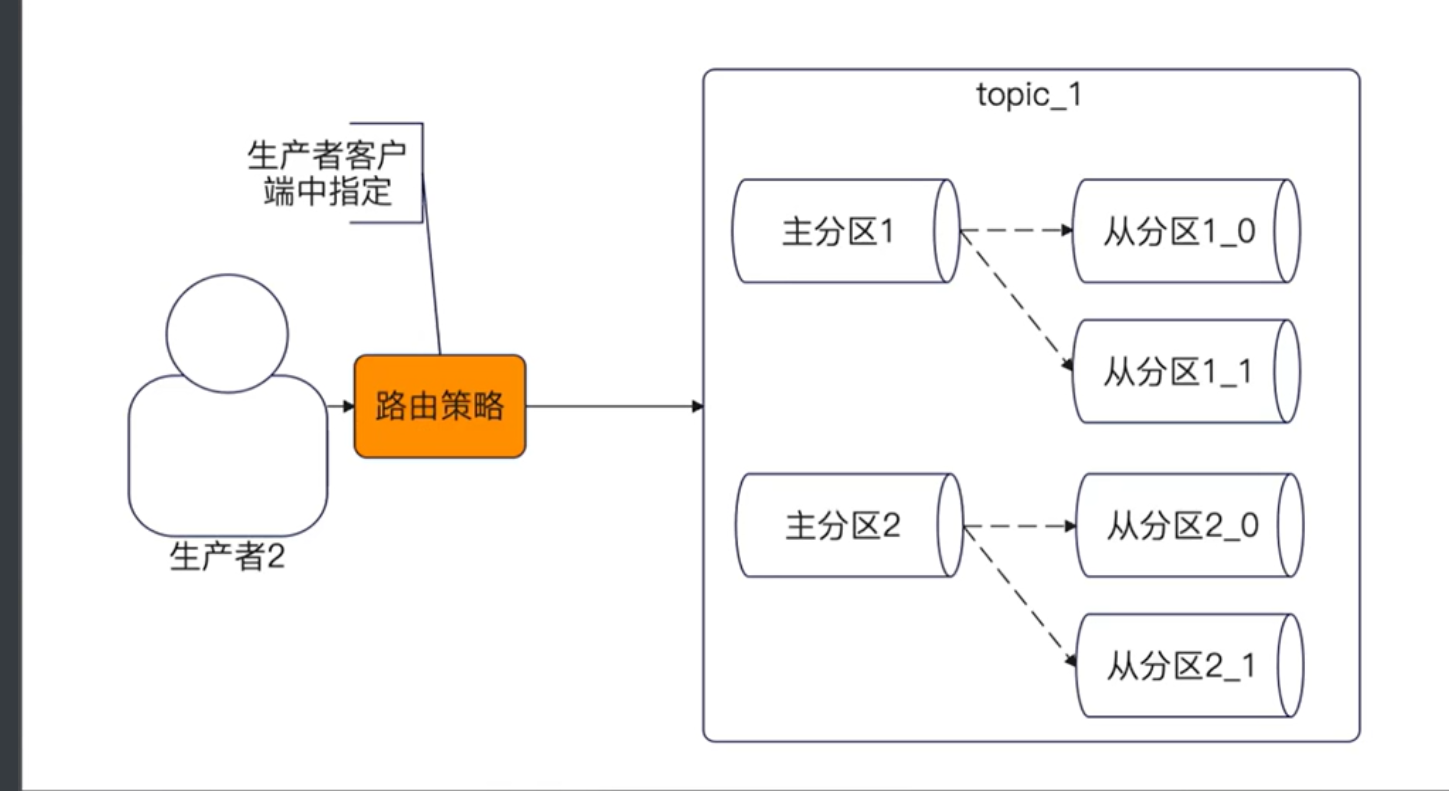
在这里插入图片描述

分区和消息有序性

Kafka中的消息有序性保证是以分区为单位的。

也就是说,一个分区内的消息是有序的。即,消息在一个分区内的顺序,就是分区的消息被消费的顺序。

因此,如果要做到全局有序,就只能有一个分区。

如果要做到业务有序,就需要保证业务的消息都丢到同一个分区里面。

下图是一个不同分区上的消息失序的例子。生产者发送msgA和msgB,但是消费者的消费顺序是msgB,msgA。
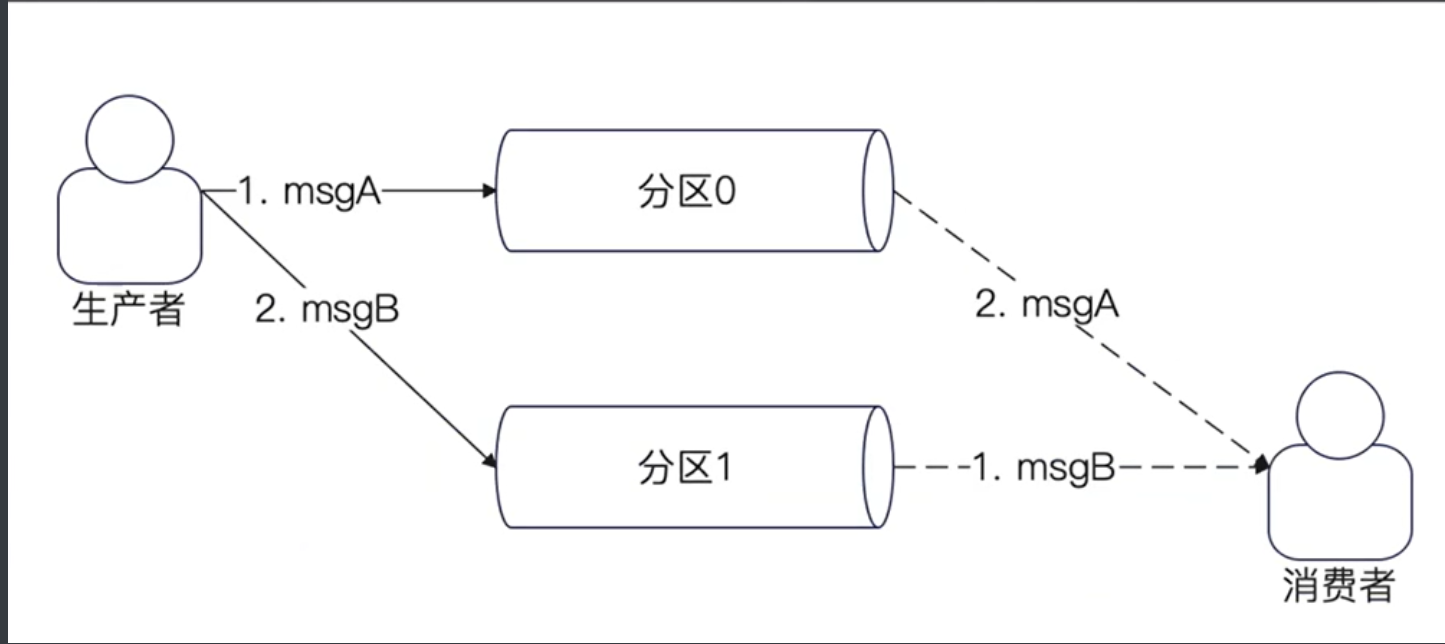
在这里插入图片描述

分区和消费者组,消费者的关系

在Kafka中,消费者都是归属于某一个消费者组的。

**一个消费者组可以看作是关心这个topic的一个业务方。**比如说在创建用户的时候,搜素关心新用户,推荐也关心新用户,那么搜索自己是一个消费者组,推荐也是一个消费者组。

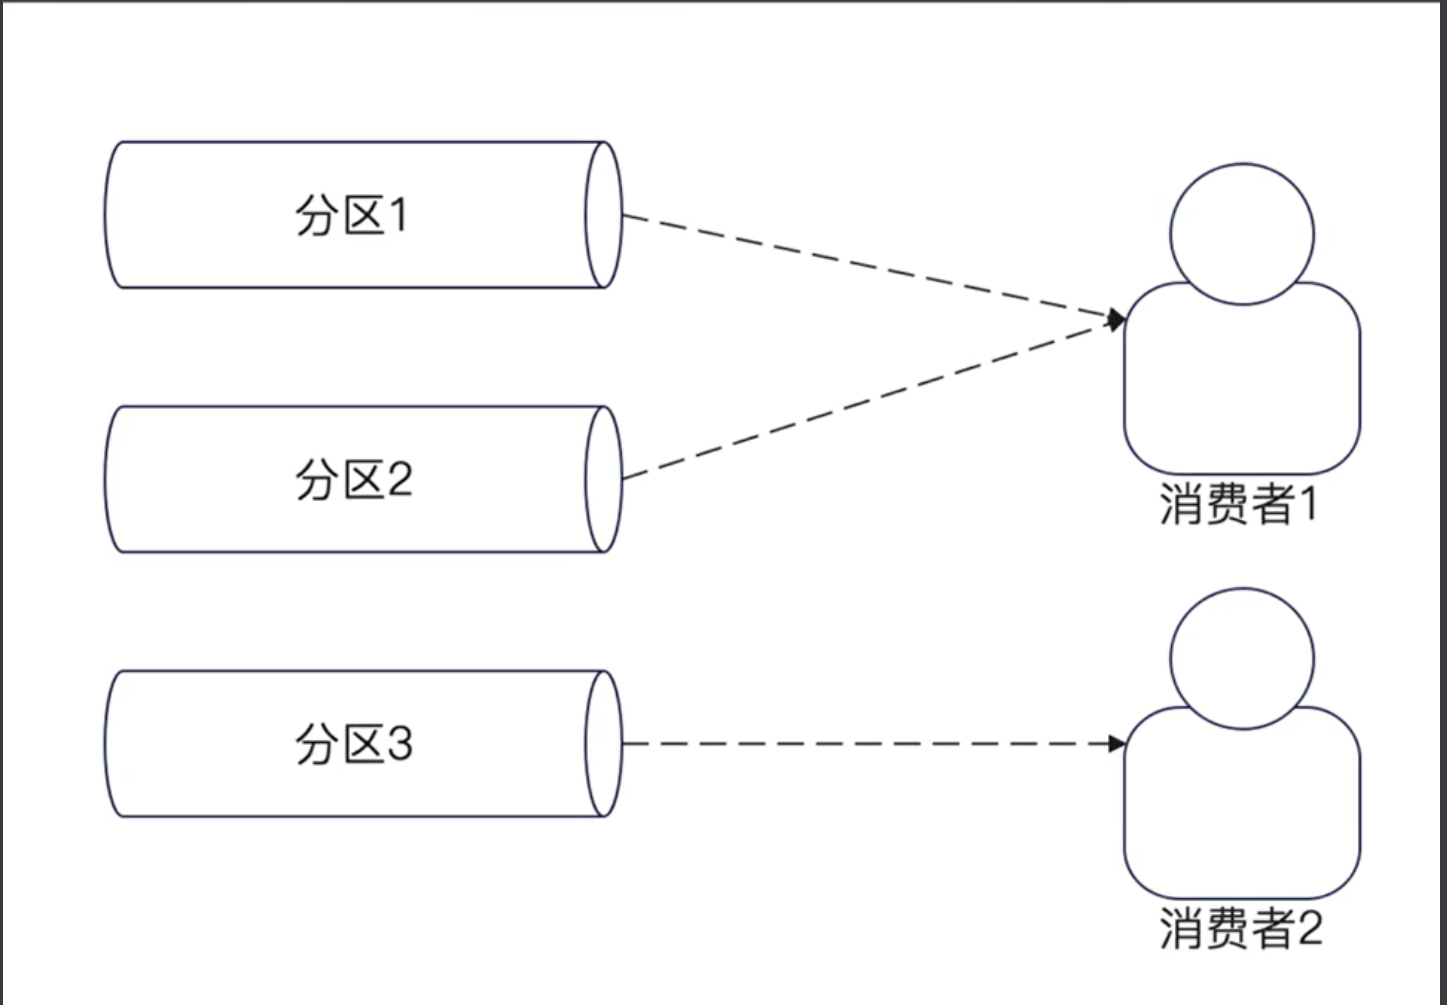
**同一个消费者组里面,一个分区最多只有一个消费者。**也就是在同一个消费者组里面:

  • 一个消费者可以消费多个分区的数据。
  • 一个分区在同一时刻,只可能被一个消费者消费。

在这里插入图片描述

最多一个消费者的内涵

一个分区最多一个消费者!!!

下图中的分区2被两个消费者消费,这种是不允许的。
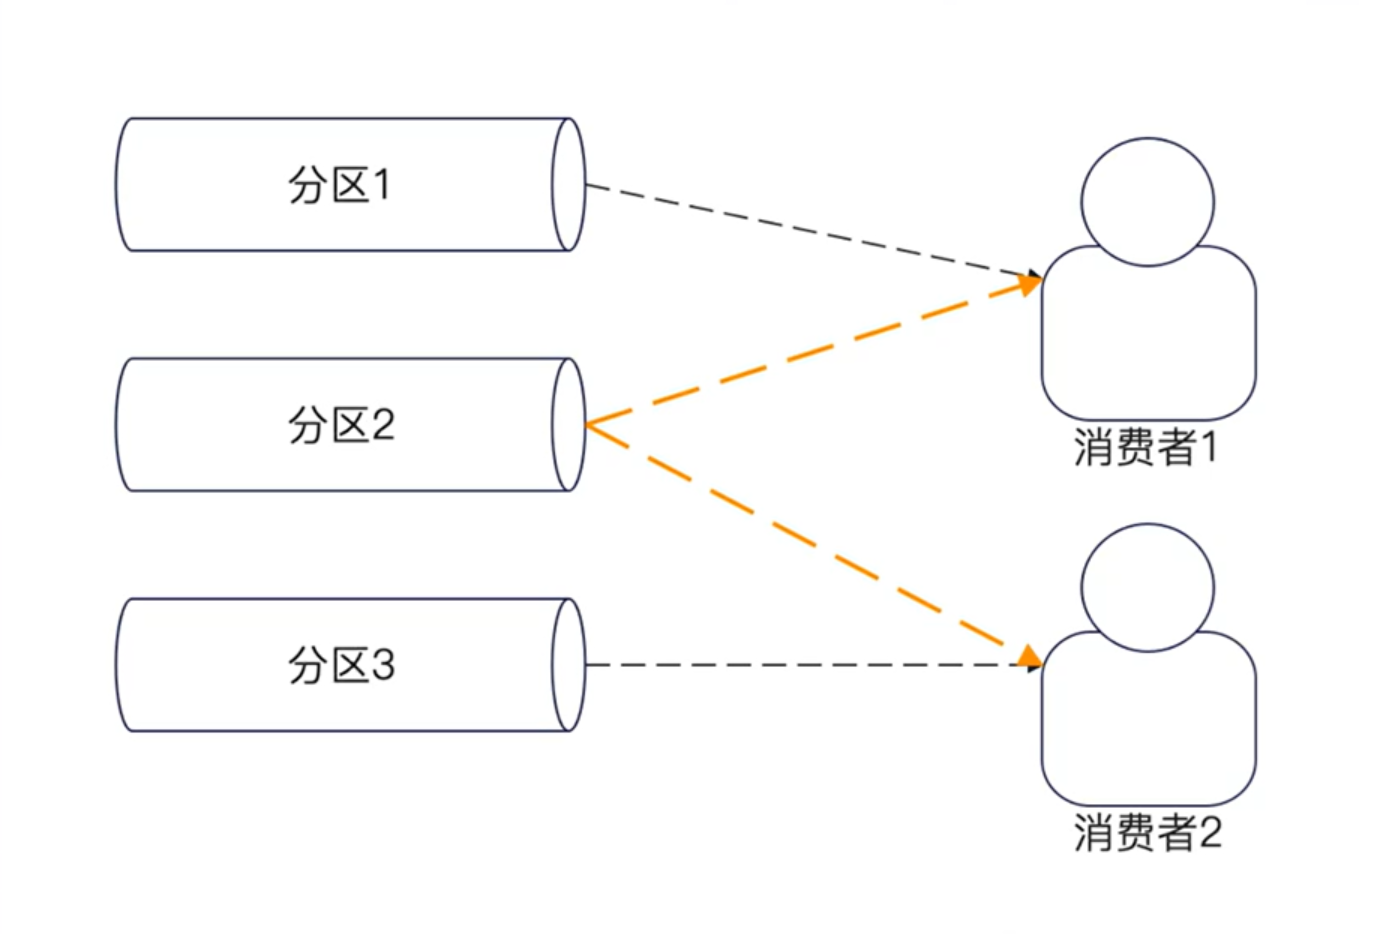
在这里插入图片描述

由此衍生出来:

  • 如果一个topic有N个分区,那么同一个消费者组最多有N个消费者。多于这个数字的消费者会被忽略。

  • 如果消费者性能很差,那么并不能通过无限增加消费者来提高消费速率。

这就是典型的面试热点:消息积压问题。

面试题:消息积压问题

消息积压问题(Message Backlog / Message Queue Backlog)是指消息系统(如 Kafka、RabbitMQ、RocketMQ 等)中的消息生产速度大于消费速度,导致未被及时处理的消息不断堆积,形成队列积压。


一、具体表现
  • 消息队列的未消费消息数量持续上升。
  • 消费者处理延迟增加,甚至发生超时或阻塞。
  • 系统下游(如数据库、缓存)负载飙升,进一步加剧问题。

二、常见原因
  1. 消费者处理能力不足
    • 单个消费者处理速度慢(CPU、IO瓶颈等)。
    • 消费者数量不足,未充分利用并行处理能力。
  2. 消费逻辑复杂或存在性能问题

    • 业务逻辑太重,如耗时操作、远程调用、数据库慢查询等。
    • 消费端存在阻塞、锁竞争、批处理效率低等问题。
  3. 系统异常或崩溃

    • 消费者崩溃未及时恢复。
    • 消息堆积后触发重试机制,造成雪崩效应。
  4. 消息生产突增

    • 突发业务高峰(如秒杀、双十一)。
    • 上游程序错误导致消息量异常增长。
  5. 消息队列配置不合理

    • 分区/主题配置不当,消费者未能均匀分担压力。
    • 消息堆积阈值设置过高,未能及时预警。

三、危害
  • 消息处理延迟,影响业务实时性(如用户通知、订单处理等)。
  • 可能导致系统雪崩,甚至消息丢失或重复消费。
  • 增加恢复难度,影响用户体验与系统稳定性。

四、解决思路
问题类型解决方案
消费能力不足增加消费者实例、优化消费逻辑、批量处理消息
消费慢引入异步处理、使用缓存、优化数据库操作
系统异常设置监控报警、自动拉起消费者、实现幂等重试机制
消息突增实现流量削峰(如削峰队列、限流器)、分布式消费
配置不合理合理设置分区数、消费组数、预警阈值

Docker 中如何部署Kafka

Kafka 早期版本(< 2.8) 需要依赖 Zookeeper 来管理元数据(如 topic、broker 信息),但从 Kafka 2.8 开始引入了 KRaft 模式(Kafka Raft Metadata Mode),也就是所谓的 “无 Zookeeper 模式”。

1.手动拉取镜像

docker pull bitnami/kafka:3.6.0

2.创建并启动Kafka

清爽版,下面有专门的注释

docker run -d \
  --name kafka \
  -p 9092:9092 \
  -p 9094:9094 \
  -e KAFKA_CFG_NODE_ID=0 \
  -e KAFKA_CFG_AUTO_CREATE_TOPICS_ENABLE=true \
  -e KAFKA_CFG_PROCESS_ROLES=controller,broker \
  -e KAFKA_CFG_LISTENERS=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093,EXTERNAL://0.0.0.0:9094 \
  -e KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://192.168.24.101:9092,EXTERNAL://192.168.24.101:9094 \
  -e KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,EXTERNAL:PLAINTEXT \
  -e KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=0@localhost:9093 \
  -e KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER \
  -v kafka-data:/bitnami/kafka \
  bitnami/kafka:3.6.0


docker run -d \
  --name kafka \
  #Kafka 内部使用的端口
  -p 9092:9092 \
  #Kafka 提供给宿主机或外部客户端访问的端口
  -p 9094:9094 \
  #Kafka 节点 ID,必须在集群中唯一,这里是 0 (单节点时设置成 0 即可)
  -e KAFKA_CFG_NODE_ID=0 \
  #是否允许自动创建 topic,开发测试建议开启;线上建议关闭(手动管理更安全)
  -e KAFKA_CFG_AUTO_CREATE_TOPICS_ENABLE=true \
  #设置本节点既充当 controller 又充当 broker(KRaft 模式支持分离角色,但单节点要全包)。
  -e KAFKA_CFG_PROCESS_ROLES=controller,broker \
  #定义 Kafka 要监听哪些协议/端口。
  #PLAINTEXT://0.0.0.0:9092:内部通信(集群内组件用)。
  #CONTROLLER://0.0.0.0:9093:用于 KRaft 元数据 controller 间通信。
  #EXTERNAL://0.0.0.0:9094:暴露给外部客户端使用。
  -e KAFKA_CFG_LISTENERS=PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093,EXTERNAL://0.0.0.0:9094 \
  #设置 Kafka 向客户端“宣传”的地址(外部怎么连)。
  #PLAINTEXT://192.168.24.101:9092:容器内其他服务连接时使用服务名 192.168.24.101
  #EXTERNAL://192.168.24.101:9094:宿主机通过 192.168.24.101:9094 访问 Kafka。
  -e KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://192.168.24.101:9092,EXTERNAL://192.168.24.101:9094 \
  #定义每个 listener 对应的协议(这里全部使用明文 PLAINTEXT)
  -e KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,EXTERNAL:PLAINTEXT \
  #声明 controller 的投票者(即 controller 之间的通信)。
  #0@kafka:9093:ID 为 0 的节点,其 controller 地址是 localhost:9093。
  #单节点配置即可,集群中要配置多个。
  -e KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=0@localhost:9093 \
  #告诉 Kafka 哪个 listener 是 controller 用的。
  -e KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER \
  #使用 Docker volume kafka-data 来持久化 Kafka 数据(日志、topic 等),即使容器删除数据也不会丢失。
  -v kafka-data:/bitnami/kafka \
  bitnami/kafka:3.6.0

3.验证Kafka是否创建完成

INFO ... Kafka successfully initialized
INFO ... Starting Kafka server
INFO ... [KafkaServer id=0] started (kafka.server.KafkaServer)

当最后出现“started”或“ready”字样,就表示 Broker 已经监听并可用。

Docker部署Kafka Kafka官方提供了官方镜像,我们可以使用它来快速搭建Kafka环境。通过以上步骤,我们成功地使用Docker搭建了Kafka环境,并进行了消息的发布和订阅。上述命令中,我们指定了容器的名称为"kafka",并将宿主机的9092端口映射到容器的9092端口。命令在运行中的"kafka"容器中执行了"kafka-topics"命令来创建主题。如果看到名为"kafka"的容器正在运行,则表示Kafka环境已成功搭建。命令消费了名为"mytopic"的主题中的消息,并通过。指定了Kafka监听的地址和端口, 阅读详情

相关推荐

【docker】宿主机安装kafka docker容器内clickhouse无法连接

请注意,这些日志行提供的信息是基于所提供的内容。要获得更全面和准确的分析,可能需要查看更多的日志内容并了解系统的上下文和配置。本地搭建了一套clickhouse连接kafka的环境,然后发现无法连接到kafka,环境如下。这是ClickHouse服务器日志的最后几行内容。docker内部telnet如下。

九师兄 1297

用 docker 部署kafka

通过 docker 部署 kafka 服务

lijiewen2017的博客 2万+

物联网数据处理的终极指南:Hadoop vs Spark

物联网(IoT)时代,全球连接的设备数量已突破500亿台(2023年数据),每台设备每秒都在产生数据——传感器的温度、摄像头的视频帧、智能电表的电量读数……这些数据具有**海量性(日增TB/PB级)、多源性(设备/网关/云)、实时性(需秒级响应)、异构性(结构化/半结构化/非结构化)**四大特点,传统数据库(如MySQL)已无法应对,必须依赖大数据框架。Hadoop和Spark作为大数据领域的两大主流框架,到底谁更适合物联网数据处理?很多开发者困惑于两者的差异——Hadoop的批处理能力强,但实时性差;

架构师的AI之路,分享AI应用开发架构的学习与实践。 643

【Docker】手把手教你使用Docker安装kafka【详细教程】

手把手教你使用Docker安装kafka

m0_64210833的博客 4万+

JESD204B Subclass 1的SYSREF机制

SYSREF 是一个系统级同步脉冲信号,用于对齐 JESD204B 中的 LMFC(Local Multi-Frame Clock),从而实现每次建链的延迟一致性。核心点内容说明是系统参考跨多个芯片、多通道实现精确同步控制 LMFC决定所有设备的 LMFC 对齐点仅用于 Subclass 1是 JESD204B 实现确定性延迟的前提条件一般通过时钟芯片生成推荐使用 AD9528、LMK04828,支持 JESD204 专用输出建链过程中关键作用。

weixin_41230430的博客 1828

单细胞 | pySCENIC·转录因子分析(二)

接上一篇,pySCENIC分析完之后就可以进行可视化了,个人认为最重要的有三个图:rss点图,rank图,转录因子表达水平热图,3个图结合着看。3.可视化rank图,可以自己改一下plotRSS_oneSet参数让图更好看一点。4. regulon表达水平热图,转录因子表达水平同理,得到的图类似只是输入不一样。2.可视化点图:寻找cluster特异性转录因子。1.loom文件读入R,提取数据。

生信练习生 4283

30分钟带你搞定Dokcer部署Kafka集群

准备一下两个文件,他们的位置可以放到任意地方,只需要镜像部署的配置文件中能引用到即可。

Gefangenes的博客 214

from pointnet2_ops import pointnet2_utils 安装过程

pointnet2_ops

goodgoodstudy___的博客 8362

Dokcer 搭建 kafka

pull镜像 docker pull wurstmeister/zookeeper docker pull wurstmeister/kafka 安装zookeeper 我这里做了资源限制 docker run -d \ --name zookeeper \ -p 2181:2181 \ --memory=1024m --cpus=1 \ -t wurstmeister/zookeeper 安装kafka docker run -d \ --name kafka \ -p 9092

weixin_38367535的博客 223

【Hermes Agent】2026 Hermes Agent 最新入门级实战指南:从原理、部署、模型配置到落地 Demo

当下 Vibe Coding、AI 自动化时代,单纯对话大模型已经没有竞争力,

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 244

LeRobot X-VLA:首个适用于任意机器人、任意任务的软提示机器人基础模型

X-VLA是一种基于软提示的视觉-语言-动作模型,通过可学习嵌入向量编码不同机器人配置,实现跨平台统一控制。该框架采用两阶段训练:先在29万次多平台任务中学习通用策略,再通过微调少量参数(仅1%)适配新机器人。实验表明,0.9B参数的X-VLA在6个仿真和3个真实平台上表现优异,如LIBERO任务达93%成功率,布料折叠任务100%完成。其核心创新是将硬件差异视为"任务",用软提示引导Transformer处理异构数据,为机器人基础模型提供可扩展方案。

2506_90492529的博客 1241

dokcer 下安装kafka

1. 从网易镜像蜂巢中心下载 zookeeper kafka 镜像 docker pull zookeeper  docker pull kafka 2. 容器中启动 启动zookeeper  bin/kafka-console-consumer.sh --zookeeper zookeeper:2181 --topic mykafka --from-beginning  启动kafk

hello world 368

OCS2 入门教程(一)

OCS2 是专为切换系统优化控制(ptimalontrol forwitchedystems,OCS2)定制的 C++ 工具箱。该工具箱提供以下算法的高效实现:SLQ:连续时间域约束 DDPiLQR:离散时域约束 DDPSQP:基于 HPIPM 的多重打靶算法IPM: 基于非线性内点法的多重搜索算法SLP:基于 PIPG 的顺序线性规划算法OCS2 通过增强拉格朗日法(Augmented Lagrangian)或松弛障碍法(relaxed barrier methods)处理一般路径约束。

机器人控制与仿真应用 7836

使用Dokcer快速搭建kafka

docker快速搭建kafka

我的博客 310

Python 爬虫实战:全国高校录取分数线数据爬取与院校对比分析

本文介绍了一个基于Python的高考志愿填报辅助系统,通过爬取掌上高考平台的全国高校录取分数线数据,构建本地数据库并实现智能分析。系统主要功能包括:1)使用requests+BeautifulSoup爬取院校基本信息和历年分省分科类录取线;2)通过SQLite实现数据持久化与增量更新;3)利用pyecharts生成分数线趋势图、院校对比雷达图等可视化图表;4)提供"冲稳保"三档智能选校推荐。技术栈涵盖网络爬虫、数据清洗、数据库管理和可视化分析,可为考生提供数据驱动的志愿填报决策支持。项目采用模块化设计,包含

u014481728的博客 238

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Kafka之docker部署

一.镜像拉取 docker pull wurstmeister/zookeeper docker pull wurstmeister/kafka docker pull sheepkiller/kafka-manager 二.定义docker-compose.yml version: '3' services: zookeeper: image: wurstmeister/zookeeper ports: - "2181:2181" kafka: image: w

RedStone618的博客 888

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Kafka安装部署以及相关介绍1

我们想要了解Kafka,首先需要知道什么是消息队列。消息队列(MQ):存放消息的容器,这里的消息可以是任何东西,比如用户下单了,订单支付,登录注册成功,这些都是消息,而消息队列就是存储这些消息的地方。kafka就是其中的一个组件,它是消息队列的具体实现。2.应用异步处理,系统解耦,流量销峰,日志处理。(这里就不赘述了)点对点:一条消息只能被一个消费者消费发布/订阅:一条消息所有的订阅者都可以消费。我们要学的Kafka,就是发布订阅这种模型。kafka在以前必须依赖。

2401_87618381的博客 408

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

dokcer打filebeat镜像

Filebeat容器主要负责将app容器里面的日志推送到kafka, 为了降低耦合度及后续的维护难度,创建filebeat容器的时候可将filebeat.yml配置文件以configmap的方式实现。本文是单独打的filebeat镜像,当然也有在项目中集成的。因为项目针对日志在宿主机上设置了挂载点,filebeat镜像也设置同样的挂载点,这样就能取到日志完成发送。 Dockerfile文件内容 FROM centos MAINTAINER youcaige # Install Filebeat W.

fan1865221的博客 732

Kafka on Docker

//启动zookeeper docker run -d -p 2181:2181 –net=zoonet –name=zookeeper -e ZOOKEEPER_CLIENT_PORT=2181 wurstmeister/zookeeper //启动kafka docker run -d –net=zoonet –name kafka -p 9092:9092 -e KAFKA_...

aLivable_Dedode的博客 270

Dokcer搭建各种服务|第五章 安装mongodb

通过docker安装mongodb前言什么是mongodb拉取镜像设定角色权限连接mongodb如何操作mongodb附录角色表 前言 这个系列是对我学习docker的一个总结,先从各种服务的搭建开始,直接带大家实战入门。其实docker本身是运维技能,后端同学只需要了解即可。我这个系列也不会对docker太过深入,点到为止。 这个系列暂时完结,常用软件就以mongodb收官。 什么是mongod...

JokerLiu的博客 227

使用Dokcer-compose一站式搭建Prometheus+Grafana监控

Prometheus组件中的核心部分,负责实现对监控数据的获取,存储以及查询监控数据持久化数据库,时序数据库chunks:存储所有时间序列数据块(chunk),每个块包含一定时间范围内的一组样本数据。Prometheus 会周期性地将采集到的样本数据划分为一些块,并将它们写入此目录下的子目录中。index:存储所有时间序列的索引信息,以便 Prometheus 可以快速查找和检索样本数据。索引文件按照特定格式存储,其中包含了各种元数据(例如标签名称、值、时间戳等)以及对应数据块的位置和偏移量等信息。

xactuax的博客 1125

docker安装 kafak及外部链接配置

主要解决docker安装的kafka的外部无法访问的问题

qq_1342832900的博客 813

docker学习笔记

1.安装 1.1查看是否已经安装 yum list installed | grep docker 2.2 安装docker yum -y install docker 阿里云ECS服务器和阿里云IOT平台账号 1.爱尔-阿里云ECS服务器 服务器账号 服务器IP:121.41.47.36 用户名:liusaisai 密码: liusaisai123 端口号和项目统计 32121,用于MQTT数据接入EMQX服务器,tcp监听端口;专用 32122,私有MQTT服务器EMQX的控制台网页

走过,路过,别错过的博客 494

(Dify日志级别设置避坑指南):90%新手都会犯的2个错误

掌握Dify日志级别设置与查看技巧,避开配置常见错误。适用于本地部署与生产环境,详解调试模式开启、日志等级调整核心方法,提升问题排查效率。配置清晰可靠,值得收藏。

GatherTide的博客 1049
上一篇: go语言实现用户管理系统
下一篇: Kafka Go客户端--Sarama
Cxzzzzzzzzzz
博客等级 码龄4年 229粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值