
机器学习:训练集与测试集分割train_test_split

Sklearn切分数据集(超详细) 当一个数据集足够大时,可将同一数据集按比例切分为训练集和测试集。Sklearn库在机器学习中具有非常重要的作用。在本篇文中,将介绍如何使用sklearn库的model_selection模块,以及具体实现细节。 阅读详情
AI摘要

本文详细介绍了scikit-learn库中的train_test_split函数,用于Python机器学习中数据集的划分,包括参数说明、使用示例以及sklearn库在数据预处理和机器学习任务中的重要性。,

1 引言

在使用机器学习训练模型算法的过程中,为提高模型的泛化能力、防止过拟合等目的,需要将整体数据划分为训练集和测试集两部分,训练集用于模型训练,测试集用于模型的验证。此时,使用train_test_split函数可便捷高效的实现数据训练集与测试集的划分。

2 train_test_split介绍

train_test_split函数来自scikit-learn库(也称为sklearn),安装命令:

pip install sklearn

函数的导入:

from sklearn.model_selection import train_test_split

2.1 函数定义

def train_test_split(*arrays,test_size=None,train_size=None,random_state=None,
    shuffle=True,stratify=None,):

2.2 参数说明

  • *arrays: 单个数组或元组,表示需要划分的数据集。如果传入多个数组,则必须保证每个数组的第一维大小相同。
  • test_size: 测试集的大小(占总数据集的比例,值为0.0-1.0,表示测试集占总样本比例)。默认值为0.25,即将传入数据的25%作为测试集。
  • train_size: 训练集的大小(占总数据集的比例,值为0.0-1.0,表示训练集占总样本比例)。默认值为None,此时和test_size互补,即训练集的大小为(1-test_size)。
  • random_state: 随机数种子。可以设置一个整数,用于复现结果。默认为None。其实是该组随机数的编号,在需要重复试验的时候,保证得到一组一样的随机数。(比如每次都填1,其他参数一样的情况下你得到的随机数组是一样的。但填0或不填,每次都会不一样。)
  • shuffle: 是否随机打乱数据。默认为True。
  • stratify: 可选参数,用于进行分层抽样。传入标签数组,保证划分后的训练集和测试集中各类别样本比例与原始数据集相同。默认为None,即普通的随机划分。(此参数作用是保持测试集与整个数据集里的数据分类比例一致,比如有1000个数据,800个属于A类,200个属于B类。设置stratify = y_lable,test_size=0.25,split之后数据组成如下:training: 750个数据,其中600个属于A类,150个属于B类;testing: 250个数据,其中200个属于A类,50个属于B类)

2.3 返回值

该函数返回一个元组(X_train, X_test, y_train, y_test),其中X_train表示训练集的特征数据,X_test表示测试集的特征数据,y_train表示训练集的标签数据,y_test表示测试集的标签数据。

2.4 注意事项

  • test_size和train_size必须至少有一个设置为非None。
  • 当传入多个数组时,请确保每个数组的第一维大小相同。
  • random_state要设置一个整数值,从而保证每次获取相同的训练集和测试集
  • 当使用分层抽样时,请确保传入的标签数组是正确的。

3 train_test_split使用

3.1 使用train_test_split分割Iris数据

from sklearn import datasets
from sklearn.model_selection import train_test_split

# 加载Iris数据集
iris = datasets.load_iris()
X = iris.data
y = iris.target

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=1)
train_dataset = TensorDataset(torch.from_numpy(X_train), torch.from_numpy(y_train))
test_dataset = TensorDataset(torch.from_numpy(X_test), torch.from_numpy(y_test ))

batch_size = 32
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=True)

print(X_train)
print(X_test)

结果展示:

X_train=[[6.5 2.8 4.6 1.5]
 [6.7 2.5 5.8 1.8]
 [6.8 3.  5.5 2.1]
 [5.1 3.5 1.4 0.3]
 [6.  2.2 5.  1.5]
 ......此处数据省略
 [4.9 3.6 1.4 0.1]]
X_test=[[5.8 4.  1.2 0.2]
 [5.1 2.5 3.  1.1]
 [6.6 3.  4.4 1.4]
 [5.4 3.9 1.3 0.4]
 [7.9 3.8 6.4 2. ]
 ......此处数据省略
 [5.2 3.4 1.4 0.2]]

3.2 使用train_test_split分割水果识别数据

在/opt/dataset下存放着水果图片的分类数据文件夹(文件夹名称为标签),每个文件夹下存储着多张对应标签的水果图片,如下所示:
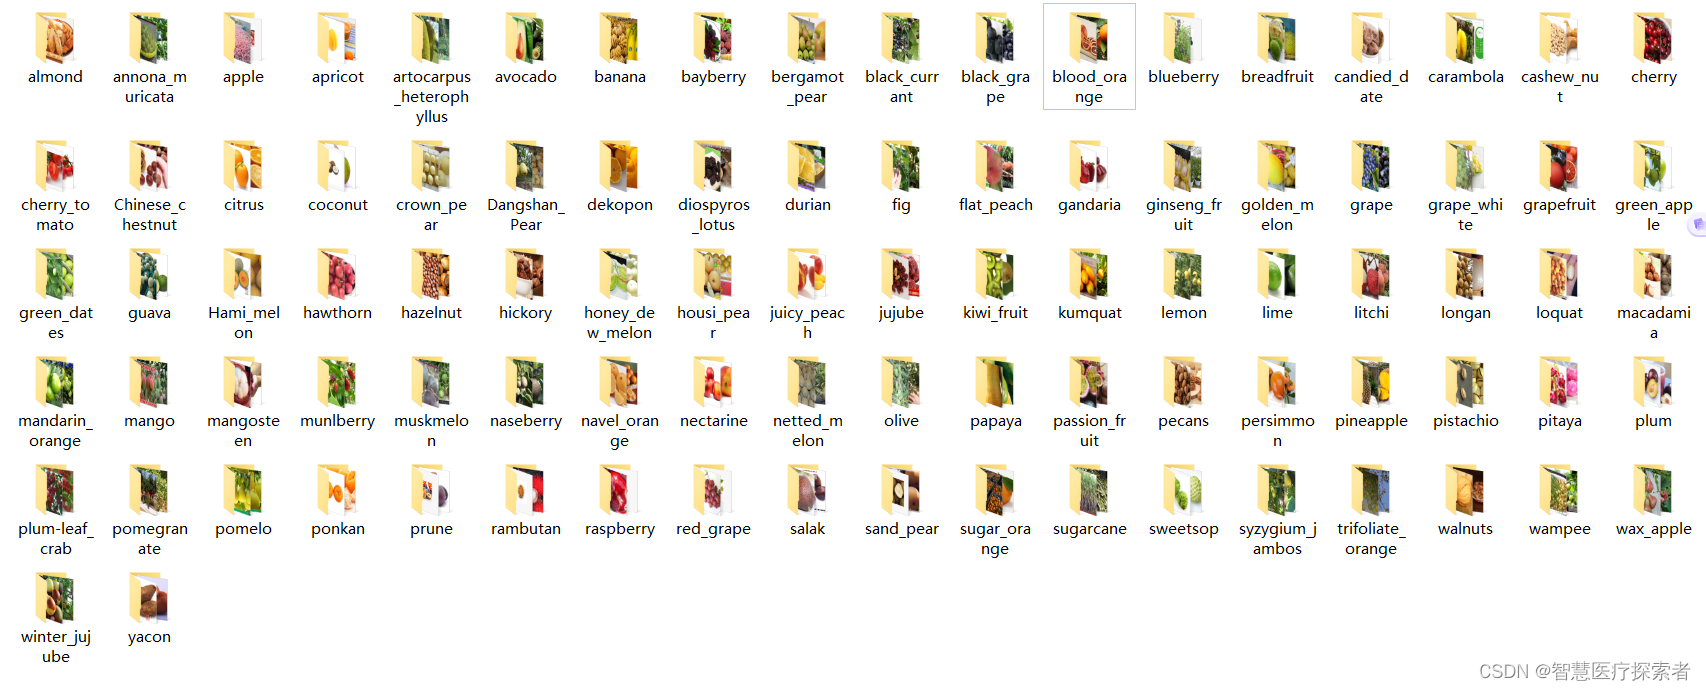
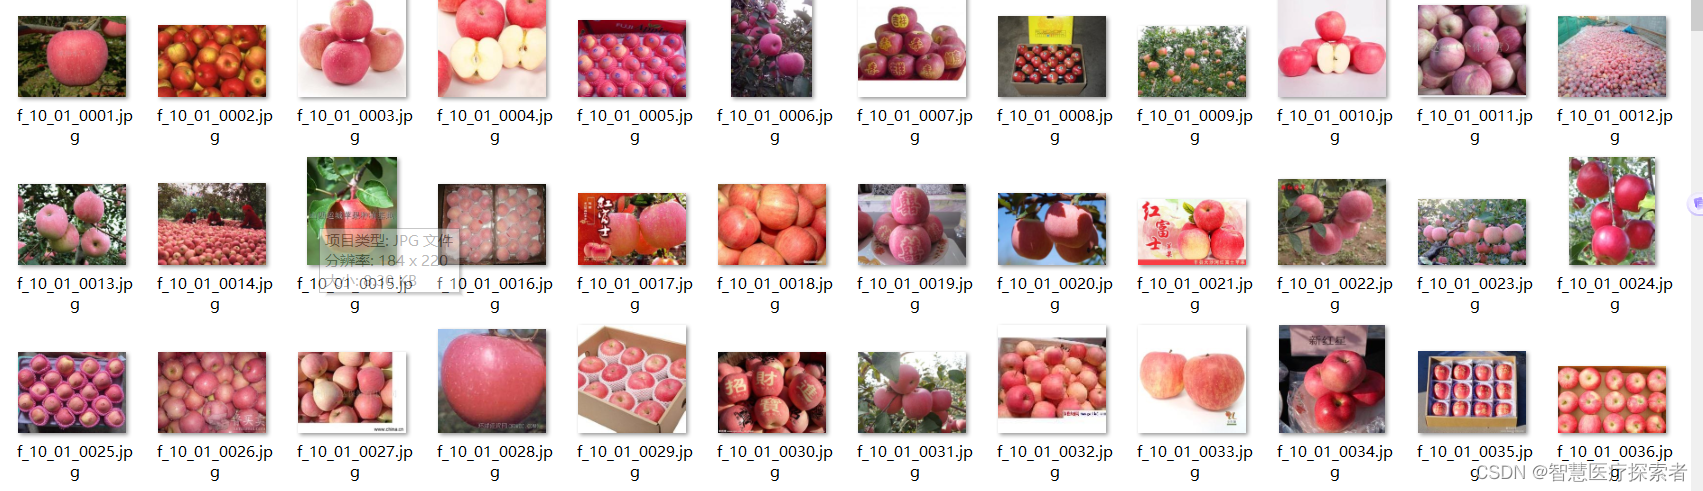
以apple文件夹为例,图片内容如下:
数据加载和分割数据集的代码如下:

from torchvision.datasets import ImageFolder
from sklearn.model_selection import train_test_split

# 图像变换
transform = transforms.Compose([transforms.Resize((224, 224)),
                                transforms.ToTensor(),
                                transforms.Normalize(
                                     mean=[0.5, 0.5, 0.5],
                                     std=[0.5, 0.5, 0.5]
                                ), ])
# 加载数据集
dataset = ImageFolder('/opt/dataset', transform=transform)

# 划分训练集与测试集
train_dataset, valid_dataset = train_test_split(dataset, test_size=0.2, random_state=10)

batch_size = 64
train_loader = DataLoader(dataset=train_dataset, batch_size=batch_size, shuffle=True, drop_last=True)
test_loader = DataLoader(dataset=valid_dataset, batch_size=batch_size, shuffle=True, drop_last=True)

4 sklearn介绍

train_test_split()是sklearn
.cross_validation模块中用来随机划分训练集和测试集。

sklearn,全称scikit-learn,是python中的机器学习库,建立在numpy、scipy、matplotlib等数据科学包的基础之上,涵盖了机器学习中的样例数据、数据预处理、模型验证、特征选择、分类、回归、聚类、降维等几乎所有环节,功能十分强大。与深度学习库存在pytorch、TensorFlow等多种框架可选不同,sklearn是python中传统机器学习的首选库,不存在其他竞争者。

sklearn为初学者提供了一些经典数据集,通过这些数据集可快速搭建机器学习任务、对比模型性能。数据集主要围绕分类和回归两类经典任务,对于不同需求,常用数据集简介如下:

  • load_breast_cancer:乳腺癌数据集,特征为连续数值变量,标签为0或1的二分类任务

  • load_iris:经典鸢尾花数据集,特征为连续数值变量,标签为0/1/2的三分类任务,且各类样本数量均衡,均为50个

  • load_wine:红酒数据集,与鸢尾花数据集特点类似,也是用于连续特征的3分类任务,不同之处在于各类样本数量轻微不均衡

  • load_digits:小型手写数字数据集(之所以称为小型,是因为还有大型的手写数字数据集mnist),包含0-9共10种标签,各类样本均衡,与前面3个数据集最大不同在于特征也是离散数值0—16之间,例如在进行多项式朴素贝叶斯模型、ID3树模型时,可用该数据集

  • load_boston:波士顿房价数据集,连续特征拟合房价,适用于回归任务

值得指出,sklearn除了load系列经典数据集外,还支持自定义数据集make系列和下载数据集fetch系列(load系列为安装sklearn库时自带,而fetch则需额外下载),这为更多的学习任务场景提供了便利。

sklearn中的各模型均有规范的数据输入输出格式,一般以np.array和pd.dataframe为标准格式,所以一些字符串的离散标签是不能直接用于模型训练的;同时为了加快模型训练速度和保证训练精度,往往还需对数据进行预处理,例如在以距离作为度量进行训练时则必须考虑去量纲化的问题。为此,sklearn提供了一些常用的数据预处理功能,常用的包括:

  • MinMaxScaler:归一化去量纲处理,适用于数据有明显的上下限,不会存在严重的异常值,例如考试得分0-100之间的数据可首选归一化处理

  • StandardScaler:标准化去量纲处理,适用于可能存在极大或极小的异常值,此时用MinMaxScaler时,可能因单个异常点而将其他数值变换的过于集中,而用标准正态分布去量纲则可有效避免这一问题

  • Binarizer:二值化处理,适用于将连续变量离散化

  • OneHotEncoder:独热编码,一种经典的编码方式,适用于离散标签间不存在明确的大小相对关系时。例如对于民族特征进行编码时,若将其编码为0-55的数值,则对于以距离作为度量的模型则意味着民族之间存在"大小"和"远近"关系,而用独热编码则将每个民族转换为一个由1个"1"和55个"0"组成的向量。弊端就是当分类标签过多时,容易带来维度灾难,而特征又过于稀疏

  • Ordinary:数值编码,适用于某些标签编码为数值后不影响模型理解和训练时。例如,当民族为待分类标签时,则可将其简单编码为0-55之间的数字

label y 训练集测试集x_训练集测试集划分 train_test_split(X, y, stratify=y) sklearn——train_test_split 随机划分训练集和测试集 sklearn.model_selection.train_test_split随机划分训练集和测试集 官网文档:http://scikit-learn.org/stable/modules/generated/sklearn.model_selection.train_test_split.html 一般形式: trai... 阅读详情

相关推荐

纯随机采样(train_test_split)和分层采样(StratifiedShuffleSplit)| sklearn库实现

Scikit-Learn 提供了一些函数,可以用多种方式将数据集分割成多个子集。 sklearn.model_selection.train_test_split 是纯随机的取样方法,即没有对原数据集进行分层,具体调用如下: from sklearn.model_selection import train_test_split train_set, test_set = train_test_split(data, test_size=0.2, random_state=42) 其中,random_s

用途:中英文学习笔记,如有侵权,可评论留言,及时清理;学历:NUS计算机硕士;SYSU地球物理学士 1万+

python机器学习 train_test_split()函数用法解析及示例 划分训练集和测试集 以鸢尾数据为例 入门级讲解

文章目录train_test_split()用法获取数据划分训练集和测试集完整代码脚手架 train_test_split()用法 python机器学习中常用 train_test_split()函数划分训练集和测试集,其用法语法如下: X_train, X_test, y_train, y_test = train_test_split(train_data, train_target, test_size, random_state, shuffle) 变量 描述 X_train 划

侯小啾技术博客 11万+

划分训练集、验证集和测试集代码

val_ratio,和test_ratio分别为验证集和测试集所占的比例,test_ratio=0表示不划分测试集。输入需要划分的数据所在的文件夹,返回一个划分好的包含train,val和test的文件夹。

Billie使劲学的博客 4426

train_test_split详解

train_test_split是python在机器学习中常常需要用到的一个方法安装方法:pip installsklearn导入方法:from sklearn.model_selection import train_test_splittrain_test_split是每个机器学习学习者必学的方法之一,这里给大家总结出了详细的用法。

weixin_42888180的博客 1万+

数据拆分神器:train_test_split 帮你轻松分割训练集与测试集

train_test_split 是 scikit-learn 提供的一个强大工具,可以轻松地将数据集随机拆分为训练集和测试集,帮助模型在不同数据上进行训练和评估,从而提高模型的泛化能力。

专注于深入研究多种编程语言,以实战为导向,逐步拓展开发技能,提升工程化编码和思维能力,展现无敌技术实力。 442

离散数学期末复习笔记【精华版】

文章目录前言一、????理逻辑1. 命题逻辑2. 等值演算3. 主合取范式、主析取范式4. 【题】推理证明5. 辖域、自由变元、约束变元二、????合1. 环和、环积,幂集,笛卡尔乘积三、 ????????关系1. 自反、对称、传递2&3. 合成运算,逆关系、闭包4. 哈斯图、上下界、偏序5. 等价关系、划分四、????1. 幺元(么元、单位元)、零元、逆元,半群、群、阿尔贝群、独异点、循环独异点2. 【题】由表判断3. 【题】证明五、????论1. 简单图、平凡图、多重图、子图、补图、出度、入度、

林大夕可的博客 17万+

iris数据集_sklearn日志(二)训练集和测试集划分

机器学习算法需要大量的数据,这些数据一部分用于模型训练,另一部分作为测试或验证。机器学习入坑者:sklearn日志(一)体验官方提供的标准数据集​zhuanlan.zhihu.com sklearn库不仅提供了多个标准数据集,同时还具有易用的数据集划分功能,核心函数为train_test_split(),下面将对此函数用法进行具体介绍。1、准备:数据集读取首先,读取sklearn提供的标...

weixin_39827850的博客 1841

保姆级教程如何进行本地局域网布署openclaw小龙虾

全网唯一一篇一步步实战教程,图文并茂方式的方式教你如何本地部署安装小龙虾openclaw

zzw17wei的专栏 1467

训练集/验证集/测试集 7:2:1分割:3种Python实现方法与场景选择指南

本文详细介绍了训练集、验证集和测试集7:2:1分割的三种Python实现方法及其适用场景,帮助开发者在机器学习项目中优化数据划分策略。通过对比sklearn的train_test_split、StratifiedShuffleSplit分层抽样和自定义时间序列分割器,提供针对不同数据特点的解决方案,提升模型评估效率和性能。

weixin_30985047的博客 277

记录一次小项目中的重放攻击与解决方案

文章目录1、重放攻击简介2、重放攻击演示3、解决方案4、重放攻击验证 欢迎各位 前(提)来(出)讨(意)论(见)。 1、重放攻击简介 重放攻击(Replay Attacks)又称重播攻击、回放攻击,是指攻击者发送一个目的主机已接收过的包,来达到欺骗系统的目的,主要用于身份认证过程,破坏认证的正确性。 举个简单的小例子。 我们往系统里面插入一条数据,如果此次操作的数据包被攻击者获取,又恰巧后台没有对重复内容进行验证,那么攻击者就可以利用该数据包重复的发起请求,无限制的往数据库插入数据,即使请求包是加密的也

fiveSix 8726

安卓风控对抗实战:如何用AOSP定制ROM绕过Momo、AIDA64等检测(从环境搭建到设备画像)

本文详细解析了如何通过定制AOSP ROM绕过Momo、AIDA64等安卓风控检测工具的设备指纹识别。从环境搭建到硬件参数修改,再到内核级特征混淆,提供了一套完整的底层对抗方案,显著提升设备伪装通过率。

weixin_30687051的博客 490

train_test_split(),随机划分训练集和测试集的函数

sklearn.model_selection.train_test_split() from sklearn.model_selection import train_test_split x_train,x_test,y_train,y_test=train_test_split(train_data,train_lable,test_size=0.3,random_state=o,strat...

qq_38410428的博客 1万+

浏览器主页被360篡改?教你彻底解决并预防再次发生

通过本文介绍的快捷方式修复、注册表清理、启动项管理三步法,可解决99%的浏览器主页篡改问题。权限最小化原则:非管理员账户日常使用,关键系统目录设置写保护定期安全审计:每月检查启动项/计划任务/浏览器扩展备份还原机制:创建系统还原点,重要操作前做好快照安全意识培养:不安装来源不明的软件,谨慎处理软件安装向导中的附加选项浏览器安全是系统防护的重要环节,建议结合EDR(终端检测与响应)方案构建立体防护体系。对于普通用户,保持系统更新、使用官方渠道下载软件、定期清理系统垃圾,即可有效预防绝大多数安全威胁。

nntxthml的博客 1万+

sklearn的train_test_split()各函数参数含义解释

在机器学习中,我们通常将原始数据按照比例分割为“测试集”和“训练集”,从 sklearn.model_selection 中调用train_test_split 函数 简单用法如下: X_train,X_test, y_train, y_test =sklearn.model_selection.train_test_split(train_data,train_target,test_size=0.4, random_state=0,stratify=y_train) # train_data:所要划分的

zjmy的博客 1万+

基于STM32设计的数字电子秤

当前项目是采用采用STM32+称重模块+OLED实现了简单的电子秤项目,称重模块上采用24位的ADC芯片,精度较高。实现了称重,校准、去皮等功能。

1万+

Python爬虫反爬:突破Cloudflare 5秒盾(免费方案,小红书/知乎可用)

这套方案的核心优势是“真实模拟+免费无门槛”无需付费代理、无需复杂JS解密,仅用playwright模拟真实浏览器,即可突破Cloudflare 5秒盾;适配小红书、知乎、豆瓣等主流平台,修改配置即可复用;兼顾易用性和稳定性,新手也能快速上手,企业级场景可通过IP轮换、异步爬取进一步优化。“模拟人类行为到底”——Cloudflare的反爬本质是区分“机器”和“人类”,只要爬虫的浏览器指纹、行为特征与人类一致,就能稳定绕过限制。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 2881

train_test_split 函数 

在机器学习中,我们通常将原始数据按照比例分割为“测试集”和“训练集”,从 sklearn.model_selection 中调用train_test_split 函数 简单用法如下: X_train,X_test, y_train, y_test =sklearn.model_selection.train_test_split(train_data,train_target,test_size=0.4, random_state=0,stratify=y_train)# train_data:所要划.

人的抱怨源自,自我无能的愤怒 1万+

动态时间规整(Dynamic Time Warping,DTW):让时间序列分析不再枯燥和代码全分析

动态时间规整(DTW)是一种用于比较时间序列相似性的算法,特别适用于处理长度不同或时间轴不对齐的序列。本文介绍了DTW的核心概念,包括其通过非线性对齐解决时间扭曲问题的能力,以及在语音识别、金融分析等领域的应用。通过Python代码示例,演示了如何计算两个模拟时间序列的DTW距离,并可视化最优对齐路径。结果显示,DTW能够有效捕捉序列间的相似模式,即使它们在时间轴上存在偏移或伸缩。该算法通过最小化累积距离来评估相似性,得分越低表明序列间相似度越高。

此星光明博客 163

Scikit-learn(sklearn)机器学习的数据分割方法--train_test_split和KFold

本文简单介绍了机器学习中的数据分割经常使用的方法,并具体介绍了sklearn中简单随机分割train_test_split、标准K折交叉验证KFold两种具体方法及其使用案例,后续文章将介绍其他几种数据分割方法。需要注意任何基于统计的预处理(如均值填充、标准化)都应仅在训练集上计算参数,再应用到测试集,这样测试集才能起到评估训练后模型的效果。

老猿Python 1766

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

python sklearn 机器学习 train_test_split 划分训练集测试集 鸢尾数据实例

目录获取数据划分训练集和测试集完整代码脚手架python机器学习中常用 train_test_split()函数划分训练集和测试集,其用法语法如下:X_train, X_test, y_train, y_test = train_test_split(train_data, train_target, test_size, random_state, shuffle)以sklearn库内置的iris数据集(鸢尾数据集)为例,首先获取数据: 这里的dataset数据是sklearn.utils.Bunch

whatday的专栏 2880

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

matlab划分训练集验证和测试集代码_训练集、验证集和测试集

机器学习简单流程:使用大量和任务相关的数据集来训练模型;通过模型在数据集上的误差不断迭代训练模型,得到对数据集拟合合理的模型;将训练好调整好的模型应用到真实的场景中;我们最终的目的是将训练好的模型部署到真实的环境中,希望训练好的模型能够在真实的数据上得到好的预测效果,换句话说就是希望模型在真实数据上预测的结果误差越小越好。我们把模型在真实环境中的误差叫做泛化误差,最终的目的是希望训练好的模型泛化误...

weixin_39748183的博客 1万+

sklearn.model_selection.train_test_split 用法

sklearn之前没有接触过,以练代学了。常用的用法记录下来,这样才能慢慢总结。 sklearn.model_selection.train_test_split 用法 在使用python做机械学习时候,为了制作训练数据(training samples)和测试数据(testing samples),常使用sklearn里面的 sklearn.model_selection.trai

鱼霸 3万+

Scikit-learn API:train_test_split函数 将数据分割为训练集和测试集

函数原型 sklearn.model_selection.train_test_split(*arrays, **options) 函数功能 将数组或矩阵随机的分割成训练集和测试集,注意这里是随机的。假定某元素A第一次划分为测试集,在数据集中新增数之后,再进行划分则可能划分到训练集中。 参数说明 *arrays:长度或者shape[0]相同7的可索引序列。 允许的输入是列表、num...

Wang_PChao的博客 2738

train_test_split参数含义

在机器学习中,我们通常将原始数据按照比例分割为“测试集”和“训练集”,通常使用sklearn.cross_validation里的train_test_split模块用来分割数据。cross_validation已经弃用,现在改为从 sklearn.model_selection 中调用train_test_split 函数。简单用法如下:X_train,X_test, y_train, y_te...

samsam2013的博客 3万+

使用train_test_split划分数据集

是sklearn库中的一个函数,用于将数据集分割为训练集和测试集。

2301_77444219的博客 3935

机器学习python中train_test_split()函数进行数据集分割

函数名:train_test_split 所在包:sklearn.model_selection 功能:划分数据的训练集与测试集 参数解读:train_test_split (*arrays,test_size, train_size, rondom_state=None, shuffle=True, stratify=None) #红色为常用 arrays:特征数据和标签数据(array,list,dataframe等类型),要求所有数据长度相同。 test_size / train_size:

忘川的博客 1万+
上一篇: 机器学习:监督学习、无监督学习、半监督学习、强化学习
下一篇: 深度学习:使用全连接神经网络FCN实现MNIST手写数字识别
源启智能
博客等级 码龄20年 3万+粉丝 285原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

源启智能

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值