代码随想录 Day 17 | 【第六章 二叉树 part05】654.最大二叉树、617.合并二叉树、700.二叉搜索树中的搜索、98.验证二叉搜索树

听故事学语言 · 数据结构篇 · 第五章 藏在文件里的顺序与链 数据结构篇第五章,工业章一,前四章家当的实战回门。拖动进度条为什么秒跳,MP4 登记簿记位置供直达;FAT 文件分配表,链式存储的逻辑、数组实现的身体,1977 年马克·麦克唐纳为软盘设计它;进程档案链表轮转,一头进一头出,内核偏爱链表的连接自由;浏览器后退键,教科书的双向链表对工业界的数组加游标,同一个队形,两种站位法,谁赢谁的战场。 阅读详情

一、654.最大二叉树

又是构造二叉树,昨天大家刚刚做完 中序后序确定二叉树,今天做这个 应该会容易一些, 先看视频,好好体会一下 为什么构造二叉树都是 前序遍历

1. 整体思路

(1)递归终止条件:当传入的数组大小等于1,说明到达叶子节点,停止递归。由于题目中已经定义数组的大小大于等于1,所以不需要对空数组的情况进行处理。

(2)定义一个maxvalue用于更新数组最大值,找到中间结点;同时需要定义一个index用于更新当前数组最大值的下标,只有找到最大值的下标才可以切分数组。由于题目要求数组所有数字均为正整数,所以此处maxvalue初始化为0,最大值下标index也初始化为0。

(3)给定数组来构造二叉树必须使用中序遍历,因为必须先确定中间结点才能进行下一层的树构造。注意:区间均是左闭右开原则。

        1)中间节点:遍历数组所有元素,如果有比maxvalue更大的元素,就将该元素的值赋给maxvalue,并且将该元素的下标传递给index。接下来定义新节点,传入maxvalue。

        2)左子树:向左遍历递归构造左子树,必须保证左区间的元素个数一定需要大于等于1,所以限制条件index大于0,就可以构建左子树, 从而进行切割新数组。

        3)左子树:index<nums.size-1保证分割点的右区间的大小一定是大于等于1的,接下来同样分割左右区间。

(4)将节点返回。

(5)优化:每一步构造新数组比较耗时,可以进行合并优化。

2. 完整代码

# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def constructMaximumBinaryTree(self, nums: List[int]) -> Optional[TreeNode]:
        # 递归的终止条件:遍历至叶子节点则停止递归
        if len(nums) == 1:
            return TreeNode(nums[0])
        
        # middle:
        max_value = 0 # 初始化最大值
        index = 0     #初始化最大值下标
        for i in range(len(nums)):
            if nums[i] > max_value:
                max_value = nums[i]
                index = i
        node = TreeNode(max_value) # 更新定义中间节点
    
        # left:
        if index > 0: # 递归前,需要确保切割点的左区间元素大于等于1
            nums_left = nums[: index]
            node.left = self.constructMaximumBinaryTree(nums_left) # 递归左子树
    
        # right:
        if index < len(nums)-1: # 递归前,需要确保切割点的右区间元素大于等于1
            nums_right = nums[index+1: ]
            node.right = self.constructMaximumBinaryTree(nums_right) # 递归右子树

        return node


二、617.合并二叉树

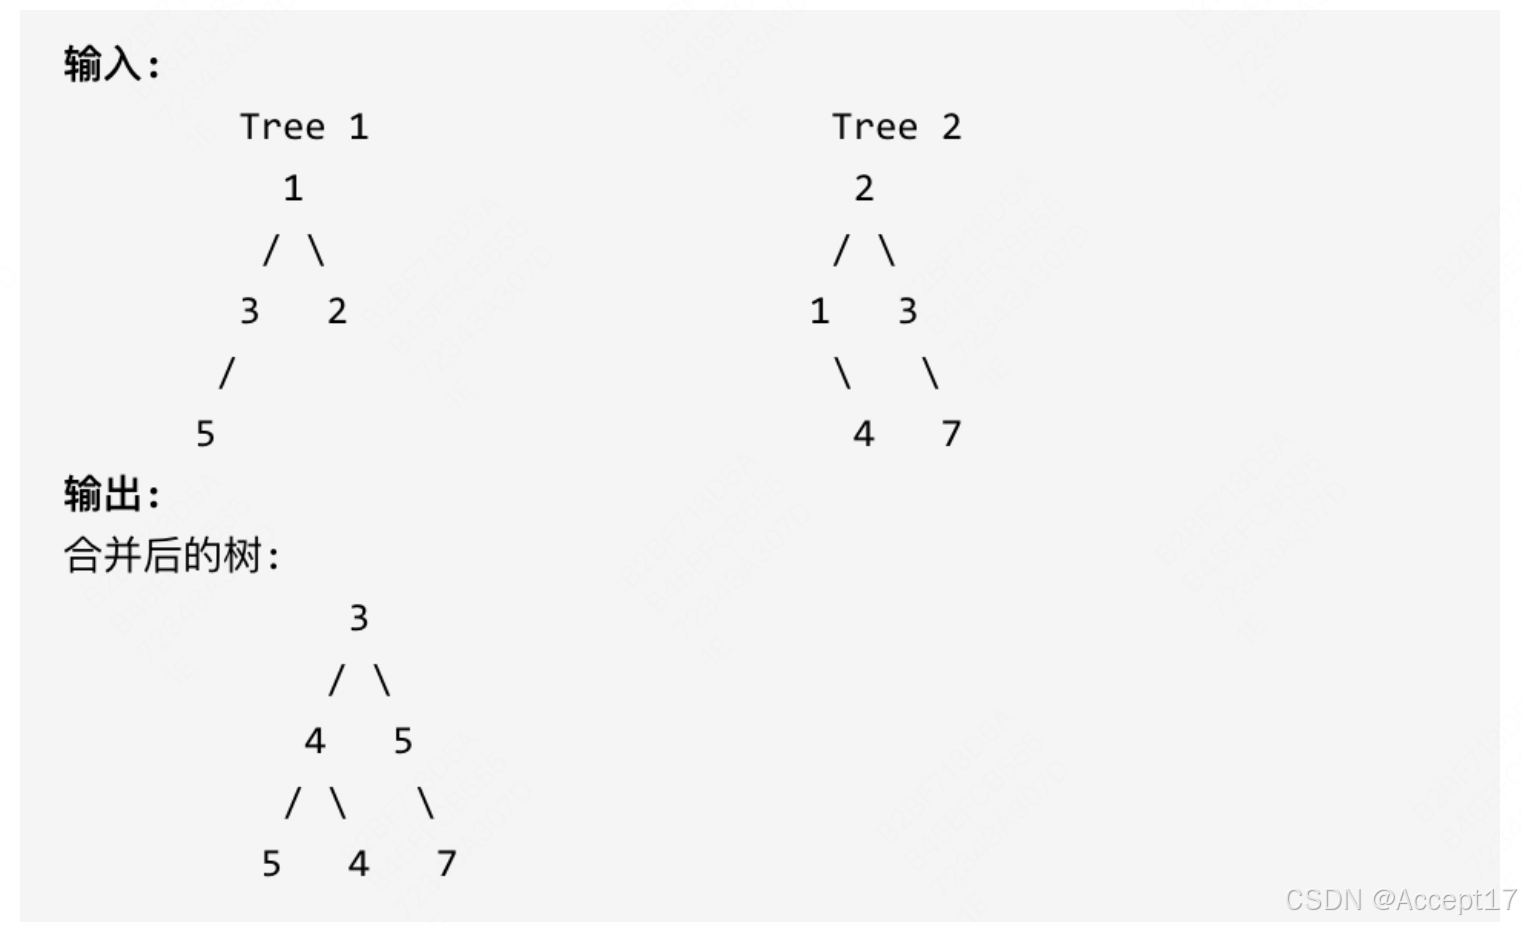
这次是一起操作两个二叉树了, 估计大家也没一起操作过两个二叉树,也不知道该如何一起操作,可以看视频先理解一下。 优先掌握递归。

1. 整体思路

(1)确定函数返回值和传入参数:函数返回值为合并后二叉树的根节点,传入参数为待合并两个树的根节点。

(2)确定终止条件:要明确的是tree1和tree2是同步遍历的,所以当遍历到tree1某节点为空时,返回tree2(此时tree2也遍历到同一位置节点);当遍历到tree2某节点为空时,返回tree1(此时tree1也遍历到同一位置节点)。不需要考虑tree1和tree2同时为空的情况,因为上述条件已经包含了tree1和tree2同时为空,会自动返回null。

        以上两种情况考虑后,如果tree1和tree2都不为空,那么将tree1和tree2对应位置上的值直接相加。

(3)单层递归逻辑:分别递归左右子树。

(4)返回根节点。

(5)此外,本题可以在tree1或tree2基础上修改,或者定义新树;本题前中后序遍历均可。
 

2. 完整代码

# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def mergeTrees(self, root1: Optional[TreeNode], root2: Optional[TreeNode]) -> Optional[TreeNode]:
        # middle:
        if not root1: 
            return root2
        if not root2: 
            return root1
        root1.val += root2.val
        
        # left:
        root1.left = self.mergeTrees(root1.left, root2.left)
        # right:
        root1.right = self.mergeTrees(root1.right, root2.right)

        return root1

三、700.二叉搜索树中的搜索

递归和迭代 都可以掌握以下,因为本题比较简单, 了解一下 二叉搜索树的特性

1. 搜索树的特性

二叉搜索树是一个有序树:

  • 若它的左子树不空,则左子树上所有结点的值均小于它的根结点的值;
  • 若它的右子树不空,则右子树上所有结点的值均大于它的根结点的值;
  • 它的左、右子树也分别为二叉搜索树

2. 递归法代码

(1)首先函数的返回值是节点指针,传入的参数是二叉搜索树和目标值。判断传入的节点是否为空,如果为空,直接返回根节点。

(2)如果目标值小于当前中间节点值,那么根据搜索二叉树的特性,要搜索的节点一定在当前节点的左子树中,所以必须向左子树去遍历。

(3)如果目标值大于当前中间节点值,那么根据搜索二叉树的特性,要搜索的节点一定在当前节点的右子树中,所以必须向右子树去遍历。

(4)如果没有搜索到结果,自动默认返回null。

# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def searchBST(self, root: Optional[TreeNode], val: int) -> Optional[TreeNode]:
        if not root or root.val == val:
            return root
        result = TreeNode(val = None)

        if val < root.val:
            result = self.searchBST(root.left, val)

        if val > root.val:
            result = self.searchBST(root.right, val)

        return result

四、98.验证二叉搜索树

遇到 搜索树,一定想着中序遍历,这样才能利用上特性。

但本题是有陷阱的,可以自己先做一做,然后在看题解,看看自己是不是掉陷阱里了。这样理解的更深刻。

题目链接/文章讲解:代码随想录

视频讲解:你对二叉搜索树了解的还不够! | LeetCode:98.验证二叉搜索树_哔哩哔哩_bilibili

1. 二叉搜索树的特性

假设一个二叉搜索树具有如下特征:

  • 节点的左子树只包含小于当前节点的数。
  • 节点的右子树只包含大于当前节点的数。
  • 所有左子树和右子树自身必须也是二叉搜索树。

2. 直白想法

        利用二叉搜索树的特性,采用中序遍历(左中右),遍历树,并存放在数组中,如果数组排列从小到大,那么说明这棵树是搜索二叉树。   

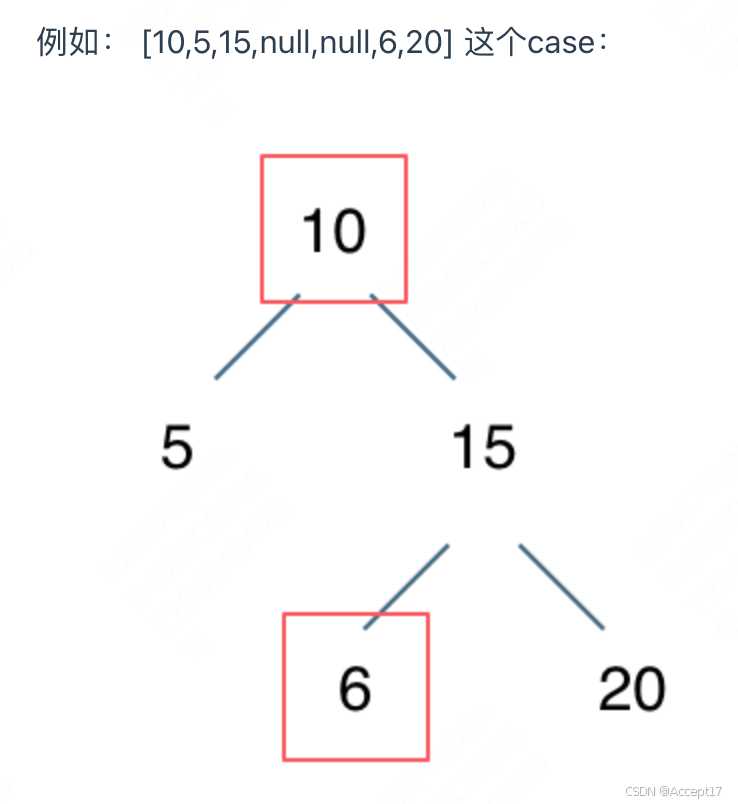
3. 递归法代码误区

        仅比较中间节点比左孩子大且比右孩子小,然而二叉搜索树需要满足中间节点比左子树上所有节点值大且比右子树所有节点值小。    
4. 代码实现

(1)本题采用中序遍历,用于比较中间节点是否大于左子树所有节点,并且小于右子树所有节点。递归函数的返回值为bool类型,传入参数为根节点。如果根节点为空,那么返回true,因为空树是满足所有类型的树的条件的。

(2)定义maxvalue,初始化为最小值。这样在第一次比较时,中间节点一定比maxvalue小,完成maxvalue的第一次更新,便于后续递归。

(3)首先向左去递归遍历,然后中间节点比较和maxvalue的大小,如果中间节点大于maxvalue,那么更新maxvalue的值为当前中间节点的值,如果中间节点小于等于maxvalue,那么直接返回false,说明并不是左子树的所有节点都小于中间节点。最后递归遍历右子树。

(4)最后如果左右遍历均满足条件则返回true。

# Definition for a binary tree node.
# class TreeNode:
#     def __init__(self, val=0, left=None, right=None):
#         self.val = val
#         self.left = left
#         self.right = right
class Solution:
    def __init__(self):
        self.max_value = float('-inf')

    def isValidBST(self, root: Optional[TreeNode]) -> bool:
        if not root:
            return True
        left = self.isValidBST(root.left)
        if self.max_value < root.val:
            self.max_value = root.val
        else:
            return False
        right = self.isValidBST(root.right)
        return left and right
听故事学语言 · 数据结构篇 · 第六章 栈,后进先出的盒子 数据结构篇第六章,栈。二进制短除法余数为什么要倒着读,谜底是栈;括号匹配先让计数器上场,([)] 一串让它当场折戟,混括号必须栈;逆波兰记法,1924 年卢卡谢维奇发明波兰记法,1957 年汉布林把它倒过来;一件学生时代的四则运算器文物,带着一颗时发时不发的雷,当年调了很久怎么也跑不对,病没变,变的是它发不发作;双栈直接求值与随机表达式对数器一千组零不合;最小栈一步报最小,接雨水单调栈一层一层结算;汉诺塔的调用栈真身,V 字图退役;火车进出站十四种可能,卡塔兰数;链栈与共享栈收章。 阅读详情

相关推荐

VS2022 LNK1168无法打开进行写入 解决办法

C语言编程---VS---错误和警告---链接器工具错误---LNK1168--无法打开进行写入

weixin_67166415的博客 7161

代码随想录算法训练营day17(python版)|第六章 二叉树 part05|654.最大二叉树·617.合并二叉树·700.二叉搜索树中的搜索·98.验证二叉搜索树

654.最大二叉树又是构造二叉树,昨天大家刚刚做完 中序后序确定二叉树,今天做这个 应该会容易一些, 先看视频,好好体会一下 为什么构造二叉树都是 前序遍历。

qq_43752779的博客 997

Windows系统下Mamba环境配置实战:从零到编译成功

本文详细记录了在Windows系统下从零开始配置Mamba深度学习环境的完整实战过程。针对官方不直接支持Windows的难点,文章提供了关键解决方案,包括安装特定版本的Python、PyTorch与第三方Triton,以及修改源码以解决Windows编译器的兼容性问题,最终成功编译并运行Mamba-SSM。

weixin_28842269的博客 500

算法训练营DAY17 第六章 二叉树part05

(举一个例子,当当前节点遍历到最左边的节点,把最左边的节点赋予pre,下一步当前节点会去到pre的根节点,这时候比较当前节点与下方的pre节点,如果当前节点root比下方的pre小,那么就返回false;再下一步将这个根节点赋予pre,当前节点去到右节点,右节点(当前节点)比上方的pre小,返回false;再下一步右节点赋予pre,当前节点去到根节点的根节点,继续比较.....如果传入数组的大小为1,那说明传入的是叶子节点,需要定义一个新节点,将数组中的数值赋予这个节点。3)右边的数组作为右子树的数组。

2401_89133587的博客 493

MMDetection框架入门教程(完全版)

  网上MMDetection的教程看似有很多,但感觉都不成系统,看完一圈下来还是不知道MMDetection要怎么用。这里还是推荐直接跟着官方教程,结合源码学习MMDetection,相关链接汇总如下: 官方教程 - MMCV 官方教程 - MMDetection 官方教程 - 不得不知的 MMDetection 学习路线(个人经验版) 西安交大课件 - mmdetection教程(使用篇)   本文会介绍如何在MMDetection中从头开始搭建一套属于自己的算法。前几篇博客算是本人学习过...

Sual 10万+

软考高级系统架构设计师系列论文四十九:论微服务架构及其应用

软考高级系统架构设计师系列论文四十九:论微服务架构及其应用

zhengzaifeidelushang的博客 3194

代码随想录算法训练营DAY17第六章 二叉树 part05

【代码】代码随想录算法训练营DAY17第六章 二叉树 part05。

2401_88089822的博客 86

1篇1章4节:生成对抗网络GAN和图像生成领域的StyleGAN

AI图像生成技术的革命性突破:从GAN到StyleGAN 近年来,人工智能在图像生成领域取得显著进展,尤其是生成对抗网络(GAN)的发展推动了技术的飞跃。从早期的基础GAN到渐进式GAN(Progressive GAN),再到革命性的StyleGAN,AI生成图像的逼真度已接近人类创作水平。StyleGAN通过引入风格潜向量和自适应实例归一化,实现了对图像风格与内容的精细控制,广泛应用于人脸生成、艺术创作及影视行业。后续的StyleGAN2解决了“斑点”问题,StyleGAN3进一步优化纹理过渡,提升了图像

MD Code 218

【数据结构-5】单链表的实现

单链表,具体来说是单向的、不带头的、不循环的链表。链表由一个一个节点组成,每个节点分为数据域和指针域,数据域存放数据,指针域存放下一节点的地址。这样,就可以根据指针域中的地址找到下一个节点,节点就串起来了构成了单链表。

weixin_44218929的博客 187

【实战圣经】YOLOv8-pose姿态估计模型从训练到RK3588部署:让边缘端骨骼识别速度突破60FPS

本教程从“模型训练-转换-边缘部署”全链路拆解了YOLOv8-pose姿态估计方案在RK3588上的落地过程,每一步都经过实战验证。无论是智能健身的动作实时纠正,还是工业设备的关键部件姿态检测,这套流程都能让你以最低成本实现高精度、高实时性的姿态估计应用。如果你在实践中遇到模型转换报错、部署性能不达标等问题,可聚焦某一环节深入优化——毕竟,让AI在边缘端“精准捕捉每一个关键点”,才是技术驱动场景创新的核心。

m0_71589036的博客 251

CAPL通过lookupSignal和DBLookup获取DBC信号的属性信息

CAPL通过lookupSignal和DBLookup获取DBC信号的属性信息以及一些相关问题

天赐好车的博客 2889

pandas 深度入门:从数据结构到一份真实销售报表

本文系统讲解Pandas核心应用,从三分钟安装到完整月度报表生成,涵盖数据读取、清洗、筛选、分组聚合、表连接、透视表与时间序列等13个关键环节。强调“先看数据再动手”,掌握Series/DataFrame/Index结构本质,熟练运用loc/iloc、merge校验、agg/transform区别,通过真实案例实现高效报表自动化,告别手动Excel操作。最后提供性能优化与高频报错解决方案,助力读者快速上手,真正实现“写二十行代码,跑三秒出结果”。

信息安全领域优质创作者|操作系统领域专家 281

全网首发--Unet3+改进16:在不同位置添加RepLKBlock超大卷积核

本文提出了一种基于大核卷积的神经网络架构RepLKNet,旨在缩小CNN与ViTs之间的性能差距。通过重新审视CNN中的大核设计,研究证明使用少量大卷积核替代多个小核能获得更强大的性能。提出的RepLKNet采用31×31大卷积核,在ImageNet和下游任务上取得了与SwinTransformer相当或更好的结果,同时具有更低延迟。文章详细介绍了实现步骤:(1)创建RepLKBlock模块文件;(2)在模型层中添加注意力机制;(3)在UNet模型中集成RepLKBlock;(4)完成训练流程。该方法展现了

AIcurator的博客 621

数据结构的基本概念和算法的初步认识

本文系统阐述数据结构与算法的基础概念,涵盖数据、数据元素、数据对象的层次关系,数据结构的三要素(逻辑结构、存储结构、数据运算),以及抽象数据类型。重点解析算法的特性与设计要求,并深入讲解时间复杂度分析的核心——大O表示法,通过“只保留最高阶项、忽略常数系数、取最坏情况”三大原则,结合实例剖析O(1)、O(n)等常见时间复杂度,揭示算法效率的本质评估方法。

ACH_YYX的博客 188

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

数据结构:9.Map和Set

有的讲解会说这里key是标识作用,这种说法其实没有太大意义,就算知道了他是标识value的作用又如何,在实际的使用过程中,我们只会根据具体的效果选择使用的方法等,不会执着于“标识”这种说法。2.由于哈希函数的设计原则太过理论,它仅仅是在认为:这些通过关键码算出来的index不同 的情况下设计的,然而这种理论化的设计原则在遇到冲突时,恰恰就出现了问题,而我们能做的,就是降低冲突率。虽然哈希表的使用过程中存在冲突,但是在实际的使用过程中,哈希表的冲突率是不高的,冲突的个数是可控的。

2602_95646088的博客 201

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Vue3 低代码移动表单设计器实战(二):缩放画布下的拖拽系统与树状级联数据结构

本文深入剖析Vue3低代码表单设计器在缩放画布下的拖拽失效问题,揭示SortableJS在CSS Transform下坐标崩溃的数学根源。通过自研独立视觉克隆壳层与逆向几何补偿算法,实现精准拖拽;采用扁平数据存储+运行时树状计算结构,解决级联依赖与深克隆难题,确保逻辑一致性与性能优化,为复杂低代码系统提供可复用的工程范式。

NanChen的博客 343

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

排序算法深度笔记(上):比较类排序的思想演进与代码实现

与。本文聚焦前者 —— 也就是通过元素间两两比较来确定相对顺序的排序算法,从最朴素的 O (n²) 基础排序,到工业级主流的 O (nlogn) 进阶排序,逐层拆解设计思想、带注释的代码实现与边界细节。当我们理解了比较排序的性能边界,也就自然引出了非比较排序的存在意义。所有代码均遵循统一的实现规范:入口函数前置空数组与单元素边界校验,基于数组原地修改,主函数附带可直接运行的测试用例,与练习代码风格完全对齐。

2401_87069538的博客 611

CF2283F[数据结构]

首先考虑一种暴力解法,当我们建好i之前的图后,当我们添加i的时候,区间[li,ri]中的点都会向i建边,但是这些点中,如果有某两个顶点l,r,满足l<r,那么l就可以通过r间接到达i,因此可以删除l到i的边;初始时我们令所有点放入set中,然后对于每一个i的处理,我们将集合中仍在[l,r]的范围的点弹出,并且将f设置为i,这样我们就得到了所有点的最小跳板;对于每个区间[l,r] 我们要计算这下下标中的f(v)中大于r的数目有多少个;我们令f(v)表示顶点v可到达的最小的顶点;

蒟蒻 138

笔记-论数据结构2

typedef 数据类型 别名return 0;typedef也经常用在结构体上:每次声明结构体变量都要写struct关键字,很麻烦,而且逻辑上也很难受,typedef可以解决这个问题。int x;int y;p.x = 5;p.y = 10;return 0;而利用typedef解决有两种解法:typedef struct 结构体名数据类型 变量名;数据类型 变量名;……}别名;数据类型 变量名;数据类型 变量名;……}别名;实际的运用int x;

fish_zzzz的博客 111

【数据结构-3】算法美学之降复杂度

在while循环的循环体内,首先用临时变量保存最后一个位置的数据,再通过for循环把所有元素往后移动一位,最后把tmp中保存的值放到下标为0的位置上去。方法二的思路是:创建新数组,让原数组中后k个数据移动到新数组中前面的位置,让原数组中前numsSize-k个数据移动到新数组中后面的位置,这。这段代码的思路是:三次逆置,第一次逆置前numsSize-k个数据,第二次逆置后k个数据,最后整体逆置。这篇博文分享一道解法不一的算法题,求解过程的目的在于降低算法的时间复杂度,题源力扣。,属于空间换时间的操作。

weixin_44218929的博客 85

【数据结构-2】顺序表的实现

线性表是一种数据结构,它分为逻辑结构和物理结构,在逻辑结构上线性表是呈线性的,数据是是连续存储的;在物理结构(物理空间)上,线性表不一定是连续存储的。线性表的实现,主要分为数组和链式结构。顺序表是线性表的一种实现方式,顺序表在逻辑结构和物理结构上都是连续的。顺序表的底层实现是数组。

weixin_44218929的博客 208

数据结构:排序

将一组无序的记录(数据元素),按照某个关键字(key)递增或递减的顺序重新排列。

2502_92937908的博客 467

Python 开发的实践:从数据结构选型到框架决策

规模多大?决定用list还是set,Pandas 还是 Polars。瓶颈在哪?I/O 密集用异步,CPU 密集用进程/自由线程,内存受限用列式与惰性执行。代价是什么?消除手动维护窗口的出错面,TaskGroup消除失败任务不被取消的泄漏,消除 N+1,Protocol消除为类型约束而引入的继承层级——每个选择都在消除某类代价,同时也引入新的约束。能回答这三个问题,比记住更多 API 更有用。愿你我都能在各自的领域里不断成长,勇敢追求梦想,同时也保持对世界的好奇与善意!

weixin_45809780的博客 379

头歌 数据结构——C&C++线性表实训

本系列任务围绕线性表的链式实现,依次完成顺序构建、逆序构建、排序插入、查找、删除、求长度及栈、队列、集合等应用。通过动态内存分配与指针操作,掌握单链表的基本操作与实际应用,涵盖插入、删除、遍历、搜索等核心功能,最终实现数据结构在典型场景中的灵活运用。

一名敲代码的苦13程序员 238

CDGA DMBOK 第5章——数据建模和设计:如何将业务需求转化为规范的数据结构

本章系统阐述数据建模与设计的核心方法,强调将业务需求转化为规范数据结构的全过程。重点涵盖数据模型三层次(概念、逻辑、物理)、实体关系模型(ER)及主键、外键等核心要素,深入解析第一至第三范式,阐明规范化在消除冗余、保障数据一致性的关键作用,并介绍反规范化在性能优化中的合理应用。通过“概念看业务、逻辑看结构、物理看实现”的逻辑框架,实现从需求到数据库落地的完整闭环。

积跬步,慕至千里的博客 307

数据结构第三课:单链表与双向链表

单链表是基于结点的非连续存储结构,由数据域和指针域组成,逻辑上连续但物理上可不连续。其核心优势在于动态增删高效,适合频繁插入删除场景;相较顺序表,虽有指针开销且访问需遍历,但灵活性更高。常见算法包括反转、中间节点查找、合并有序链表及环检测等。双向链表通过前后指针提升操作效率,实际应用中常采用带头循环双向链表结构。

2503_93549121的博客 206
上一篇: 代码随想录 Day 16 | 【第六章 二叉树】找树左下角的值、路径总和、从中序与后序遍历序列构造二叉树
下一篇: 代码随想录 Day 18 | 【第六章 二叉树 part06】530.二叉搜索树的最小绝对差、501.二叉搜索树中的众数、236. 二叉树的最近公共祖先
Accept17
博客等级 码龄4年 479粉丝 43原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值