


CIFAR10数据集的介绍
CIFAR-10数据集是一个平衡的数据集,这意味着每个类别的样本数量是相同的。CIFAR-10包含10个类别,每个类别有6000张图像,整个数据集共有60000张图像。其中50000张用于训练,10000张用于测试。训练集和测试集也是平衡的,即每个类别在训练集中有5000张图像,在测试集中有1000张图像。
其他介绍:
两种方法制作数据不平衡
在处理分类问题时,尤其是在现实世界的数据集中,数据不平衡是一个常见的问题。不同类别的样本数量可能差异很大,这对模型的训练和性能评估都是一个挑战。为了模拟这种现象并测试模型在不同不平衡条件下的表现,可以创建人工的不平衡数据集。在提供的代码中,使用了两种方法来制造数据不平衡:指数(exp)和步进(step)。下面详细解释这两种不平衡类型:
指数型不平衡(Exponential Imbalance - "exp")
- 原理:在指数型不平衡中,类别的样本数按照指数函数递减。这意味着一些类别的样本数会非常多,而其他类别的样本数则逐渐减少,最少的类别可能只有很少的样本。
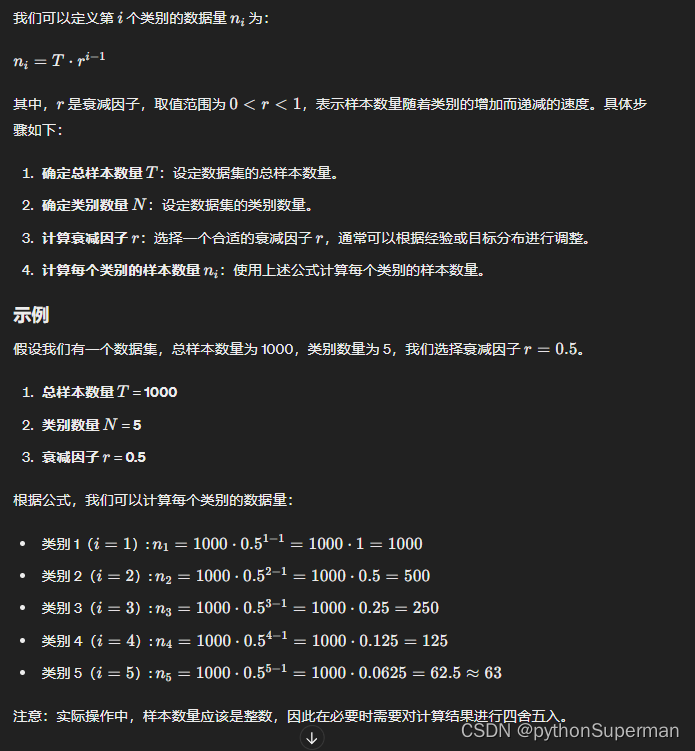
- 效果:导致类别间的样本数量差异非常大,对模型的泛化能力和对少数类的识别能力提出了挑战。
exp指数分布不平衡
长尾不平衡(long-tailed imbalance)指的是数据集中存在极端不平衡的情况,即某些类别的样本数量远远少于其他类别。这种情况通常表现为数据集中有少数类别的样本量较少,而大多数样本集中在另外一些类别上。
意思是几个主导类占据大多数例子,而大多数其他的类只有着相对较少的例子
定义:在指数分布不平衡中,数据集的样本数量按照指数规律逐渐减少。这意味着从最多样本的类别到最少样本的类别,样本数量以指数形式递减。
特点:
- 长尾效应:少数类别有大量样本,而多数类别只有极少数样本。这种分布往往导致模型更偏向于学习样本数量较多的类别,而忽略样本较少的类别。
- 实例:假设一个数据集有10个类别,样本数量分别为1000, 500, 250, 125, 60, 30, 15, 8, 4, 2。这就是一个典型的指数分布不平衡。
步进型不平衡(Step Imbalance - "step")
- 原理:在步进型不平衡中,将类别分为两组,一组具有较多的样本,另一组具有较少的样本。这通常是通过直接设置一半类别具有最大样本数,而另一半类别的样本数显著减少来实现。
- 计算方法:前半部分的类别(
cls_num // 2)设置为最大样本数img_max,后半部分的类别设置为img_max乘以不平衡因子imb_factor(一个小于1的值)。 - 效果:这种设置创建了一个明显的分界线,一半的类别是"多数类",另一半是"少数类"。这种不平衡类型对于测试模型在处理极端类别不平衡情况下的性能尤其有用。
step阶梯分布不平衡
-
阶梯不平衡(step imbalance)可能是指数据集中存在类别间数量差距较大,但并不是像长尾不平衡那样极端不平衡的情况。相比于长尾不平衡,阶梯不平衡可能是更均衡但仍存在类别不平衡的情况,其中某些类别的样本数量明显多于其他类别,但不像长尾不平衡那样数量悬殊。
- 分段明显:类别样本数量在不同的分段之间有明显的跳跃。例如,从一个分段到下一个分段,样本数量会骤减。
- 实例:假设一个数据集有10个类别,样本数量分别为1000, 1000, 1000, 100, 100, 100, 10, 10, 10, 10。这就是一个典型的阶梯分布不平衡。
应用意义
这两种不平衡类型的设置使研究人员可以详细探索和评估分类模型在面对不同程度和类型的类别不平衡时的表现。这对于优化模型结构和学习策略,以及在特定应用中选择合适的处理方法都非常重要。例如,在医疗图像分析、欺诈检测、文本分类等领域,类别不平衡是一个常见且棘手的问题,有效的处理策略对于提高模型的实用性至关重要。
Imbalance代码理解
import torch
import torchvision
import torchvision.transforms as transforms
import numpy as np
import torchvision.datasets as datasets

class IMBALANCECIFAR10(torchvision.datasets.CIFAR10):
    cls_num = 10

    def __init__(self, root, imb_type='exp', imb_factor=0.01, rand_number=0, train=True,
                 transform=None, target_transform=None,
                 download=False):
        super(IMBALANCECIFAR10, self).__init__(root, train, transform, target_transform, download)
        np.random.seed(rand_number)
        img_num_list = self.get_img_num_per_cls(self.cls_num, imb_type, imb_factor) # 生成每个类别的样本数量列表。
        print("Generated Image Number List:", img_num_list)
        self.gen_imbalanced_data(img_num_list) # 调用 gen_imbalanced_data 方法,生成不平衡数据集。
        print("Imbalanced Data Generated.")

    def get_img_num_per_cls(self, cls_num, imb_type, imb_factor):
        img_max = len(self.data) / cls_num
        img_num_per_cls = []
        if imb_type == 'exp':
            for cls_idx in range(cls_num):
                num = img_max * (imb_factor**(cls_idx / (cls_num - 1.0)))
                img_num_per_cls.append(int(num))
        elif imb_type == 'step':
            for cls_idx in range(cls_num // 2):
                img_num_per_cls.append(int(img_max))
            for cls_idx in range(cls_num // 2):
                img_num_per_cls.append(int(img_max * imb_factor))
        else:
            img_num_per_cls.extend([int(img_max)] * cls_num)
        return img_num_per_cls

    def gen_imbalanced_data(self, img_num_per_cls):
        new_data = []
        new_targets = []
        targets_np = np.array(self.targets, dtype=np.int64)
        classes = np.unique(targets_np)

        self.num_per_cls_dict = dict()
        for the_class, the_img_num in zip(classes, img_num_per_cls):
            self.num_per_cls_dict[the_class] = the_img_num
            idx = np.where(targets_np == the_class)[0] # 找到所有属于当前类别的样本的索引,并存储在 idx 中。
            np.random.shuffle(idx) # 随机打乱当前类别的样本索引顺序,以确保样本的随机性。
            selec_idx = idx[:the_img_num]  # 从当前类别的样本索引中选择前 the_img_num 个索引,即根据不平衡设定的数量,选择少数类别的样本。
            new_data.append(self.data[selec_idx, ...]) #
            new_targets.extend([the_class, ] * the_img_num) #将当前类别的标签复制 the_img_num 次,并将复制的标签添加到新标签列表 new_targets 中,确保标签与样本数据对应。
        new_data = np.vstack(new_data)
        self.data = new_data
        self.targets = new_targets

    def get_cls_num_list(self):
        cls_num_list = []
        for i in range(self.cls_num):
            cls_num_list.append(self.num_per_cls_dict[i])
        return cls_num_list

transform_val = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010)),
])
# Example usage:
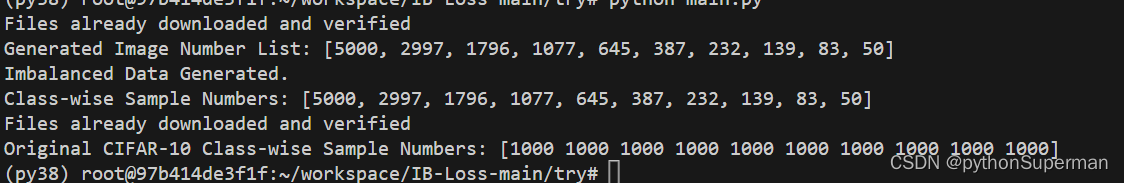
imbalance_cifar10 = IMBALANCECIFAR10(root='../data', imb_type='exp', imb_factor=0.01, rand_number=0, train=True, download=True)

print("Class-wise Sample Numbers:", imbalance_cifar10.get_cls_num_list())

val_dataset = datasets.CIFAR10(root='../data', train=False, download=True,transform=transform_val)
original_targets = np.array(val_dataset.targets)
original_class_counts = np.bincount(original_targets)
print("Original CIFAR-10 Class-wise Sample Numbers:", original_class_counts)
Cifar10Imbanlance代码理解
import torchvision
import random
from torch.utils.data import Dataset, DataLoader
import numpy as np
from PIL import Image

class Cifar10Imbanlance(Dataset):
    def __init__(self, imbanlance_rate, num_cls=10, file_path="data/",
                 train=True, transform=None, label_align=True, ):
        self.transform = transform
        self.label_align = label_align
        assert 0.0 < imbanlance_rate < 1, "imbanlance_rate must 0.0 < imbanlance_rate < 1"
        self.imbanlance_rate = imbanlance_rate

        self.num_cls = num_cls
        self.data = self.produce_imbanlance_data(file_path=file_path, train=train,imbanlance_rate=self.imbanlance_rate)
        self.x = self.data['x']
        self.targets = self.data['y'].tolist()
        self.y = self.data['y'].tolist()

    def __len__(self):
        return len(self.x)

    def __getitem__(self, item):
        x, y = self.x[item], self.y[item]
        x = Image.fromarray(x)
        if self.transform is not None:
            x = self.transform(x)
        return x, y

    def get_per_class_num(self):
        return self.class_list

    def produce_imbanlance_data(self, imbanlance_rate, file_path="/data", train=True):

        train_data = torchvision.datasets.CIFAR10(
            root=file_path,
            train=train,
            download=True,
        )
        x_train = train_data.data
        y_train = train_data.targets
        y_train = np.array(y_train)

        rehearsal_data = None
        rehearsal_label = None

        data_percent = []
        data_num = int(x_train.shape[0] / self.num_cls)

        for cls_idx in range(self.num_cls):
            if train:
                num = data_num * (imbanlance_rate ** (cls_idx / (self.num_cls - 1)))
                data_percent.append(int(num))
            else:
                num = data_num
                data_percent.append(int(num))
        if train:
            print("imbanlance_ration is {}".format(data_percent[0] / data_percent[-1]))
            print("per class num: {}".format(data_percent))

        self.class_list = data_percent


        for i in range(1, self.num_cls + 1):
            a1 = y_train >= i - 1
            a2 = y_train < i
            index = a1 & a2
            task_train_x = x_train[index]
            label = y_train[index]
            data_num = task_train_x.shape[0]
            index = np.random.choice(data_num, data_percent[i - 1],replace=False)
            tem_data = task_train_x[index]
            tem_label = label[index]
            if rehearsal_data is None:
                rehearsal_data = tem_data
                rehearsal_label = tem_label
            else:
                rehearsal_data = np.concatenate([rehearsal_data, tem_data], axis=0)
                rehearsal_label = np.concatenate([rehearsal_label, tem_label], axis=0)

        task_split = {
            "x": rehearsal_data,
            "y": rehearsal_label,
        }
        return task_split

 358


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


