重学Perfetto浏览器在线抓取trace及高频sql分享

一次实时数据链路丢数排查:从 MQTT 队列积压到 SQL 统计开销 本文通过一次实时数据链路压测,排查了从MQTT到ClickHouse的端到端数据丢失问题。核心方法是为每条消息添加序号,建立独立观察点(MQTT订阅端、Kafka消费者),结合转发服务阶段统计与线程栈分析,定位到下游处理速度不足源于Druid SQL合并统计的高开销。优化措施包括关闭SQL合并、扩容代理队列、增强生产侧失败处理,并验证15分钟内实现全链路对账一致,显著缓解积压与丢包。关键收获:数据可对账、明确各阶段“成功”定义、关注客户端队列状态。 阅读详情

背景

在性能优化中perfetto抓取的方式相对比较多,今天来介绍一下直接使用perfetto网页在chrome浏览器直接抓取方式
在这里插入图片描述同时也对一些日常分析Perfetto时候高频使用的一些sql进行整理输出。

如何chrome网页上直接抓取?**

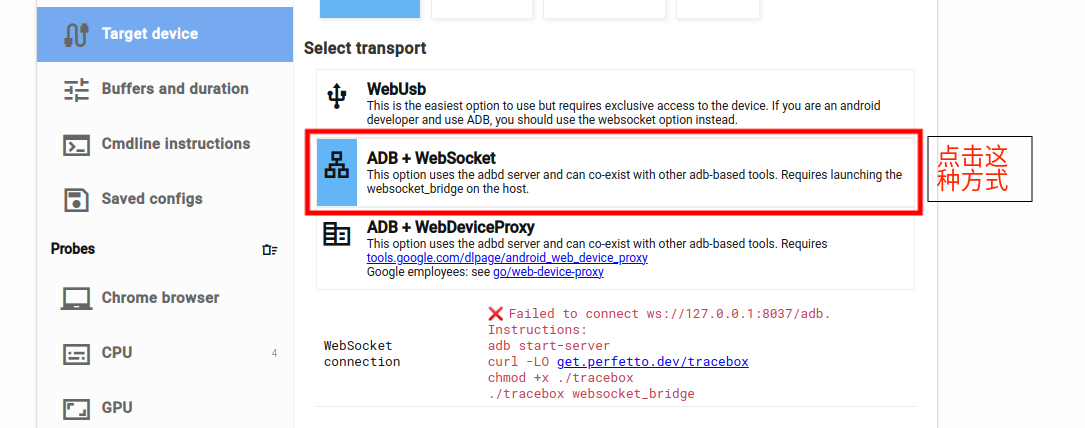
因为用WebUsb方式无法发现自编译aosp模拟器的设备,所以通用一点方法,我们选着adb+websocket方式:
在这里插入图片描述
点击这种“ADB + WebSocket”方式后,发现有一堆错误提示,无法链接发现设备。
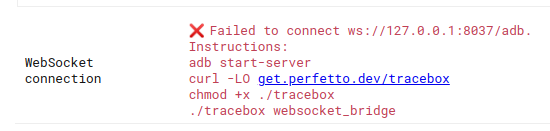
在这里插入图片描述
建议我们操作如下几步:

adb start-server
curl -LO get.perfetto.dev/tracebox
chmod +x ./tracebox
./tracebox websocket_bridge

上面其实看出,本质上就是下载个tracebox文件,然后执行这个tracebox文件既可以,但是下载这个tracebox文件一般国内网络都不行哈,所以这里可能又会阻碍一批人,不过这里马哥给大家提供一个 ubuntu 64位可以直接执行的文件

https://share.weiyun.com/djrDvGWU 密码:1q95lf
然后运行如下:

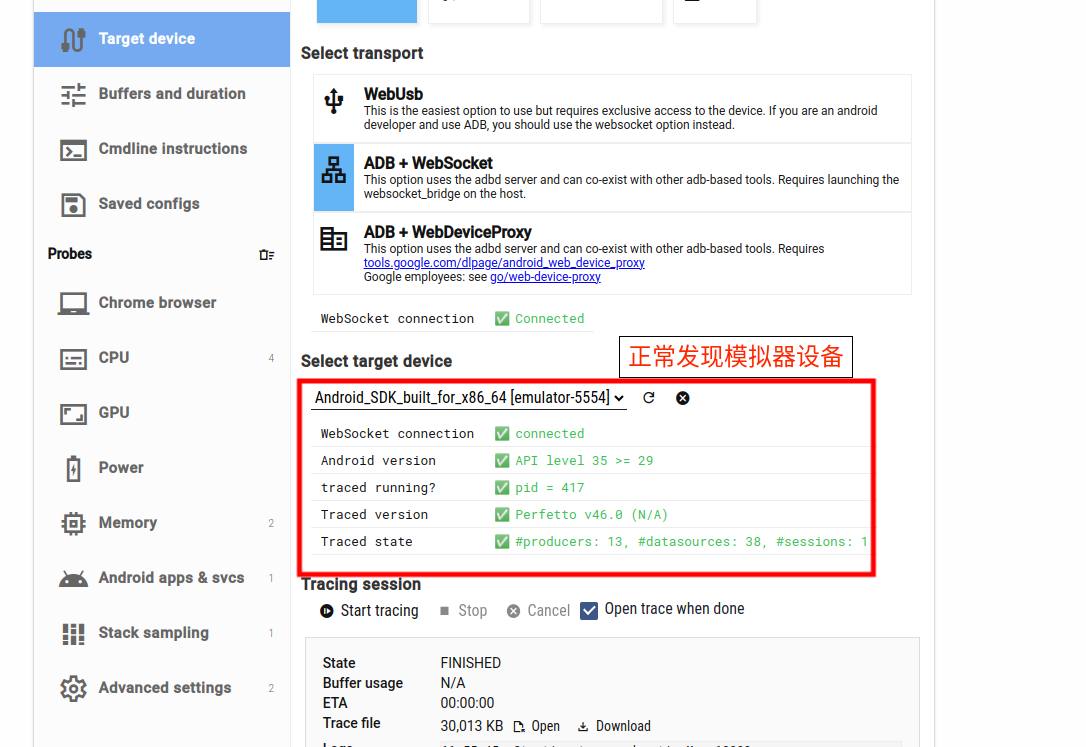
在这里插入图片描述这里刷新一些画面就可以看到我们的模拟器设备了,可以进行正常抓取了
在这里插入图片描述

抓取Perfetto数据如何保存本地?

在chrome网页抓取到相关的trace文件后,网页可以直接查看,也可以左上角看到文件名字,但是这个画面没有看到可以保存这个文件按钮。

因为抓的trace完全有可能要保存下来,或者等待下次再来分析,发送其他同学分析等,那么到底在哪里进行保存呢?
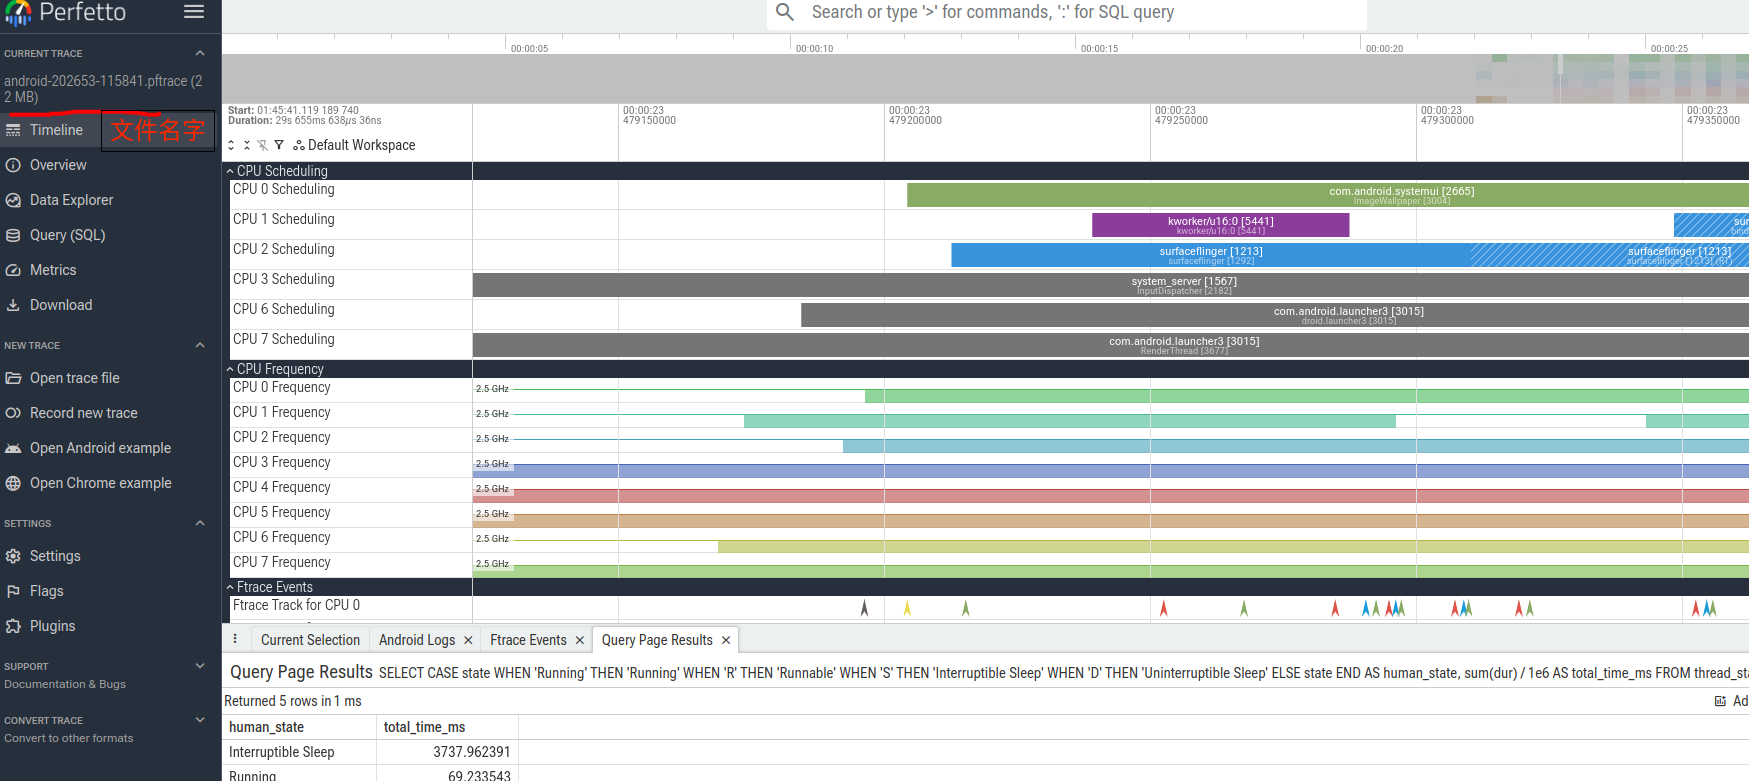
在这里插入图片描述
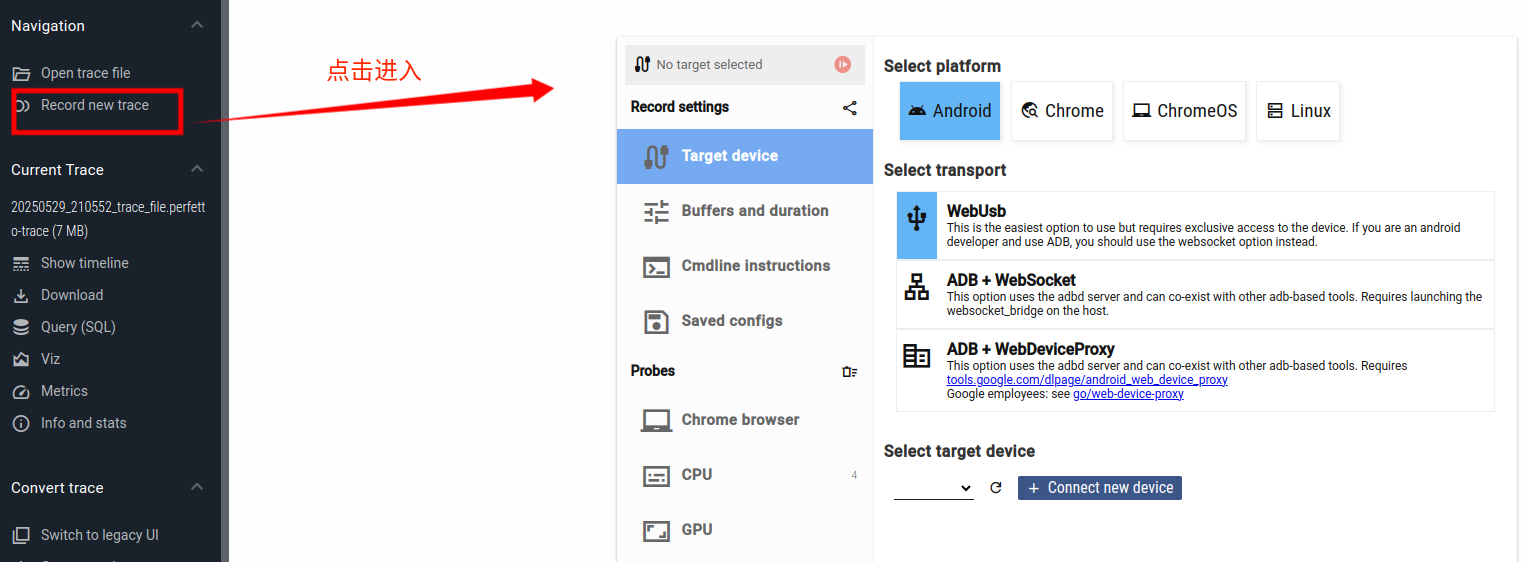
点击左侧的“Record new trace”,然后点击Download既可以保存到本地
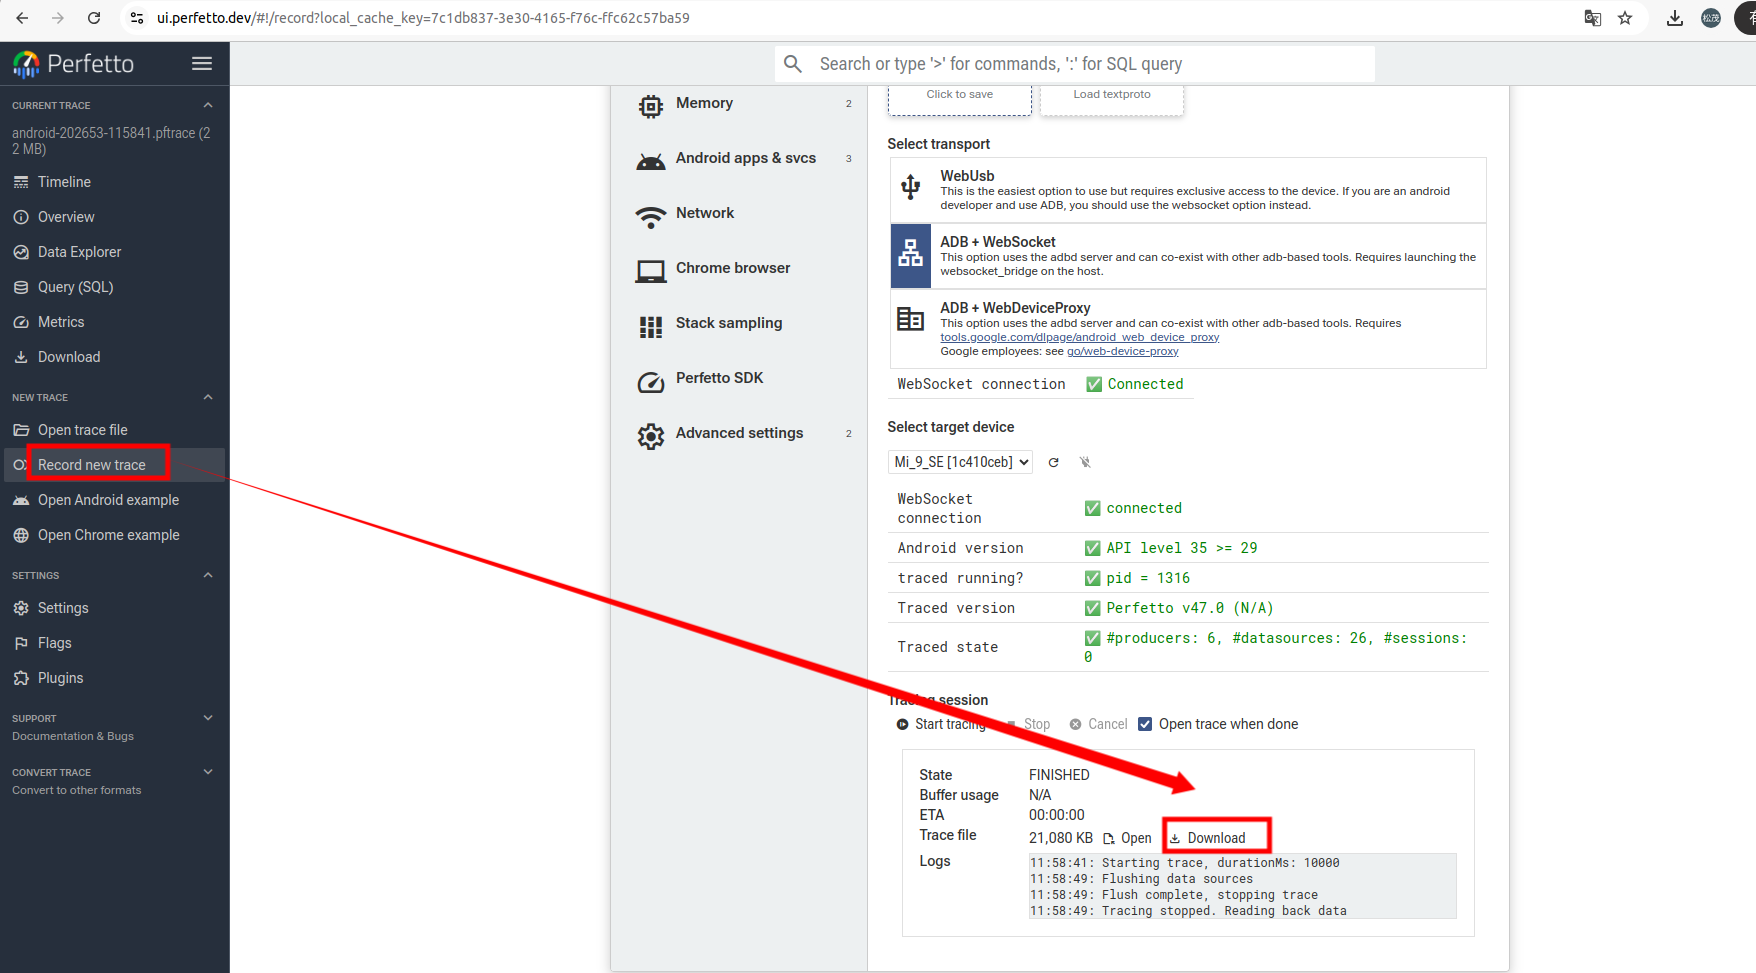
在这里插入图片描述

Pefetto量化分析常用的一些SQL分享

使用 SQL 进行量化分析
在这里插入图片描述
点击左边的Query既可以。

Perfetto 内置的 SQL 查询引擎是其强大功能之一,允许开发者对 Trace 数据进行精确的聚合、筛选和分析。以下是一些常用的 CPU 分析查询。

大家可能会有疑问?为啥一定要sql进行查询量化分析,直接看Perfetto分析不就好了么?
核心原因如下:
Perfetto直接看slice这种方式前提是Perfetto的项目时长都是比较有限,而且你已经有很明确的分析位置,很容易寻找到具体某个时间段瓶颈。
但是在实际性能优化中,你看要分析问题可能是一个时间段内的,比如某个线程的调度延时等,这种你抓某个时间点的就没有意义,必须要进行统计量化才可以减少方差波动等。

1. 计算各进程的 CPU 总时长

此查询统计每个进程在所有 CPU 上运行的总时长,按降序排列,用于快速定位消耗 CPU 资源最多的进程。

SELECT
  process.name,
  sum(dur) / 1e9 AS total_cpu_time_s
FROM sched
JOIN thread ON sched.utid = thread.utid
JOIN process ON thread.upid = process.upid
GROUP BY process.name
ORDER BY total_cpu_time_s DESC;

结果
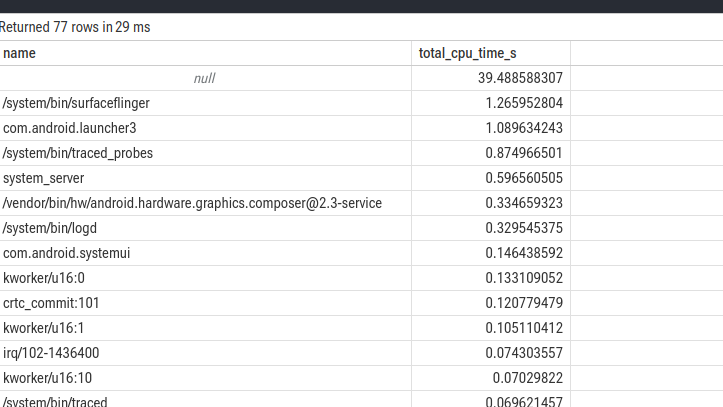
在这里插入图片描述

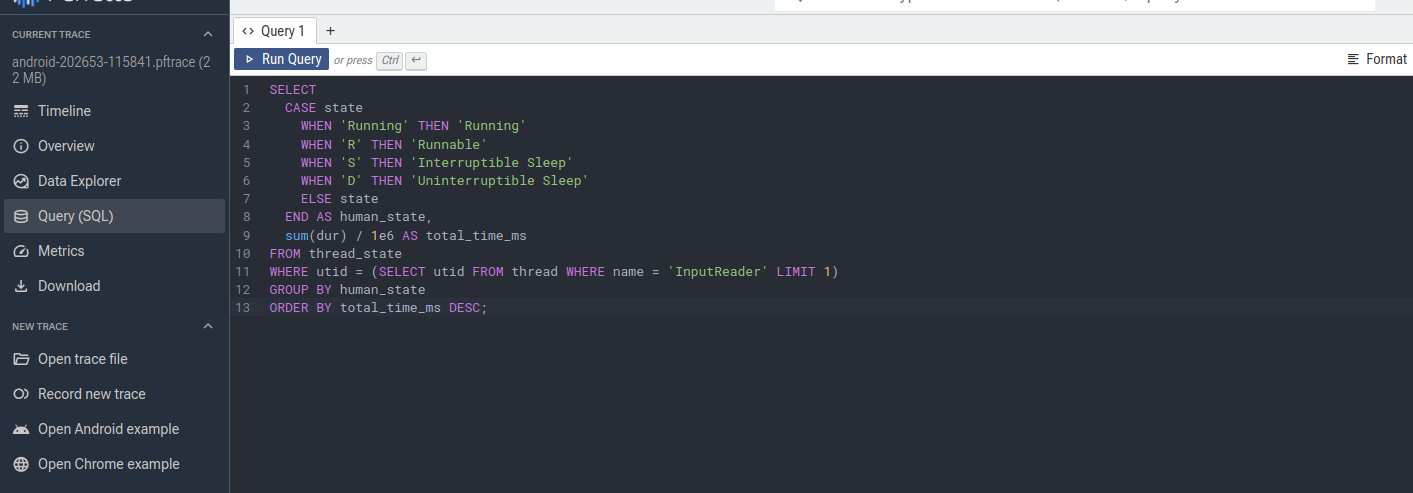
2. 分析单个线程的时间状态分布

此查询基于 thread_state 表,可用于分析特定线程(示例为 InputReader)在各种状态下的时间分布,从而判断其主要瓶颈。

SELECT
  CASE state
    WHEN 'Running' THEN 'Running'
    WHEN 'R' THEN 'Runnable'
    WHEN 'S' THEN 'Interruptible Sleep'
    WHEN 'D' THEN 'Uninterruptible Sleep'
    ELSE state
  END AS human_state,
  sum(dur) / 1e6 AS total_time_ms
FROM thread_state
WHERE utid = (SELECT utid FROM thread WHERE name = 'InputReader' LIMIT 1)
GROUP BY human_state
ORDER BY total_time_ms DESC;
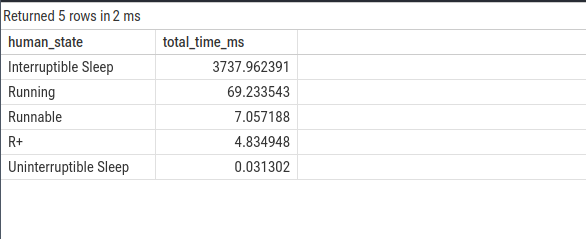
在这里插入图片描述

3. 查找特定时间段内 CPU 消耗最高的线程

此查询用于分析特定场景(如应用启动的 2-5s 时间段)中,消耗 CPU 时间最长的线程。

SELECT
  thread.name,
  sum(dur) / 1e9 AS cpu_time_s
FROM sched
JOIN thread ON sched.utid = thread.utid
-- 时间戳单位为纳秒,可以自己加上 WHERE ts > 2e9 AND ts < 5e9 来取某一段时间
GROUP BY thread.name
ORDER BY cpu_time_s DESC
LIMIT 20;
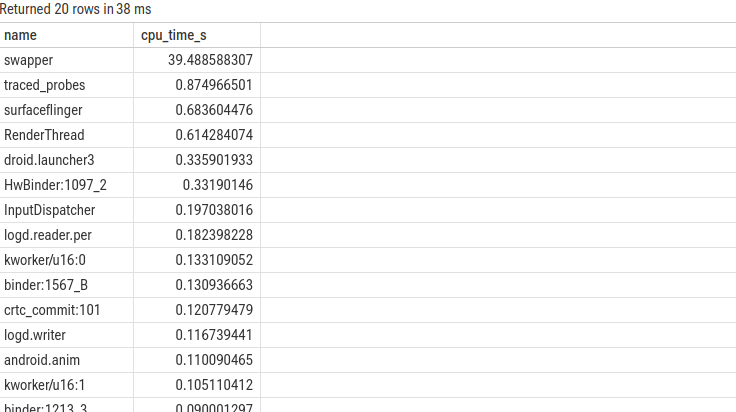
在这里插入图片描述

4. 查看线程在各 CPU 核心上的运行时间分布

此查询有助于了解一个线程的 CPU 亲和性,以及它是否在预期的大小核上运行。

SELECT
  cpu,
  sum(dur) / 1e6 AS time_on_cpu_ms
FROM sched
WHERE utid = (SELECT utid FROM thread WHERE name = 'InputReader' LIMIT 1)
GROUP BY cpu
ORDER BY cpu;

可以看出大部分时间在cpu0-1运行
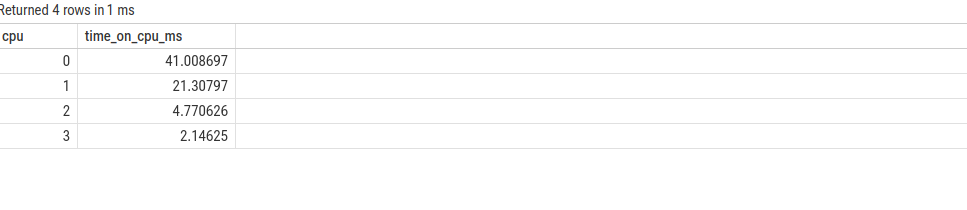
在这里插入图片描述

更多fw实战开发干货,原文地址:
https://mp.weixin.qq.com/s/N4esN731NXNbedCL5BM1dw

华为防火墙USG6000V---内网访问外网---外网访问内网服务器(NAT服务器)示例配置 华为防火墙USG6000V示例配置,展示了访问防火墙、内网服务器、外网和外网访问内网服务器(NAT服务器)的配置。 阅读详情

相关推荐

在 CentOS Stream 10 上搭建 Kubernetes 集群并支持开发调试与日志查看

搭建 Kubernetes 集群的每个步骤详细的文档。

灵犀物润 1644

SQL并行执行的机制解析与计划调控实践

并行执行是大数据量场景的核心提速手段,但用错代价极高。本文从问题边界讲起,梳理并行度的确定层级、优化器生成并行计划的逻辑、数据再分布与通信代价、倾斜成因与识别方法,覆盖表设计、索引策略、并行DML、RAC调度与参数取舍,配合三个真实失败案例与诊断步骤,给出一套可落地的并行治理流程与误区清单。

搞定过:百亿级数据、万级QPS、零宕机、AI工业化。 778

Aspose Java 25.10 版本深度破解:基于字节码修改的实战指南

本文提供了Aspose Java 25.10版本基于字节码修改的实战指南。详细介绍了如何通过Javassist工具逆向分析并修改Aspose Cells、Words、Slides及PDF组件的许可证验证逻辑,从而实现绕过限制,并完成最终的打包与功能验证。

stone的博客 1358

Flink SQL 连接器实战:MySQL Source、Flink CDC 与 JDBC Sink 全解析

提供有界流读取,适合批处理和维表场景,简单直接但无法感知变更。MySQL CDC提供无界流读取,通过「全量快照 + binlog 增量」的方式实现实时捕获,是实时数仓的核心入口,但需要 MySQL 侧正确配置 binlog 和权限。JDBC Sink负责结果回写,关键在于区分仅插入流和更新流,更新流必须依赖主键完成 upsert。掌握这三者的差异,本质上就是掌握了 Flink 中「有界与无界」「追加与更新」这两组最基本的语义。

2401_83857914的博客 456

数据库1:数据库创建与管理(头歌云课)

在 Windows 系统中,可以直接通过 SQLServer 的应用程序连接数据库,不过很多时候在生产环境下,我们需要通过命令行来连接数据库。两个数据库,数据库名分别为 TestDb 和 MyDb 的数据库,注意先后顺序。为了完成本关任务,你需要掌握:1.如何在 Linux 系统中连接 SQLServer 数据库,2.如何创建数据库。连接的数据库是本地数据库,用户名是 sa ,密码是 '

weixin_60530224的博客 2315

YALMIP介绍及怎么在Matlab中加YALMIP、SDPT3

目录YALMIP简介怎么在Matlab中加YALMIP?1. 创建决策变量:2. 添加约束:3. 参数配置4. 求解怎么在MatlabR2019a中加YALMIP?1.下载工具包2.放置工具包3.添加路径4.测试安装结果怎么在MatlabR2019a中加SDPT3? YALMIP简介 怎么在Matlab中加YALMIP? yalmip是一位“集大成者”,它不仅自己包含基本的线性规划求解算法,比如linprog(线性规划)、bintprog(二值线性规划)、bnb(分支界定算法)等,他还提供了对cpl

m0_51431440的博客 2万+

云数仓向PostgreSQL生态延伸的技术动因与工程代价

Snowflake以2.5亿美元收购Crunchy Data,把云数仓的触角伸向PostgreSQL生态。本文从负载补齐、元数据标准化与AI应用低延迟读写三个切面拆解收购动机,逐层分析列存与行存的能力边界、存算分离下引入事务负载的提交延迟预算、逻辑复制的接缝风险、元数据统一与混合负载隔离冲突,并给出迁移落地的分阶段验收清单与七个典型误区,最后提供评估厂商PostgreSQL能力的六项观察指标。

搞定过:百亿级数据、万级QPS、零宕机、AI工业化。 447

Ubuntu双系统引导修复实战:boot-repair工具详解

本文详细介绍了使用boot-repair工具修复Ubuntu双系统引导丢失问题的实战方法。当GRUB引导菜单因安装新系统或更新而损坏时,通过制作Ubuntu启动盘进入Live环境,安装并运行boot-repair,可一键完成系统修复引导,自动化执行GRUB重装与配置,解决无法进入Windows或Ubuntu的常见故障。

weixin_29224589的博客 357

记一次Sql Server2012免费版如何升级到2016企业版本

本文记录了将SQL Server 2012免费版升级至企业版的完整流程,重点解决因版本限制导致无法使用代理功能的问题。通过加载ISO安装包,选择从旧版本升级,完成功能安装与实例配置后,需手动启用“代理XP”并检查服务状态。若代理仍异常,需通过安装程序添加“SQL Server代理”组件,最终实现企业版功能完整启用。

qq_57492774的博客 200

基于YOLOv10的机器人抓取引导系统:从物体检测到精准抓取

python# 数据标注工具简化版import os"""启动标注工具""""""标注单张图像"""print(f"标注图像: {os.path.basename(img_path)}")print("请在图像上绘制抓取矩形框...")# 这里应该实现交互式标注界面# 简化版本直接返回示例标注# 示例标注数据"""保存标注结果"""# 保存为YOLO格式# 转换为YOLO格式。

YOLO 378

1.2 机器人控制系统软硬件平台

工业机器人的软硬件平台架构是影响工业机器人性能和效率的重要因素。良好的软硬件平台架构可以帮助工业机器人更加稳定和高效地完成工作,提高生产效率。正确的软硬件配置还可以提高工业机器人的灵活性和可靠性,使其能够更好地适应不断变化的生产环境。 同时,工业机器人的软硬件平台架构还可以影响工业机器人的安全性和维护成本。如果软硬件平台架构不合适,工业机器人可能出现故障或安全隐患,需要大量的维护和维修费用。因此,选择适当的软硬件平台架构对于确保工业机器人的高效运行和长期使用是非常重要的。

Galaxy_Robot的博客 2万+

PostgreSQL 日报| OAuth 校验库置空仍可登录(11 月 9 日)

Tomas Vondra 提交了针对 commit a798660ebe3 中"bogus parameterizations"漏洞的清理版修复补丁,并为各个回退分支分别提供了对应的版本。据报道,OpenAI 正在进行新一轮融资,已额外筹集 110 亿美元,整轮融资尚未正式收官,预计将在未来数周内完成。作为一款面向现代开发流程的 Serverless Postgres 数据库,Lakebase 支持即时分支与环境克隆,并通过计算与存储分离的架构提升性能、降低成本、增强可靠性。函数中发现了一个 bug。

IvorySQL的博客 237

Supreme小程序自动化抢购终端——源码架构与执行流程全解析

本系统是一套基于开发的桌面端小程序自动化抢购终端。把只有开发者能跑的脚本,包装成普通用户也能操作的桌面工具。参数自动捕获 → 商品多关键词检索 → sku/尺码/库存映射 → 多商品任务队列 → 定时/立即抢购 → 订单创建 → 支付参数拉取 → 本地服务生成支付链接 → 手机微信扫码付款这套 Supreme 抢购终端,表面上看是一个"下单工具"。但从工程角度审视,它已经具备了一个小型桌面自动化系统GUI 层:CustomTkinter 现代化界面,线程安全业务层:多商品队列、定时调度、任务编排。

猫敷雪 203

SQL Server 基础语法详解:从建库建表到约束与增删改查

本文以学生信息表 Students 为主线,系统讲解数据库基础语法,涵盖建库、建表、约束添加及增删改查操作。通过 SQL Server T-SQL 示例,清晰区分数据库、表结构与记录的操作对象,强调字段类型、非空、自增、主键、唯一、检查与默认约束的定义与应用,帮助读者理清各语句间的逻辑关系,掌握数据库管理的核心技能。

2601_96519735的博客 940

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

XSS 过滤器 vs SQL 注入防护:自动化测试平台中的

通过分析 AutoTest Platform 的源码可以看出,在实际开发中合理运用字符转义、参数化查询和白名单策略能够有效减少 Web 安全风险。对于非科班出身或刚刚入门的技术人员来说,理解这些安全措施的具体实现方式是非常重要的一步。建议读者可以尝试以下几个方向深入学习:1. 学习 Jsoup 库及 Whitelist API 的用法,并尝试自定义一套适用于自身项目的 HTML 清理规则;

后台模板 237

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

智能问数(Text2SQL)的两大方案及实施成本

现在流行挂个 RAG 知识库,把表结构、字段名、业务术语全向量化存起来,每次查询时现去检索相关片段喂给大模型。只做一件事,把口语化的自然语言转成有规则的自然语言,也就是“规范文本”。然后规则引擎根据预先配置好的业务词典和映射规则,把规范文本编译成 100% 准确的 SQL。核心工作量在配置业务词典,把用户爱说的“华北区”“在途订单”这些词,跟数据库表和字段对上。关键是,规则是写死的、确定的。SQL 怎么生成、逻辑怎么组合,全都写在规则里。出了问题,查规则、改词典、补映射,改完就知道对不对,没有不确定性。

Raqsoft 157

sqlsugar入门

sqlsugar入门

bjzhang75的博客 238

#SQLite 数据库笔记一:(概念 / 终端指令 / SQL 语句 / C 编程 / 回调函数)

数据库 = 数据的仓库,假设数据是海量。能力说明存储数据持久化保存,程序退出数据还在统计数据、分组、排序数据管理增、删、改、查(CRUD)嵌入式设备上也会用数据库(单片机网关、路由器、工业 HMI 都常见),因为 sqlite 体积小、无需服务进程、单文件即可。数据库 = 库 > 表 > 记录(行) > 字段(列)sqlite3 = 开源、C 写的、单文件、免安装、最多 2T 的嵌入式关系型数据库。

lwq20051110的博客 214

网站的SQL 注入:从攻击原理到防御措施

SQL 注入(SQL Injection)是 Web 应用中最古老、危害最大的安全漏洞之一。简单来说就是攻击者通过在用户输入中注入了恶意的SQL 代码,让数据库执行非正常的操作,从而能窃取数据、篡改内容甚至控制整个服务器。SQL 注入虽然古老,但至今仍是 Web 安全的头号威胁。永远不要把用户输入直接拼进 SQL 语句。首选:使用 PDO/MySQLi 预处理语句 + 关闭模拟预处理配合:输入类型校验与格式验证加固:数据库最小权限 + 关闭错误回显外围:WAF + 定期安全扫描。

2501_94567985的博客 418

01_SQLServer 体系架构全解 —— 实例进程、关系引擎、SQLOS 与事务日志深入

01_SQLServer 体系架构全解 —— 实例进程、关系引擎、SQLOS 与事务日志深入 系列定位 :《SQL Server 数据库全栈运维实战系列》第 01 篇,与《MySQL 数据库全栈运维实战系列》同构对标(对标 MySQL 01 对应篇目)。 适用版本 :SQL Server 2019/…

dk843108982的博客 189

SQL Server 增删改查与约束全解:INSERT/UPDATE/DELETE、LIKE 模糊查询、主外键约束

看着简单,但delete和truncate的区别、where漏写、null判断、like通配符、约束命名,每一处都能让新手卡半天。文末给出 WinForm 连接 SQL Server 的完整写法。

2501_94699871的博客 179

快捷键与热键有何异同?

本文对比了热键与快捷键在“粘贴”操作中的异同:用户层面,热键需按Alt+字母组合,快捷键则直接Ctrl+V;开发者层面,修改热键仅需调整菜单标题,而修改快捷键需编辑资源文件中的加速器设置。文章强调专业分工的重要性,并推荐相关排样优化与工具箱技术博文。

闻缺陷则喜何志丹 1746

PostgreSQL 日报| pg_basebackup 提速至 23Gbps(11 月 5 日)

这一案例展示了按需、可弹性扩展的数据库供给如何满足 AI 辅助开发场景的需求,也说明 Neon 在多智能体与多用户并…Neon 的实际使用数据显示,AI agent 在选择工具时,即便内部逻辑建议使用 CLI,仍会优先选择 MCP server。然而,批评人士指出,该倡议同样服务于 OpenAI 自身的商业利益,意在将公司议程嵌入重大选举周期前的政治生态。用户可将其与平台上 70 余个其他模型配合使用,直接调用 Lakehouse 中的现有数据,构建受治理的 AI 应用与智能体。每个哈希条目存储两个有…

IvorySQL的博客 235

SonnetDB 5.0 正式发布:增强 SQL 与事务,开放九模型 MCP 读写

SonnetDB 5.0 正式发布,系统介绍相对 4.0 的 SQL、事务、精确类型、九模型 MCP、.NET 接入、查询优化、可靠性修复与升级步骤。

麦壳饼 359

PG18 索引与查询特性在 IvorySQL5.6 上的实测

这一篇测 IvorySQL 5.6(PG18) 在索引与查询侧的三组新能力:nbtree 的 skip scan、GIN 索引的并行构建、以及控制文件复制方式的。

IvorySQL的博客 234

4-1 PostgreSQL 索引体系总览:B-tree|GIN|GiST|BRIN|SP-GIST

很多新手拿到 PG 就无脑加 B-tree,遇到 JSONB、空间、时序数据直接踩坑。PG 不是只有 B-tree,5 种主流索引各司其职,**没有万能索引,匹配查询模式才是核心**。本文带你看懂每一类索引的原理、适用场景、优缺点、SQL 示例,最后重点讲清楚:索引不是越多越好。

zhangjw34的专栏 370

SQL Server 自带维护计划够用吗?聊聊数据库异地备份的落地选择

原生SQL Server维护计划虽免安装、易上手,但配置繁琐,缺乏异地同步与断点续传能力,长期运维成本高。尤其在无专职DBA团队下,备份链易断裂,清理依赖手动脚本,风险大。相较之下,可视化向导式备份工具可批量管理多库,灵活配置完整、差异、日志备份,保留策略自动执行,无需编写脚本。核心优势在于备份生成后自动加密异地流转,支持断点续传、防勒索过滤,实现“备份+归档”一体化。适合中小团队简化运维,提升数据安全。无论何种方案,定期恢复测试不可或缺。

2501_93776716的博客 318
上一篇: 干货技巧:单模块编译再见adb push迎接sync命令
下一篇: 手机大厂桌面负一屏 Overlay 触摸事件冲突修复笔记
千里马学框架
博客等级 码龄6年 1万+粉丝 650原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

千里马学框架

帮助你了,就请我喝杯咖啡

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值