


https://perfetto.dev/docs/analysis/sql-tables
https://gugu-perf.github.io/perfetto-docs-zh-cn/docs/analysis/sql-tables.html
Perfetto SQL的使用背景
Perfetto 引入 SQL 能力,是为了解决传统性能分析工具在处理海量 trace 数据时的痛点,它的核心作用如下:
1. 解决传统分析的效率低
传统工具手动翻时间轴、靠视觉估算指标,面对数十万调度事件的大 trace 文件,排查偶发问题可能耗时数天。而 Perfetto SQL 能直接将 trace 数据映射为 60+ 预定义表的 SQLite 数据库,用标准 SQL 语法直接查询,原本两天的调度延迟分析现在仅需15分钟就能完成。
2. 实现精准量化的数据分析
它支持直接计算平均延迟、标准差、CPU 占用率分布等量化指标,替代过去依赖肉眼估算的模式。还能通过 WHERE 子句实现比 GUI 筛选器更灵活的精确过滤,快速筛选出耗时超阈值的异常事件。
3. 支持批量模式识别与深度关联
通过 GROUP BY、聚合函数可以快速从海量数据中发现异常模式,比如统计热点函数、识别高负载线程、关联系统事件与应用行为。还能跨进程、跨事件维度做关联分析,挖掘出可视化界面难以发现的隐藏性能瓶颈。
4. 降低分析门槛并支持自动化
它基于通用的 SQL92/SQLite 语法,开发者无需学习复杂的专用 API 就能上手,打开 Perfetto UI 即可直接使用。还能和 Python 结合,实现固定性能场景的自动化批量分析,大幅减少重复人工操作的工作量。
大白话讲解Perfetto sql存在必要性:
大家可能会有疑问?为啥一定要sql进行查询量化分析,直接看Perfetto分析不就好了么?
核心原因如下:
Perfetto直接看slice这种方式前提是Perfetto的项目时长都是比较有限,而且你已经有很明确的分析位置,很容易寻找到具体某个时间段瓶颈。
但是在实际性能优化中,你看要分析问题可能是一个时间段内的,比如某个线程的调度延时等,这种你抓某个时间点的就没有意义,必须要进行统计量化才可以减少方差波动等。
常见的一些table
| 分类 | 包含表 | 核心用途 |
|---|---|---|
| 时间片 | slice | 存储所有带起止时间的事件,覆盖ATrace打点、自定义Track Event、系统派生事件,是定位卡顿的核心表 |
| 计数器 | counter、counter_track | 记录随时间变化的数值指标,支持分析CPU频率、内存占用、功耗、业务计数器等动态数据 |
| 线程与进程 | thread、process | 维护全量线程/进程元数据,存储tid、pid、utid、upid、线程名、进程名等基础标识信息 |
| 轨道 | track、thread_track、process_track | 定义事件的归属关系,关联slice/counter到对应线程/进程,支撑Perfetto UI的可视化轨道渲染 |
| 调度状态 | thread_state、sched | thread_state覆盖线程全状态流转(Running/Sleeping/Waiting等),sched仅记录线程占用CPU的Running区间 |
| CPU采样 | perf_sample、cpu_profile_stack_sample | 存储CPU Profiler的采样数据,用于精准定位热点函数的CPU占用分布 |
| 调用栈维表 | stack_profile_callsite、stack_profile_frame、stack_profile_mapping | 维护符号化的调用栈全链路信息,需和采样表关联查询,还原完整函数调用路径 |
| 采集质量 | stats | 记录Trace采集过程中的数据丢失、缓冲区溢出、解析异常等问题,用于校验Trace文件有效性 |
| Android Binder专属 | android_binder_txns | 专门存储Android系统的Binder IPC事务全量数据,是分析跨进程通信性能的专属核心表 |
直接Perfetto上拷贝现成的SQL语句:

再点击的track details

再点击show query

有了语句后然后执行

Pefetto量化分析常用的一些SQL分享
使用 SQL 进行量化分析
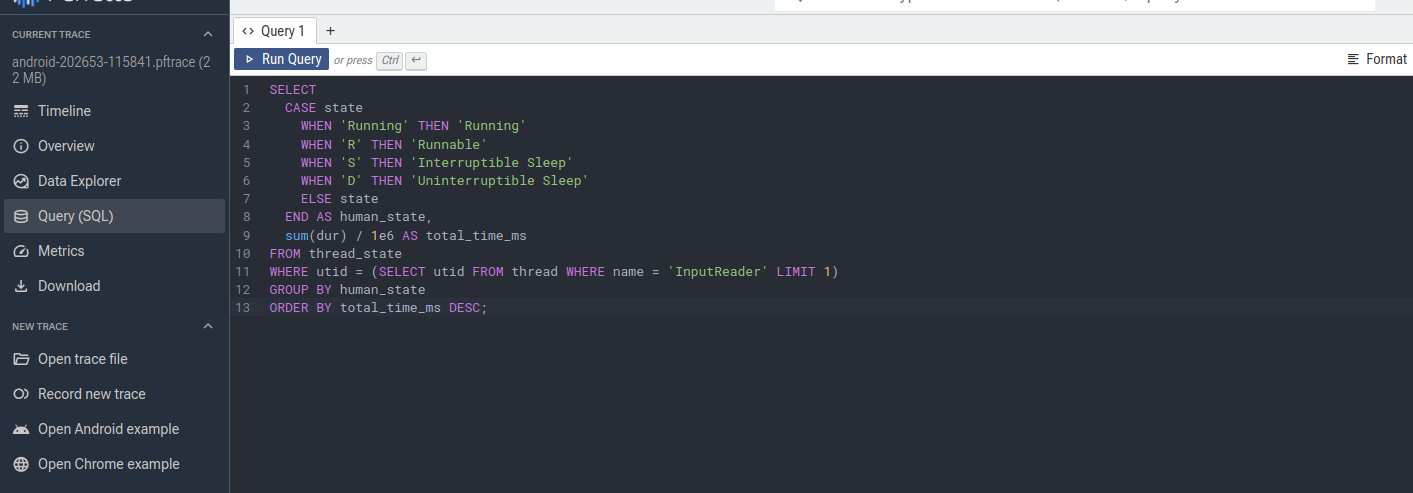
点击左边的Query既可以。
Perfetto 内置的 SQL 查询引擎是其强大功能之一,允许开发者对 Trace 数据进行精确的聚合、筛选和分析。以下是一些常用的 CPU 分析查询。
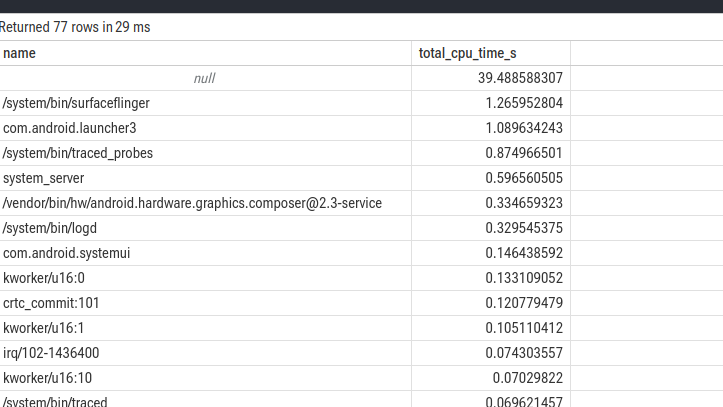
1. 计算各进程的 CPU 总时长
此查询统计每个进程在所有 CPU 上运行的总时长,按降序排列,用于快速定位消耗 CPU 资源最多的进程。
SELECT
  process.name,
  sum(dur) / 1e9 AS total_cpu_time_s
FROM sched
JOIN thread ON sched.utid = thread.utid
JOIN process ON thread.upid = process.upid
GROUP BY process.name
ORDER BY total_cpu_time_s DESC;
结果
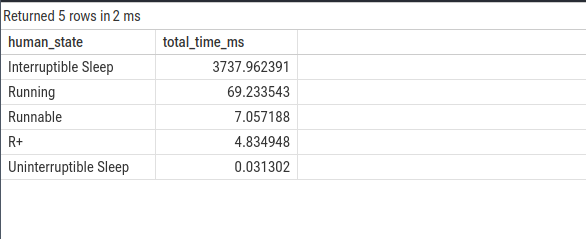
2. 分析单个线程的时间状态分布
此查询基于 thread_state 表,可用于分析特定线程(示例为 InputReader)在各种状态下的时间分布,从而判断其主要瓶颈。
SELECT
  CASE state
    WHEN 'Running' THEN 'Running'
    WHEN 'R' THEN 'Runnable'
    WHEN 'S' THEN 'Interruptible Sleep'
    WHEN 'D' THEN 'Uninterruptible Sleep'
    ELSE state
  END AS human_state,
  sum(dur) / 1e6 AS total_time_ms
FROM thread_state
WHERE utid = (SELECT utid FROM thread WHERE name = 'InputReader' LIMIT 1)
GROUP BY human_state
ORDER BY total_time_ms DESC;
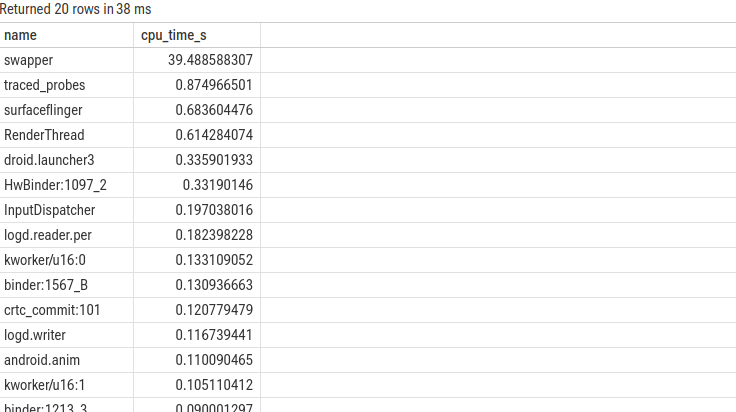
3. 查找特定时间段内 CPU 消耗最高的线程
此查询用于分析特定场景(如应用启动的 2-5s 时间段)中,消耗 CPU 时间最长的线程。
SELECT
  thread.name,
  sum(dur) / 1e9 AS cpu_time_s
FROM sched
JOIN thread ON sched.utid = thread.utid
-- 时间戳单位为纳秒,可以自己加上 WHERE ts > 2e9 AND ts < 5e9 来取某一段时间
GROUP BY thread.name
ORDER BY cpu_time_s DESC
LIMIT 20;
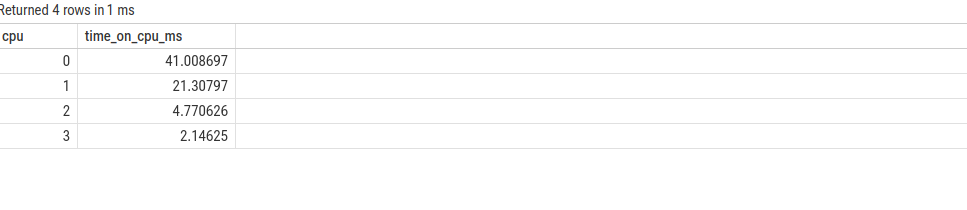
4. 查看线程在各 CPU 核心上的运行时间分布
此查询有助于了解一个线程的 CPU 亲和性,以及它是否在预期的大小核上运行。
SELECT
  cpu,
  sum(dur) / 1e6 AS time_on_cpu_ms
FROM sched
WHERE utid = (SELECT utid FROM thread WHERE name = 'InputReader' LIMIT 1)
GROUP BY cpu
ORDER BY cpu;
可以看出大部分时间在cpu0-1运行
5.查询binder的调用耗时等情况
INCLUDE PERFETTO MODULE android.binder;

SELECT
  aidl_name,
  method_name,
  client_process,
  client_thread,
  client_dur / 1e6 AS client_ms,
  server_process,
  server_thread,
  server_dur / 1e6 AS server_ms,
  (server_ts - client_ts) / 1e6 AS dispatch_ms
FROM android_binder_txns
WHERE is_sync
ORDER BY client_dur DESC
LIMIT 20;

 606


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


